


Python中copy.copy()与copy.deepcopy()的代码实现对比
在 Python 中,变量名本质上是指向内存中具体对象的引用标签。当使用直接赋值语句(如 b = a)时,系统仅仅是将新变量绑定到原有对象的内存地址上,并没有创建任何新对象。当需要生成彼此独立的副本时,Python 标准库提供了 copy 模块,其中包含两个核心函数:浅拷贝 copy.copy() 与深拷贝 copy.deepcopy()。两者的关键区别在于处理“嵌套对象”时的行为深度:浅拷贝仅构造一个顶层新容器,其内部元素依然是指向原对象的子元素引用;而深拷贝会递归遍历所有层级,为所有嵌套的可变对象均创建全新的独立内存副本。
一、内存模型与指针关系:直接赋值、浅拷贝与深拷贝
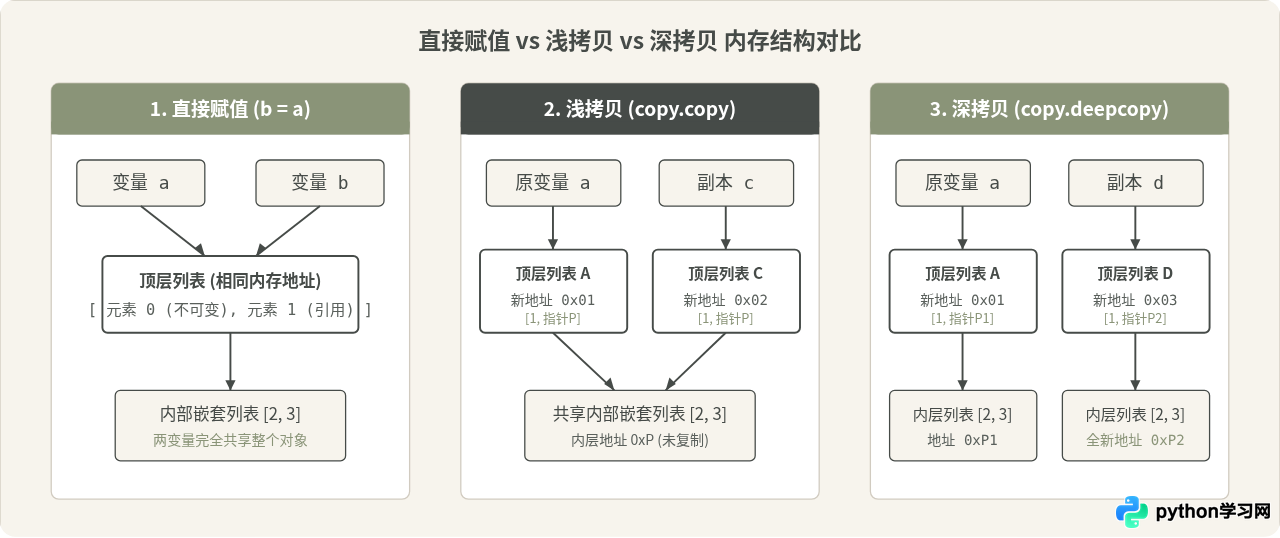
为了直观区分这三种操作在底层内存中的差异,我们先从一个包含嵌套列表的复合对象 [1, [2, 3]] 切入。直接赋值、浅拷贝与深拷贝在内存分配与指针引用上的关系如下图所示:
二、基础嵌套结构的代码实现与地址验证
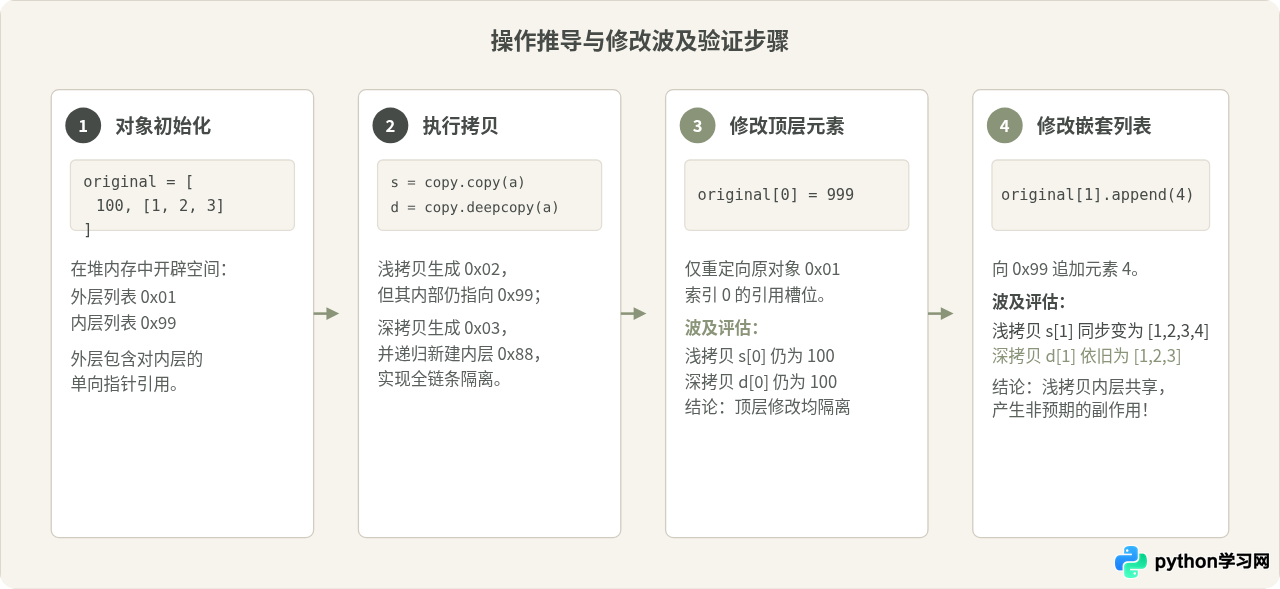
为了让读者清晰看到浅拷贝与深拷贝在代码运行时的行为,下面使用 Python 标准库的 copy 模块,分别对顶层元素和嵌套元素进行修改操作,并通过 id() 函数打印内存地址进行客观验证。
1. 完整代码示例
import copy

# 1. 构造一个包含嵌套可变对象的列表
original = [100, [1, 2, 3]]

# 2. 分别进行浅拷贝与深拷贝
shallow_copied = copy.copy(original)
deep_copied = copy.deepcopy(original)

print("--- 初始状态地址对比 ---")
print(f"原对象外层 id: {id(original)}, 内层 id: {id(original[1])}")
print(f"浅拷贝外层 id: {id(shallow_copied)}, 内层 id: {id(shallow_copied[1])}")
print(f"深拷贝外层 id: {id(deep_copied)}, 内层 id: {id(deep_copied[1])}")

# 3. 操作 A:修改原列表的顶层元素
original[0] = 999

# 4. 操作 B:修改原列表中嵌套的内部列表
original[1].append(4)

print("\n--- 修改后的内容输出 ---")
print(f"原对象:   {original}")
print(f"浅拷贝对象: {shallow_copied}")
print(f"深拷贝对象: {deep_copied}")
2. 运行结果示例分析
--- 初始状态地址对比 ---
原对象外层 id: 1404882001, 内层 id: 1404882065
浅拷贝外层 id: 1404882129, 内层 id: 1404882065  # 外层地址不同,内层地址相同!
深拷贝外层 id: 1404882193, 内层 id: 1404882257  # 外层、内层均为全新地址!

--- 修改后的内容输出 ---
原对象:   [999, [1, 2, 3, 4]]
浅拷贝对象: [100, [1, 2, 3, 4]]  # 顶层保持独立,但嵌套列表被连带修改!
深拷贝对象: [100, [1, 2, 3]]     # 完全独立,任何修改均不波及
从输出结果可以观察到两个关键现象:
- 顶层元素修改互不影响:当把
original[0]赋值为999时,shallow_copied[0]依然是100。这是因为浅拷贝已经为外层容器创建了新的列表对象,外层容器中的索引槽位互相独立。 - 嵌套可变对象被浅拷贝共享:当通过
original[1].append(4)对内层列表原地追加元素时,shallow_copied[1]同样出现了4。这是因为shallow_copied内部保存的指针与原对象指向完全相同的内层内存地址(1404882065)。而深拷贝对象的内层是独立分配的全新列表(1404882257),因此保持原状。
三、自定义对象中的拷贝协议与循环引用处理
在实际工程开发中,拷贝的对象往往不仅限于基础的列表或字典,而是包含了自定义类的实例。Python 允许通过定义特殊方法 __copy__() 与 __deepcopy__() 来定制对象的拷贝逻辑。
1. 自定义类实现 `__copy__` 与 `__deepcopy__`
import copy

class Task:
    def __init__(self, title, tags):
        self.title = title
        self.tags = tags  # 列表类型,属于可变对象

    def __copy__(self):
        # 浅拷贝自定义实现:直接传递原有的 tags 引用
        cls = self.__class__
        new_obj = cls.__new__(cls)
        new_obj.__dict__.update(self.__dict__)
        return new_obj

    def __deepcopy__(self, memo):
        # 深拷贝自定义实现:递归拷贝 tags,并在 memo 中记录当前对象
        cls = self.__class__
        new_obj = cls.__new__(cls)
        memo[id(self)] = new_obj
        for k, v in self.__dict__.items():
            setattr(new_obj, k, copy.deepcopy(v, memo))
        return new_obj

# 测试自定义类的拷贝表现
t1 = Task("数据处理", ["Python", "ETL"])
t_shallow = copy.copy(t1)
t_deep = copy.deepcopy(t1)

t1.tags.append("SQL")
print("原对象 tags:", t1.tags)           # ['Python', 'ETL', 'SQL']
print("浅拷贝 tags:", t_shallow.tags)   # ['Python', 'ETL', 'SQL'] (受影响)
print("深拷贝 tags:", t_deep.tags)      # ['Python', 'ETL'] (不受影响)
2. 循环引用与 memo 字典的作用
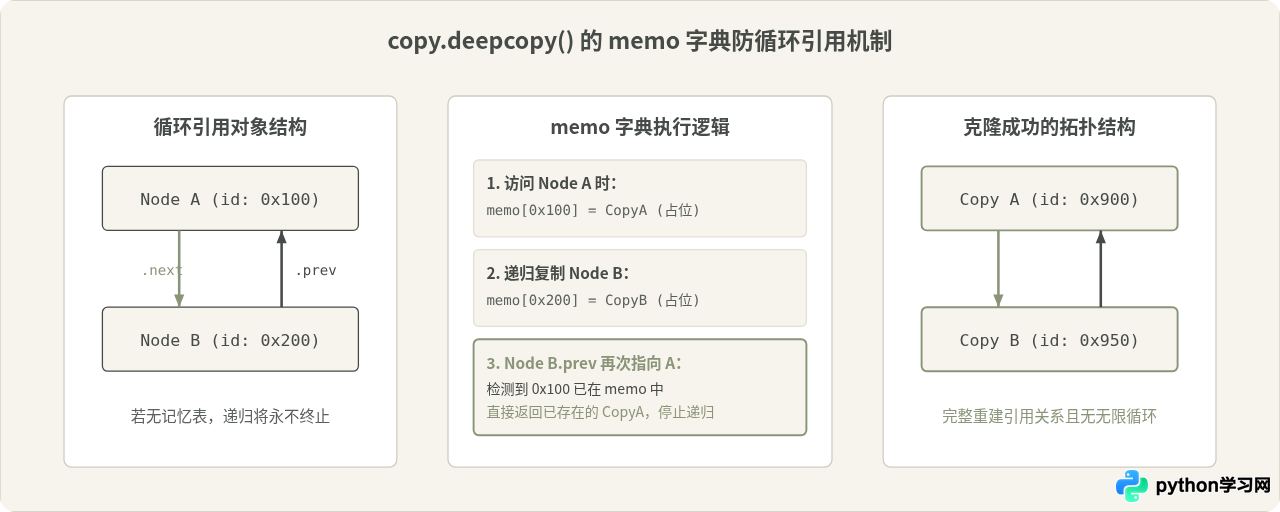
当对象结构中存在相互引用(例如图结构、双向链表或包含自身的引用 a.append(a))时,如果朴素地执行递归复制,程序将陷入死循环并最终触发 RecursionError。copy.deepcopy() 通过在内部维护一个 memo 字典解决了这个问题。
在进入 deepcopy(x, memo) 时,函数首先检查 id(x) 是否已存在于 memo 中:
- 如果已存在,直接返回先前缓存的拷贝对象;
- 如果不存在,立即创建未初始化的新实例并写入
memo[id(x)] = new_obj,随后再递归复制其属性。
四、容易混淆的场景辨析与边界陷阱
在日常使用中,很多开发者常把切片操作或字典的 copy() 方法当成独立深拷贝,或对不可变对象的拷贝行为产生误解。以下对三个典型混淆场景进行辨析:
1. 切片 `[:]`、`list.copy()` 与 `dict.copy()` 的本质均为浅拷贝
常见误解认为调用内置方法如 new_list = old_list[:] 或 new_dict = old_dict.copy() 就实现了独立拷贝。实际上,这些内建方法为了兼顾性能,全部等价于浅拷贝。如果容器中包含列表、字典或类实例,修改嵌套内容依然会产生副作用。
old_dict = {"conf": {"timeout": 30}}
new_dict = old_dict.copy()  # 仅为浅拷贝!

new_dict["conf"]["timeout"] = 60
print(old_dict["conf"]["timeout"])  # 输出 60,原数据被改动!
2. 不可变对象(元组、字符串、数字)的拷贝优化
对于纯不可变对象(如纯整数、字符串或仅包含不可变元素的元组),Python 解释器在执行 copy.copy() 时会直接返回原对象本身,因为既然无法修改,复制内存毫无意义:
t = (1, 2, 3)
c = copy.copy(t)
print(id(t) == id(c))  # True,直接复用原对象
注意边界条件:如果元组内部包含了可变对象(如 t = (1, [2, 3])),copy.deepcopy(t) 则会专门创建一个新的元组,并递归克隆内部的列表。而 copy.copy(t) 依然会返回原元组自身。
五、性能损耗对比与技术选型建议
由于 copy.deepcopy() 需要对整个对象图进行递归遍历、在 memo 中记录所有遍历过的 id,以及动态检测各类对象的内部类型,其执行速度通常比 copy.copy() 慢数倍至数十倍,且内存开销随嵌套深度明显上升。
| 对比维度 | 直接赋值 (b = a) | 浅拷贝 (copy.copy) | 深拷贝 (copy.deepcopy) |
|---|---|---|---|
| 新对象创建 | 不创建新对象,仅增加引用 | 仅创建最外层容器新对象 | 递归创建外层及所有内层新对象 |
| 嵌套对象独立性 | 完全共享 | 嵌套对象共享指针,不独立 | 完全独立,隔离一切后续修改 |
| 执行时间开销 | 极快(仅指针赋值,O(1)) | 较快(仅遍历顶层元素,O(N)) | 较慢(递归遍历全图,常数大) |
| 循环引用支持 | 自然支持 | 不涉及内部递归,支持 | 通过内置 memo 字典安全支持 |
| 适用典型场景 | 别名传递、函数参数传递 | 一维列表/字典的副本、扁平数据快照 | 深层嵌套配置、复杂状态机树、图结构克隆 |
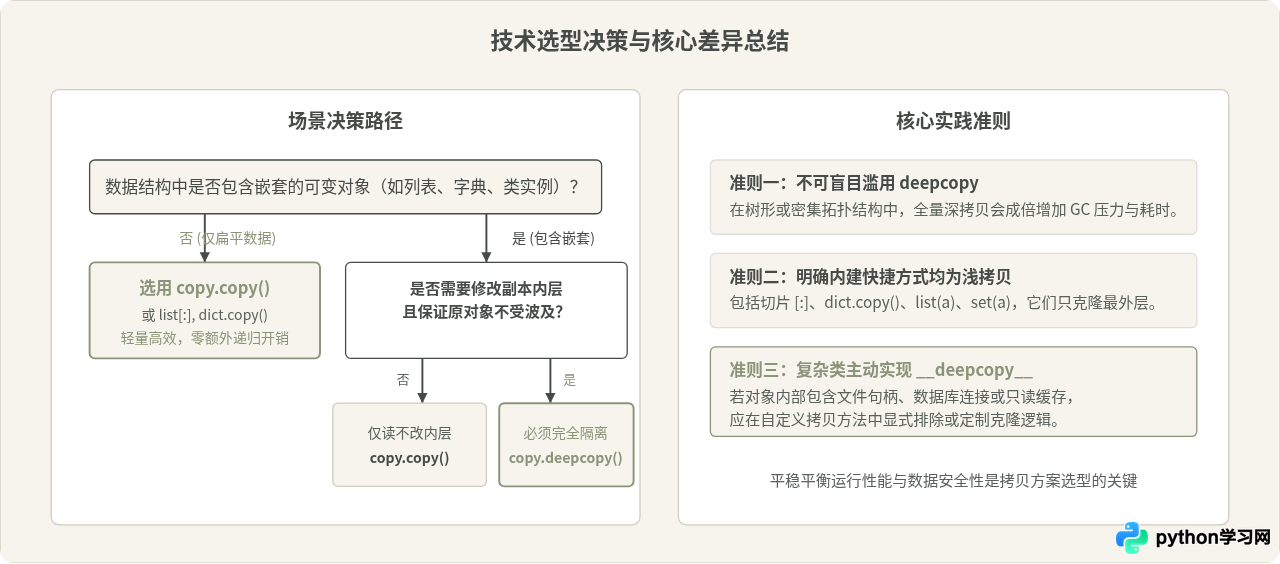
六、总结
在 Python 开发中理解 copy.copy() 与 copy.deepcopy() 的本质区别,核心在于掌握“顶层新建”与“全链路递归克隆”的内存分布差异。对于单一层级的集合结构,直接使用浅拷贝(或内建的构造器与切片)能够以极高的效率满足快照需求;而对于层级多变、包含内部状态更新或复杂类实例的业务对象,显式使用 copy.deepcopy() 或通过 __deepcopy__ 协议精细化控制复制逻辑,则是防范多处指针引用连带污染、保障数据独立性与程序正确性的关键防线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















