


Python赋值是引用还是拷贝?理解变量绑定机制
深入解析Python中赋值语句的本质,厘清变量与对象之间的名称绑定(贴标签)关系,对比可变对象与不可变对象在赋值、修改和函数传参中的行为表现与底层内存机理。
b = a 时,Python 绝不会开辟新内存去复制对象,而仅仅是将名字 b 也贴到 a 当前所指向的同一个对象上。后续操作是否会导致两个变量同时受影响,完全取决于该对象是可变对象还是不可变对象。
一、变量不是盒子:Python 的“名字绑定”心智模型
许多初学者在刚接触 Python 时,常常沿用从其他语言带来的直觉——把变量想象成一个“盒子”,把数据放进盒子里;执行赋值 b = a 时,就如同把盒子 a 里的物品复制一份放进盒子 b。在 Python 中,这种“盒子模型”是导致绝大多数赋值困惑的根源。
在 Python 的底层对象模型中,所有数据(无论是整数、字符串、列表还是函数)都是在堆内存中独立存在的对象实体。变量本身并不分配容纳数据的内存空间,它只是程序命名空间中的一个名字(Identifier)。赋值语句 = 的核心工作,是把等号右侧计算得到的对象,与等号左侧的名字关联起来,这在官方规范中被称为“绑定”(Binding)。
当执行 a = [1, 2] 时,Python 先在内存中构建列表对象 [1, 2],再把名字 a 贴到该对象上;随后执行 b = a,Python 并没有复制任何列表数据,而是把名字 b 同样贴到了这块内存对象上。此时,a 与 b 只是同一个对象的两个不同别名。
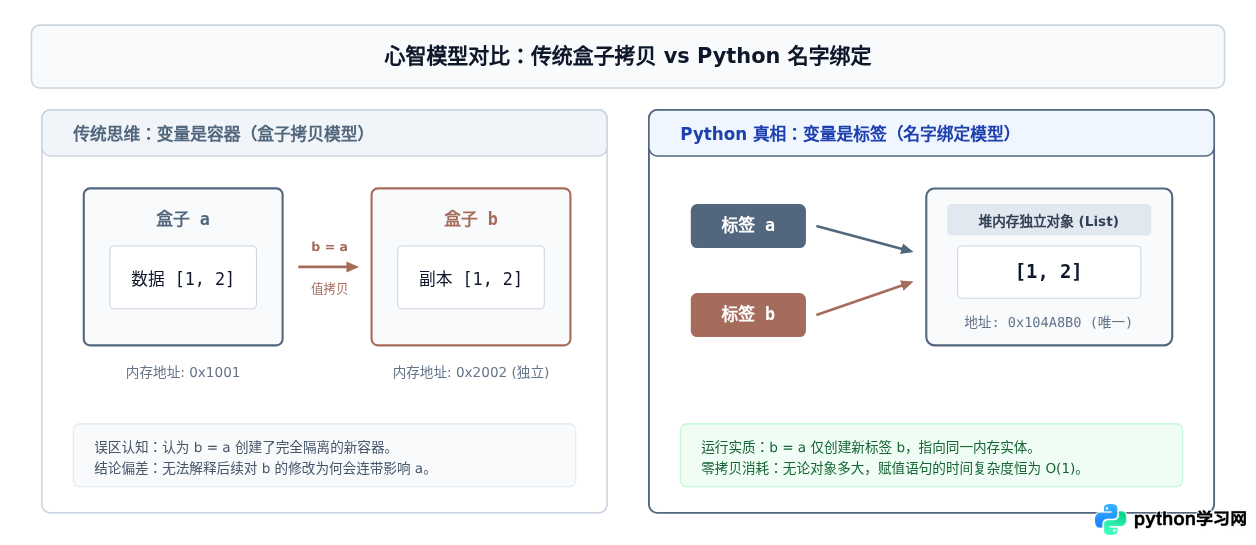
我们可以通过 Python 内置的 id() 函数(返回对象的内存地址整数)以及 is 运算符(判断两端是否为同一对象实体)来直接验证这一绑定机制:
# 验证变量绑定与内存地址
a = [10, 20]
b = a

print("id(a):", id(a))
print("id(b):", id(b))
print("a is b:", a is b)

# 示例输出:
# id(a): 4410294144
# id(b): 4410294144
# a is b: True输出结果完全印证了上述模型:a 和 b 的地址完全一致,a is b 返回 True。这说明赋值并没有生产任何新对象。
二、关键分水岭:可变对象与不可变对象
如果说“赋值永远只是绑定标签”,那么为什么日常写代码时,修改数值往往互不影响,修改列表却会互相污染?
这引出了理解该问题的核心分水岭:操作对象的“可变性”(Mutability)。在 Python 中,所有类型被严格区分为两类:
- 不可变对象(Immutable):数值类型(
int、float、bool)、字符串(str)、元组(tuple)、冻结集合(frozenset)。此类对象一旦在内存中创建,其内部状态不可变更。 - 可变对象(Mutable):列表(
list)、字典(dict)、集合(set)以及绝大部分自定义类的实例。此类对象可以在原内存地址上就地修改内容。
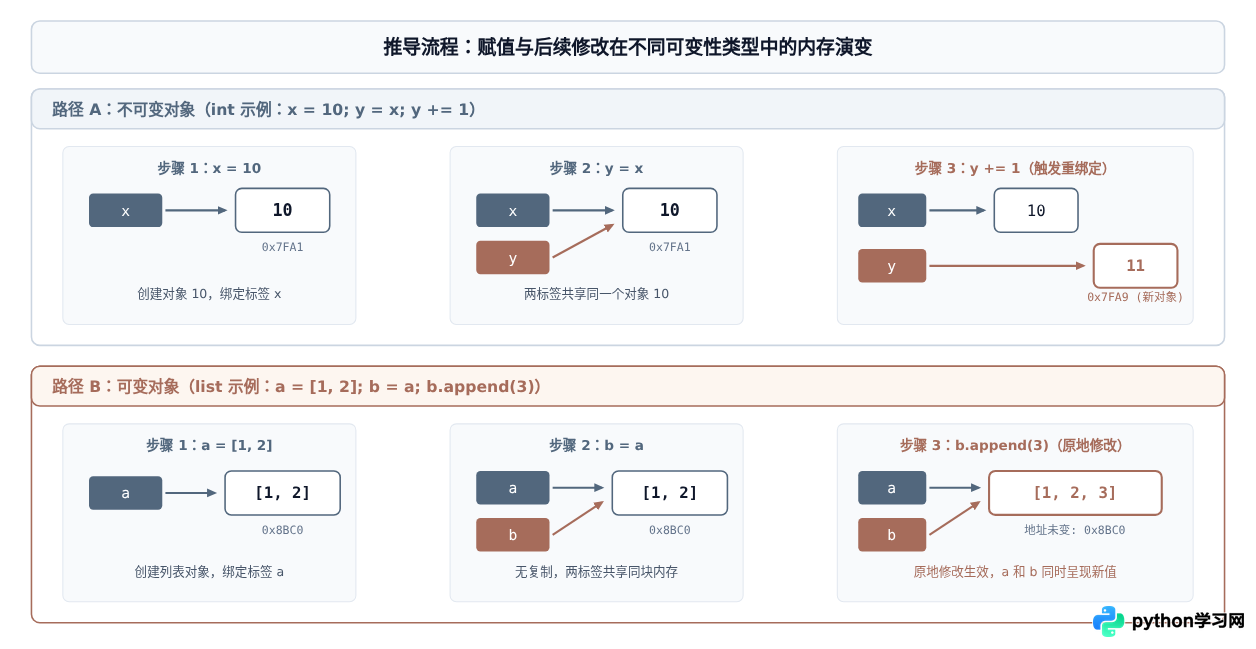
1. 不可变对象的“修改”本质:重新绑定
当执行以下代码时:
x = 10
y = x
y += 1

print("x =", x, "| id(x) =", id(x))
print("y =", y, "| id(y) =", id(y))

# 示例输出:
# x = 10 | id(x) = 4305824128
# y = 11 | id(y) = 4305824160
初学者容易误以为 y = x 发生了一次拷贝,所以后续修改 y 没有影响 x。真实过程是:
x = 10:创建整数对象10,标签x绑定它。y = x:标签y也绑定到同一个整数对象10。此时x is y为True。y += 1:因为整数10是不可变的,无法把它的内存直接改成11。Python 计算10 + 1后,在内存中创建了全新的整数对象 11,并把标签y撕下来贴到了11上。而标签x仍然留在原对象10上。
2. 可变对象的“修改”本质:原地突变(In-place Mutation)
与不可变对象不同,可变对象支持原地更新:
list_a = [1, 2]
list_b = list_a
list_b.append(3)

print("list_a:", list_a, "| id(list_a) =", id(list_a))
print("list_b:", list_b, "| id(list_b) =", id(list_b))

# 示例输出:
# list_a: [1, 2, 3] | id(list_a) = 4410294144
# list_b: [1, 2, 3] | id(list_b) = 4410294144此时,list_b.append(3) 调用的是列表的方法,它直接在原内存区域追加数据,并没有创建新列表对象。因为 list_a 同样贴在这块内存上,通过 list_a 观察到的列表自然变成了 [1, 2, 3]。
三、函数传参:对象引用共享(Call-by-Object-Reference)
关于 Python 函数参数传递机制的争议长期存在:有人说是“值传递”,有人说是“引用传递”。这两种说法都来自 C/C++ 体系,无法准确描述 Python。
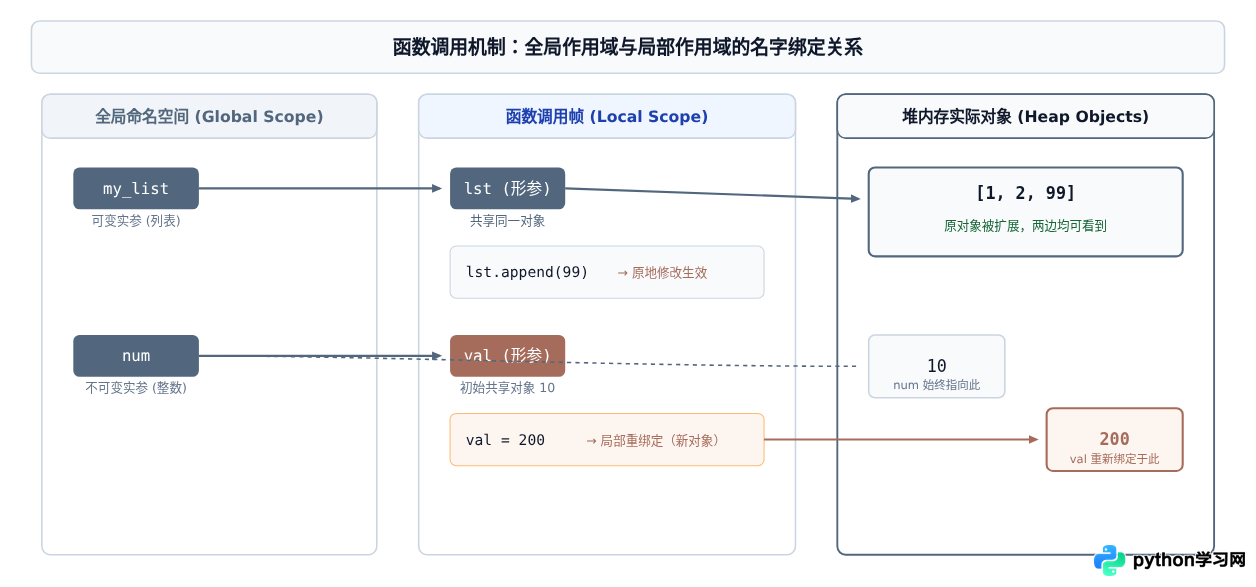
官方权威的定义是共享对象传递(Call by sharing),也被称作传递对象的引用(Call by object reference)。其底层规则极其简单:调用函数时,形参和实参之间发生的仅仅是一次普通的“名字绑定”。
函数被调用时,Python 创建了一个局部的局部命名空间(Local Scope)。形参名字被直接绑定到调用方传入的实参对象上。因此:
- 在函数内部如果执行
param = new_value,这只是让局部名字param重新绑定了新对象,绝不会改变外部调用方的变量绑定。 - 在函数内部如果调用
param.append()或param[key] = val,则是直接对共享的堆对象进行原地修改,外部变量由于绑定的是同一个对象,其状态自然随之变化。
因为函数定义在编译时只执行一次,默认参数对象也是在函数定义阶段创建的唯一单例。如果使用可变对象作为默认值(如
def append_item(x, target=[])),多次调用将永久共享并修改这同一个列表。正确的工程做法是使用不可变的 None 作为占位符,并在函数体内动态判断初始化:
def append_item(x, target=None):
    if target is None:
        target = []
    target.append(x)
    return target
四、需要真正隔离时:浅拷贝与深拷贝
既然常规赋值 b = a 只是新增标签,那当我们确实需要对数据进行隔离操作、确保修改时不影响原数据时,该如何处理?Python 标准库提供了浅拷贝(Shallow Copy)和深拷贝(Deep Copy)两种选择。
1. 浅拷贝(Shallow Copy)
浅拷贝的作用是创建一个新的顶层容器,但容器内部所包含的子元素,仍然保持对原对象子元素的引用。
常见的浅拷贝实现途径包括:
- 切片操作:
new_list = old_list[:] - 工厂函数:
new_list = list(old_list)、new_dict = dict(old_dict) - 容器自带的拷贝方法:
new_list = old_list.copy() - 标准库方法:
import copy; new_obj = copy.copy(old_obj)
# 浅拷贝的行为特征
import copy

origin = [[1, 2], [3, 4]]
shallow = copy.copy(origin)

print("顶层容器是否独立:", shallow is origin)
print("第一层子列表是否共享:", shallow[0] is origin[0])

shallow.append([5, 6])     # 改变顶层容器结构
shallow[0].append(999)     # 改变共享的嵌套列表

print("origin:", origin)
print("shallow:", shallow)

# 示例输出:
# 顶层容器是否独立: False
# 第一层子列表是否共享: True
# origin: [[1, 2, 999], [3, 4]]
# shallow: [[1, 2, 999], [3, 4], [5, 6]]输出表明:浅拷贝成功阻断了顶层结构的联动(shallow.append([5, 6]) 没有影响 origin),但是嵌套的内部子列表 [1, 2] 依然指向同一个内存对象。通过 shallow[0] 写入的数据,原变量 origin 完全穿透受影响。
2. 深拷贝(Deep Copy)
如果对象包含多层嵌套结构,且必须实现完全的数据隔离,就必须使用 copy.deepcopy()。深拷贝会递归遍历原对象的所有层级,遇到可变对象就逐层创建全套独立副本,同时内部通过备忘录字典(Memo Dict)智能处理循环引用,避免无限递归。
# 深拷贝的行为特征
import copy

origin = [[1, 2], [3, 4]]
deep = copy.deepcopy(origin)

deep[0].append(999)

print("origin:", origin)
print("deep:", deep)

# 示例输出:
# origin: [[1, 2], [3, 4]]
# deep: [[1, 2, 999], [3, 4]]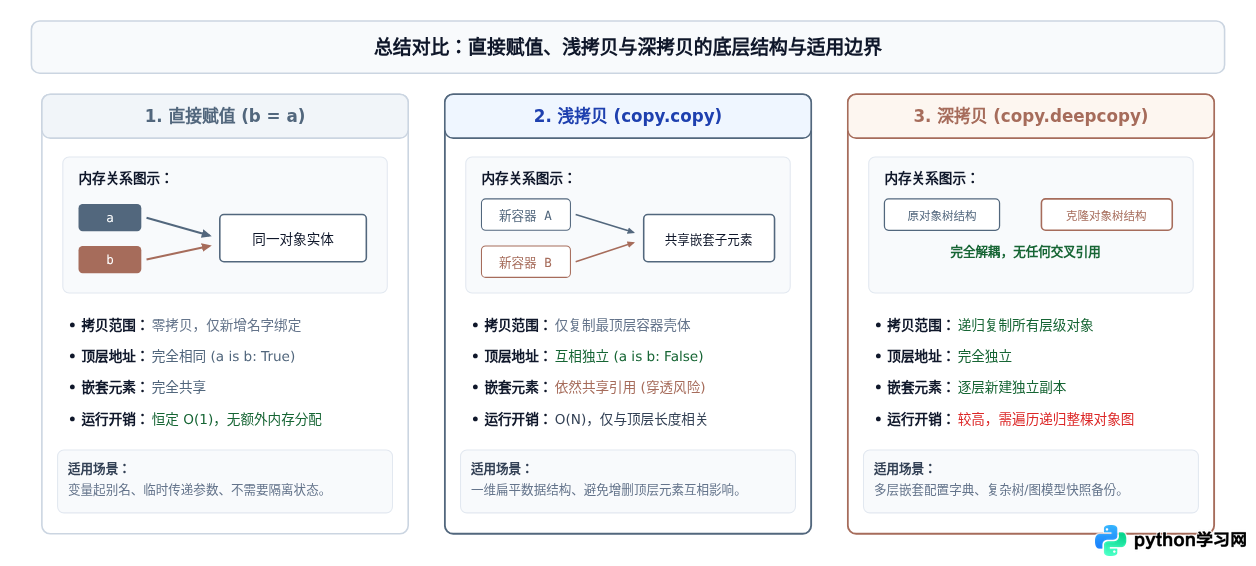
五、工程实践中的高频陷阱排查清单
建立正确的“名字绑定”心智模型后,许多平时容易让人摸不着头脑的偶发 Bug 都会迎刃而解。以下是三条在实际编码中最容易踩中的陷阱:
1. 陷阱一:嵌套列表乘法生成的“全家桶”
当需要初始化一个 3×3 的二维全零矩阵时,常有开发者写出这样的代码:
matrix = [[0] * 3] * 3
matrix[0][0] = 1
print(matrix)

# 示例输出:
# [[1, 0, 0], [1, 0, 0], [1, 0, 0]]原因剖析:[0] * 3 创建了一个包含 3 个零的单层列表。而外层的 * 3 并没有把这个子列表复制 3 遍,而是把对同一个子列表的引用重复了 3 次。换言之,matrix[0]、matrix[1] 和 matrix[2] 只是贴在同一个物理列表上的 3 个指针。修改其中一行,所有行都会同步变化。
正确写法:采用列表推导式,确保每次迭代都重新生成全新列表对象:
matrix = [[0] * 3 for _ in range(3)]。
2. 陷阱二:+= 在可变与不可变对象上的语义分歧
# 对不可变对象:+= 等价于重新计算并重新绑定
a = 10
b = a
a += 5
print(a, b)  # 输出: 15, 10

# 对可变对象:+= 会优先调用 __iadd__ 执行原地扩展!
x = [1, 2]
y = x
x += [3]
print(x, y)  # 输出: [1, 2, 3], [1, 2, 3]  (y 被影响)

# 对比:如果是显式的普通加法赋值
x2 = [1, 2]
y2 = x2
x2 = x2 + [3]  # 创建了全新列表并重新绑定 x2
print(x2, y2)  # 输出: [1, 2, 3], [1, 2]  (y2 保持不变)
这一微妙差异经常在维护共享列表状态时引发静默数据污染,必须警惕 x += [...] 原地修改的副作用。
3. 陷阱三:小整数与短字符串的驻留机制(Interning)干扰测试
在测试 is 运算符时,有时会发现不可变对象出现看似“被复用”的巧合:
m = 100
n = 100
print(m is n)  # True

p = 1000
q = 1000
print(p is q)  # 在不同执行环境下可能为 False
这并非赋值机制的特殊表现,而是 CPython 解释器为了节省内存和加速执行所做的内部优化:在启动时预先创建好 -5 到 256 之间的小整数对象池,并在内存中进行全局单例复用。理解变量绑定时,不应将底层的对象池优化误认为是赋值语义的一部分。
六、自查与总结
| 操作方式 | 语法示例 | 顶层对象是否独立 | 嵌套子对象是否独立 | 典型适用场景 |
|---|---|---|---|---|
| 直接赋值 | b = a |
否(同一对象) | 否(完全共享) | 临时别名、函数入参传值 |
| 浅拷贝 | b = a.copy() 或 b = a[:] |
是(新建顶层容器) | 否(仍共享内部引用) | 扁平列表/字典避免增删互相干扰 |
| 深拷贝 | b = copy.deepcopy(a) |
是(递归全套新建) | 是(完全隔离) | 多层嵌套配置备份、复杂图结构克隆 |
回到最初的核心问题:Python 赋值是引用还是拷贝?
答案是:赋值既不是拷贝,也不是传统指针传递,而是名字绑定。赋值语句的工作永远只是为对象贴上一张名字标签。至于后续的操作是“牵一发而动全身”还是“各走各的路”,不取决于赋值语句本身,而完全取决于操作的方法是在原对象上就地修改,还是计算后重新绑定了新标签。只要在脑海中建立起“变量是便利贴、数据是内存实体”的物理模型,Python 中所有与赋值、参数传递及拷贝相关的逻辑,都会变得清晰而自然。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















