


Python scikit-learn中怎么获取树模型与线性模型的属性重要性
深入讲解在Python scikit-learn中如何正确提取树模型与线性模型的属性(特征)重要性,包含coef_标准化约束、feature_importances_不纯度减少量(MDI)原理与高基数偏置、以及置换重要性检验的标准实现流程。
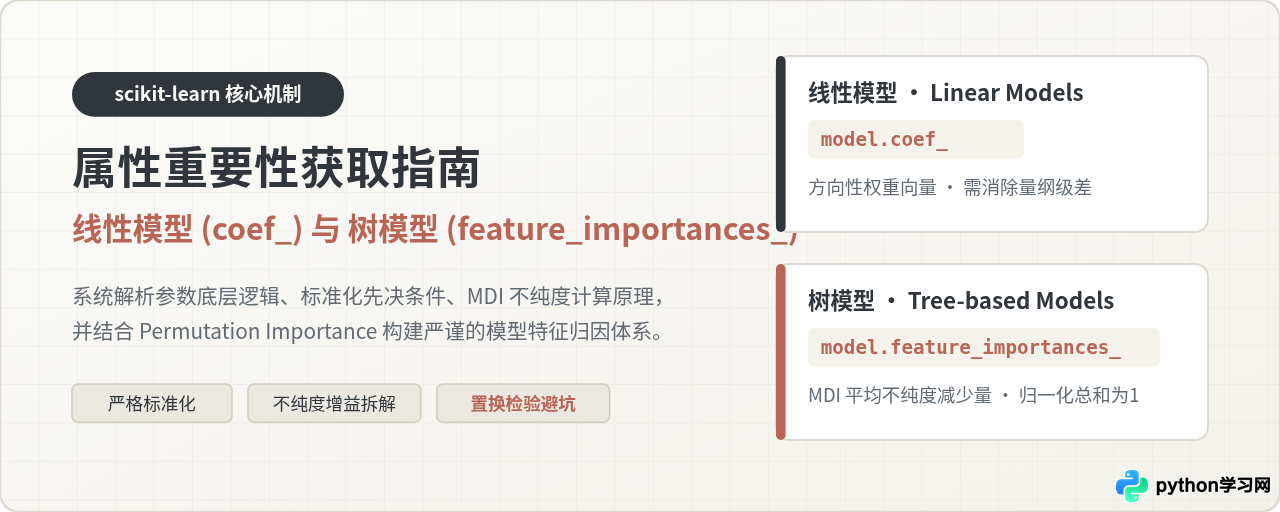
在 Python 的 scikit-learn 机器学习库中,树模型与线性模型提取“属性重要性”(Feature Importance)的底层逻辑与代码接口完全不同:线性模型(如 LinearRegression、LogisticRegression、Ridge)通过拟合后的权重系数 model.coef_ 衡量特征对输出的边际影响方向与幅度,其前提是输入特征必须事先经过严格标准化;树模型(如 DecisionTreeClassifier、RandomForestClassifier、GradientBoostingClassifier)则提供了开箱即用的内置属性 model.feature_importances_,基于树节点分裂时的平均不纯度减少量(MDI, Mean Decrease in Impurity)量化特征贡献率。当面对高基数类别、数据存在共线性或需要评估模型真实泛化贡献时,两者还可统一借助模型无关的置换重要性(Permutation Importance)实现客观校验。
一、核心机制概览:两种模型属性重要性的根本差异
在 scikit-learn 中,“重要性”并不是一个通用的绝对物理量,而是模型依据自身假设对输入特征分配的数学权重。混淆线性模型与树模型的属性提取方式,往往会导致错误的业务归因与特征筛选结论。
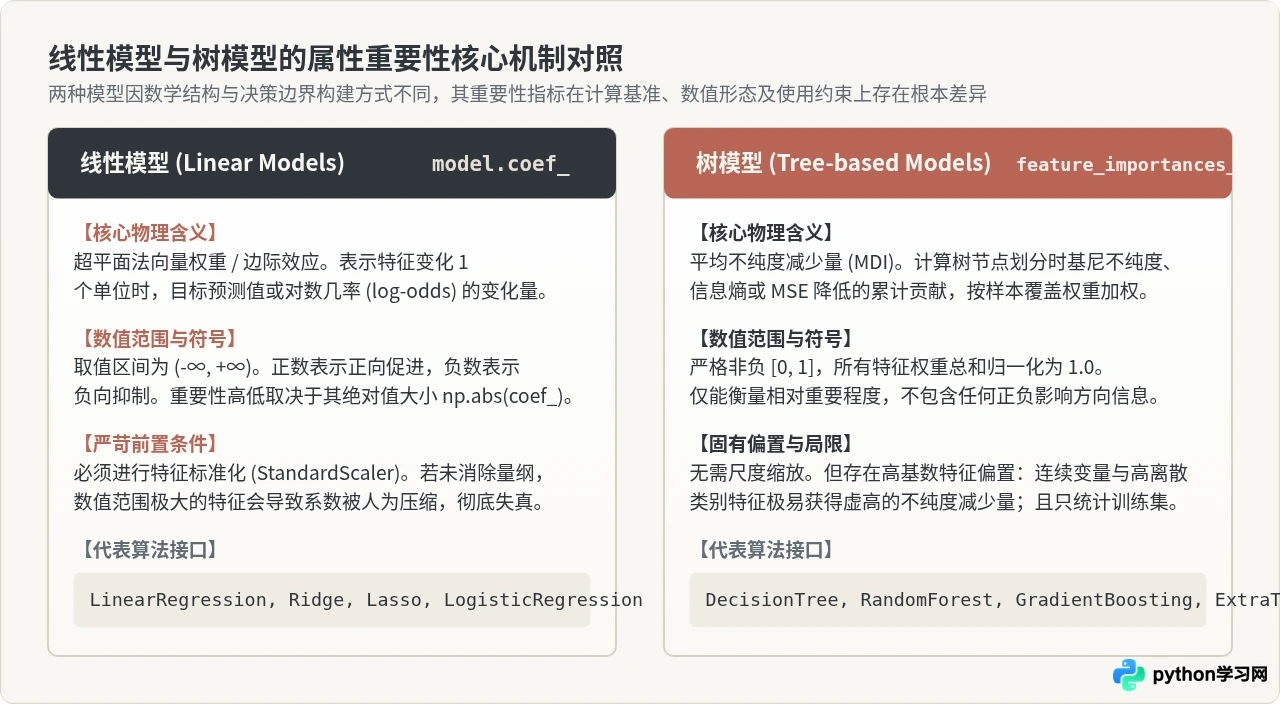
线性模型建立在输入特征与输出目标的线性映射假设之上。在这里,权重系数向量 coef_ 直接充当了决策超平面的法向量。每一个特征系数的绝对值代表单位变动所引发的目标变化幅度,符号(正负)则指明了促进或抑制的关系方向。然而,如果特征之间量纲相差悬殊(例如“年龄”范围为 0–100,而“年收入”范围为 10,000–1,000,000),未缩放的优化算法会自动为大数值特征分配极小的系数,导致直接比较 coef_ 彻底失去物理意义。
树模型则是基于特征空间的轴对齐切分(Axis-aligned splits)。每个树节点贪心地选取使子节点“不纯度”(分类任务中的基尼系数、信息熵,或回归任务中的均方误差 MSE)下降最大的特征与阈值。model.feature_importances_ 将全森林所有树节点中某个特征带来的加权不纯度减少量(MDI)进行累计,并对所有特征做归一化,使其总和恒等于 1.0。这意味着树模型重要性是非负的相对占比,天然对单调特征缩放免疫,但完全不包含特征与目标是“正相关”还是“负相关”的方向性信息。
二、线性模型特征重要性的提取与规范操作
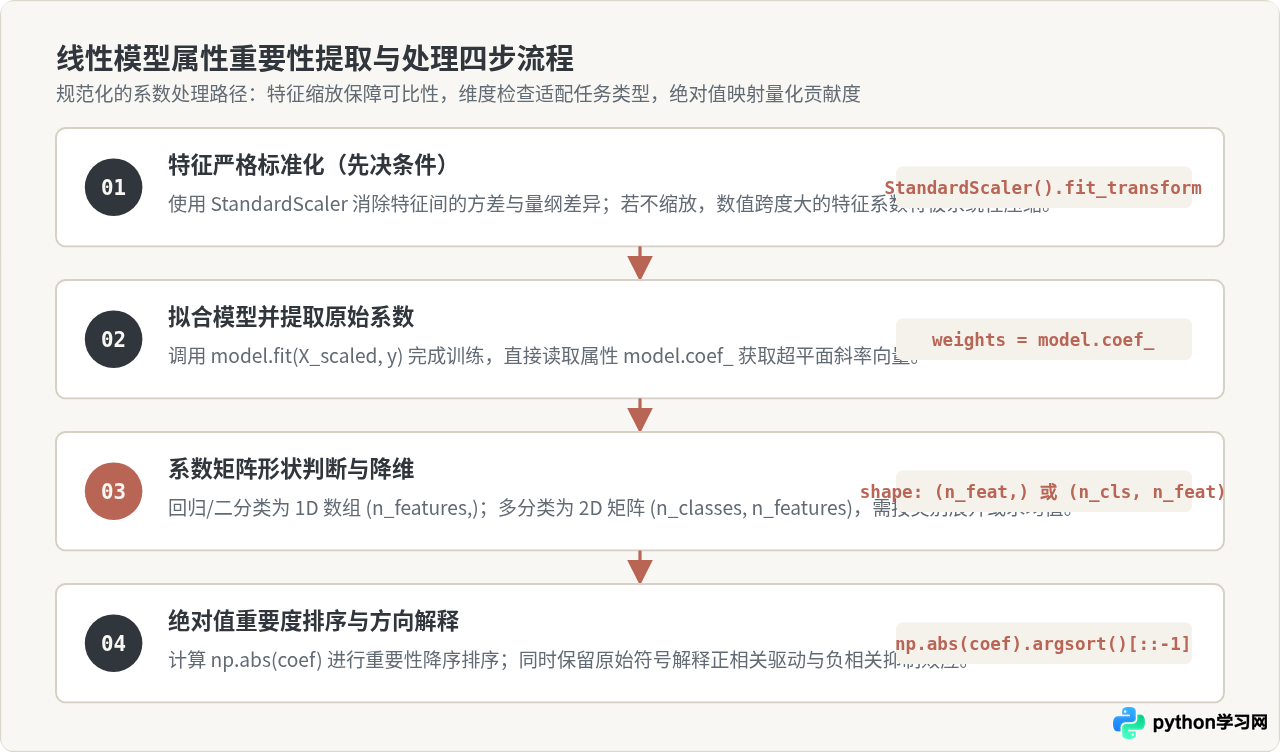
提取线性模型的特征重要性,必须严格遵循“预处理标准化 → 拟合模型 → 维度校验 → 绝对值转换与排序”的标准流程。
1. 关键前置:为什么必须做标准化
假设我们预测房价,特征 A 是房屋面积(单位:平方米,均值 100),特征 B 是房间数(均值 3)。若不做标准化,一间房间对总价的影响可能是数万元,而一平方米面积对总价的影响可能是几千元。回归模型拟合出的系数可能表现为面积系数为 3,000,房间数系数为 50,000。若仅按绝对值比较,读者会误认为房间数的重要性远高于面积;然而,面积变动 10 平方米(非常普遍)对总价的影响即为 30,000 元。
只有使用 StandardScaler 将所有特征转化到均值为 0、方差为 1 的无量纲分布后,系数才能真实反映“每个特征变动一个标准差时,预测目标变动的幅度”。
2. 线性模型特征重要性提取完整代码
下面的示例使用合成数据集,演示逻辑回归在标准化流水线下的系数提取与特征重要性分析:
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline

# 1. 构造具有不同量纲的模拟数据集
X, y = make_classification(
    n_samples=1000,
    n_features=5,
    n_informative=3,
    n_redundant=1,
    random_state=42
)
feature_names = [f"feat_{i}" for i in range(X.shape[1])]

# 2. 构建包含标准化的 Pipeline,避免数据泄露与手动管理缩放状态
pipe = Pipeline([
    ("scaler", StandardScaler()),
    ("classifier", LogisticRegression(penalty="l2", C=1.0, random_state=42))
])

# 3. 拟合模型
pipe.fit(X, y)

# 4. 提取拟合后的系数与截距
model = pipe.named_steps["classifier"]
coefs = model.coef_  # 二分类形状为 (1, n_features)

# 5. 校验维度并构建特征重要性 DataFrame
# 二分类时 coef_ 形状为 (1, n_features),取扁平数组 [0]
importance_df = pd.DataFrame({
    "feature": feature_names,
    "raw_coef": coefs[0],
    "importance": np.abs(coefs[0])
}).sort_values(by="importance", ascending=False).reset_index(drop=True)

# 6. 计算方向性标签
importance_df["direction"] = np.where(importance_df["raw_coef"] > 0, "正向促进 (+)", "负向抑制 (-)")
print(importance_df)
示例输出表格如下(数值根据实际拟合生成):
  feature  raw_coef  importance   direction
0  feat_1  1.428352    1.428352  正向促进 (+)
1  feat_2 -1.152410    1.152410  负向抑制 (-)
2  feat_0  0.723145    0.723145  正向促进 (+)
3  feat_3 -0.218902    0.218902  负向抑制 (-)
4  feat_4  0.031520    0.031520  正向促进 (+)
在多分类任务中(例如 n_classes = 3),LogisticRegression.coef_ 的形状为 (n_classes, n_features)。每一行代表对应类别的对数几率决策边界超平面。如果需要评估某个特征对整个模型的全局重要性,常用的处理方式是对各类别系数的绝对值取平均值:np.mean(np.abs(model.coef_), axis=0);若需要探究特定类别的驱动因素,则需针对具体类别的行向量单独解析。
三、树模型特征重要性的提取与注意事项
树系模型(包括单决策树 DecisionTreeClassifier/Regressor、随机森林 RandomForestClassifier/Regressor 以及梯度提升机 GradientBoostingClassifier/Regressor)均原生挂载了 feature_importances_ 属性。
1. 属性提取代码与排序展示
由于树模型不需要做特征缩放,我们直接训练随机森林并读取该属性:
import pandas as pd
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import make_classification

# 1. 生成样本数据
X, y = make_classification(
    n_samples=1000,
    n_features=5,
    n_informative=3,
    n_redundant=1,
    random_state=42
)
feature_names = ["age", "income", "credit_score", "debt_ratio", "noise_col"]

# 2. 训练随机森林分类器
rf = RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42)
rf.fit(X, y)

# 3. 读取 feature_importances_ 属性
importances = rf.feature_importances_

# 4. 汇总为 DataFrame 并按重要性降序排列
tree_importance_df = pd.DataFrame({
    "feature": feature_names,
    "importance": importances
}).sort_values(by="importance", ascending=False).reset_index(drop=True)

# 5. 校验归一化:所有特征重要性之和应严格等于 1.0
print(f"重要性总和: {importances.sum():.4f}")
print(tree_importance_df)
输出示例:
重要性总和: 1.0000
        feature  importance
0        income    0.384210
1  credit_score    0.312845
2           age    0.189320
3    debt_ratio    0.081412
4     noise_col    0.032213
2. MDI 的计算原理与致命盲区
虽然 feature_importances_ 调用极其简便,但在实际工程与业务决策中,如果未经审视直接使用 MDI 指标,极易被假象误导。
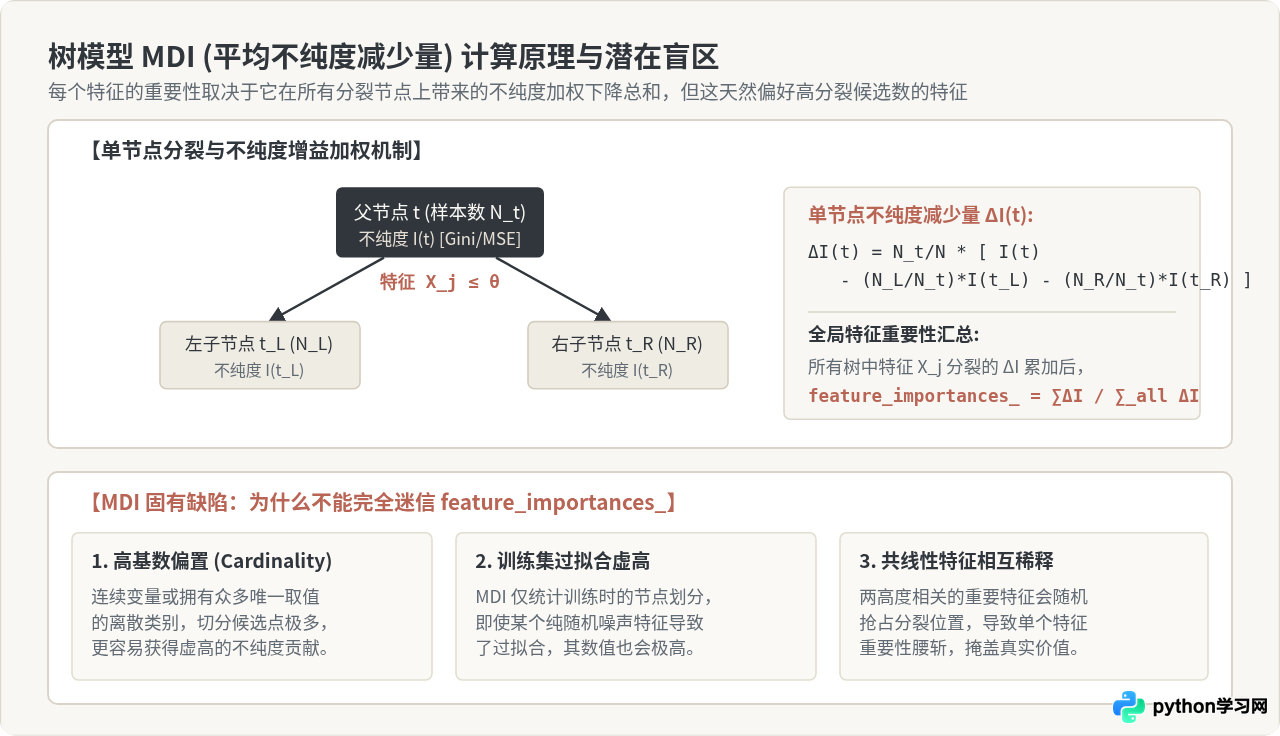
在理解图 3 的基础上,需要特别关注以下三个经典陷阱:
- 高基数特征偏置(High-cardinality Bias):树模型在寻找最优分裂点时,会遍历特征所有可能的切分阈值。连续型数值或具有大量类别的离散特征(例如用户 ID、精确时间戳或随机生成的浮点数),天然拥有成百上千个切分候选点。即使该特征与预测标签毫无关联,它也能通过切分训练集偶然降低不纯度,从而获得极其虚高的重要性分值。
-
仅基于训练集的过拟合偏差:MDI 衡量的是训练过程中的不纯度缩减。如果单棵决策树没有限制最大深度(
max_depth=None),树会一直分裂直到每个叶子节点完全纯净。此时,纯噪声特征所带来的训练不纯度下降会被完全计入重要性,而该模型在测试集上可能完全不具备泛化能力。 - 共线性特征的分摊稀释:当数据中存在两个高度相关的特征时(例如以厘米和以米为单位的身高),树在每次分裂时会随机二选一。这会导致原本极重要的特征被拆分为两个分数减半的特征,使得它们在排行榜上的名次双双下跌。
四、通用进阶方案:置换重要性 (Permutation Importance)
为了彻底解决树模型 MDI 的高基数偏置,以及在测试集上客观检验特征的真实泛化贡献,scikit-learn 提供了模型无关的检测工具:sklearn.inspection.permutation_importance。
1. 置换检验的工作机制
置换检验的核心逻辑非常直观:
- 在训练集上训练好模型(无论是树模型、线性模型还是神经网络)。
- 将模型应用到独立的测试集(Test Set)上,计算基准性能评分(如 Accuracy、AUC 或 R²)。
- 针对测试集中的某一列特征,随机打乱(Shuffle)其样本顺序,彻底打破该特征与真实标签的关联,同时保持该特征自身的边缘分布以及其他特征完全不变。
- 使用已有模型对打乱后的测试集再次预测,观察性能指标下降了多少。
- 性能下降越剧烈,说明该特征对模型的预测泛化能力越关键;如果指标几乎没有下降甚至上升,说明该特征对模型泛化毫无实质贡献。
2. 代码实战与 MDI 结果对比
from sklearn.inspection import permutation_importance
from sklearn.model_selection import train_test_split

# 划分训练集与测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

rf.fit(X_train, y_train)

# 在测试集上执行置换重要性检验(重复打乱 10 次计算均值与标准差)
result = permutation_importance(
    rf, X_test, y_test,
    n_repeats=10,
    random_state=42,
    scoring="accuracy"
)

# 汇总置换检验结果
perm_df = pd.DataFrame({
    "feature": feature_names,
    "perm_mean": result.importances_mean,
    "perm_std": result.importances_std
}).sort_values(by="perm_mean", ascending=False).reset_index(drop=True)

print(perm_df)
输出示例(包含统计不确定度):
        feature  perm_mean  perm_std
0        income   0.142000  0.018230
1  credit_score   0.108000  0.015421
2           age   0.054000  0.009812
3    debt_ratio   0.012000  0.005120
4     noise_col  -0.002000  0.003150
注意最后一项 noise_col 的 perm_mean 为负数(-0.002),这说明随机打乱该噪声特征后,测试集准确率反而略有提升。这在 MDI 中是永远无法发现的,因为 MDI 强制所有特征贡献非负。
五、总结与属性评估选型指南
为了帮助读者在面临具体建模任务时快速选取最恰当的属性重要性获取方案,下表对三种主要提取方式进行了全方位对照:
| 评估维度 | 线性模型 coef_ | 树模型 feature_importances_ | 置换重要性 permutation_importance |
|---|---|---|---|
| 计算开销 | 瞬时(直接读取训练参数) | 瞬时(模型拟合内生附带) | 中等(需多次打乱测试集重新推断) |
| 数据依赖 | 仅依赖训练完成的权重 | 仅反映训练集节点分裂情况 | 在独立的验证集/测试集上评估 |
| 量纲敏感度 | 极高(必须先做 StandardScaler) | 完全不敏感(单调变换不改变切分) | 完全不敏感(随机打乱不改动原值) |
| 数值特性 | 有正有负,可直接判断作用方向 | 非负,各特征之和等于 1.0 | 指标降幅,可正可负(负值代表噪声) |
| 主要缺陷 | 无法表达非线性关联 | 偏好高基数特征;容易被过拟合欺骗 | 强相关特征同时存在时可能低估重要性 |
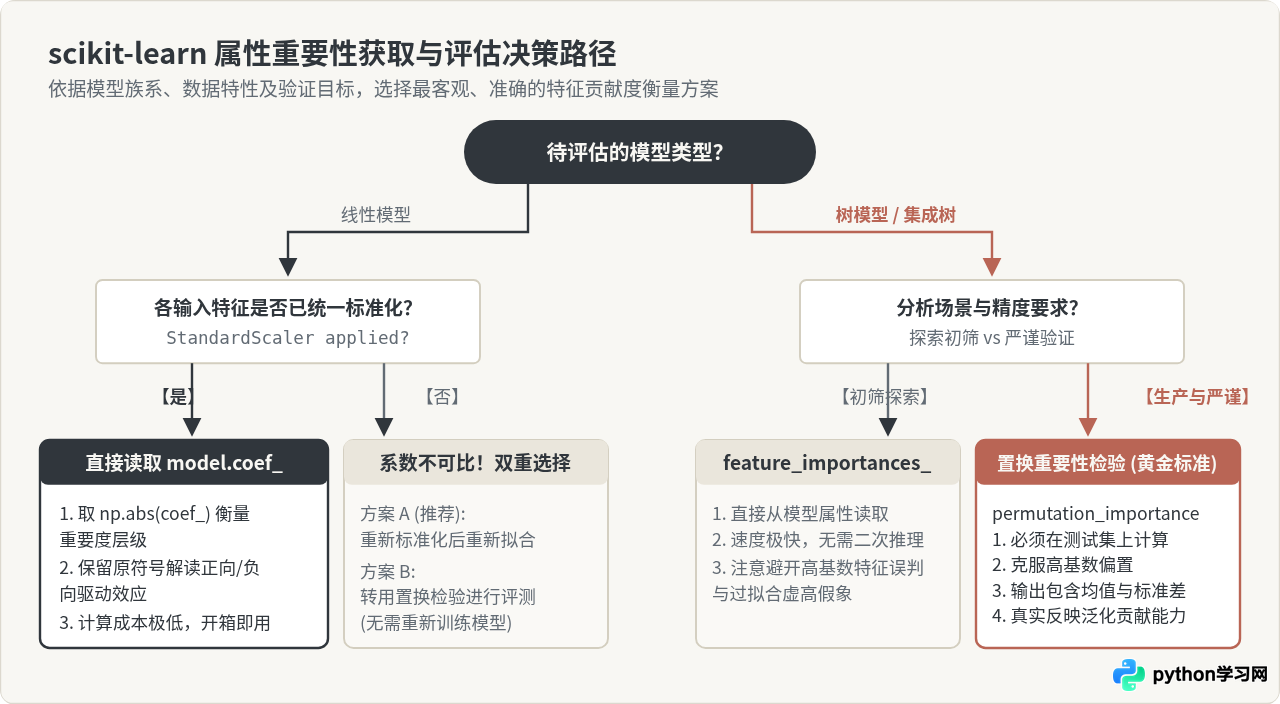
在实际研发实践中,推荐采取“分步推进”的最佳实践:在初步探索阶段,直接读取线性模型的 coef_(务必配合 StandardScaler)与树模型的 feature_importances_ 进行快速基线洞察;在进入最终特征筛选、业务归因报告或关键决策前,务必在验证集上运行 permutation_importance,交叉核对两者的重要性排名,从而剔除因过拟合与高基数带来的伪重要特征。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















