


Python中字典花括号与列表方括号内冒号的用法区别
深入解析Python中字典花括号与列表方括号内冒号的语法意义、底层机制、执行逻辑与常见报错排查。
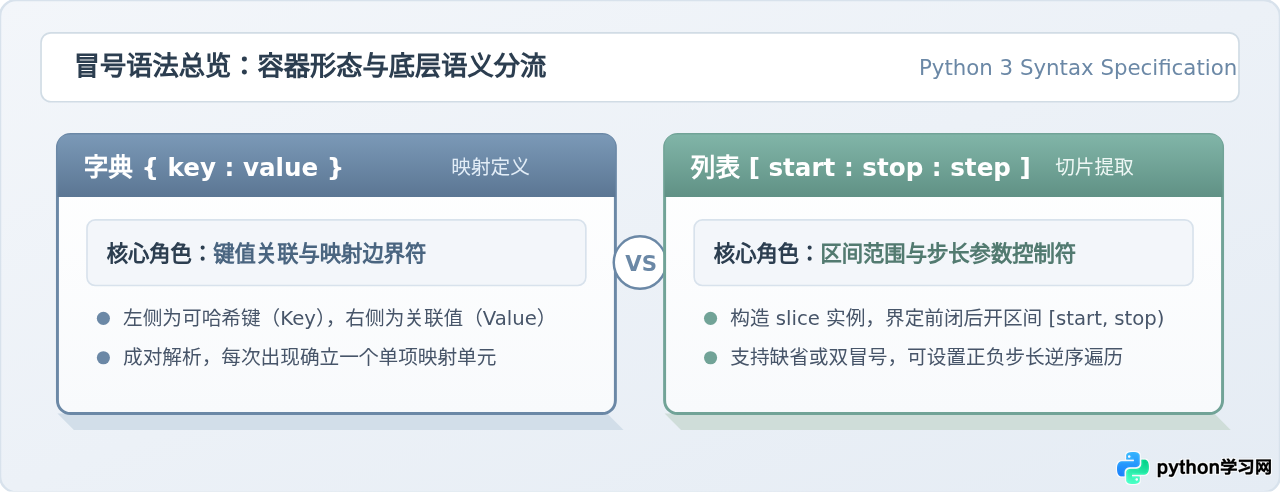
: 在不同容器括号内具有完全不同的语义:在字典花括号 {key: value} 中,冒号是键值对分隔符,用于在语法层面将键(Key)与其对应的值(Value)绑定并映射到底层哈希表中;在列表方括号 list[start:stop:step] 中,冒号是切片运算符(Slicing Operator),用于生成 slice 切片对象,指定提取元素的左闭右开区间与遍历步长。
1. 字典花括号内的冒号:键值对映射分隔符
在 Python 中,字典(dict)是基于哈希表实现的键值对映射集合。当我们在花括号内编写字面量或字典推导式时,冒号承担的是“键与值的绑定边界符”职责。
每个冒号连接左右两部分:冒号左侧为键(Key),右侧为值(Value)。它们作为一个不可分割的条目(Item)注入到底层的哈希表中。多个键值对之间使用逗号 , 分隔。
字典语法规则与必要条件
- 不可或缺的成对性:在普通字典字面量
{...}中,凡是不带冒号且包含元素的表达式,会被 Python 解析为集合(set)而非字典。例如{1, 2}是集合,而{1: 2}才是包含单个键值对的字典。 - 键的可哈希要求:冒号左边的对象必须是可哈希(Hashable)的不可变对象,例如整型、浮点型、字符串或元素不可变的元组;如果左侧传入列表或字典等可变对象,运行时将触发
TypeError: unhashable type: 'list'。 - 值的任意性:冒号右边的值可以是任意 Python 对象,包含可变容器、自定义对象甚至是另一个字典或函数引用。
# 字典字面量中的冒号用法
student_scores = {
    "Alice": 95,
    "Bob": 88,
    "Charlie": 92
}

# 字典推导式中的冒号用法
squared_map = {x: x ** 2 for x in range(1, 4)}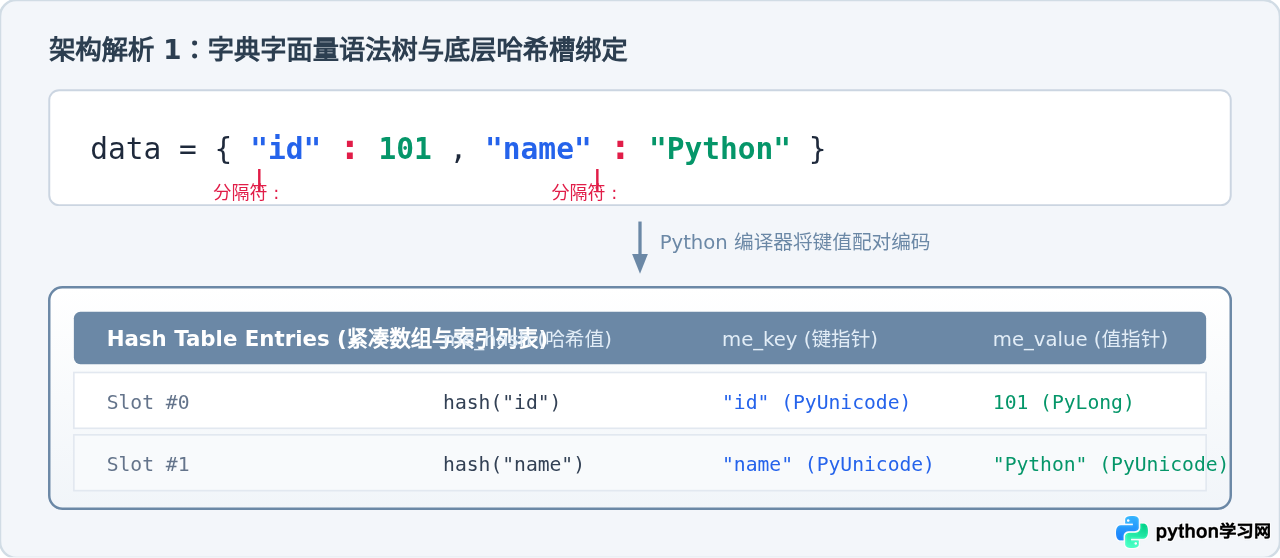
2. 列表方括号内的冒号:切片区间的范围定义符
列表(list)是一种支持快速随机访问的有序序列。当我们在列表的方括号 [] 中使用冒号时,冒号充当切片操作符(Slicing Operator)。它的本质不是存取单点索引,而是构建一个内置的 slice 切片对象。
切片的标准语法为:sequence[start:stop:step]。在语法解析时,Python 会将方括号内的内容等价转换为 sequence[slice(start, stop, step)],然后调用该序列的 __getitem__ 或 __setitem__ 方法。
切片语法的参数规则与边界推导
- 单冒号
[start:stop]:省略步长参数,此时默认步长step=1。截取的范围为左闭右开区间[start, stop),即包含起始下标为start的元素,一直截取到stop - 1,不包含stop下标处的元素。 - 双冒号
[start:stop:step]:第二个冒号用于引出步长。例如[::2]表示从序列开头以步长 2 跳跃提取元素;如果步长为负数(如[::-1]),遍历方向自动倒转为从右向左。 - 参数缺省规则:
- 正步长时,若
start缺省,默认为0;若stop缺省,默认为列表长度len(lst)。 - 负步长时,若
start缺省,默认为末尾索引-1;若stop缺省,截取将延伸至列表首位之前。
- 正步长时,若
numbers = [10, 20, 30, 40, 50, 60]

# 1. 基础单冒号:截取索引 1 到 4(不含 4)
sub_nums = numbers[1:4]

# 2. 缺省冒号:从索引 3 截取到末尾
tail_nums = numbers[3:]

# 3. 双冒号指定步长:跳跃截取与全列表逆序
evens = numbers[::2]
reversed_nums = numbers[::-1]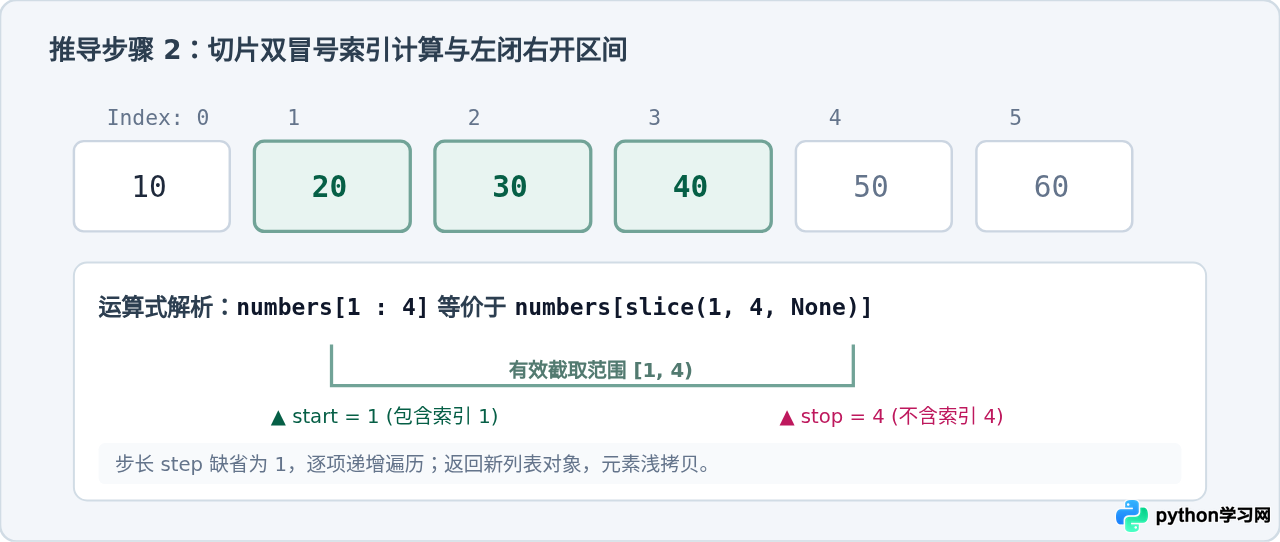
3. 核心行为与底层机制差异对比
为了透彻理解两者在使用时的本质不同,需要从AST语法树转换、内存开销以及赋值行为三个维度展开深入对比。
| 对比维度 | 字典花括号内 {k: v} |
列表方括号内 lst[i:j:k] |
|---|---|---|
| 语法角色 | 键值对边界符(Key-Value Delimiter) | 切片范围运算符(Slicing Operator) |
| 底层映射对象 | 构筑 dict 内部哈希槽映射项 |
构筑内置 slice(start, stop, step) 实例 |
| 时间复杂度 | 平均 O(1) 插入或查找 |
O(k),其中 k 为截取切片的元素个数 |
| 内存行为 | 分配哈希槽并引用对应对象 | 创建新列表并浅拷贝(Shallow Copy)原序列引用 |
| 冒号个数上限 | 每个键值对仅允许1个冒号 | 最多允许2个冒号(分隔起始、终止与步长) |
切片赋值与普通字典赋值的异同
一个极容易让初学者困惑的场景是切片赋值。在列表中,方括号内的冒号不仅可用于读取,还能进行批量替换,此时其赋值语义与字典完全不同:
- 字典赋值
d[key] = val:方括号内绝对不能使用冒号!字典取值或修改只接受单一的key。若误写为d["a":"b"],Python 会将"a":"b"解析为切片对象slice("a", "b", None),由于slice不可哈希,将抛出异常。 - 列表切片赋值
lst[start:stop] = iterable:列表支持使用带有冒号的方括号进行区间替换。它会直接修改原列表内部的指针数组,甚至允许替换长度不同的可迭代对象。
# 列表原位切片替换赋值
data = [1, 2, 3, 4, 5]
data[1:4] = [20, 30]  # 将 [2, 3, 4] 替换为 [20, 30]

# 清空列表并保留原对象内存地址
data[:] = []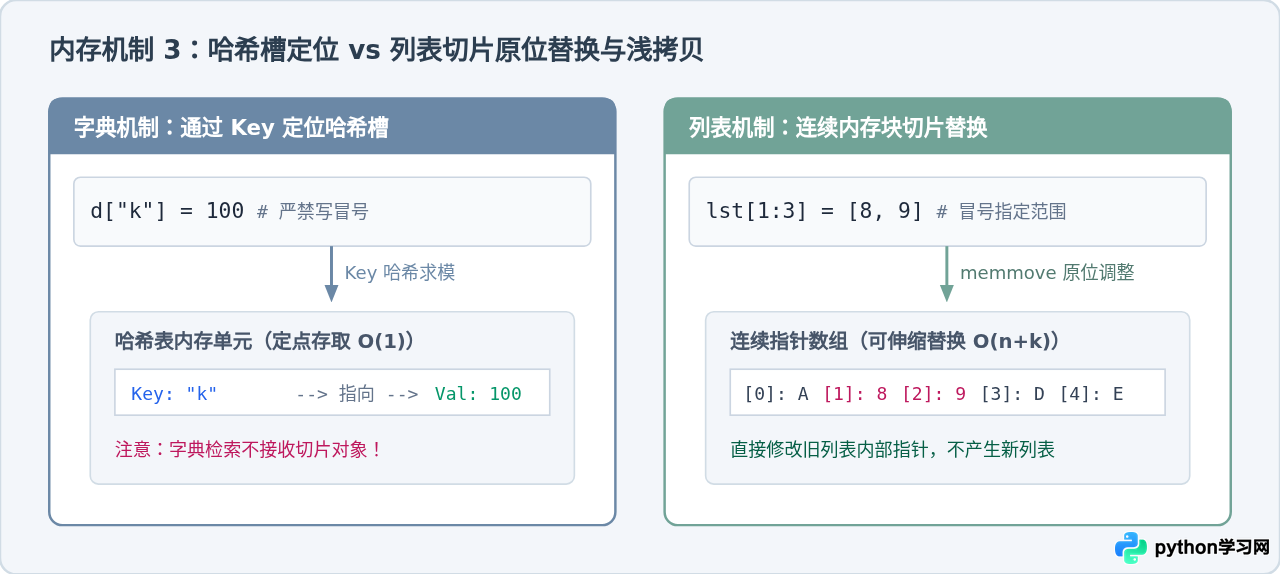
4. 常见误区与异常排查自查指南
初学者在混合使用列表与字典时,经常会因概念混淆而引发以下典型错误:
误区一:在字典索引访问中错误使用冒号
错误代码示例:d = {"name": "Bob"}; print(d["name":])
报错分析:在 d[...] 中写冒号,解释器会生成 slice("name", None, None)。字典底层查找需要计算键的哈希值,而 slice 类没有定义 __hash__,因此直接抛出:
误区二:在字典字面量中遗漏冒号或将集合与字典混写
错误代码示例:invalid_dict = {"a": 1, "b"}
报错分析:Python 在解析花括号时,根据内部是否存在冒号来判定是字典还是集合。若同一花括号内某项有冒号而另一项无冒号,语法解析器无法归纳构造函数,直接在编译期报错:
误区三:切片越界与字典越界的截然不同处理
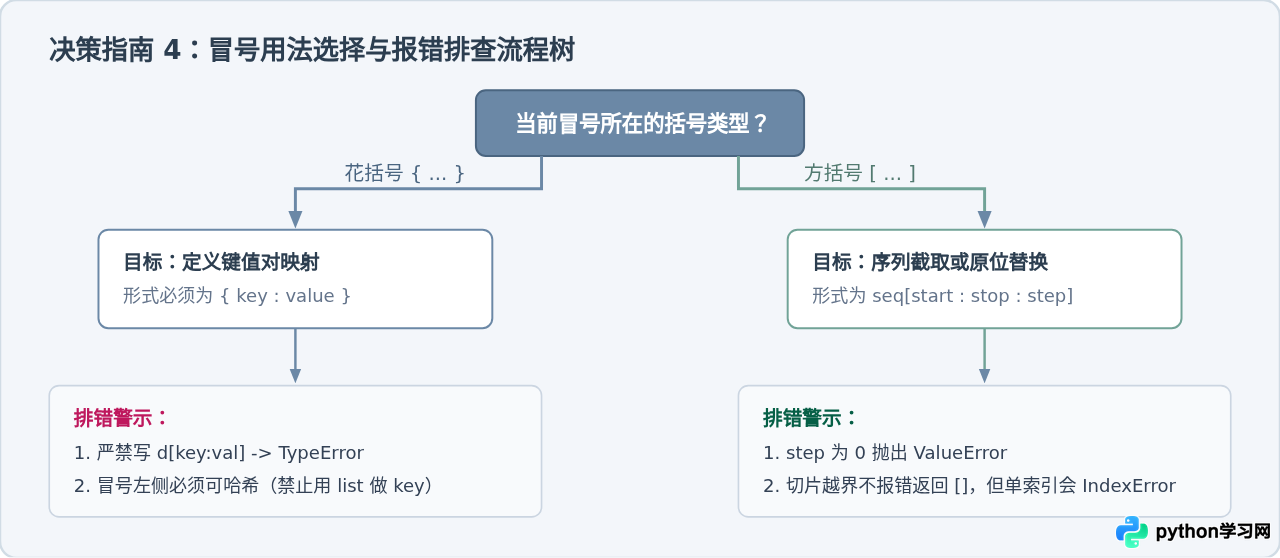
列表使用普通单索引越界(如 lst[999])会抛出 IndexError;但使用带有冒号的切片时,即使范围完全越界(如 lst[100:200]),Python 也绝不会报错,而是安全地返回空列表 []。
相反,字典访问不存在的键时(如 d["unknown"]),直接抛出 KeyError。
总结
归纳而言,Python 容器中的冒号并不神秘,关键在于括号决定的上下文环境:
- 在字典花括号
{}中,冒号是“二元关系粘合剂”,将左边的哈希键与右边的值绑定为不可分割的映射对。 - 在列表方括号
[]中,冒号是“多维区间切分符”,通过构建slice实例,精确划分序列遍历的起点、终点与步长。
牢记这一本质差异,便能在日常编程中迅速避开 TypeError: unhashable type: 'slice' 以及因区间边界计算引起的逻辑缺陷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















