


利用repr()查看Python字符串中的隐藏控制字符
详细讲解在Python中如何使用内置的repr()函数快速排查和显形字符串中的隐藏控制字符(如回车符、制表符、空字符及零宽字符等),分析print()与repr()的底层机制差异,提供清晰的诊断工作流、对照表与清洗方案。
a == b 返回 False)”或者“字符串长度与肉眼看到的字符数不符”的怪异现象。这类问题绝大多数由文本中夹带的回车符、制表符、零宽字符或底层空字符等控制字符导致。直接使用 print() 无法察觉这些字符,因为终端已将其渲染或隐匿;而 Python 原生内置的 repr() 函数能够输出包含显式转义代码的官方字符串形态,是排查此类文本隐患最直接、高效的利器。
一、为什么 print() 掩盖了问题真相
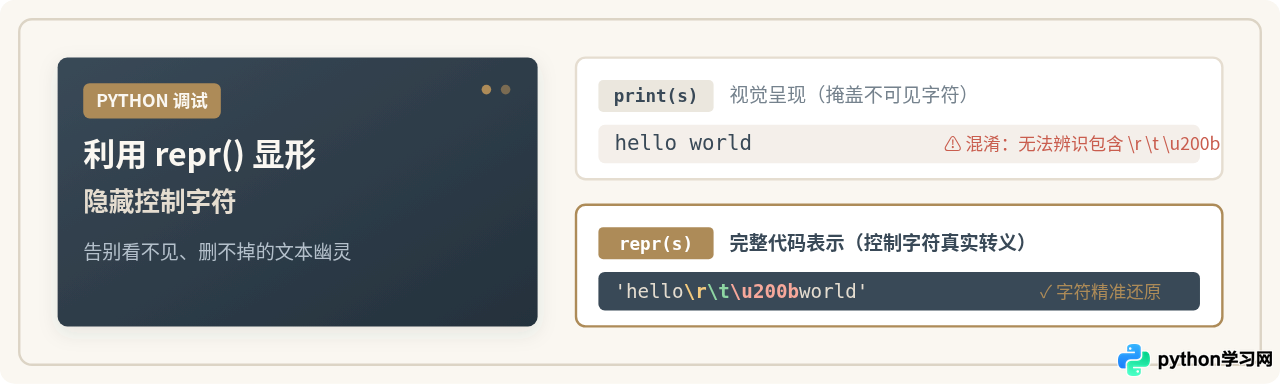
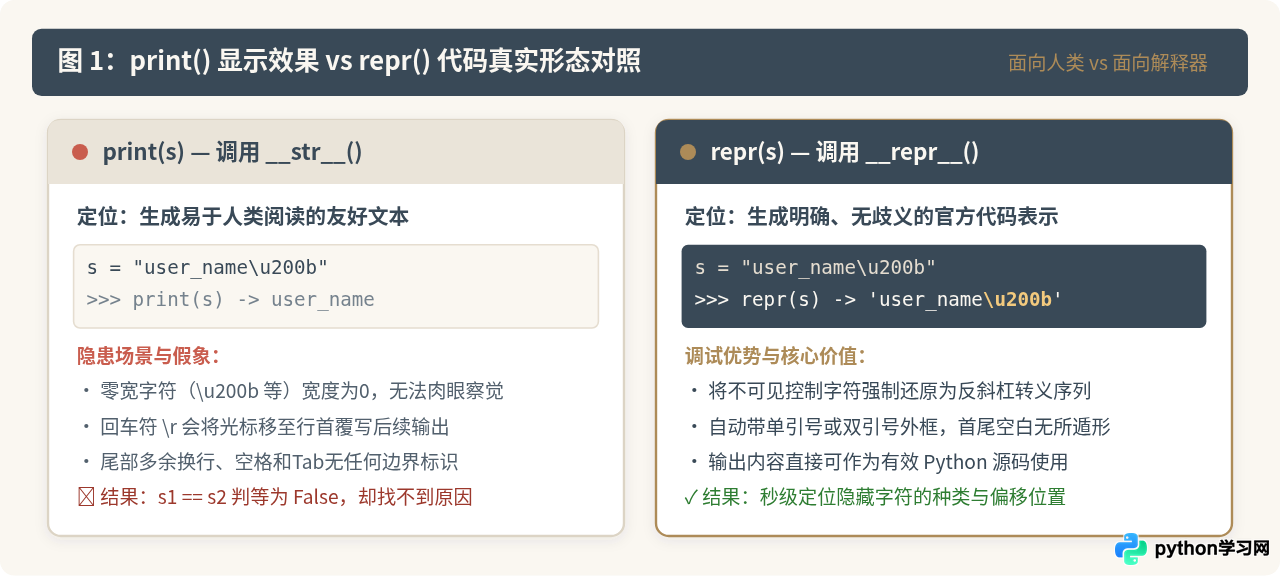
Python 解释器在执行 print(s) 时,本质上是在调用对象底层的 __str__() 魔法方法。该方法的设计宗旨是“输出易于人类阅读的友好文本”,因此会忠实地把控制字符交给终端驱动来解释:换行符触发换行,制表符扩展为空白对齐,而像零宽字符这类不可见字符,终端直接以 0 像素宽度渲染,导致视觉上完全隐形。
常见的视觉假象主要包含以下三类具体表现:
- 回车符(
\r)覆盖前文:在早期 MacOS 或特定行协议中,单独的回车符会将终端光标挪至当前行的最左侧。如果后面紧接着其他字符,光标会直接原地重写,造成前半截字符串在终端上“凭空消失”,日志看似被截断。 - 零宽空格(
\u200b)完全隐匿:零宽连字与零宽空格常用于网页文本防爬、排版微调或即时通讯软件。它们在 Python 字符串中占据真实的字符索引和内存,但无论在终端还是图形编辑器中,渲染宽度都为 0。 - 不可见空白填充:字符串末尾的多余普通空格、制表符(
\t)以及换行符,在没有边框参照的情况下,肉眼完全无法察觉,却会导致精准匹配条件全部失效。
下面通过一段具体的代码演示这一矛盾:
# 模拟从外部文件或接口读取到的两个看似相同的用户名
s1 = "admin"
s2 = "admin\u200b"  # 末尾混入零宽空格

# 示例运行与输出
print("print(s1):", s1)
print("print(s2):", s2)
print("长度对比:", len(s1), len(s2))
print("相等性判断:", s1 == s2)
运行上述代码后,终端输出的示例结果如下:
print(s1): admin
print(s2): admin
长度对比: 5 6
相等性判断: False
从输出中可以看到,两行 print 打印的文本完全没有区别,但 len(s2) 却为 6,并且 s1 == s2 判定为 False。如果仅依靠 print(),排查者很容易陷入怀疑解释器或比对逻辑的死胡同。
二、利用 repr() 排查隐藏字符的核心操作步骤
要刺破 print() 营造的视觉假象,只需将输出目标包裹在 repr() 中。repr() 会返回对象的“官方代码字符串表示”(Official Representation),并且会自动将所有不可打印字符及特殊控制字符替换为反斜杠引导的转义序列。
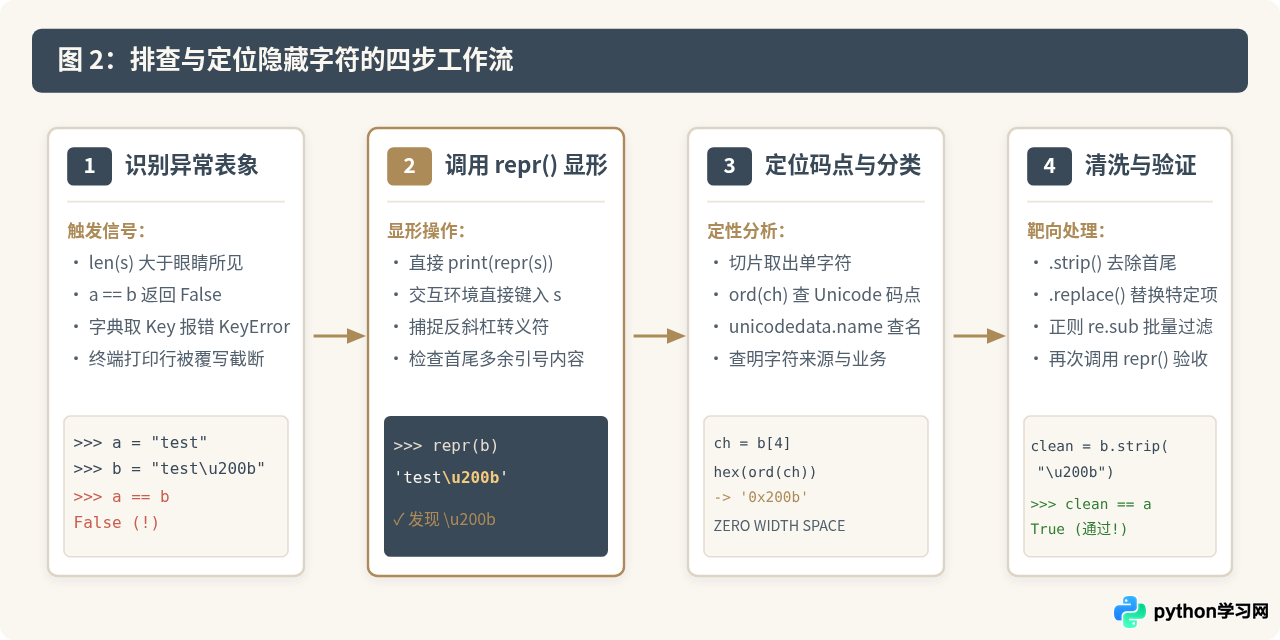
在日常开发与线上问题排查中,建议遵循以下四个具体步骤进行系统定位:
步骤 1:捕获异常信号
当业务逻辑出现以下异常信号之一时,应首先警惕控制字符的存在:
- 两个打印看似完全相同的字符串,执行
==或in判定却返回False; - 使用字典或哈希集合取值时,明确存在的键报出
KeyError; len(s)结果明显大于可见字符的个数;- 终端打印某行日志时,前面的文字被部分覆盖或吞掉。
步骤 2:使用 repr() 进行显形化输出
在交互式环境(如 Python REPL、IPython 或 Jupyter Notebook)中,直接输入变量名回车求值,或者在脚本中使用 print(repr(s)),亦或采用 f-string 的调试修饰符 f"{s!r}":
# 在终端中直接打印 repr 结果
print("s1 的代码形式:", repr(s1))
print("s2 的代码形式:", repr(s2))

# 使用 f-string 的 !r 转换符
print(f"调试变量: {s2!r}")
此时控制台给出的示例输出如下:
s1 的代码形式: 'admin'
s2 的代码形式: 'admin\u200b'
调试变量: 'admin\u200b'
repr() 的输出具有两个关键特征:第一,字符串两端被单引号包裹,这使得首尾隐藏的空格与换行能够立即通过边界暴露出来;第二,零宽空格被无所遁形地展现为 \u200b 转义符。
步骤 3:精确定位码点与字符语义
一旦发现了形如 \xNN、\uNNNN 的转义符,若需要进一步探究其字符定义与来源,可以结合切片与内置函数 ord() 提取出 Unicode 整数码点,并借助标准库 unicodedata 查询其标准名称:
import unicodedata

# 取出混入的第 6 个字符
hidden_char = s2[5]

code_point = ord(hidden_char)
char_name = unicodedata.name(hidden_char, "未知控制符")

print(f"字符十六进制码点: {hex(code_point)}")
print(f"Unicode 规范名称: {char_name}")
示例输出:
字符十六进制码点: 0x200b
Unicode 规范名称: ZERO WIDTH SPACE
步骤 4:针对性清洗与回归验证
查清隐藏字符后,根据业务特征选择清理手段:若是边界混入空白或换行,使用 str.strip();若是特定字符,使用 str.replace();若是批量混入的隐藏控制符,使用正则表达式过滤。处理完成后,必须再次使用 repr() 验证是否彻底干净。
三、repr() 的底层运作机制与转义规则
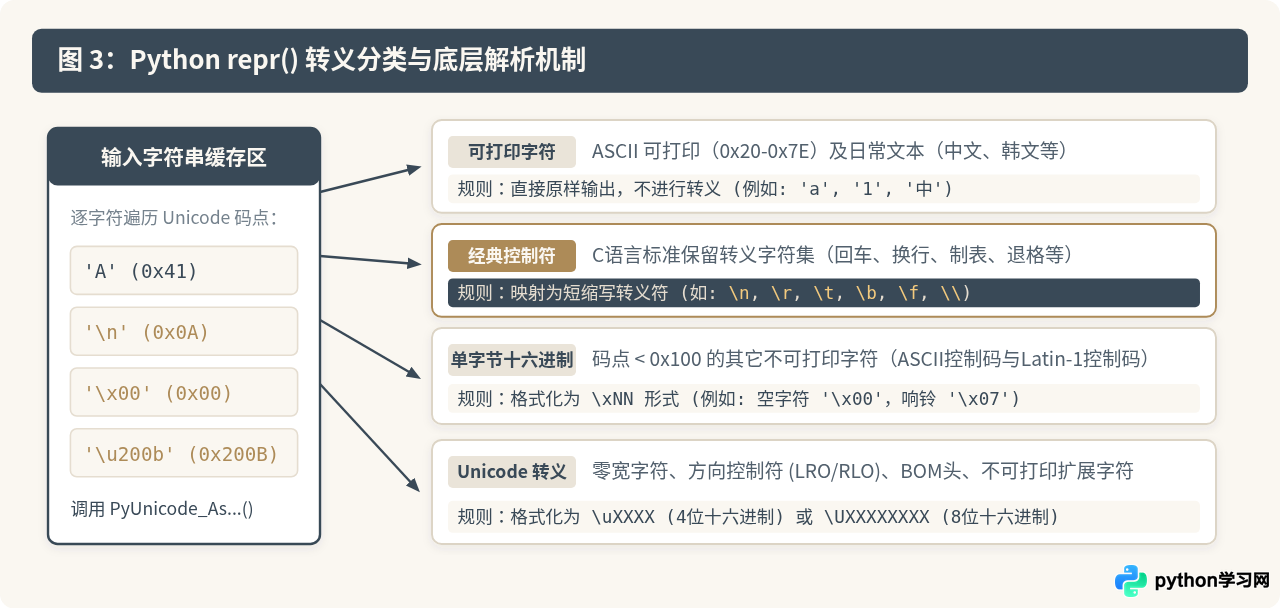
了解 repr() 是如何将内部字节转换为转义字符串的,有助于我们在面对复杂的转义输出时迅速建立直觉。在 Python 内部,repr(s) 会触发 CPython 核心的 unicode_repr() 函数(其在 C API 中对应 PyUnicode_AsASCIIString 及相关序列化实现)。
Python 解释器在对字符串执行 repr 操作时,会逐个遍历字符并遵循严格的分支分类规则:
- ASCII 可打印范围(0x20 至 0x7E):字符在 ASCII 编码中具有明确字形,如字母、数字及常见标点,直接原样输出,不加任何转义。
- 经典短转义符(Escape Sequences):对于 C 语言传统保留的不可打印控制字符,转换为对应的双字符短缩写,例如换行符映射为
\n(0x0A)、回车符映射为\r(0x0D)、制表符映射为\t(0x09)、退格映射为\b(0x08)以及报警符映射为\a(0x07)。 - 单字节十六进制转义(
\xNN):对于码点小于 256(0xFF)且不属于上述经典短转义的其它不可打印控制字符(如 0x00 空字符、0x1B ESC 控制符),格式化为两位的十六进制\xNN。 - 多字节 Unicode 转义(
\uXXXX与\UXXXXXXXX):对于大于 256 且属于不可见或特定控制类别的 Unicode 字符(例如零宽空格\u200b、字节顺序标记\ufeff等),格式化为 4 位或 8 位的大写十六进制代码。
在 Python 3 中,repr() 会保留可打印的非 ASCII 字符(例如中文汉字、日文假名等,如 repr("中国") 输出 '中国')。而 ascii() 函数则更加激进,它会把所有非 ASCII 字符(无论是否可打印)全部转义为 \uXXXX。因此,在日常调试中,repr() 是观察中英文混排文本控制字符的最佳选择,既能看懂中文内容,又能精准抓出异常控制符号。
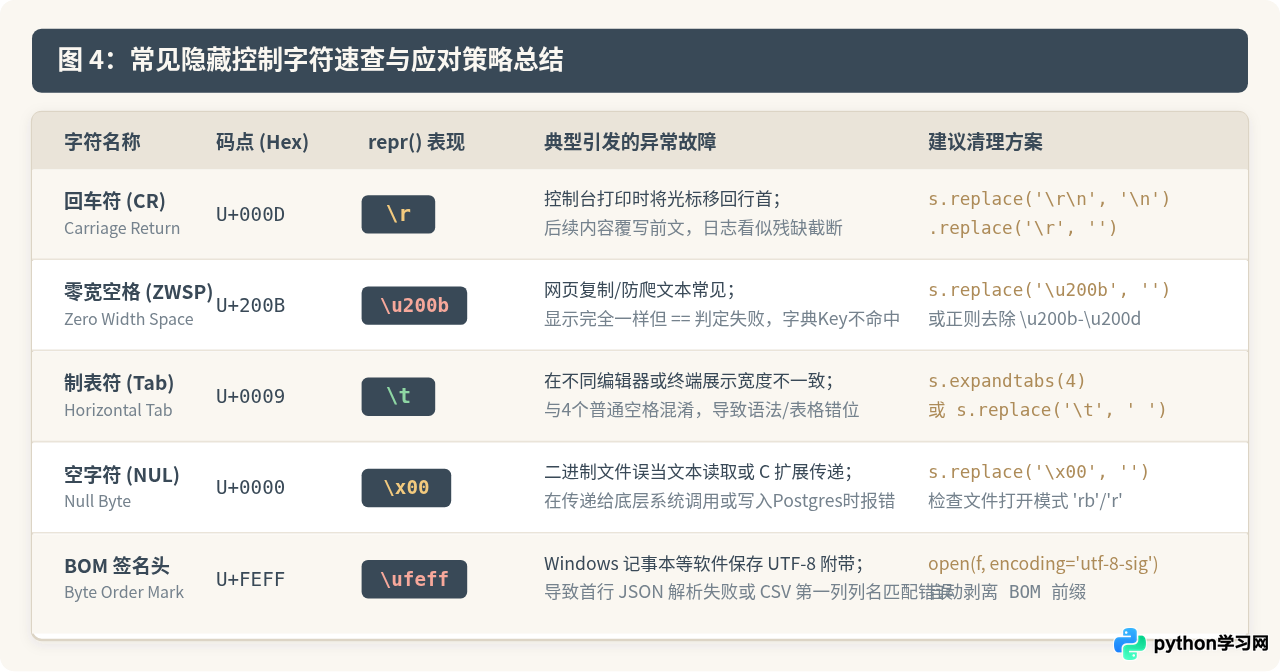
四、常见隐藏控制字符速查与针对性清洗方案
在工程实践中,隐藏字符并非随机产生,绝大多数都有明确的外部来源。下表梳理了最常见的 5 类控制字符及其在 repr() 中的标识、典型故障特征与推荐应对手段:
1. 回车符 \r:消除行覆盖与末尾截断
回车符多来源于旧式跨平台文件混用或 Windows 下 \r\n 仅被不当剥离了 \n 的情况。在 Linux 或 macOS 终端下,\r 会重置当前行输出位置,造成日志打印被后续文本覆盖。
# 针对文本中的回车符进行正规化处理
raw_text = "status: 200\r\nmessage: ok\r"
clean_text = raw_text.replace("\r\n", "\n").replace("\r", "")
print(repr(clean_text))  # 验证:'status: 200\nmessage: ok'
2. 零宽字符 \u200b:识别与批量剥离
零宽空格(ZWSP)以及与其同族的零宽不连字(ZWNJ \u200c)、零宽连字(ZWJ \u200d)常见于从特定网站复制粘贴的内容,或被用作隐式数据水印。针对这种字符,单靠 str.strip() 是无法去除的(因为它们不属于标准 ASCII 空白),必须显式替换或使用正则表达式:
import re

raw_input = "user\u200b_\u200cname"
# 使用正则匹配所有常见的零宽格式字符
clean_user = re.sub(r"[\u200b-\u200d\ufeff]", "", raw_input)
print(repr(clean_user))  # 验证:'user_name'
3. BOM 头 \ufeff:在文件读取源头拦截
BOM(Byte Order Mark)常见于 Windows 记事本等编辑器保存的 UTF-8 文件。如果不做处理,它会成为字符串的第一个字符 \ufeff,直接导致 json.loads() 报错 JSONDecodeError,或使 CSV 表头第一列无法被准确匹配。最规范的做法不是在读取后 replace,而是在打开文件时指定支持 BOM 自适应的编码:
# 推荐方案:使用 'utf-8-sig' 模式打开文件,Python 会自动识别并剔除 BOM
with open("data.csv", mode="r", encoding="utf-8-sig") as f:
    header = f.readline()
    print(repr(header))  # 首字符不会再包含 \ufeff
4. 通用工业级文本清洗管道
如果需要在数据清洗流水线(如 NLP 处理、日志采集器)中防御各种不可预知的控制字符,可以利用 Python 标准库的 unicodedata.category() 编写通用清洗函数。在 Unicode 标准中,所有不可打印控制字符属于 Cc(Other, Control)类别,格式字符属于 Cf(Other, Format)类别:
import unicodedata

def sanitize_control_characters(text: str, keep_newlines: bool = True) -> str:
    """
    通用控制字符清洗管道:
    过滤所有非打印控制字符(Cc)与零宽格式符(Cf),同时按需保留合法换行和Tab。
    """
    clean_chars = []
    for ch in text:
        cat = unicodedata.category(ch)
        # 保留必要的常用格式符:换行 \n、制表 \t
        if keep_newlines and ch in ("\n", "\t"):
            clean_chars.append(ch)
        # 过滤其它所有控制字符(Cc)与格式控制符(Cf)
        elif cat not in ("Cc", "Cf"):
            clean_chars.append(ch)
    return "".join(clean_chars)

# 综合验证清洗效果
dirty = "Hello\x00World!\r\nData:\t\u200bTest\ufeff"
cleaned = sanitize_control_characters(dirty)
print("清洗前:", repr(dirty))
print("清洗后:", repr(cleaned))
示例输出:
清洗前: 'Hello\x00World!\r\nData:\t\u200bTest\ufeff'
清洗后: 'HelloWorld!\nData:\tTest'
五、开发与日志输出的最佳实践
在日常编码和日志输出中,建议养成以下两项防御性习惯:
- 调试日志优先使用
%r或{var!r}:在打排错日志时,特别是涉及外部传入的主键、ID、用户名和请求参数时,使用logger.debug("处理目标: %r", target),一旦传入的值含有首尾空格或脏数据,在日志中一眼就能看清。 - 编写单元测试前用
repr()验证断言差异:当单元测试报告两个字符串不相等(如AssertionError: 'abc' != 'abc')且视觉上无差异时,不要反复比对肉眼所见,应立即使用repr()分别打印实际值和预期值,通常只需几秒钟即可锁定隐秘的不可见字符。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















