


求职竞争力提升:后端、数据与算法方向的Python实战项目选题
针对Python后端开发、数据工程与分析、算法与大模型方向,提供具备真实生产约束、架构深度与可量化指标的实战项目选题指南,帮助求职者突破同质化Demo瓶颈,切实提升求职竞争力。
一、为什么传统 Demo 失去竞争力:面试官的核心评估标准
在招聘筛选中,技术面试官最先排除的往往是“课程同质化项目”。这类项目的典型特征是:只有单机无状态的简单增删改查(CRUD),缺少生产级真实约束,未考虑服务异常容灾,且没有可观测性与性能基准指标。
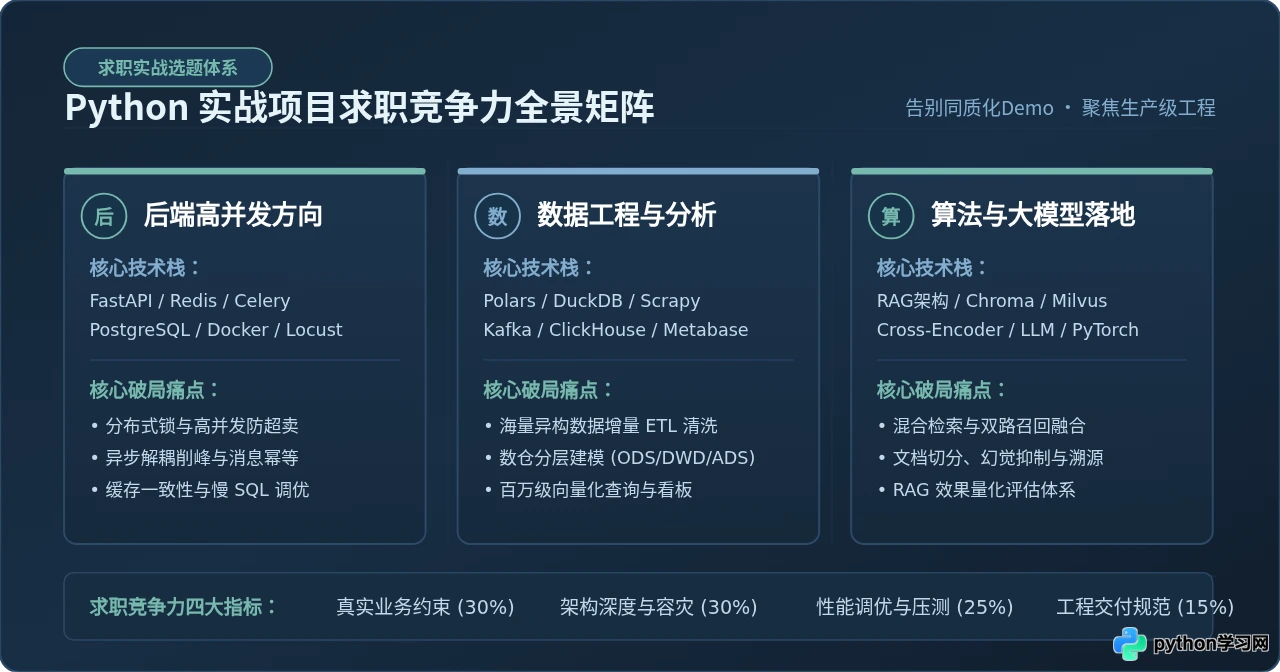
企业引入工程师,本质上是为了解决特定业务场景中的工程复杂度与系统可靠性。一个具备高竞争力的 Python 实战项目,必须在以下四个核心维度上形成清晰的工程证据:
- 业务场景真实度(30%):项目需具备清晰的业务背景与冲突场景(如库存争抢、异步削峰、海量异构数据聚合清洗、专业领域知识准确检索),而非空洞的字段入库。
- 系统架构深度(30%):合理运用中间件与分层设计(如 Redis 缓存与分布式锁、消息队列解耦、列式数仓分层、双路召回与重排机制),并能自圆其说各个组件的技术选型依据。
- 性能调优与压测(25%):提供明确的性能基准。通过压测工具暴露出连接池枯竭、慢查询、内存泄漏或上下文窗口溢出等瓶颈,并记录具体的调优手段与优化前后对比数据。
- 工程化交付规范(15%):具备类型注解(Type Hints)、结构化配置隔离、自动化测试用例(pytest)、容器化编排(Docker Compose)与清晰的部署文档。
二、三大技术方向核心架构与技术演进对比
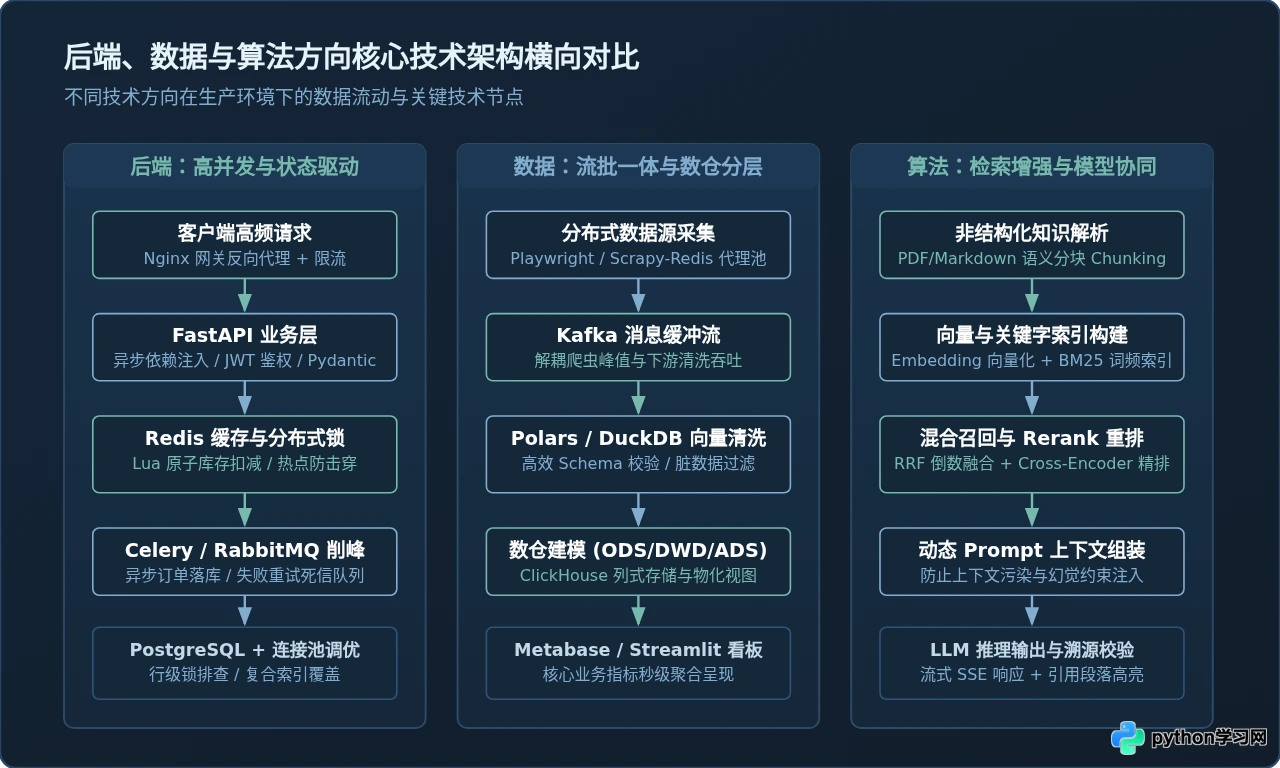
不同求职岗位的关注点差异显著。后端开发看重系统的高吞吐、低延迟与并发一致性;数据工程看重数据的吞吐管道、清洗质量与数仓建模;算法与大模型方向则聚焦于语义召回准确率、幻觉抑制与业务结合深度。
| 技术方向 | 同质化淘汰选题 | 高竞争力推荐选题 | 核心突破技术点 |
|---|---|---|---|
| Python 后端开发 | 学生信息管理系统、博客后台、简易图书商城 | 分布式高并发预约秒杀与限流系统 | Redis+Lua 原子防超卖、Celery/RabbitMQ 异步削峰、延迟双删保证双写一致性、Locust 压测调优 |
| 数据工程与分析 | 静态抓取某电影 Top250 并画柱状图、单表 Excel 汇总 | 全网电商价格波动监控与数仓分层分析管道 | Playwright 动态渲染抓取、Kafka 消息缓冲、Polars/DuckDB 高效 ETL 清洗、ClickHouse 数仓分层建模 |
| 算法与大模型 | 鸢尾花分类、波士顿房价预测、调用 OpenAI API 做套壳聊天 | 企业级多源知识库 RAG 检索增强系统 | 文档结构化切分 (Chunking)、Dense+BM25 双路混合召回、Cross-Encoder 重排、幻觉抑制与溯源评估 |
三、方向一:Python 后端开发实战选题详解
推荐选题:高并发商品秒杀与预约库存系统
在后端面试中,秒杀场景是检验求职者是否真正理解高并发架构的标准试金石。该项目不要求庞大的前端界面,但要求在单机或多实例下,用严谨的并发控制应对数千 QPS 的瞬时突发流量。
核心架构设计:
- 入口层限流防刷:基于 Redis 滑动窗口或令牌桶算法,在 FastAPI 中间件层拦截高频刷单请求。
- 库存原子预扣减:将数据库写操作前置到 Redis,使用 Lua 脚本执行
get与decrby原子操作,彻底杜绝高并发环境下的超卖问题。 - 异步消息削峰:Redis 扣减成功后,生产端向 RabbitMQ/Celery 发送订单创建消息;消费者平滑地将订单持久化写入 PostgreSQL 数据库。
- 缓存与数据库双写一致性:引入延迟双删或基于监听 Binlog 的方案,保证数据库与缓存数据的最终一致性。
下面是秒杀核心路由的完整实现。通过 Lua 脚本将“检查库存”与“扣减库存”打包在 Redis 单线程中原子执行,避免了高并发竞态条件:
import asyncio
import redis.asyncio as aioredis
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="High Concurrency Flash Sale Engine")

# 初始化 Redis 异步连接池(实际生产需配置合理的 max_connections)
redis_pool = aioredis.ConnectionPool.from_url(
    "redis://localhost:6379/0", decode_responses=True, max_connections=50
)
redis_client = aioredis.Redis(connection_pool=redis_pool)

# Lua 原子扣减库存脚本
# KEYS[1]: 库存键名 (如 stock:goods_1001)
# ARGV[1]: 扣减数量 (如 1)
# 返回值: 1 扣减成功; 0 库存不足; -1 商品不存在
SEC_KILL_LUA_SCRIPT = """
local stock_key = KEYS[1]
local buy_num = tonumber(ARGV[1])

local current_stock = redis.call('get', stock_key)
if not current_stock then
    return -1
end

if tonumber(current_stock) >= buy_num then
    redis.call('decrby', stock_key, buy_num)
    return 1
else
    return 0
end
"""

class OrderRequest(BaseModel):
    user_id: int = Field(..., description="用户ID")
    goods_id: int = Field(..., description="商品ID")
    quantity: int = Field(1, ge=1, le=5, description="购买数量")

@app.post("/api/v1/seckill/order", status_code=status.HTTP_200_OK)
async def process_seckill_order(order: OrderRequest):
    stock_key = f"stock:goods_{order.goods_id}"

    # 执行 Lua 脚本保证原子扣减
    result = await redis_client.eval(SEC_KILL_LUA_SCRIPT, 1, stock_key, order.quantity)

    if result == -1:
        raise HTTPException(status_code=404, detail="秒杀商品不存在或活动未初始化")
    elif result == 0:
        raise HTTPException(status_code=400, detail="商品库存已售罄")
    elif result == 1:
        # 扣减成功,将订单创建任务异步推入消息队列削峰(以模拟后台异步任务为例)
        asyncio.create_task(dispatch_order_to_mq(order.user_id, order.goods_id, order.quantity))
        return {"status": "success", "message": "排队成功,订单正在生成中"}
    else:
        raise HTTPException(status_code=500, detail="系统并发异常")

async def dispatch_order_to_mq(user_id: int, goods_id: int, quantity: int):
    # 模拟推入 RabbitMQ / Celery 任务队列
    await asyncio.sleep(0.01)
    # 此处完成落库并记录流水
性能压测与调优步骤:
使用 Python 压测工具 Locust 编写压测脚本,模拟 1000 个并发用户冲刺 /api/v1/seckill/order 接口。
在未引入 Redis Lua 前,直接采用 PostgreSQL SELECT ... FOR UPDATE 行级锁,系统在 300 并发时出现数据库连接池耗尽、大量请求超时(响应耗时 > 1200ms)。
引入 Redis 预扣减与 Celery 异步队列后,数据库写压力被彻底削峰平摊,系统吞吐量稳定达到 2800+ QPS,P99 延迟稳定在 35ms 以内,测试库存为 100 件时,实测出库精准为 100 件,超卖率为 0。
四、方向二:Python 数据工程与分析实战选题详解
推荐选题:全网电商价格监控与流批一体数仓分析系统
数据岗位最忌讳的是只会从 Kaggle 下载一个干净的 CSV 做静态描述性统计。生产环境中的数据大多是非结构化、存在脏乱缺失、并持续实时产生的。 本选题构建一套从“动态反爬数据采集”到“流式清洗”、“数仓分层建模”再到“指标看板”的完整管道。
核心链路与工程设计:
- 反爬与分布式采集层:采用 Playwright 结合异步代理池,解决主流电商平台针对无头浏览器(Headless)的环境指纹检测,支持断点续爬与分布式增量调度。
- 数据流缓冲与解耦:采集到的原始 JSON 数据流实时写入 Kafka Topic,防止短时间暴增的爬虫数据压垮下游解析服务。
- 高性能清洗与校验:使用新一代高性能数据框架 Polars 与轻量分析引擎 DuckDB 替代传统的单线程 Pandas,内存占用下降 60%,处理速度提升 5~10 倍;使用 Pydantic 校验 Schema 异常。
- 数仓分层设计:
- ODS 层(原始数据层):保留采集到的完整原始报文与时间戳。
- DWD 层(明细数据层):完成清洗过滤、统一字段命名、货币汇率转换与去除异常波动脏数据。
- ADS 层(应用数据层):构建宽表与聚合指标(如历史最低价监控、同品类降价排行、品牌折扣率分布),持久化至 ClickHouse 列式库,供 Metabase / Streamlit 秒级渲染展示。
下面是数仓从 ODS 到 DWD/ADS 的高性能向量化清洗代码示例,展示如何用 Polars 处理缺失值、解析嵌套数据并计算窗口指标:
import polars as pl
import duckdb

def transform_ods_to_ads(raw_json_records: list[dict]) -> pl.DataFrame:
    # 1. 加载并定义严格的 Schema,利用 Polars 快速解析
    df_raw = pl.DataFrame(raw_json_records)

    # 2. DWD 清洗转换:剔除无效价格、解析时间戳、文本去噪
    df_dwd = (
        df_raw
        .filter(pl.col("raw_price").is_not_null() & (pl.col("raw_price") > 0))
        .with_columns([
            pl.col("item_id").cast(pl.Utf8),
            pl.col("raw_price").cast(pl.Float64).alias("price"),
            pl.col("timestamp").str.to_datetime("%Y-%m-%d %H:%M:%S").alias("crawl_time"),
            pl.col("title").str.strip_chars().str.to_lowercase().alias("clean_title")
        ])
    )

    # 3. 计算分析指标:计算同款商品近 30 天滑动窗口最低价与价格波动率
    df_ads = (
        df_dwd
        .sort(["item_id", "crawl_time"])
        .with_columns([
            pl.col("price").min().over("item_id").alias("history_lowest_price"),
            pl.col("price").rolling_mean(window_size=7).over("item_id").alias("rolling_7d_avg")
        ])
        .with_columns(
            ((pl.col("price") - pl.col("history_lowest_price")) / pl.col("history_lowest_price"))
            .round(4)
            .alias("price_markup_ratio")
        )
    )

    # 4. 无缝对接到 DuckDB 进行高速 SQL 聚合分析与持久化
    con = duckdb.connect(database=":memory:")
    con.register("ads_goods_prices", df_ads.to_arrow())

    # 提取跌破 30 天均价 15% 以上的商品报警清单
    alert_summary = con.execute("""
        SELECT item_id, clean_title, price, rolling_7d_avg, price_markup_ratio
        FROM ads_goods_prices
        WHERE price < (rolling_7d_avg * 0.85)
        ORDER BY price_markup_ratio ASC
        LIMIT 50
    """).pl()

    return alert_summary
五、方向三:Python 算法与大模型落地实战选题详解
推荐选题:企业级多源知识库 RAG 检索增强系统
在大模型重塑软件工程的当下,招聘方对 Python 算法与 AI 开发者的考核,已全面从“在已知数据集上调参(如调随机森林参数)”转向“大语言模型与私有知识库的高可靠落地”。
很多求职者仅仅使用第三方库调用 load_and_qa 函数就写入简历,一旦被问及分块策略(Chunking)、召回排序准确率评价(Recall@K)与幻觉抑制机制便无法深入。
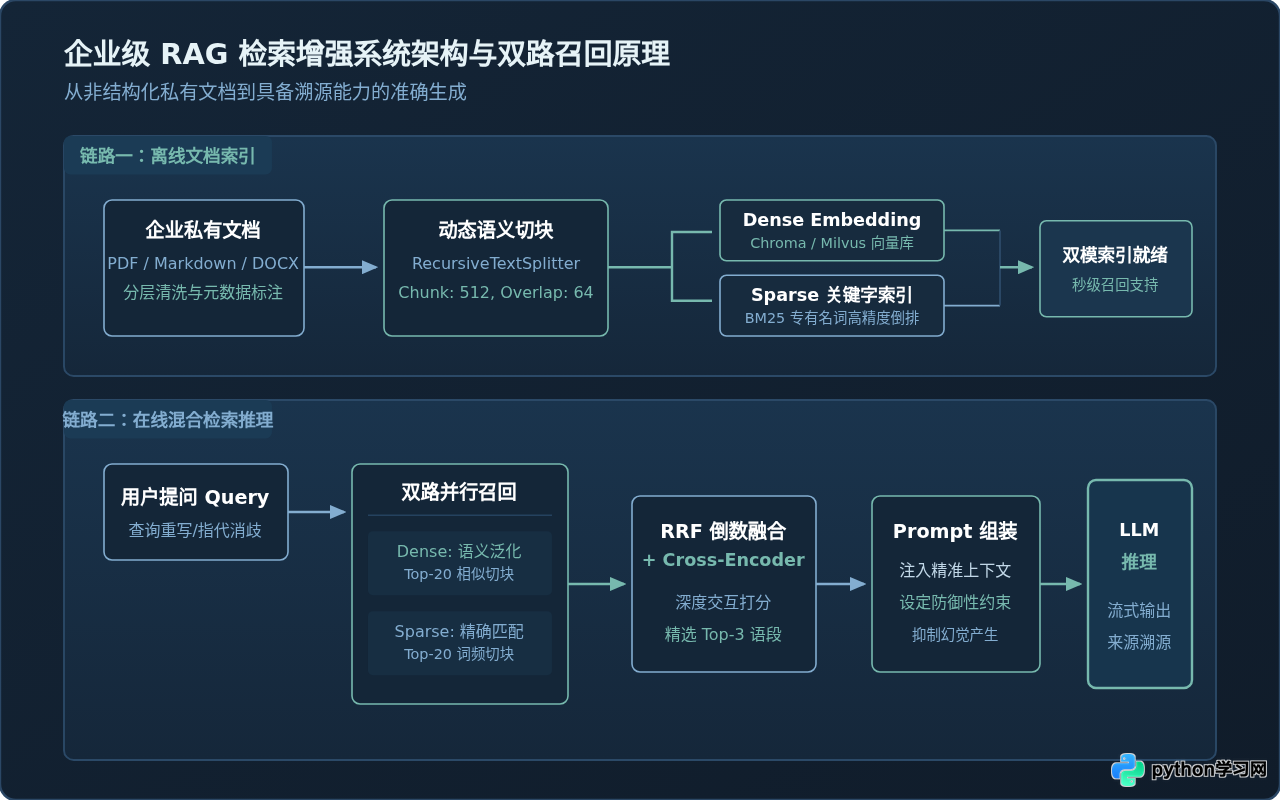
核心技术深度与架构要点:
- 精细化文档预处理与分块:采用具备层级感知(Heading-Aware)的递归文本切分器,控制切分窗口(如 512 Tokens,Overlap 64 Tokens),并为每个 Chunk 注入章节标题、文档创建时间与作者等 Metadata。
- Dense + Sparse 双路混合召回: 单纯的向量检索(Dense Embedding)擅长理解宏观语义,但面对专有名词、产品型号、函数名时极易失效;BM25(Sparse)则能进行精准字面匹配。将两者召回的 Top-20 候选集通过 RRF (Reciprocal Rank Fusion) 算法进行得分归一化融合。
- Cross-Encoder 重排序(Reranking): 将候选段落与 Query 拼接后送入 Cross-Encoder 模型(如 BAAI/bge-reranker-large),计算 Query 与 Document 的全局深度语义交互注意力得分,截取前 3~5 个高置信度语段。
- 防御性 Prompt 与防幻觉对齐: 组装 Prompt 时明确系统边界指令:“请严格依据以下参考资料回答;若参考资料中未明确记载,请直接回复‘未知’,严禁根据外部推测编造”。
- 量化评估框架:使用 Ragas 或自建 Benchmark 评测集,针对 Faithfulness(忠实度)、Answer Relevance(回答相关度)和 Context Recall(上下文召回率)给出客观量化打分。
通过原生 Python 协同向量与倒排索引实现混合召回与排名融合,不依赖封闭黑盒框架:
from typing import List, Dict
import math

class HybridSearchEngine:
    def __init__(self, k_constant: int = 60):
        # k_constant 用于平滑 RRF 排名倒数权重
        self.k = k_constant

    def reciprocal_rank_fusion(
        self,
        dense_results: List[Dict],
        sparse_results: List[Dict],
        top_n: int = 5
    ) -> List[Dict]:
        """
        计算双路检索结果的 RRF 综合得分:
        RRF_Score(d) = sum(1 / (k + rank_i(d)))
        """
        rrf_scores: Dict[str, float] = {}
        doc_store: Dict[str, Dict] = {}

        # 处理稠密向量检索排名
        for rank, item in enumerate(dense_results, start=1):
            doc_id = item["doc_id"]
            doc_store[doc_id] = item
            rrf_scores[doc_id] = rrf_scores.get(doc_id, 0.0) + (1.0 / (self.k + rank))

        # 处理 BM25 稀疏检索排名
        for rank, item in enumerate(sparse_results, start=1):
            doc_id = item["doc_id"]
            if doc_id not in doc_store:
                doc_store[doc_id] = item
            rrf_scores[doc_id] = rrf_scores.get(doc_id, 0.0) + (1.0 / (self.k + rank))

        # 根据最终融合分数降序排序
        sorted_docs = sorted(rrf_scores.items(), key=lambda x: x[1], reverse=True)

        final_top = []
        for doc_id, score in sorted_docs[:top_n]:
            entry = doc_store[doc_id].copy()
            entry["rrf_score"] = round(score, 5)
            final_top.append(entry)

        return final_top
六、工程化交付标准与 STAR 法则简历转化
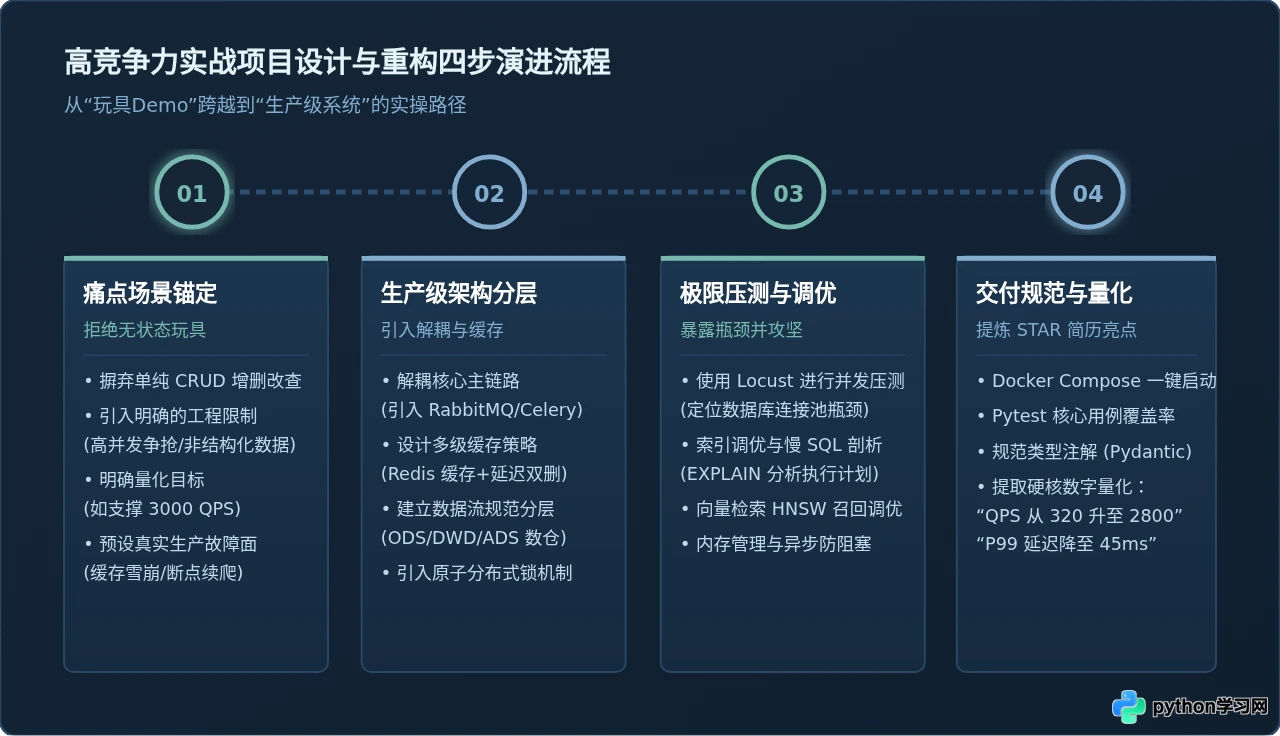
完成了代码编写并不意味着可以高枕无忧。许多技术功底扎实的开发者之所以在简历筛选中被忽视,是因为在简历撰写中充斥着“参与了系统开发”、“负责了模型训练”等平淡叙述,缺少让招聘方眼睛一亮的硬核技术指标。
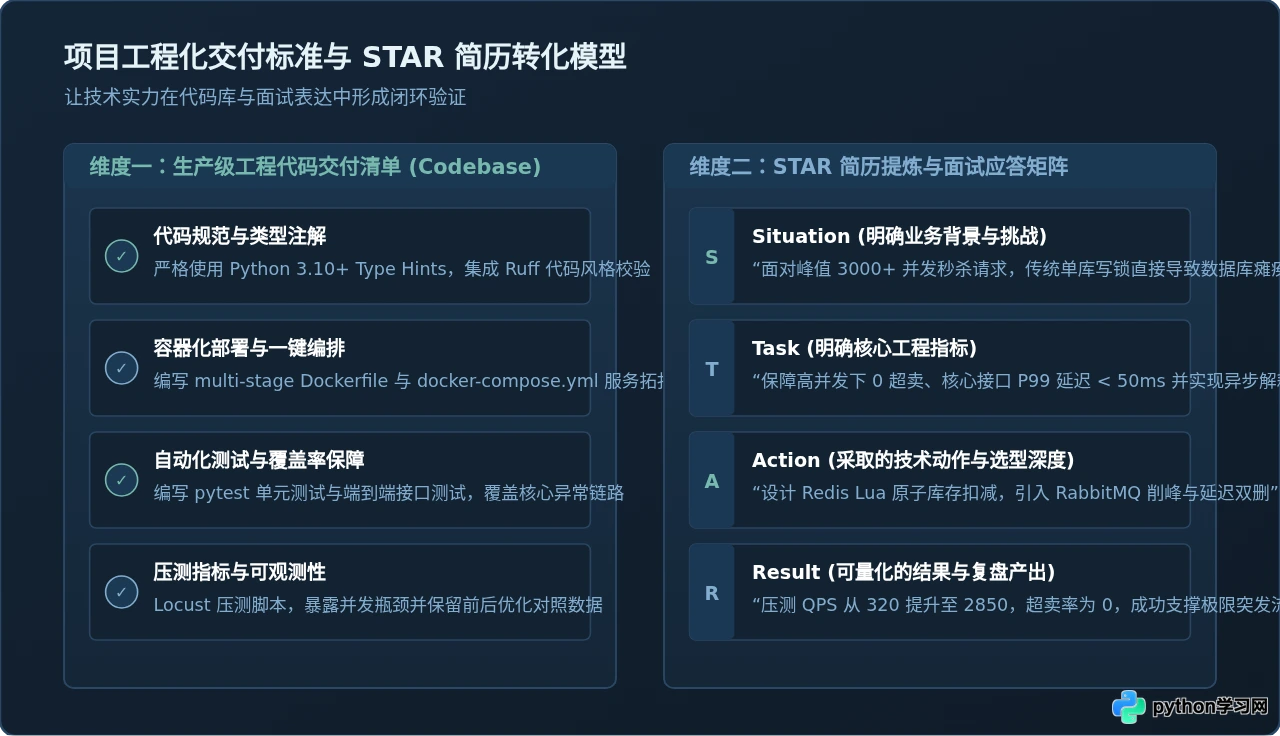
1. 消除代码库的“学生气”
将项目发布在 GitHub 或 Gitee 时,必须具备正规商业软件的代码面貌:
- 规范的代码分层与工程脚手架:遵循标准的 Poetry / Pdm 依赖管理,明确区分
api/、core/、services/、models/、tests/目录。 - 可一键复现的环境配置:提供包含多服务拓扑的
docker-compose.yml(含应用容器、Redis、PostgreSQL/ClickHouse),避免“在我机器上能跑”的尴尬。 - 清晰的单元测试与覆盖率徽标:使用 pytest 编写对核心鉴权、并发扣减逻辑、清洗逻辑的测试,测试覆盖率维持在 75% 以上。
- 真实压测报告与性能指标演进图:在 README 中附上 Locust / JMeter 的压测图表,注明优化前后的 QPS 与耗时曲线。
2. 简历 STAR 法则撰写范例对照
| 技术方向 | 平庸的表述(减分项) | 高竞争力的 STAR 规范表述(加分项) |
|---|---|---|
| 后端开发 | 负责电商后台的秒杀模块开发,使用 FastAPI 和 Redis 实现了商品购买与数据库存储。 |
[S/T] 针对单机秒杀场景下突发 3000+ 并发导致的数据库锁死与超卖问题; [A] 主导重构为 FastAPI + Redis 分布式架构,设计 Lua 脚本实现内存级原子库存预扣减,并接入 RabbitMQ 异步削峰;利用延迟双删策略保障双写最终一致性; [R] 经 Locust 压测,单节点吞吐量由 320 QPS 提升至 2850 QPS,P99 延迟降至 35ms,在高并发冲刺下实现 0 超卖。 |
| 数据工程 | 使用 Python 爬虫爬取了主流电商平台的商品价格,用 Pandas 进行清洗并生成了图表。 |
[S/T] 针对千万级电商动态商品价格监控需求,解决高频 IP 封禁与海量增量清洗性能瓶颈; [A] 搭建基于 Playwright + 动态代理池的分布式采集器,将 Kafka 作为流式缓冲削峰;引入 Polars 与 DuckDB 实现向量化 ETL 清洗,建立 ODS/DWD/ADS 数仓分层模型并入库 ClickHouse; [R] 日均清洗吞吐超 200 万条记录,内存占用相比旧版 Pandas 降低 65%,报表查询响应由 14 秒优化至 380 毫秒。 |
| 算法与 AI | 基于 LangChain 搭建了知识库问答系统,调用大模型 API 实现了用户提问与回答功能。 |
[S/T] 解决企业内部专业技术文档检索准确率低、大模型回答易产生幻觉的业务痛点; [A] 设计基于 Chroma 的语义向量检索与 BM25 专有名词倒排的双路混合召回架构,引入 RRF 算法与 Cross-Encoder 重排模型;设计结构化防御 Prompt 与回答溯源校验; [R] 在自建的 500 条专业问答评测集上,Top-3 上下文召回率从单路向量检索的 68% 提升至 91.5%,模型事实忠实度(Faithfulness)达到 94.2%。 |
七、总结与落地建议
求职竞争力的本质,是从“代码执行者”向“工程问题解决者”的认知跃迁。 在确定选题后,切忌贪多求全同时做多个同质化项目。集中精力挑选一个与自己求职目标高度匹配的方向,完整走完“设计边界场景 → 攻坚并发/海量数据瓶颈 → 压测发现弱点 → 调优解决问题 → 容器化交付”的全链路流程。 当你的代码库不仅包含功能代码,还附带详细的压测数据、复盘分析与可一键启动的编排脚本时,你在面试沟通中便拥有了充足的深度与绝对的说服力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















