


Python实战型程序设计题:小型数据处理项目练习
针对Python实战型程序设计题要求,通过完整的电商交易日志清洗与聚合统计小型项目,详细讲解基于Python标准库的数据读取、防御性字段校验、指标计算与报表输出的全流程实现。
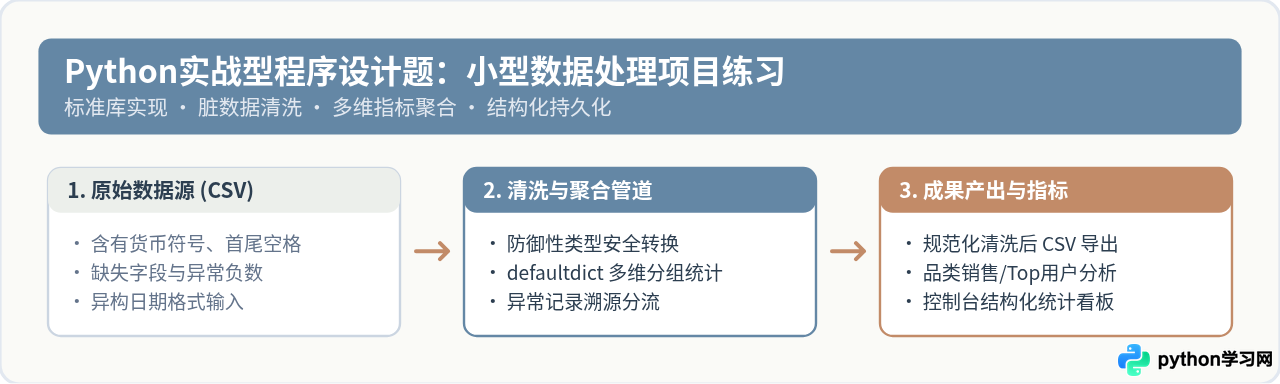
一、题目需求规格与业务场景
在实际业务环境中,第三方系统导出的日志与原始报表普遍存在数据脏污、类型混杂等问题。本练习的目标是编写一个独立可执行脚本,安全读取原始交易日志文件,排查并拦截各类脏数据,计算多维销售指标并生成结构化成果。
1. 输入文件特征与缺陷清单
输入源为逗号分隔的 transactions.csv 文件,包含订单号(order_id)、用户标识(user_id)、交易日期(date)、商品品类(category)、商品单价(price)以及购买数量(quantity)。样本数据中包含以下典型的实际缺陷:
- 空白符污染:文本字段包含不可见的换行或首尾空格(例如
" 电子数码 "); - 非纯数字金额:单价字符串混有货币前缀或千分位符(例如
"¥ 1,999.00"、"$88.00"); - 业务反常数值:出现退单或测试遗留的非正数(如数量为
-1、价格为0或负数); - 日期格式异构:混合使用了斜杠分隔(
2026/03/01)与标准短横线分隔(2026-03-01),甚至包含非法月份日期; - 关键信息缺损:必要字段值为空字符串或缺失列。
2. 核心输出指标
程序执行完成后,需输出结构化控制台看板,并产生清洗后的规范文件:
- 全局总览:统计有效成交订单总数、累计有效销售额(四舍五入保留2位小数)、被拦截的异常记录总数;
- 品类销售排行:按商品品类统计其贡献的销售总额和售出商品件数,并按销售总额由高到低排序;
- 高价值客户 Top 3:统计累计消费金额排名前 3 名的用户 ID 与具体金额;
- 按日销售走势:按日期先后顺序列出每日的营业流水;
- 异常审计留痕:将所有被拦截的非法数据行号、原因及原始内容归档至异常记录表中。
二、流水线处理架构设计
为保障系统高可用与低内存占用,数据流应当采用严格的单向流动设计:流式读取 → 字段清洗与合规校验 → 内存分组聚合 → 结构化结果持久化。
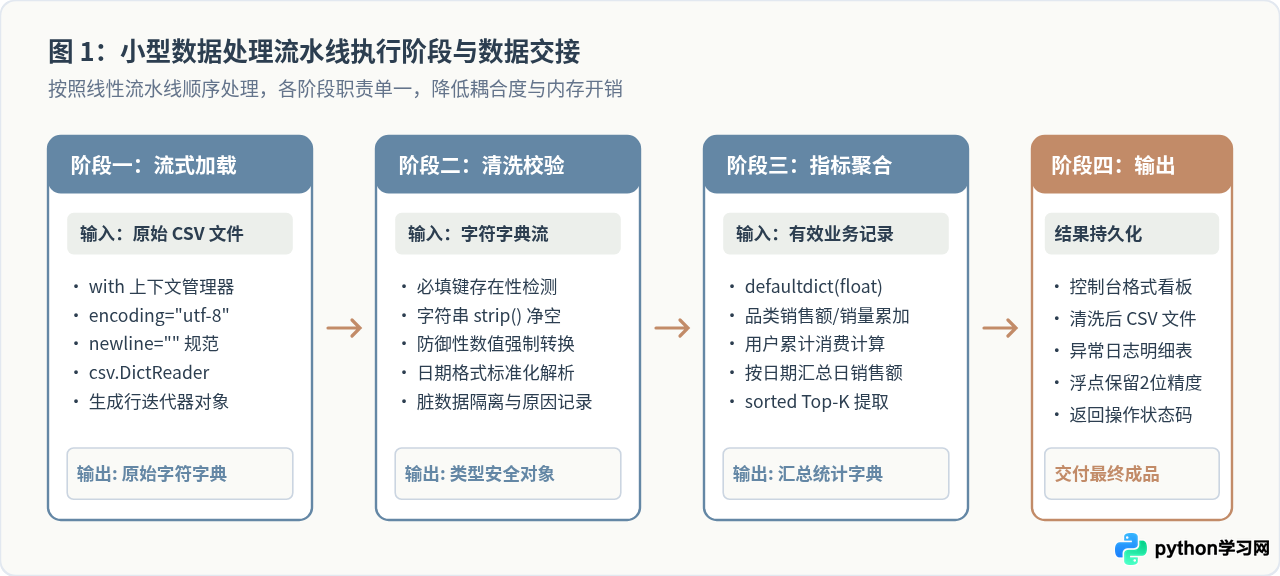
单向流水线的优势在于关注点分离。后续无论是调整校验规则(例如增加打折券字段),还是改变统计维度(例如增加用户平均客单价),都只需改动对应的单一阶段函数,避免牵一发而动全身。
三、核心模块实现要点
1. 安全读取与 CSV 字典流式封装
在文件读取方面,采用标准库自带的 csv.DictReader。与手写 str.split(',') 相比,标准库内部已完整实现对带引号字段、转义逗号和换行符的标准解析。
import csv

def iter_raw_records(filepath: str):
    """流式生成器:逐行产出 (行号, 字典),保证句柄安全关闭并控制内存"""
    with open(filepath, mode="r", encoding="utf-8", newline="") as f:
        reader = csv.DictReader(f)
        for line_number, row in enumerate(reader, start=2):
yield line_number, rowencoding="utf-8",避免不同系统环境下的编码歧义;参数 newline="" 则是 Python 官方文档明确要求的规范写法,交由 csv 模块内部负责通用换行符识别。
2. 防御性数据清洗与多维校验
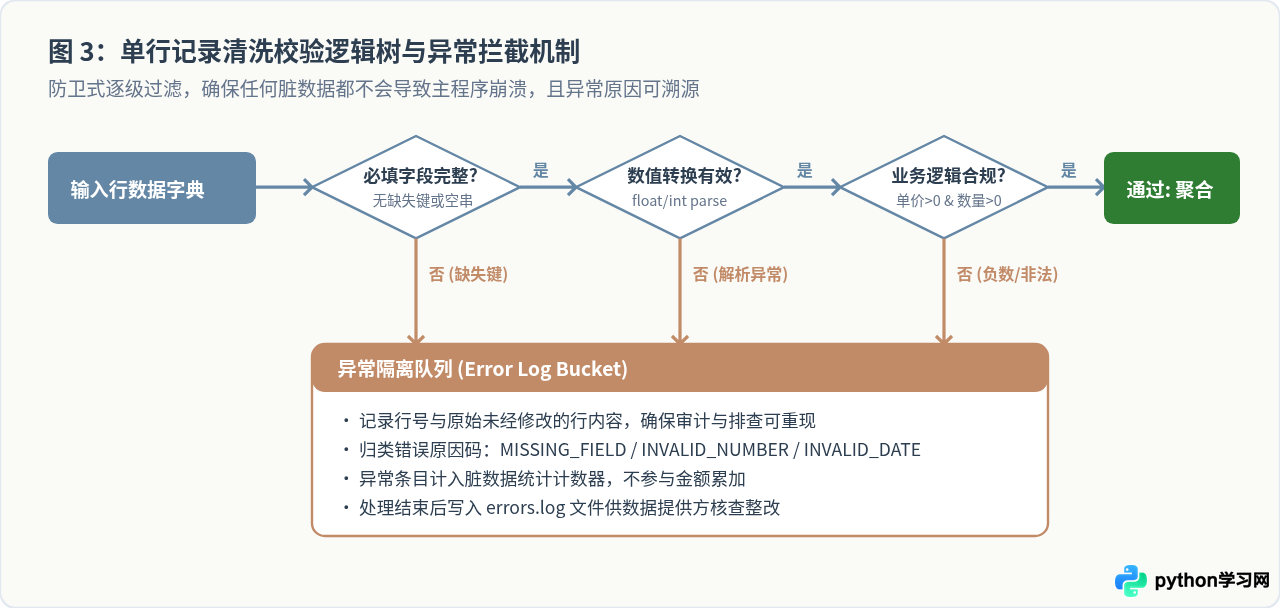
数据清洗是本练习的重中之重。图 2 展现了一条含有脏数据的原始记录,在经过类型校验后转换为规整对象,并同步更新聚合容器的过程。
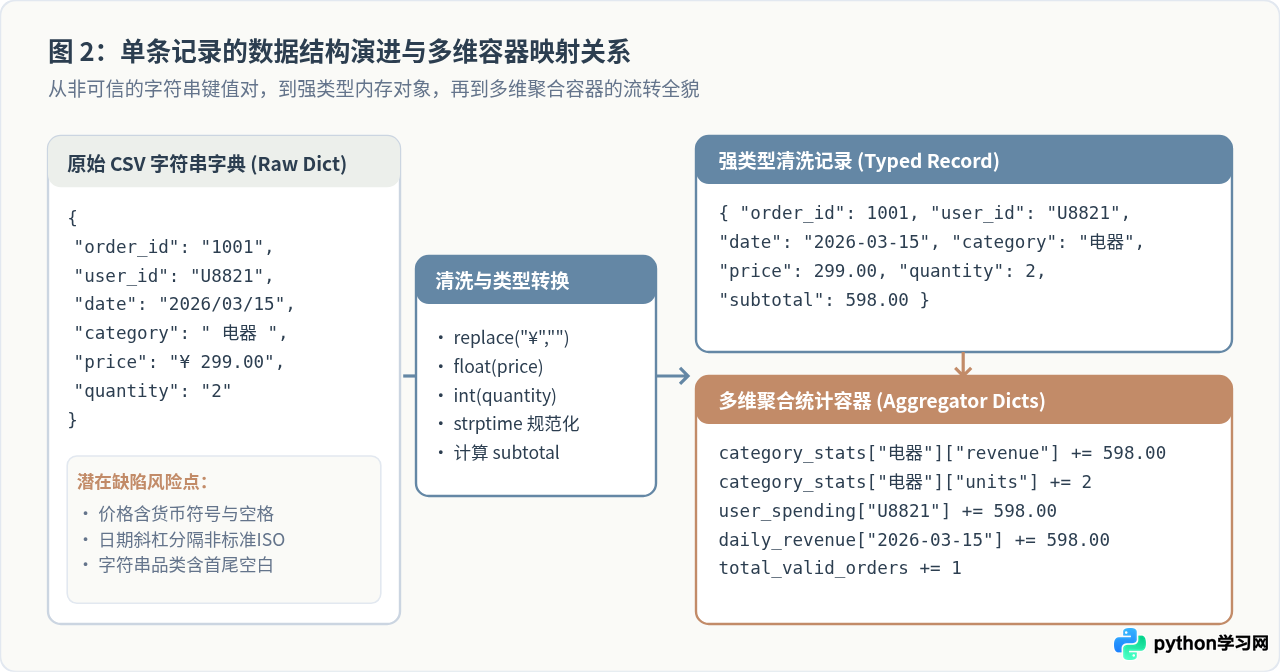
清洗阶段应采取防御性设计:禁止直接使用 eval() 执行文本解析;任何类型强制转换必须包裹在细粒度的 try...except ValueError 代码块中。每条记录的清洗判定遵循逻辑树顺序逐级检测:
from datetime import datetime
from typing import Dict, Any, Tuple, Optional

def clean_record(raw_row: Dict[str, str]) -> Tuple[Optional[Dict[str, Any]], Optional[str]]:
    """
    清洗单行记录。若合法返回 (规范字典, None);若非法返回 (None, 错误原因)。
    """
    required_keys = ["order_id", "user_id", "date", "category", "price", "quantity"]
    for key in required_keys:
        val = raw_row.get(key, "").strip()
        if not val:
            return None, f"必填字段缺失或值为空: {key}"

    # 清洗价格:剔除货币符号及空格
    cleaned_price_str = raw_row["price"].replace("¥", "").replace("$", "").replace(",", "").strip()
    try:
        price = float(cleaned_price_str)
        if price <= 0:
            return None, f"单价必须大于零: {price}"
    except ValueError:
        return None, f"单价不是有效数值: {raw_row['price']}"

    # 清洗数量:必须为正整数
    try:
        quantity = int(raw_row["quantity"].strip())
        if quantity <= 0:
            return None, f"购买数量必须为正整数: {quantity}"
    except ValueError:
        return None, f"购买数量不是有效整数: {raw_row['quantity']}"

    # 清洗日期:规范化为 YYYY-MM-DD
    normalized_date_str = raw_row["date"].strip().replace("/", "-")
    try:
        dt = datetime.strptime(normalized_date_str, "%Y-%m-%d")
        iso_date = dt.strftime("%Y-%m-%d")
    except ValueError:
        return None, f"日期不符合YYYY-MM-DD格式: {raw_row['date']}"

    subtotal = round(price * quantity, 2)

    return {
        "order_id": raw_row["order_id"].strip(),
        "user_id": raw_row["user_id"].strip(),
        "date": iso_date,
        "category": raw_row["category"].strip(),
        "price": price,
        "quantity": quantity,
        "subtotal": subtotal
    }, None
3. 高效内存聚合与多维指标统计
在指标累加阶段,使用 collections.defaultdict 可以消除深层字典初始化时的键存在性判断,使逻辑平直明晰:
from collections import defaultdict

def calculate_aggregates(valid_records):
    total_sales = 0.0
    cat_stats = defaultdict(lambda: {"revenue": 0.0, "quantity": 0})
    user_spend = defaultdict(float)
    daily_sales = defaultdict(float)

    for item in valid_records:
        subtotal = item["subtotal"]
        total_sales += subtotal

        # 品类汇总
        cat_stats[item["category"]]["revenue"] += subtotal
        cat_stats[item["category"]]["quantity"] += item["quantity"]

        # 用户消费汇总
        user_spend[item["user_id"]] += subtotal

        # 每日流水汇总
        daily_sales[item["date"]] += subtotal

    # 排序提取高净值 Top-3 用户
    top_3_users = sorted(user_spend.items(), key=lambda x: x[1], reverse=True)[:3]

    # 按营业额排序品类
    sorted_categories = sorted(cat_stats.items(), key=lambda x: x[1]["revenue"], reverse=True)

    # 按时间正序排列走势
    sorted_daily = sorted(daily_sales.items(), key=lambda x: x[0])

    return {
        "total_revenue": round(total_sales, 2),
        "total_orders": len(valid_records),
        "category_summary": sorted_categories,
        "top_users": top_3_users,
        "daily_trend": sorted_daily
    }
四、完整可运行代码与验证演示
以下为自包含的完整实现代码。脚本内置了一段典型的脏数据 CSV 字符串,可直接粘贴在任何标准 Python 3 环境下执行。
import csv
import io
from datetime import datetime
from collections import defaultdict

SAMPLE_RAW_CSV = """order_id,user_id,date,category,price,quantity
1001,U101,2026-03-01, 电子数码 ,¥ 1999.00,1
1002,U102,2026/03/01,办公文具,25.50,4
1003,U101,2026-03-02,电子数码,150.00,-1
1004,U103,2026-03-02,家居百货,¥88.00,2
1005,,2026-03-03,服饰鞋帽,299.00,1
1006,U104,2026-03-03,办公文具,INVALID_PRICE,2
1007,U102,2026-03-03,电子数码,2400.00,1
1008,U105,2026/03/04,家居百货,45.00,3
1009,U101,2026-03-04, 办公文具 ,12.00,10
"""

def clean_row_data(row, line_no):
    req_keys = ["order_id", "user_id", "date", "category", "price", "quantity"]
    for k in req_keys:
        if not row.get(k, "").strip():
            return None, f"第 {line_no} 行:关键字段缺失 [{k}]"

    p_str = row["price"].replace("¥", "").replace("$", "").replace(",", "").strip()
    try:
        price = float(p_str)
        if price <= 0:
            return None, f"第 {line_no} 行:单价必须大于0,当前为 {price}"
    except ValueError:
        return None, f"第 {line_no} 行:单价无法转为数值 [{row['price']}]"

    try:
        qty = int(row["quantity"].strip())
        if qty <= 0:
            return None, f"第 {line_no} 行:购买数量必须为正整数,当前为 {qty}"
    except ValueError:
        return None, f"第 {line_no} 行:数量不是合法整数 [{row['quantity']}]"

    d_str = row["date"].strip().replace("/", "-")
    try:
        dt = datetime.strptime(d_str, "%Y-%m-%d")
        iso_date = dt.strftime("%Y-%m-%d")
    except ValueError:
        return None, f"第 {line_no} 行:日期格式非法 [{row['date']}]"

    subtotal = round(price * qty, 2)
    return {
        "order_id": row["order_id"].strip(),
        "user_id": row["user_id"].strip(),
        "date": iso_date,
        "category": row["category"].strip(),
        "price": price,
        "quantity": qty,
        "subtotal": subtotal
    }, None

def process_sales_dataset(stream_file):
    reader = csv.DictReader(stream_file)
    valid_data = []
    error_records = []

    for idx, raw in enumerate(reader, start=2):
        clean_res, err_msg = clean_row_data(raw, idx)
        if err_msg:
            error_records.append((idx, err_msg, raw))
        else:
            valid_data.append(clean_res)

    # 汇总计算
    total_revenue = sum(r["subtotal"] for r in valid_data)
    cat_summary = defaultdict(lambda: {"revenue": 0.0, "quantity": 0})
    user_summary = defaultdict(float)
    daily_summary = defaultdict(float)

    for r in valid_data:
        cat_summary[r["category"]]["revenue"] += r["subtotal"]
        cat_summary[r["category"]]["quantity"] += r["quantity"]
        user_summary[r["user_id"]] += r["subtotal"]
        daily_summary[r["date"]] += r["subtotal"]

    top_3_users = sorted(user_summary.items(), key=lambda x: x[1], reverse=True)[:3]
    ranked_cats = sorted(cat_summary.items(), key=lambda x: x[1]["revenue"], reverse=True)
    ranked_days = sorted(daily_summary.items(), key=lambda x: x[0])

    return valid_data, error_records, total_revenue, ranked_cats, top_3_users, ranked_days

# 模拟运行
file_input = io.StringIO(SAMPLE_RAW_CSV.strip())
valid_list, errors, total_rev, cats, top_users, days = process_sales_dataset(file_input)

print("=" * 62)
print(f"数据清洗完成: 有效订单 {len(valid_list)} 笔 | 拦截异常 {len(errors)} 笔")
print(f"有效总营业额: ¥ {total_rev:,.2f}")
print("-" * 62)
print("【各品类销售统计】")
for cat, st in cats:
    print(f"  品类: {cat:<6} | 营收: ¥ {st['revenue']:>9.2f} | 销量: {st['quantity']:>3} 件")
print("-" * 62)
print("【累计消费 Top 3 用户】")
for rank, (uid, amt) in enumerate(top_users, start=1):
    print(f"  第 {rank} 名: {uid} | 累计消费金额: ¥ {amt:,.2f}")
print("-" * 62)
print("【每日营收走势】")
for day, rev in days:
    print(f"  {day} : ¥ {rev:,.2f}")
print("-" * 62)
print("【异常数据拦截日志】")
for line_no, reason, _ in errors:
    print(f"  [告警] {reason}")
print("=" * 62)
运行输出结果展示
==============================================================
数据清洗完成: 有效订单 6 笔 | 拦截异常 3 笔
有效总营业额: ¥ 4,896.00
--------------------------------------------------------------
【各品类销售统计】
  品类: 电子数码  | 营收: ¥  4,399.00 | 销量:   2 件
  品类: 办公文具  | 营收: ¥    222.00 | 销量:  14 件
  品类: 家居百货  | 营收: ¥    275.00 | 销量:   5 件
--------------------------------------------------------------
【累计消费 Top 3 用户】
  第 1 名: U102 | 累计消费金额: ¥ 2,502.00
  第 2 名: U101 | 累计消费金额: ¥ 2,119.00
  第 3 名: U103 | 累计消费金额: ¥ 176.00
--------------------------------------------------------------
【每日营收走势】
  2026-03-01 : ¥ 2,101.00
  2026-03-02 : ¥ 176.00
  2026-03-03 : ¥ 2,400.00
  2026-03-04 : ¥ 219.00
--------------------------------------------------------------
【异常数据拦截日志】
  [告警] 第 4 行:购买数量必须为正整数,当前为 -1
  [告警] 第 6 行:关键字段缺失 [user_id]
  [告警] 第 7 行:单价无法转为数值 [INVALID_PRICE]
==============================================================
五、避坑指南与工程边界总结
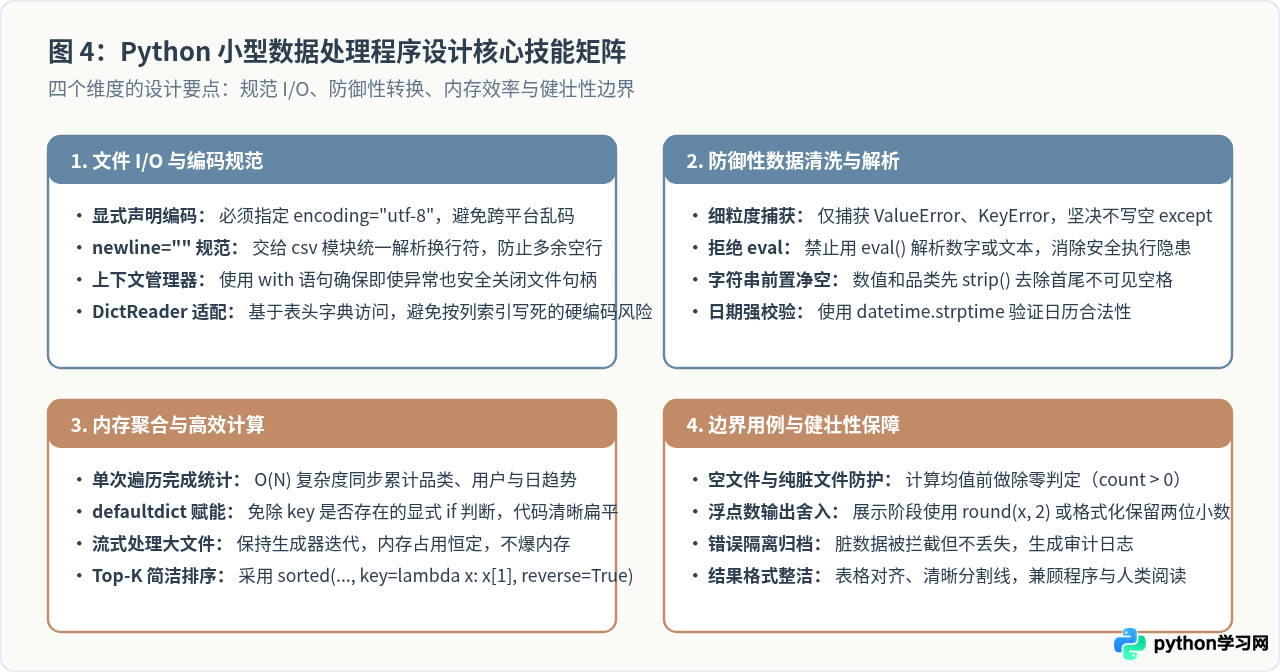
在解答实战型程序设计题时,阅卷考察的核心不仅是主干流程的正确性,更是面对极端测试用例时的容错弹性。图 4 对本项目的核心知识点与工程设计规范进行了矩阵式梳理。
1. 浮点精度与金额计算
Python 原生浮点数在进行多次连续累加时,可能会产生二进制舍入微小尾差。在控制台报表呈现阶段,建议使用 {:.2f} 格式化字符串进行规整展示;如果题目明确要求金融级零误差计算,应将 float 替换为标准库的 decimal.Decimal 进行定点运算。
2. 全脏数据与空文件时的除零风险
如果测试用例给出的 CSV 文件内容全为空,或者所有记录都被识别为非法行,那么有效订单列表将为空。若后续计算“客单价(平均订单金额)”,必须先进行长度判定:
avg_order = (total_revenue / len(valid_data)) if valid_data else 0.03. 多条件排序与比较稳定性
当面临“先按总金额降序,金额相同时按用户 ID 字典序升序”的需求时,应充分利用 Python 的元组排序机制:
# 利用负号实现数值降序,第二项保持字母升序
ranked_users = sorted(user_spend.items(), key=lambda item: (-item[1], item[0]))
掌握这一整套以标准库为核心的数据处理方法,能够使程序设计脱离对重量级环境的依赖,在任何纯净的 Python 运行环境中均能高可靠地交付预期的业务价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















