


Python初学者必练的20道基础语法题目
精选20道专为Python初学者设计的高频基础语法实战练习题,涵盖变量运算、流程控制、列表切片、字典集合及函数封装,配有详尽思路、规范代码与避坑指南。
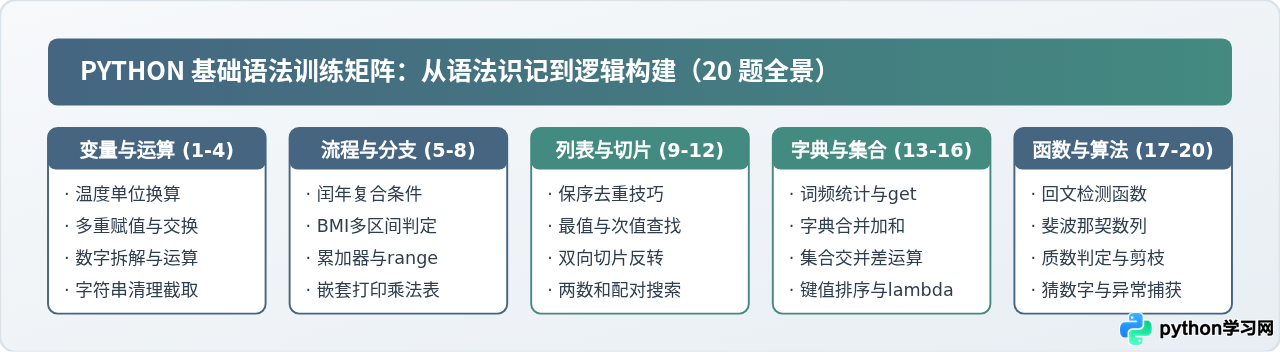
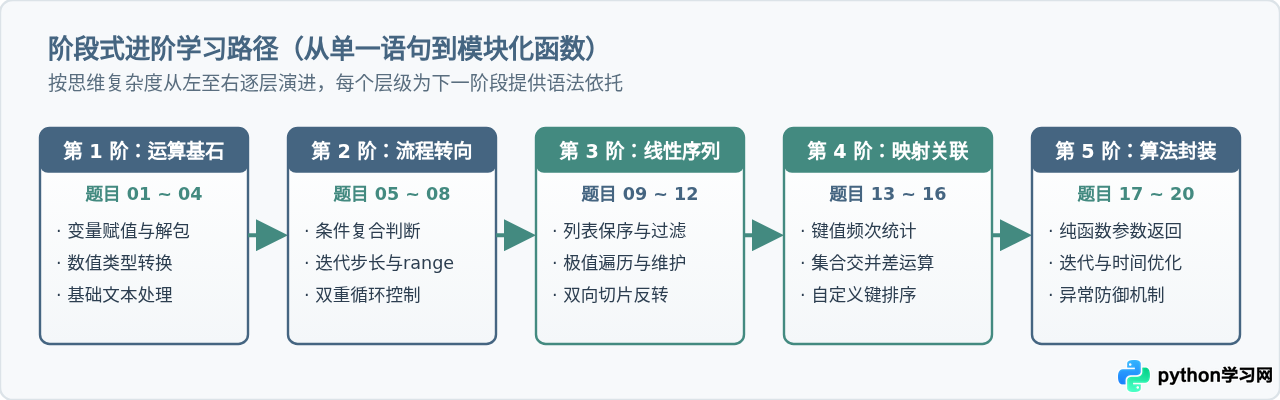
第一部分:变量、数据类型与基础运算(题 1 ~ 4)
该阶段着重考察程序中最基本的数据存放容器、运算符号优先级以及类型转换规则。初学者需要熟悉整型、浮点型、字符串之间的互转,以及常见格式化输出机制。
题目 01:摄氏度与华氏度互转计算器
F = C × 1.8 + 32 转换为华氏温度,并保留两位小数输出。核心思路:输入或定义的数值需要确保为浮点数(float)类型,避免字符串无法参与数学乘加运算。最后使用格式化字符串 f"{f_val:.2f}" 进行格式化保留。
# 设定摄氏温度输入值
celsius = 26.5

# 转换公式计算
fahrenheit = celsius * 1.8 + 32

# 格式化输出
print(f"摄氏温度 {celsius}°C 对应华氏温度为: {fahrenheit:.2f}°F")input() 函数获取用户输入,返回结果一律为字符串 str。如果不使用 float() 强制类型转换,直接进行 * 1.8 将触发 TypeError: can't multiply sequence by non-int of type 'float'。
题目 02:不使用额外中间变量交换两个变量
x = 100 和 y = 200,要求交换它们存储的值,使 x 变为 200,y 变为 100。核心思路:传统语言往往需要借助 temp 临时变量,而 Python 支持多重赋值与元组打包解包机制(Tuple Packing / Unpacking)。右侧的表达式先打包为元组,再同时解包赋给左侧的变量。
x = 100
y = 200

print(f"交换前: x = {x}, y = {y}")

# Python 惯用元组解包交换法
x, y = y, x

print(f"交换后: x = {x}, y = {y}")交换后: x = 200, y = 100
x = y 后紧接着 y = x,会导致 x 的旧值被立即覆盖,最终两个变量都变成了原来的 y。利用逗号单行解包能有效避免此逻辑灾难。
题目 03:拆解三位整数并求各位数字之和
核心思路:掌握算术运算符中的整除 // 与 取模 %。百位可通过整除 100 得到;十位可先整除 10 去掉个位,再对 10 取模;个位直接对 10 取模。
num = 749

# 算术运算拆解各个数位
hundreds = num // 100         # 749 // 100 = 7
tens = (num // 10) % 10       # 74 % 10 = 4
ones = num % 10               # 749 % 10 = 9

total_sum = hundreds + tens + ones

print(f"数字 {num} 的百位是 {hundreds},十位是 {tens},个位是 {ones}")
print(f"各位数字之和: {hundreds} + {tens} + {ones} = {total_sum}")各位数字之和: 7 + 4 + 9 = 20
int() 转回数字再求和。
题目 04:字符串规范化清洗(去空格与大小写规整)
raw_text = " pYtHon proGRamMing lanGUage ",要求去除首尾两侧多余空白,并将每个单词的首字母大写,其余小写,输出整洁的标准标题文本。核心思路:调用 str.strip() 剥离首尾空白字符,然后使用 str.title() 或组合 capitalize() 将字符串格式化为单词首字母大写的标题格式。
raw_text = "   pYtHon proGRamMing lanGUage   "

# 步骤一:去除首尾多余空格
clean_text = raw_text.strip()

# 步骤二:转换为标准标题大小写
formatted_text = clean_text.title()

print(f"原始字符串: '{raw_text}'")
print(f"规范化结果: '{formatted_text}'")规范化结果: 'Python Programming Language'
raw_text.strip() 不会改变 raw_text 原身,必须将处理结果赋给新变量或重新接收。
第二部分:流程控制与逻辑判断(题 5 ~ 8)
本阶段核心考察条件分支结构(if-elif-else)与循环控制(for / while)。重点在于掌握布尔逻辑优先级、区间比较连续写法以及嵌套循环的迭代指针配合。
题目 05:公历闰年精准判断
核心思路:将自然语言规则转化为复合布尔逻辑:年份能被 4 整除但不能被 100 整除,或者能被 400 整除。逻辑表达式为:(year % 4 == 0 and year % 100 != 0) or (year % 400 == 0)。
test_years = [2000, 1900, 2024, 2023]

for year in test_years:
    is_leap = (year % 4 == 0 and year % 100 != 0) or (year % 400 == 0)
    if is_leap:
        print(f"年份 {year}: 是闰年")
    else:
print(f"年份 {year}: 是平年")年份 1900: 是平年
年份 2024: 是闰年
年份 2023: 是平年
and 高于 or,但在复合条件判断中,强烈建议在子表达式外显式包裹圆括号,以杜绝因逻辑运算符结合顺序导致的隐蔽分支误判。
题目 06:BMI 健康体质指数多区间判定
weight = 68.5(千克)和身高 height = 1.75(米),计算公式 BMI = weight / (height ** 2),并依据中国成人参考标准划定体型:<18.5 偏瘦,[18.5, 24.0) 正常,[24.0, 28.0) 超重,≥28.0 肥胖。核心思路:Python 允许链式比较语法,例如 18.5 <= bmi < 24.0。结合 if-elif-else 结构由小到大或由大到小有序判定,分支一旦命中即终止后续判断。
weight_kg = 68.5
height_m = 1.75

bmi = weight_kg / (height_m ** 2)

if bmi < 18.5:
    status = "偏瘦"
elif 18.5 <= bmi < 24.0:
    status = "正常"
elif 24.0 <= bmi < 28.0:
    status = "超重"
else:
    status = "肥胖"

print(f"身高 {height_m}m, 体重 {weight_kg}kg -> BMI: {bmi:.1f}, 判定结果: {status}")if 语句而不是 elif,可能导致变量被后续不互斥的条件覆盖。
题目 07:求 1 到 100 之间所有偶数之和
核心思路:实现该逻辑通常有两种解法:一是使用 range(1, 101) 并在循环内通过 i % 2 == 0 过滤;二是直接利用 range(2, 101, 2) 步长为 2 直达目标。推荐第二种方式,效率更高且代码更为精炼。
# 设定累加器初值为 0
even_sum = 0

# range(起始值, 终止值开区间, 步长)
for num in range(2, 101, 2):
    even_sum += num

print(f"1 到 100 之间所有偶数之和为: {even_sum}")range(start, stop) 产生的序列是左闭右开区间(包含 start,但不包含 stop)。若要包含 100,stop 参数必须传入 101。写成 range(2, 100, 2) 会遗漏 100。
题目 08:九九乘法表整齐格式化输出
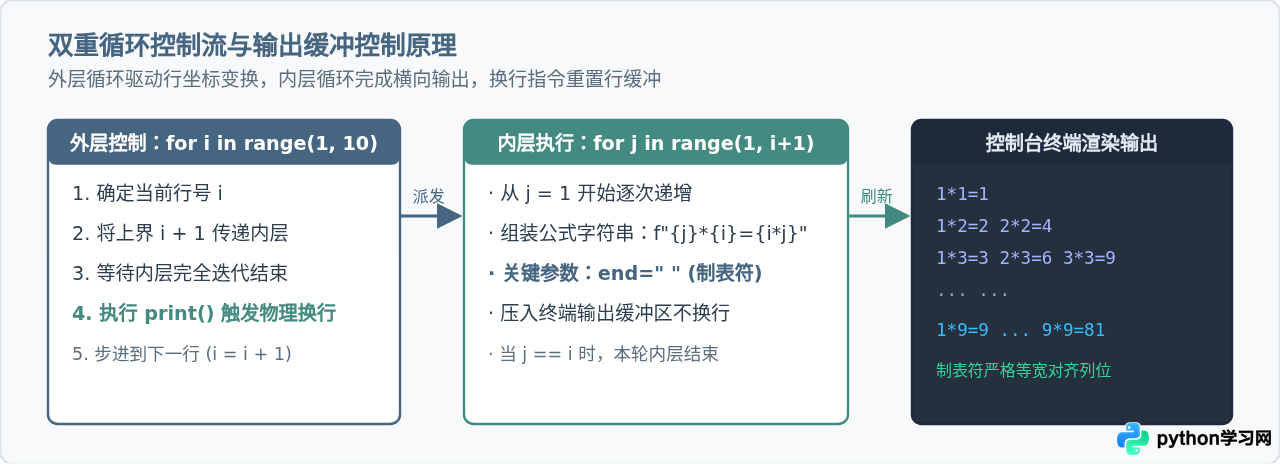
for 循环打印出下三角格式的九九乘法表,每项公式形如 1*1=1,公式之间使用制表符对齐,行末自动换行。核心思路:外层循环控制行号 i(从 1 到 9),内层循环控制列号 j(从 1 到 i)。通过控制 print() 的 end=" " 参数禁止默认换行,内层循环结束后单独调用一次无参 print() 完成物理换行。
for i in range(1, 10):
    for j in range(1, i + 1):
        # end="	" 使用制表符作为项分隔符,保持整齐
        print(f"{j}*{i}={i * j}", end="	")
    # 内层遍历完成后打印空行进行换行
print()1*2=2 2*2=4
1*3=3 2*3=6 3*3=9
...
1*9=9 2*9=18 3*9=27 ... 9*9=81
i + 1 而非 i 或固定值 9。写成 range(1, i) 会导致每行最后一个等式(如 2*2=4)丢失。
第三部分:列表、元组与序列切片(题 9 ~ 12)
列表是Python中使用最广泛的有序可变集合。掌握列表的核心在于灵活运用正负索引、闭开切片、内置遍历与原地修改(in-place)的边界差异。
题目 09:列表元素去重并严格保持原始顺序
nums = [3, 1, 2, 3, 4, 1, 5, 2],去除其中的多余重复项,且输出结果必须保持元素首次出现的先后顺序。核心思路:直接使用 list(set(nums)) 虽然能去重,但 set 是无序集合,会打乱原有排列。规范解法通常借助一个辅助的空列表或集合记录已见项,遍历原序列只收集首次出现的元素。
raw_list = [3, 1, 2, 3, 4, 1, 5, 2]

unique_list = []
seen = set()

for item in raw_list:
    if item not in seen:
        unique_list.append(item)
        seen.add(item)

print(f"去重前: {raw_list}")
print(f"保序去重后: {unique_list}")保序去重后: [3, 1, 2, 4, 5]
if item not in unique_list 进行判断,列表查找的时间复杂度为 O(n),整体会退化为 O(n²)。搭配 seen = set() 可享受 O(1) 查找速度,兼顾高性能与保序性。
题目 10:单次遍历寻找列表最大值与次大值
scores = [45, 88, 92, 73, 92, 60],不直接对原列表执行破坏性全排序,找出该列表中的最大值与严格次大值(若最大值重复,次大值为严格小于最大值的最高分)。核心思路:维护两个状态变量 first 和 second,初值设为负无穷大 float('-inf')。遍历序列时:遇更大数则将旧最大值降为次大值并更新最大值;遇介于最大与次大之间的数则更新次大值。
scores = [45, 88, 92, 73, 92, 60]

first = float('-inf')
second = float('-inf')

for score in scores:
    if score > first:
        second = first
        first = score
    elif first > score > second:
        second = score

print(f"成绩列表: {scores}")
print(f"最高分 (最大值): {first}")
print(f"严格次高分 (次大值): {second}")最高分 (最大值): 92
严格次高分 (次大值): 88
scores.sort() 后取 scores[-2] 在存在重复最高分时会失效(例如上面列表中有两个 92,排序后倒数第二位依然是 92,而非次高分 88)。
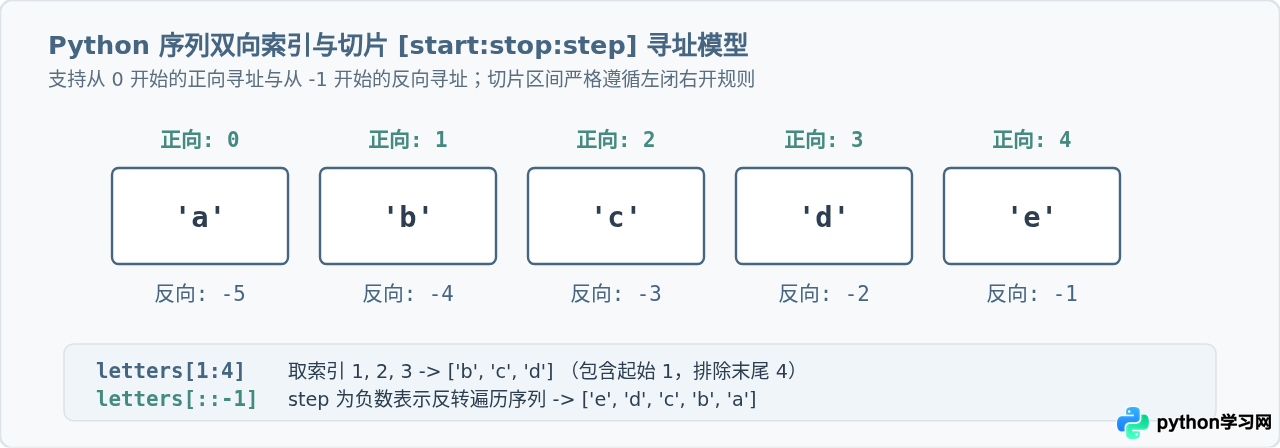
题目 11:列表倒序的多种途径与切片负步长
letters = ['a', 'b', 'c', 'd', 'e'],演示使用切片步长 [::-1] 生成倒序新列表,并对比内置方法 list.reverse() 对原对象的就地修改行为。核心思路:切片语法 [start:stop:step] 中,当 step = -1 且省略前后边界时,表示从右向左全量索引。而 reverse() 方法直接修改原列表,其返回值为 None。
original = ['a', 'b', 'c', 'd', 'e']

# 方法一:利用步长为 -1 的切片(生成全新对象,不污染原列表)
sliced_reversed = original[::-1]
print(f"切片反转新列表: {sliced_reversed}")
print(f"原列表未受影响: {original}")

# 方法二:调用 list.reverse()(就地原地修改,返回 None)
original.reverse()
print(f"原地修改后的原列表: {original}")原列表未受影响: ['a', 'b', 'c', 'd', 'e']
原地修改后的原列表: ['e', 'd', 'c', 'b', 'a']
res = original.reverse() 这样的赋值语句,因为 reverse() 原地修改并返回 None,变量 res 的值将变成空值而不是反转后的列表。
题目 12:在列表中查找和为目标值的两个数索引
numbers = [2, 7, 11, 15] 和目标和 target = 9,找出列表中相加之和等于目标的两个不同元素的索引,输出 [0, 1]。核心思路:暴力循环的时间复杂度为 O(n²)。更优解法是在遍历列表的同时维护一个哈希字典 lookup = {}。对于当前值 val,如果 target - val 已经在字典中,即可直接配对输出;否则将当前 val 及其索引存入字典。
numbers = [2, 7, 11, 15]
target = 9

def find_two_sum(nums, target_val):
    val_map = {}  # 存放 元素值: 对应索引
    for index, val in enumerate(nums):
        complement = target_val - val
        if complement in val_map:
            return [val_map[complement], index]
        val_map[val] = index
    return None

result = find_two_sum(numbers, target)
print(f"候选数组: {numbers}, 目标和: {target}")
print(f"匹配到的元素索引: {result}")匹配到的元素索引: [0, 1]
第四部分:字典与集合键值操作(题 13 ~ 16)
字典提供了高效的键值对(Key-Value)映射,集合提供了元素互异性与数学集合操作。该阶段重点考核键存在性检查、字典合并策略与高阶自定义键排序。
题目 13:英文段落单词词频统计
"apple banana apple orange banana apple",使用基础字典统计每个单词出现的总频次。核心思路:首先使用 sentence.split() 将字符串按空格切分为单词列表;接着遍历单词列表,利用 dict.get(key, default) 方法优雅地获取已存频次,若未出现则返回 0,随后加 1 存回。
sentence = "apple banana apple orange banana apple"
words = sentence.split()

frequency = {}
for word in words:
    # 若 word 不在字典中,get 返回默认值 0
    frequency[word] = frequency.get(word, 0) + 1

print(f"词频统计结果: {frequency}")frequency[word] += 1 会在单词首次出现时因键不存在而抛出 KeyError: 'apple'。使用 get(word, 0) 是初学者必须掌握的防御性写法。
题目 14:合并两个字典并累加相同键的值
stock_a = {'pen': 12, 'notebook': 5, 'eraser': 8} 和 stock_b = {'pen': 7, 'ruler': 4, 'eraser': 10}。要求合并为一份新字典,相同物品的数量相加,独有物品保留。核心思路:单纯的 stock_a.update(stock_b) 会直接覆盖共有键的值。正确做法是浅拷贝一份字典,再遍历第二个字典,将数值叠加到对应键上。
stock_a = {'pen': 12, 'notebook': 5, 'eraser': 8}
stock_b = {'pen': 7, 'ruler': 4, 'eraser': 10}

# 复制一份以防破坏原始数据
merged_stock = stock_a.copy()

for item, count in stock_b.items():
    merged_stock[item] = merged_stock.get(item, 0) + count

print(f"仓库A: {stock_a}")
print(f"仓库B: {stock_b}")
print(f"合并累计后总库存: {merged_stock}")仓库B: {'pen': 7, 'ruler': 4, 'eraser': 10}
合并累计后总库存: {'pen': 19, 'notebook': 5, 'eraser': 18, 'ruler': 4}
题目 15:集合运算求解两组爱好交集与差集
user1 = ["篮球", "游泳", "摄影", "编程"],user2 = ["摄影", "音乐", "编程", "滑板"]。求解他们共同的爱好(交集)、两人的全部爱好(并集)以及 user1 独有的爱好(差集)。核心思路:将列表转换为集合类型 set,利用集合专用的位运算符:&(交集)、|(并集)、-(差集)。
user1 = ["篮球", "游泳", "摄影", "编程"]
user2 = ["摄影", "音乐", "编程", "滑板"]

set1 = set(user1)
set2 = set(user2)

common_hobbies = set1 & set2     # 交集
all_hobbies = set1 | set2        # 并集
only_user1 = set1 - set2         # 差集

print(f"共同爱好 (交集): {list(common_hobbies)}")
print(f"全部爱好 (并集): {list(all_hobbies)}")
print(f"同学1独有爱好 (差集): {list(only_user1)}")全部爱好 (并集): ['滑板', '音乐', '编程', '篮球', '游泳', '摄影']
同学1独有爱好 (差集): ['篮球', '游泳']
list 时,元素内部顺序不能作为业务逻辑排序的依赖。
题目 16:对包含字典的列表按指定字段排序
students = [{'name': '张三', 'age': 19}, {'name': '李四', 'age': 18}, {'name': '王五', 'age': 20}],要求按照学生的年龄从大到小(降序)排列。核心思路:内置函数 sorted() 支持通过 key 参数指定排序依据。利用 lambda x: x['age'] 提取排序字段,并设置 reverse=True 实现降序。
students = [
    {'name': '张三', 'age': 19},
    {'name': '李四', 'age': 18},
    {'name': '王五', 'age': 20}
]

# sorted 返回排序后的全新列表
sorted_students = sorted(students, key=lambda item: item['age'], reverse=True)

print("按年龄从大到小排序结果:")
for stu in sorted_students:
print(f"姓名: {stu['name']}, 年龄: {stu['age']}")姓名: 王五, 年龄: 20
姓名: 张三, 年龄: 19
姓名: 李四, 年龄: 18
'age' 这个键,Lambda 表达式会立即抛出 KeyError。在生产开发中可使用 lambda x: x.get('age', 0) 增强健壮性。
第五部分:函数封装与算法进阶(题 17 ~ 20)
函数是组织代码逻辑和实现复用的基本单元。此阶段考察函数定义(def)、参数传递、返回值以及常见的基础逻辑算法(回文、递推、质数筛选与交互防崩)。
题目 17:回文字符串检测函数封装
is_palindrome(s) 的函数,判断输入的字符串是否为回文(正读和反读完全一致,如 "radar"、"level"),忽略大小写与内部空格,返回布尔值。核心思路:先做数据预处理:将所有字母统一转为小写 s.lower() 并过滤掉空白字符;之后直接比对字符串与其反转切片 cleaned == cleaned[::-1]。
def is_palindrome(text: str) -> bool:
    # 过滤掉非字母数字字符并转为纯小写
    cleaned = ''.join(char.lower() for char in text if char.isalnum())
    # 与其倒序切片进行恒等比较
    return cleaned == cleaned[::-1]

test_cases = ["Race car", "Python", "No 'x' in Nixon", "hello"]

for item in test_cases:
print(f"'{item}' -> 是否为回文: {is_palindrome(item)}")'Python' -> 是否为回文: False
'No 'x' in Nixon' -> 是否为回文: True
'hello' -> 是否为回文: False
return 语句,函数执行完毕默认返回 None,外部调用接收到的判断结果将始终判定为假。
题目 18:生成指定项数的斐波那契数列
generate_fibonacci(n),生成前 n 项斐波那契数列。规则:前两项为 0 和 1,后续每项为前两项之和(如 n=7 -> [0, 1, 1, 2, 3, 5, 8])。核心思路:初学者往往先想到递归,但递归存在严重的重复计算和调用栈溢出风险。更推荐采用循环迭代法,通过动态推进两个指针累加,时间复杂度仅为 O(n)。
def generate_fibonacci(count: int) -> list:
    if count <= 0:
        return []
    if count == 1:
        return [0]

    fib = [0, 1]
    while len(fib) < count:
        fib.append(fib[-1] + fib[-2])
    return fib

n = 8
result_sequence = generate_fibonacci(n)
print(f"前 {n} 项斐波那契数列为: {result_sequence}")count <= 0 或 count == 1 的边界条件。如果不做边界保护,当用户传入 0 或负数时可能导致无限循环或索引越界。
题目 19:素数(质数)判断与范围遍历优化
is_prime(n),判断一个给定的正整数是否为质数(只能被 1 和自身整除的大于 1 的自然数)。核心思路:若一个数 n 能被因数分解为 a * b,则其中必然有一个因数小于或等于 √n。因此只需检验 2 到 int(n**0.5) + 1 范围内的整数是否能被整除即可,无需遍历到 n - 1,大幅降低时间复杂度。
def is_prime(num: int) -> bool:
    if num <= 1:
        return False
    if num == 2:
        return True
    if num % 2 == 0:
        return False

    # 只需遍历奇数因数至平方根边界
    limit = int(num ** 0.5) + 1
    for i in range(3, limit, 2):
        if num % i == 0:
            return False
    return True

test_numbers = [1, 2, 17, 21, 97, 100]
for val in test_numbers:
print(f"数字 {val:3d} 是否为素数: {is_prime(val)}")数字 2 是否为素数: True
数字 17 是否为素数: True
数字 21 是否为素数: False
数字 97 是否为素数: True
数字 100 是否为素数: False
num <= 1 的边界判定。
题目 20:控制台猜数字游戏与异常输入防御
try-except 捕捉非数字非法输入。核心思路:结合 random.randint(1, 100) 生成目标值,使用 while True 驱动游戏循环。使用 try: guess = int(...) except ValueError: 拦截非法字符,防止程序中途崩溃。
import random

def run_guessing_game(mock_inputs=None):
    # 模拟或真实生成目标数字,此处演示设定目标为 42
    secret_number = 42
    attempts = 0

    # 模拟玩家的连续输入序列以供确定性展示
    inputs = mock_inputs if mock_inputs is not None else ["hello", "25", "60", "42"]
    input_idx = 0

    print("【猜数字游戏启动】目标范围: 1 ~ 100")
    while True:
        raw_val = inputs[input_idx]
        input_idx += 1
        print(f"玩家输入: '{raw_val}'")

        # 异常捕获防止非整数输入导致程序崩溃
        try:
            guess = int(raw_val)
        except ValueError:
            print("警告: 请输入有效的整数,本次输入不计入有效猜测!")
            continue

        attempts += 1
        if guess < secret_number:
            print(f"第 {attempts} 次: 猜小了!")
        elif guess > secret_number:
            print(f"第 {attempts} 次: 猜大了!")
        else:
            print(f"恭喜猜中!正确答案为 {secret_number},累计有效猜测次数: {attempts}")
            break

run_guessing_game()玩家输入: 'hello'
警告: 请输入有效的整数,本次输入不计入有效猜测!
玩家输入: '25'
第 1 次: 猜小了!
玩家输入: '60'
第 2 次: 猜大了!
玩家输入: '42'
恭喜猜中!正确答案为 42,累计有效猜测次数: 2
continue 跳过本轮循环余下逻辑,不可让未赋值的 guess 继续参与大小比较。
练习总结与学习建议
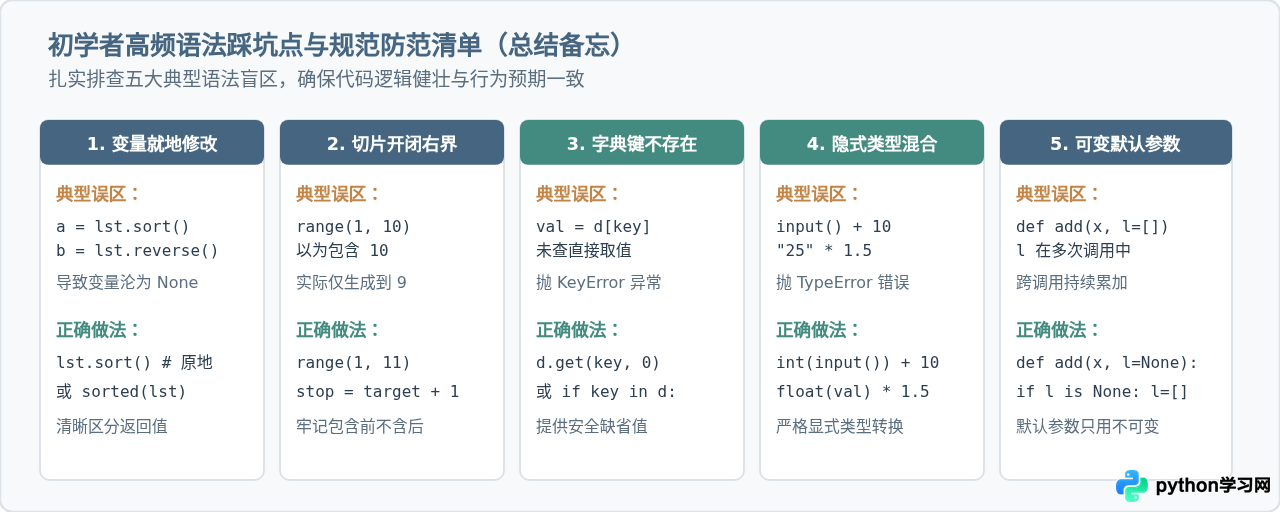
完成上述20道基础题目后,初学者不仅能够熟练掌握Python核心语法的书写规范,更能在头脑中建立起处理现实数据与逻辑控制的程序骨架。在后续的学习与练习中,建议保持以下两点习惯:
- 先纸面推演,再动手编码:遇到复杂逻辑(如九九乘法表嵌套循环、单次遍历求次大值)时,先用草稿纸列出前几轮的变量数值变化,明确边界条件后再写代码。
- 善用终端交互与错误提示:遇到报错不要慌张,学会阅读
Traceback中提示的行号与异常类型(TypeError、KeyError、IndexError等),这些错误信息往往就是定位问题的最佳向导。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















