


Python列表切片[start:end:step]中冒号的含义与省略规则
深入解析Python列表切片中冒号的作用机制与省略默认规则,涵盖单冒号、双冒号、正负步长推导逻辑、边界栅栏模型及常见陷阱与示例代码。
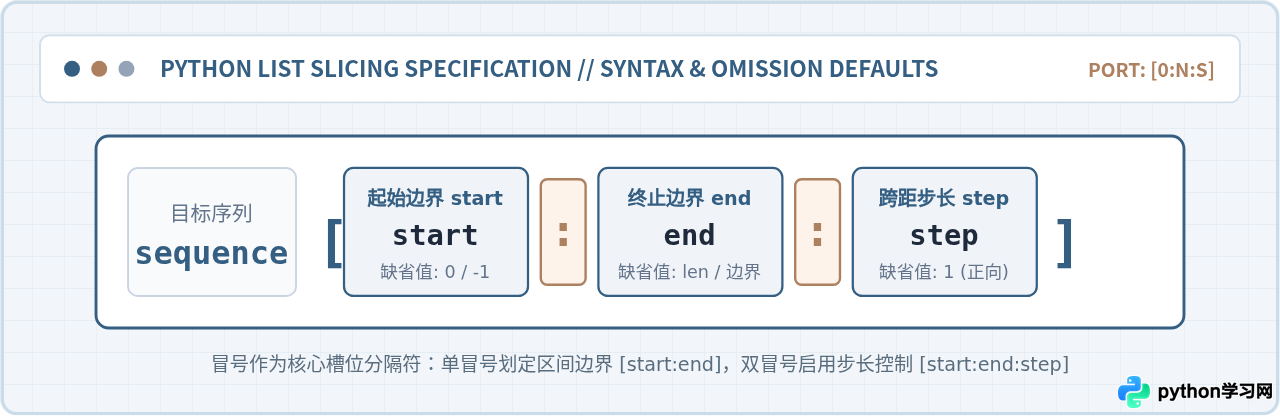
:)是语法层面的分词占位符,其核心职责是隔离 start(起始索引)、end(终止索引)与 step(步长跨度)三个控制槽位。单冒号用于界定基础截取范围,双冒号则显式开启步长控制。当对应槽位的参数被留空时,Python 会根据步长的正负方向自动匹配确定性的默认边界,而非固定取 0 或序列末尾。
一、冒号的语法定位与参数槽位划分
Python 列表支持通过索引提取单个元素,但如果要获取序列的连续子集,就需要使用切片操作符。在形式 sequence[start:end:step] 中,冒号承担着参数槽位隔离的角色。Python 解释器在编译期通过冒号的数量和相对位置,判断当前括号内传入的整数究竟作用于起跳边界、终止边界还是步长增量。
从底层实现机制来看,表达式 s[a:b:c] 在 Python 虚拟机内部等价于调用内置函数构造一个切片对象:s[slice(a, b, c)]。冒号本身并不存储任何数值,它的作用仅在于指明每一个参数在 slice() 构造器中的对应位置。如果不提供参数而直接书写冒号,该位置在内部会被赋予默认的 None,随后由对象协议结合序列长度与方向进行动态计算。
- 单冒号结构
[start:end]:声明两个参数槽位。第一个参数为起始索引,第二个参数为结束索引,此时步长step隐式缺省为默认值1。 - 双冒号结构
[start:end:step]:声明完整的三参数槽位。第一个冒号左侧为start,两个冒号之间为end,第二个冒号右侧为step。
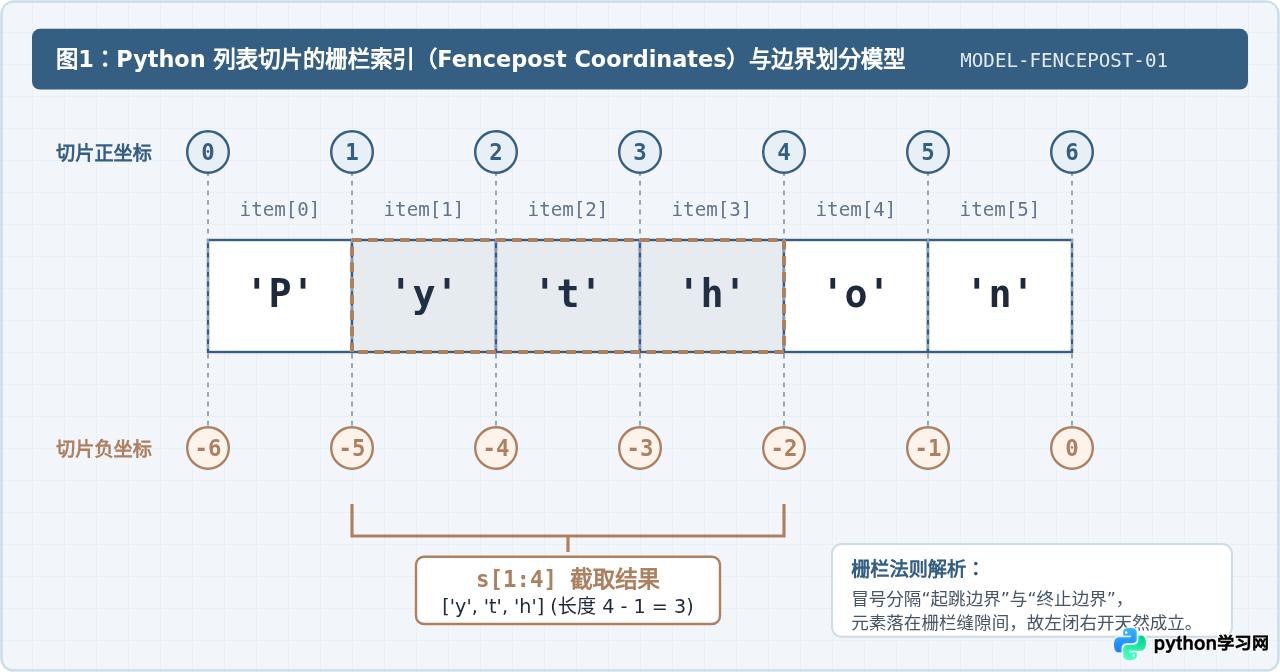
理解切片区间“左闭右开”的最佳思维模型是栅栏坐标模型(Fencepost Coordinates)(如图 1 所示)。在 Python 中,切片索引 start 与 end 并非直接指向具体的列表元素,而是指向元素之间的“缝隙切割线”。
对于包含 6 个元素的列表,其有效栅栏切割线为 0 到 6。执行 s[1:4] 时,切片从 1 号缝隙开始下刀,到 4 号缝隙收刀,落在两刀之间的元素正是 s[1]、s[2]、s[3]。这种设计带来了极具工程价值的两个数学特性:一是切片提取的子列表长度精确等于 end - start(4 - 1 = 3);二是两个相邻切片 s[:k] 与 s[k:] 能够无缝拼接复原原序列,既无重叠也无遗漏。
二、参数省略时的默认值判定机制
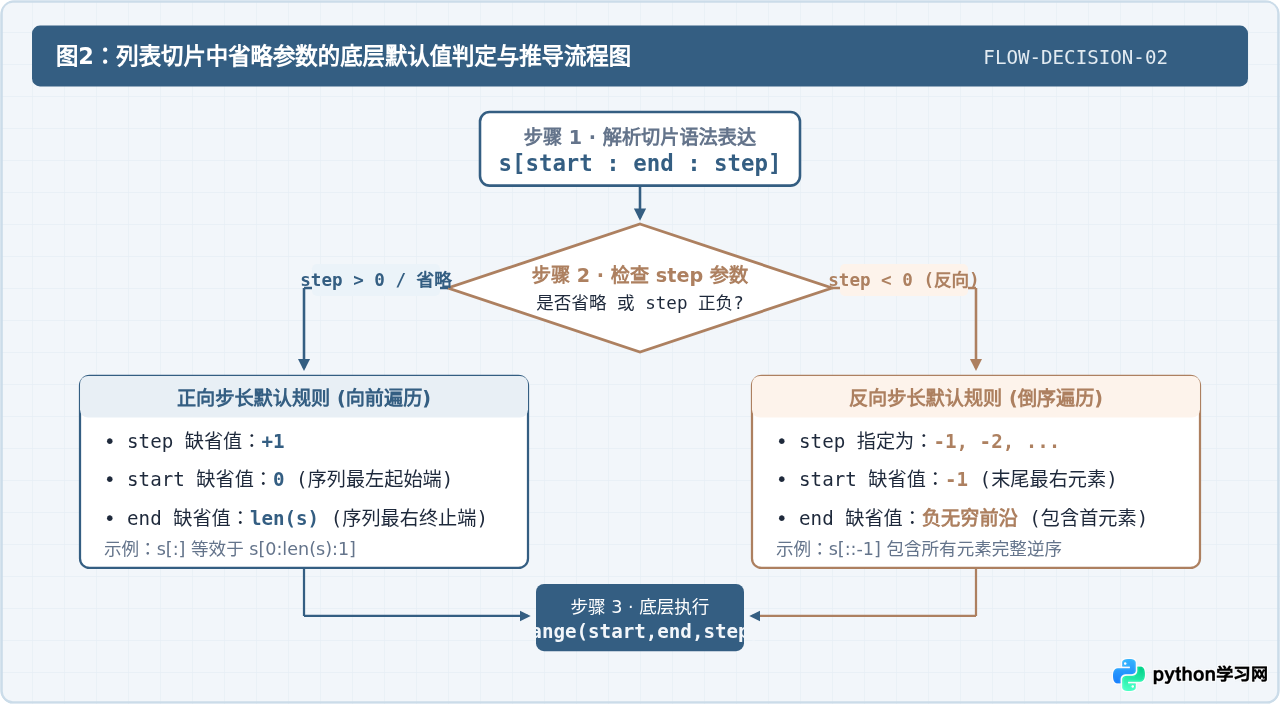
当编写切片表达式省略某些参数时,冒号的存在确保了未省略参数的槽位不会发生错位。例如在 s[:3] 中,冒号表明 3 处于 end 槽位,而不是 start。当参数缺省时,Python 并非总是简单地将 start 补为 0、将 end 补为列表长度,而是完全由 step 的正负号决定默认边界的选取。
1. 正向步长(step > 0 或省略 step)的默认值规则
当 step 未指定或为正整数时,切片沿着索引递增的方向从左向右提取元素:
- 省略
start:默认值为0,即从序列的最前端(索引 0)开始截取。 - 省略
end:默认值为序列的长度len(sequence),即一直截取到序列末尾,包含最后一个元素。 - 省略
step:默认值为1,即逐个元素连续提取。
2. 逆向步长(step < 0)的默认值规则
当 step 为负整数时,切片方向发生翻转,提取逻辑变为从右向左递减遍历:
- 省略
start:默认值为-1,即从序列最右侧的最后一个元素开始起步。 - 省略
end:默认值跨过最左侧的 0 号索引,延伸至索引 0 之前的前沿边界。这是因为在左闭右开规则下,如果将end设为0,根据右开原则将无法包含 0 号元素;只有将其缺省(底层表示为负无穷方向边界),才能完整提取到首个元素。 - 注意:逆向切片中如果显式指定
end=0(例如s[::-1]与s[:-1:-1]),会导致索引 0 被排除在外。
三、常见省略组合与典型切片操作
结合冒号与槽位留空,Python 中衍生出了多种经典且高效的切片用法。以下通过具体代码示例演示各类常见组合的实际效果与执行结果。
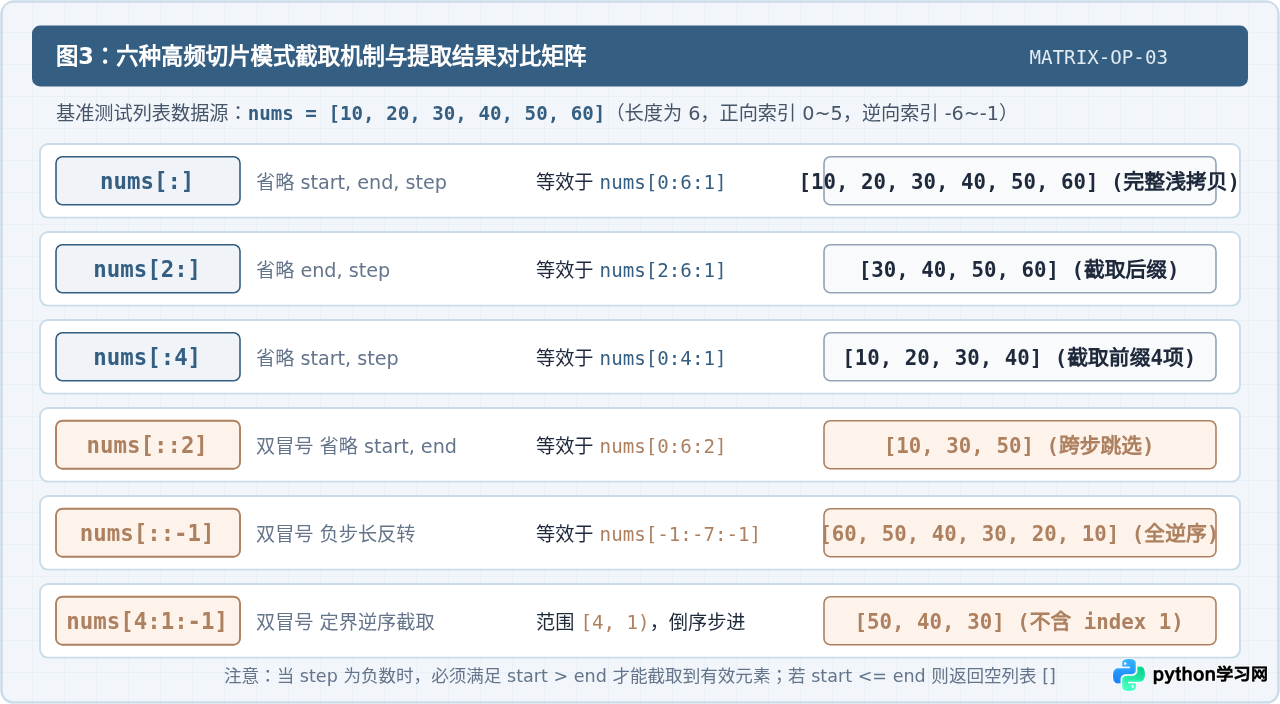
1. 完整浅拷贝:s[:] 与 s[::]
单冒号或双冒号且全部槽位留空,表示保留默认的起始位置、结束位置和步长 1。该操作会生成原列表的一个全新顶层浅拷贝副本:
# 测试环境:Python 3.x
nums = [10, 20, 30, 40, 50, 60]

copy_one = nums[:]
copy_two = nums[::]

# 示例输出:
# copy_one: [10, 20, 30, 40, 50, 60]
# copy_one is nums: False (内存地址独立,属于新对象)
2. 截取前缀与截取后缀:s[:n] 与 s[n:]
单冒号右侧写数值表示取前 n 项;左侧写数值表示从索引 n 开始截取到末尾:
letters = ['a', 'b', 'c', 'd', 'e']

prefix = letters[:3]  # 等效于 letters[0:3:1]
suffix = letters[2:]  # 等效于 letters[2:5:1]

# 示例输出:
# prefix: ['a', 'b', 'c']
# suffix: ['c', 'd', 'e']
3. 等间隔跳跃采样:s[::step]
当需要以固定步长提取序列时,首尾槽位留空,仅在第二个冒号后填充步长数值:
data = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

evens = data[::2]   # 从 0 开始,每隔 2 项采样:[0, 2, 4, 6, 8]
odds = data[1::2]   # 从 1 开始,每隔 2 项采样:[1, 3, 5, 7, 9]

# 示例输出:
# evens: [0, 2, 4, 6, 8]
# odds:  [1, 3, 5, 7, 9]
4. 列表翻转:s[::-1]
这是 Python 中倒序排列序列最简洁高效的惯用法。步长为 -1,首尾全部省略,自动从末项遍历至首项:
original = ['first', 'second', 'third', 'fourth']
reversed_list = original[::-1]

# 示例输出:
# reversed_list: ['fourth', 'third', 'second', 'first']
5. 定界倒序截取:s[start:end:-1]
在逆向步长下指定起止边界时,start 对应的位置必须位于 end 的右侧(即 start > end):
nums = [10, 20, 30, 40, 50, 60]
subset_rev = nums[4:1:-1]

# 过程推导:从索引 4 开始,向前步进至索引 1(不含 1)
# 提取索引 4 (50), 索引 3 (40), 索引 2 (30)
# 示例输出:
# subset_rev: [50, 40, 30]
四、边界处理、常见陷阱与注意事项
在编写和维护包含切片的代码时,有几个关键特性和容易混淆的边界情况需要特别留意。
单元素索引越界会直接抛出
IndexError(例如 lst[99]);而切片表达式具有极强的容错能力,无论输入的 start 或 end 超出列表边界多少,Python 都会自动将其截断并钳制到 [0, len(s)] 的合法区间,绝不会抛出 IndexError。
sample = [1, 2, 3]

# 单索引越界会崩溃:
# print(sample[10])  -> 抛出 IndexError: list index out of range

# 切片越界优雅截断:
safe_slice = sample[1:100]  # 示例输出: [2, 3]
empty_slice = sample[50:100] # 示例输出: [] (不报错,返回空列表)
常见陷阱一:步长方向与边界起止矛盾导致返回空列表
初学者最容易犯的错误之一是混淆步长方向与边界大小。切片如果设定了负步长(如 step = -1),遍历指针是向左移动的。如果此时指定的 start 小于 end,指针从起点向左移动将永远无法到达右侧的终点,Python 会判定该区间不可达,直接返回空列表 []:
nums = [1, 2, 3, 4, 5]

# 错误写法:期望倒序提取 1 到 4,但 start < end 且 step 为负
wrong = nums[1:4:-1]
# 示例输出: []

# 正确写法:起点必须在终点右侧
correct = nums[4:1:-1]
# 示例输出: [5, 4, 3]
常见陷阱二:变量引用赋值与切片赋值的区别
编写切片时必须区分“右值切片拷贝”与“左值切片就地赋值”:
b = a[:]:右值切片,创建了新列表b。修改b的元素不会影响原列表a。a[:] = [1, 2, 3]:左值切片赋值,这是在原列表内存块内就地覆盖(In-place mutation)。所有指向a的外部引用都会观察到这一更改。
五、规则速查与全景总结
为了便于在日常开发中快速决策与查阅,下表梳理了切片中各类冒号使用形式、省略行为及实际等价关系:
| 切片语法形式 | 冒号数量 | 省略的参数项 | 等效完整形式(假设序列长度为 N) | 工程用途与语义说明 |
|---|---|---|---|---|
s[:] |
1 个 | start, end | s[0:N:1] |
生成序列的完整顶层浅拷贝副本 |
s[start:] |
1 个 | end | s[start:N:1] |
从 start 开始截取到序列末尾(包含末项) |
s[:end] |
1 个 | start | s[0:end:1] |
从序列开头截取至 end 栅栏处(不含 index end) |
s[start:end] |
1 个 | step | s[start:end:1] |
常规左闭右开区间截取,连续步长为 1 |
s[::step] |
2 个 | start, end | s[0:N:step] (若 step > 0) |
全序列跨步均匀抽样(如奇偶索引过滤) |
s[::-1] |
2 个 | start, end | s[-1:-(N+1):-1] |
序列完全逆序反转 |
s[start::step] |
2 个 | end | s[start:N:step] (若 step > 0) |
从指定起点出发,按固定步长延伸至末端 |
s[:end:step] |
2 个 | start | s[0:end:step] (若 step > 0) |
从头部开始,按固定跨度采样直到 end |
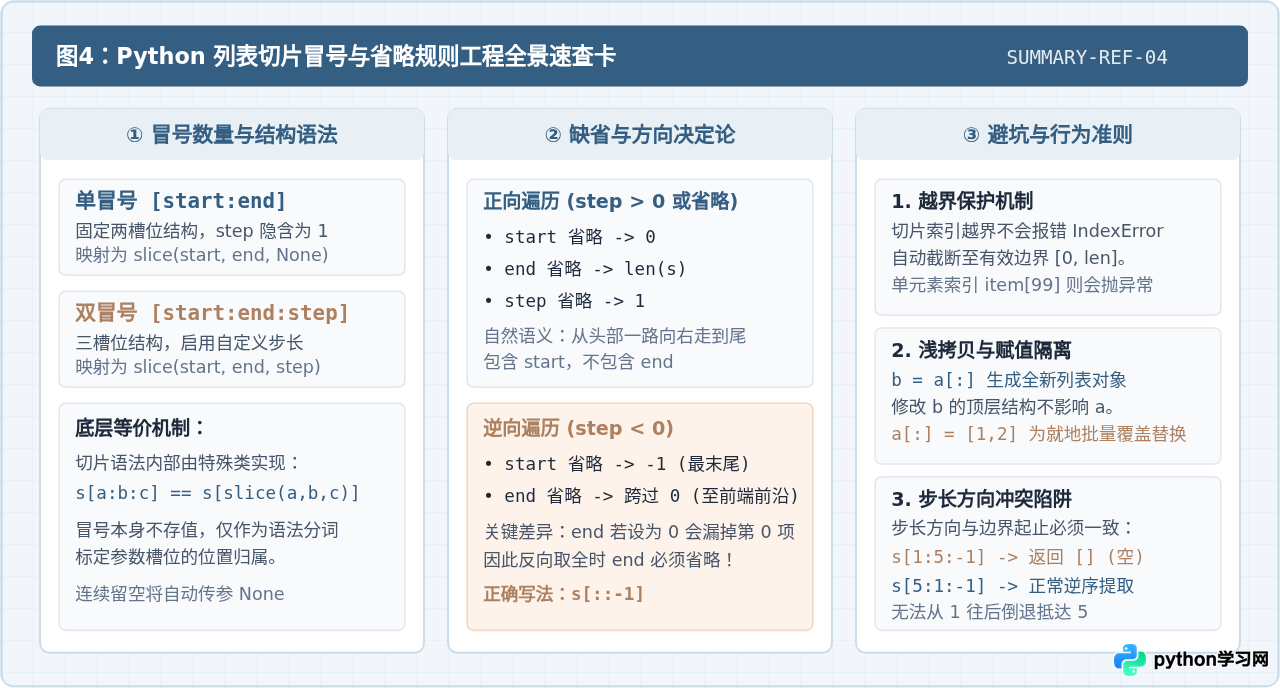
归纳而言,Python 列表切片中冒号的核心价值在于以极其精炼的标点语法,构建了多参数槽位的确定性映射。只要熟记“栅栏缝隙界定范围”、“单冒号两槽位、双冒号三槽位”以及“步长正负主导缺省值边界”这三大支柱原则,无论是面对基础截取、复杂采样还是逆序遍历,都能做到准确推导与稳健编写。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















