


Python装饰器与生成器的原理及实际应用案例
深入解析Python装饰器与生成器的底层实现原理,涵盖闭包结构、虚拟机栈帧状态机、字节码运作机制,并提供API耗时监控、鉴权拦截、海量日志流式解析及协同管道等实际工程落地案例。
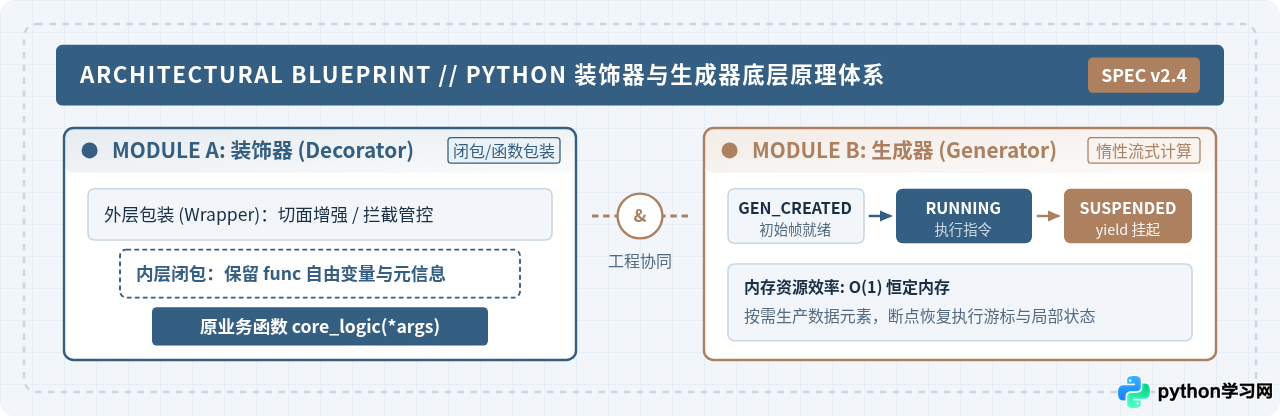
yield 表达式的流式计算状态机,通过在 CPython 堆上保留虚拟机栈帧游标,实现了按需求值与恒定 $O(1)$ 内存开销的数据迭代。本文系统拆解两者的底层运行机制,并结合性能监控、鉴权拦截、海量日志流式清洗与协同管道等实际工程案例,给出可直接复用的完整实现方案与陷阱排查清单。
一、Python 装饰器的底层原理与调用机制
装饰器在设计模式中对应切面编程(AOP,Aspect-Oriented Programming)。在 Python 中,函数是第一类对象(First-Class Object),意味着函数可以作为参数传递、在另一个函数内部定义,并作为返回值输出。装饰器的核心实现基石正是高阶函数与闭包环境。
1.1 闭包环境与自由变量捕获
当一个内层函数引用了包含它的外层函数作用域内的变量,并且外层函数将这个内层函数作为对象返回时,便构成了闭包(Closure)。被引用的外层变量被称为自由变量(Free Variable)。
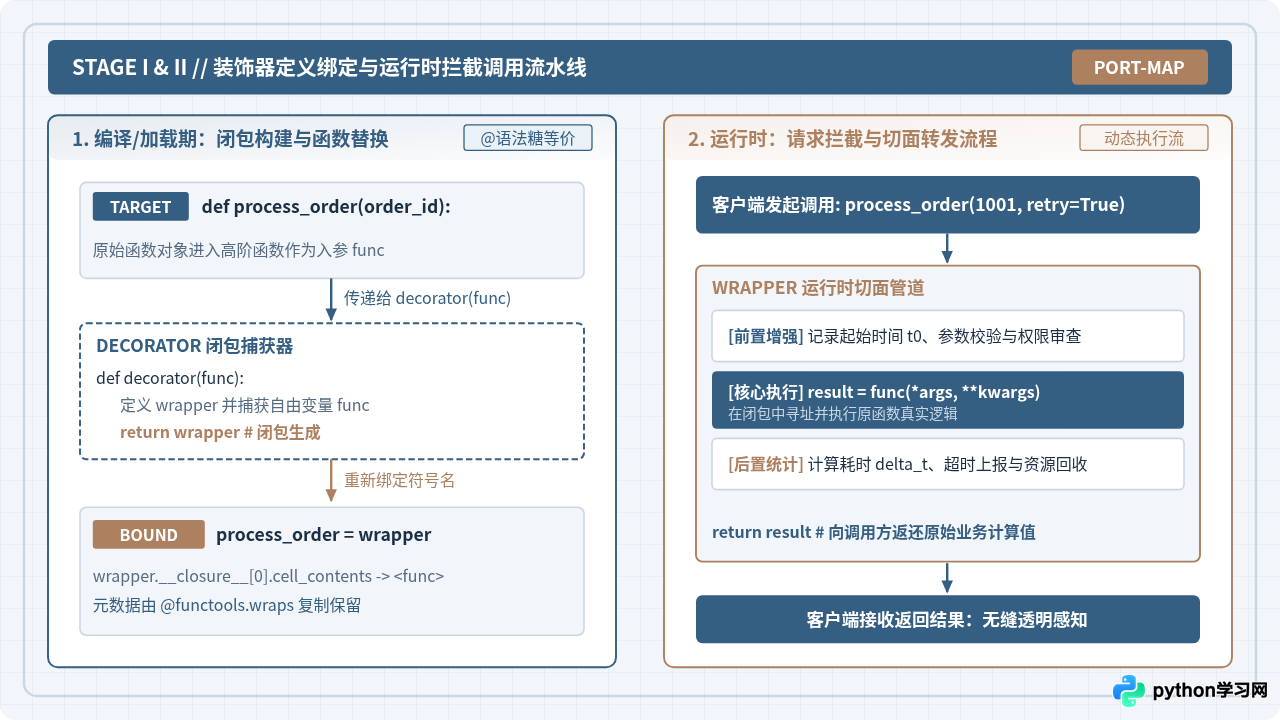
在 CPython 虚拟机实现中,闭包通过函数的 __closure__ 属性进行状态维系。__closure__ 是一个元组,内部包含由 cell 对象封装的自由变量引用。即使外层函数执行完毕且本地作用域已销毁,内层函数依然能够通过 cell 对象安全访问和修改这些外部状态。
1.2 语法糖 @ 的编译期替换过程
Python 中的 @decorator 是一种语法糖,它的本质是在模块加载(或类/函数定义执行)时进行同名变量的重新绑定。例如以下代码:
@my_decorator
def calculate_tax(amount):
    return amount * 0.08
在 Python 解释器解析该模块代码块时,会严格等价于执行:
def calculate_tax(amount):
    return amount * 0.08

calculate_tax = my_decorator(calculate_tax)
这意味着在随后的所有调用中,客户端代码所执行的 calculate_tax 实际上已经是 my_decorator 返回的包装函数(通常命名为 wrapper)。
1.3 functools.wraps 的元信息保护
直接进行函数替换会导致原始函数的内省元数据丢失,包括函数名 __name__、文档注释 __doc__ 以及类型注解 __annotations__。这会给自动化文档生成、单元测试反射和调试定位带来困难。
标准库 functools.wraps 本身也是一个装饰器,它在底层调用 functools.update_wrapper,将原函数的属性复制给内层 wrapper,并在 wrapper.__wrapped__ 中保存原函数的直接引用,从而确保元信息完整传递。
1.4 带参数装饰器的三层闭包结构
普通装饰器只接收一个 func 参数。当需要给装饰器自身传递配置项(例如超时阈值、重试次数)时,需要构建三层函数嵌套:最外层接收配置参数,中间层接收目标函数 func,最内层接收运行时的 *args, **kwargs。
二、装饰器的工程实践案例
以下通过两个生产级真实场景展示装饰器的标准编写方式,代码均基于 Python 3.8+ 标准环境,可直接运行验证。
2.1 案例一:API 接口耗时统计与超时报警装饰器
在微服务或 Web 接口开发中,需要对特定核心函数的耗时进行精准统计,并在超过指定阈值时打印警告日志或触发告警指标。
import time
import functools
import logging
from typing import Callable, Any

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def monitor_perf(slow_threshold_sec: float = 1.0) -> Callable:
    """
    性能统计装饰器(带参数):
    :param slow_threshold_sec: 慢执行阈值(单位秒)
    """
    def decorator(func: Callable) -> Callable:
        @functools.wraps(func)
        def wrapper(*args: Any, **kwargs: Any) -> Any:
            start_time = time.perf_counter()
            func_qualname = func.__qualname__
            try:
                result = func(*args, **kwargs)
                return result
            finally:
                elapsed = time.perf_counter() - start_time
                if elapsed >= slow_threshold_sec:
                    logging.warning(
                        f"[ALERT] 函数 {func_qualname} 执行超时! "
                        f"耗时: {elapsed:.4f}s (阈值: {slow_threshold_sec:.2f}s)"
                    )
                else:
                    logging.info(f"[PERF] 函数 {func_qualname} 耗时: {elapsed:.4f}s")
        return wrapper
    return decorator

# 模拟业务函数
@monitor_perf(slow_threshold_sec=0.2)
def query_user_profile(user_id: int) -> dict:
    time.sleep(0.05)  # 模拟常规数据库查询
    return {"user_id": user_id, "name": "Alice", "role": "admin"}

@monitor_perf(slow_threshold_sec=0.2)
def export_large_report(report_id: str) -> bool:
    time.sleep(0.25)  # 模拟耗时较大的复杂分析运算
    return True

if __name__ == "__main__":
    query_user_profile(1001)
    export_large_report("RPT-9801")
示例输出:
2026-10-31 09:30:00,102 [INFO] [PERF] 函数 query_user_profile 耗时: 0.0512s
2026-10-31 09:30:00,358 [WARNING] [ALERT] 函数 export_large_report 执行超时! 耗时: 0.2524s (阈值: 0.20s)
2.2 案例二:基于角色的权限鉴权与上下文注入拦截器
在处理敏感操作(如删除、配置变更)时,通过装饰器拦截未经授权的请求,避免在每个视图函数中重复编写校验逻辑。
import functools
from typing import Callable, Any, Set

class PermissionDenied(Exception):
    """权限不足异常"""
    pass

# 模拟请求上下文
CURRENT_SESSION = {"user": "developer_tom", "roles": {"editor", "tester"}}

def require_roles(required_roles: Set[str]) -> Callable:
    """
    权限检查装饰器:
    :param required_roles: 执行该方法所需的角色集合(满足任一即可)
    """
    def decorator(func: Callable) -> Callable:
        @functools.wraps(func)
        def wrapper(*args: Any, **kwargs: Any) -> Any:
            user_roles = CURRENT_SESSION.get("roles", set())
            user_name = CURRENT_SESSION.get("user", "Anonymous")

            # 校验交集
            if not (user_roles & required_roles):
                raise PermissionDenied(
                    f"用户 [{user_name}] 缺少操作权限。需要: {required_roles}, 具备: {user_roles}"
                )

            # 校验通过,注入操作审计字段并向下透传
            kwargs["_operator"] = user_name
            return func(*args, **kwargs)
        return wrapper
    return decorator

@require_roles(required_roles={"editor", "admin"})
def update_article_content(article_id: int, title: str, **kwargs) -> str:
    operator = kwargs.get("_operator")
    return f"文章 {article_id} 标题已更新为: '{title}', 操作人: {operator}"

@require_roles(required_roles={"admin"})
def delete_database_cluster(cluster_id: str, **kwargs) -> str:
    return f"集群 {cluster_id} 已删除"

if __name__ == "__main__":
    # 正常调用:具备 editor 权限
    msg = update_article_content(101, "深入理解 Python 底层")
    print("执行成功:", msg)

    # 异常调用:缺少 admin 权限
    try:
        delete_database_cluster("db-prod-01")
    except PermissionDenied as e:
        print("拦截异常:", str(e))
示例输出:
执行成功: 文章 101 标题已更新为: '深入理解 Python 底层', 操作人: developer_tom
拦截异常: 用户 [developer_tom] 缺少操作权限。需要: {'admin'}, 具备: {'editor', 'tester'}wrapper 内部使用 nonlocal counter。如果不加 nonlocal,Python 解释器在对 counter += 1 编译时会将其视为当前局部变量的赋值,进而引发 UnboundLocalError: local variable 'counter' referenced before assignment。
三、Python 生成器的底层原理与状态转移
常规函数在调用执行时,CPython 会在调用栈上为其压入一个新的 PyFrameObject(栈帧)。当函数执行遇到 return 或运行结束时,该栈帧会立即从调用栈弹出并被内存回收,其内部所有局部变量随之销毁。
而生成器函数(Generator Function)是任何在函数体内部使用了 yield 关键字的函数。生成器函数的调用行为与普通函数截然不同:调用生成器函数不会立即执行函数体,而是立即返回一个实现了迭代器协议的生成器对象(generator object)。
3.1 CPython 中的栈帧挂起机制
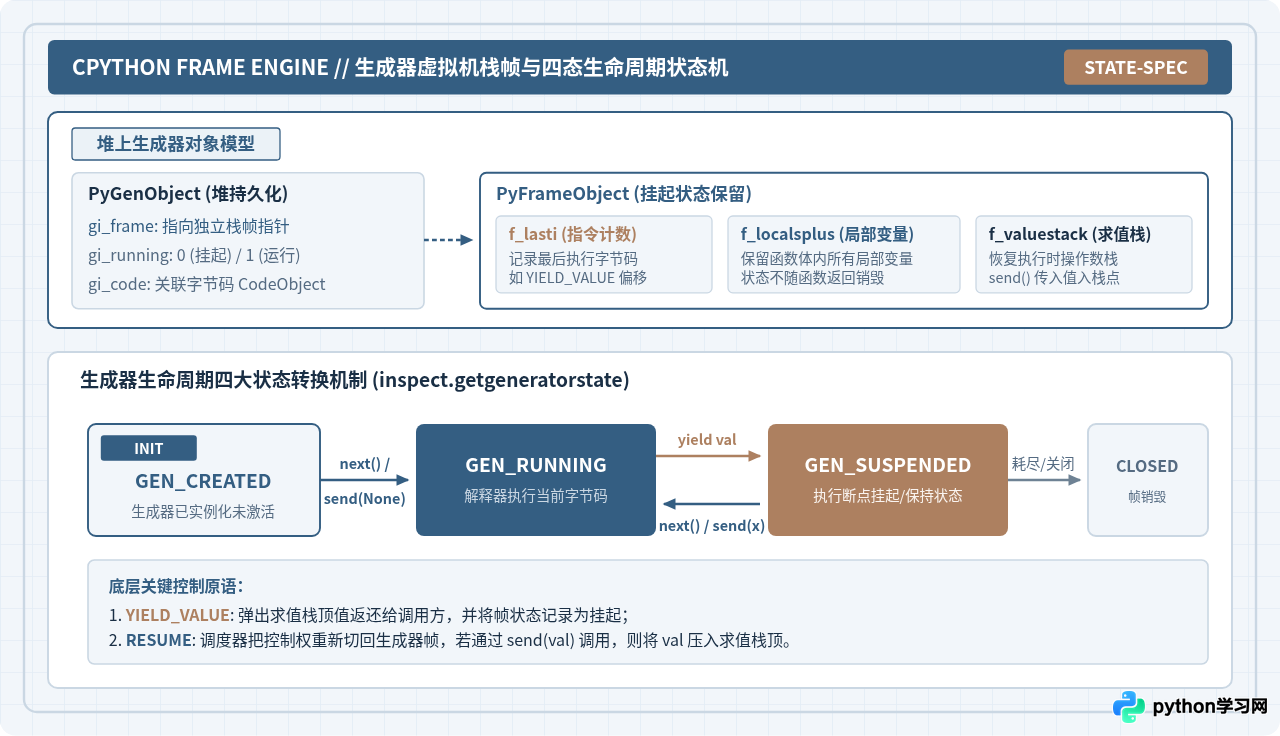
生成器对象在 CPython 底层对应一个 PyGenObject 结构体。它包含一个直接指向独立堆内存中 PyFrameObject 的指针 gi_frame:
gi_frame->f_lasti:保存上一条执行的字节码指令索引(Last Instruction Offset);gi_frame->f_localsplus:保存该函数的全部局部变量和参数值数组;gi_frame->f_valuestack:保存操作数求值栈。
当调用 next(gen) 时,CPython 虚拟机将当前执行上下文切入该生成器的栈帧,从 f_lasti 指向的下一条字节码继续运行;当遇到 yield expr 时,解释器执行字节码指令 YIELD_VALUE,将 expr 的计算结果弹出作为返回值,同时将当前的执行游标 f_lasti 与所有局部变量牢牢保留在堆上,并将控制权切回外部调用方。
3.2 生成器的四种生命周期状态
可以通过标准库 inspect.getgeneratorstate() 查看生成器的实时内部状态,其生命周期包含以下四种:
GEN_CREATED:刚通过生成器函数创建,尚未执行过next()或send(None);GEN_RUNNING:正在由 Python 虚拟机执行指令(通常在多线程或生成器嵌套调用内部体现);GEN_SUSPENDED:在yield表达式处挂起,栈帧保留在堆上,等待下一次激活;GEN_CLOSED:生成器执行完毕退出,或者被显式调用.close(),其栈帧gi_frame已被置为空并释放。
3.3 双向通信通道:send()、throw() 与 yield from
生成器不仅能通过 yield 向外单向吐出数据,还可以通过 gen.send(value) 接收外部传入的值。外部传入的 value 会成为当前挂起点 yield 表达式本身的计算结果。此外,gen.throw(exc_type) 允许在生成器当前挂起位置抛出指定异常;yield from sub_gen 则在调用方与子生成器之间建立双向透明管道,自动委托 send、throw 和返回值捕获。
四、生成器的实际应用案例
生成器最核心的工程价值在于以固定的内存开销($O(1)$ 空间复杂度)处理无限序列或超大数据流,彻底避免因一次性全量加载导致内存耗尽(OOM)。
4.1 案例一:超大日志文件(GB/TB级)的高性能流式解析管道
在生产环境中,排查故障或进行离线数据分析时常常需要读取数十吉字节(GB)的访问日志。传统 f.readlines() 会将整个文件读入内存列表,直接引发崩溃。利用生成器,可以构建按行流式处理管道。
import re
from typing import Generator, Dict, Any

# 正则表达式:提取 Nginx/API 访问日志中的字段
LOG_PATTERN = re.compile(
    r'^(?P<ip>[\d\.]+)\s+-\s+-\s+\[(?P<time>[^\]]+)\]\s+"(?P<method>\w+)\s+(?P<path>[^\s]+)\s+HTTP/[^"]+"\s+(?P<status>\d{3})\s+(?P<bytes>\d+)$'
)

def stream_log_lines(filepath: str) -> Generator[str, None, None]:
    """阶段一:惰性按行读取磁盘文件,恒定微小内存缓冲"""
    with open(filepath, "r", encoding="utf-8") as f:
        for line in f:
            line_str = line.strip()
            if line_str:
                yield line_str

def parse_log_records(lines: Generator[str, None, None]) -> Generator[Dict[str, Any], None, None]:
    """阶段二:对每一行进行格式解析与正则结构化"""
    for line in lines:
        match = LOG_PATTERN.match(line)
        if match:
            data = match.groupdict()
            data["status"] = int(data["status"])
            data["bytes"] = int(data["bytes"])
            yield data

def filter_error_requests(records: Generator[Dict[str, Any], None, None]) -> Generator[Dict[str, Any], None, None]:
    """阶段三:业务过滤,只保留 5xx 服务端错误"""
    for rec in records:
        if rec["status"] >= 500:
            yield rec

# 模拟验证代码
if __name__ == "__main__":
    # 创建模拟测试日志文件
    test_log_file = "access_sample.log"
    with open(test_log_file, "w", encoding="utf-8") as f:
        f.write('192.168.1.10 - - [31/Oct/2026:09:00:01] "GET /api/v1/health HTTP/1.1" 200 120\n')
        f.write('10.0.0.15 - - [31/Oct/2026:09:00:02] "POST /api/v1/pay HTTP/1.1" 502 340\n')
        f.write('192.168.1.12 - - [31/Oct/2026:09:00:05] "GET /api/v1/user HTTP/1.1" 500 512\n')

    # 装配流式管道(尚未消耗任何内存与CPU)
    lines_stream = stream_log_lines(test_log_file)
    parsed_stream = parse_log_records(lines_stream)
    error_stream = filter_error_requests(parsed_stream)

    # 消费端:按需逐个拉取处理
    for error in error_stream:
        print(f"[ERROR ALERT] IP: {error['ip']} 触发异常响应: {error['status']} 请求路径: {error['path']}")
示例输出:
[ERROR ALERT] IP: 10.0.0.15 触发异常响应: 502 请求路径: /api/v1/pay
[ERROR ALERT] IP: 192.168.1.12 触发异常响应: 500 请求路径: /api/v1/user
4.2 案例二:无限序列流与分页批处理窗口
在调用上游第三方 API 或拉取数据库游标时,数据通常以分页形式返回。调用方不应感知分页的具体实现,生成器可以把无限或动态流封装为连续迭代器,并支持按批次聚合提交。
from typing import Generator, List, TypeVar, Tuple
import itertools

T = TypeVar("T")

def mock_paged_api(cursor: int, page_size: int = 3) -> Tuple[List[dict], int]:
    """模拟第三方分页接口:返回(当前页列表,下一个游标),游标为 -1 表示终点"""
    if cursor >= 8:
        return [], -1
    items = [{"id": cursor + i, "data": f"payload_{cursor + i}"} for i in range(page_size) if cursor + i < 8]
    next_cursor = cursor + len(items) if cursor + len(items) < 8 else -1
    return items, next_cursor

def stream_all_records() -> Generator[dict, None, None]:
    """将分页查询透明抽象为连续的单项生成器"""
    cursor = 0
    while cursor != -1:
        items, next_cursor = mock_paged_api(cursor, page_size=3)
        for item in items:
            yield item
        cursor = next_cursor

def batch_window(iterable: Generator[T, None, None], batch_size: int) -> Generator[List[T], None, None]:
    """将单项数据流切分为固定大小的微批次(Batch Window)"""
    it = iter(iterable)
    while True:
        chunk = list(itertools.islice(it, batch_size))
        if not chunk:
            break
        yield chunk

if __name__ == "__main__":
    records_gen = stream_all_records()
    batches_gen = batch_window(records_gen, batch_size=4)

    for idx, batch in enumerate(batches_gen, start=1):
        print(f"批次 #{idx} (包含 {len(batch)} 条数据): {[x['id'] for x in batch]}")
示例输出:
批次 #1 (包含 4 条数据): [0, 1, 2, 3]
批次 #2 (包含 4 条数据): [4, 5, 6, 7]StopIteration),生成器对象即进入 GEN_CLOSED 状态,无法重置或倒退。如果需要对同一批数据进行多次遍历,必须显式将其转为列表(需权衡内存占用),或者重新调用生成器函数创建新的生成器实例。
五、装饰器与生成器的协同模式
在实际生产架构中,装饰器与生成器往往能够相互协同:装饰器负责横向治理(耗时监控、限流、内存告警),生成器负责纵向流式吞吐。
5.1 场景一:流式生成器管道的吞吐率与耗时监控切面
直接在生成器函数内部写监控逻辑会破坏函数的单一职责。通过装饰器包装生成器,可以在外部对每个 yield 出来的元素进行无侵入的耗时统计和吞吐率度量。
import time
import functools
from typing import Callable, Generator

def stream_telemetry(report_interval: int = 1000) -> Callable:
    """
    监控生成器吞吐率与迭代耗时的切面装饰器
    """
    def decorator(gen_func: Callable) -> Callable:
        @functools.wraps(gen_func)
        def wrapper(*args, **kwargs) -> Generator:
            gen = gen_func(*args, **kwargs)
            count = 0
            start_t = time.perf_counter()
            try:
                for item in gen:
                    count += 1
                    yield item
                    if count % report_interval == 0:
                        now = time.perf_counter()
                        qps = count / (now - start_t) if (now - start_t) > 0 else 0
                        print(f"[STREAM TELEMETRY] 已处理 {count} 项, 当前吞吐率: {qps:.1f} items/s")
            finally:
                total_t = time.perf_counter() - start_t
                avg_qps = count / total_t if total_t > 0 else 0
                print(f"[STREAM DONE] 管道迭代结束! 总产出: {count} 项, 总耗时: {total_t:.4f}s, 平均速率: {avg_qps:.1f} items/s")
        return wrapper
    return decorator

@stream_telemetry(report_interval=3)
def number_producer(limit: int):
    for i in range(1, limit + 1):
        time.sleep(0.02)  # 模拟数据生成开销
        yield i * i

if __name__ == "__main__":
    consumer_stream = number_producer(7)
    for value in consumer_stream:
        pass
示例输出:
[STREAM TELEMETRY] 已处理 3 项, 当前吞吐率: 48.7 items/s
[STREAM TELEMETRY] 已处理 6 项, 当前吞吐率: 49.1 items/s
[STREAM DONE] 管道迭代结束! 总产出: 7 项, 总耗时: 0.1432s, 平均速率: 48.9 items/s
5.2 场景二:基于生成器的上下文管理器 (@contextlib.contextmanager)
Python 标准库中最精巧的协同设计莫过于 contextlib.contextmanager。它利用装饰器将只包含单个 yield 的生成器转换为完整的上下文管理器协议:
yield之前的代码在__enter__阶段执行,yield产出的对象被赋值给as变量;yield之后的代码被置于finally块中,在退出with作用域时由__exit__阶段执行。
from contextlib import contextmanager
import time

@contextmanager
def database_transaction(session_id: str):
    """使用生成器与装饰器协同封装事务生命周期"""
    print(f"[{session_id}] 开启底层数据库事务...")
    start_time = time.perf_counter()
    try:
        # yield 将控制权交给 with 代码块,并传递操作句柄
        yield {"session": session_id, "status": "ACTIVE"}
        print(f"[{session_id}] 提交事务 (COMMIT)")
    except Exception as exc:
        print(f"[{session_id}] 捕获异常: {exc}, 执行回滚 (ROLLBACK)")
        raise
    finally:
        cost = time.perf_counter() - start_time
        print(f"[{session_id}] 事务关闭,总连接保持耗时: {cost:.4f}s")

# 正常事务执行验证
with database_transaction("TX-2026-001") as tx:
    print(f"执行写入操作,当前上下文状态: {tx['status']}")
示例输出:
[TX-2026-001] 开启底层数据库事务...
执行写入操作,当前上下文状态: ACTIVE
[TX-2026-001] 提交事务 (COMMIT)
[TX-2026-001] 事务关闭,总连接保持耗时: 0.0003s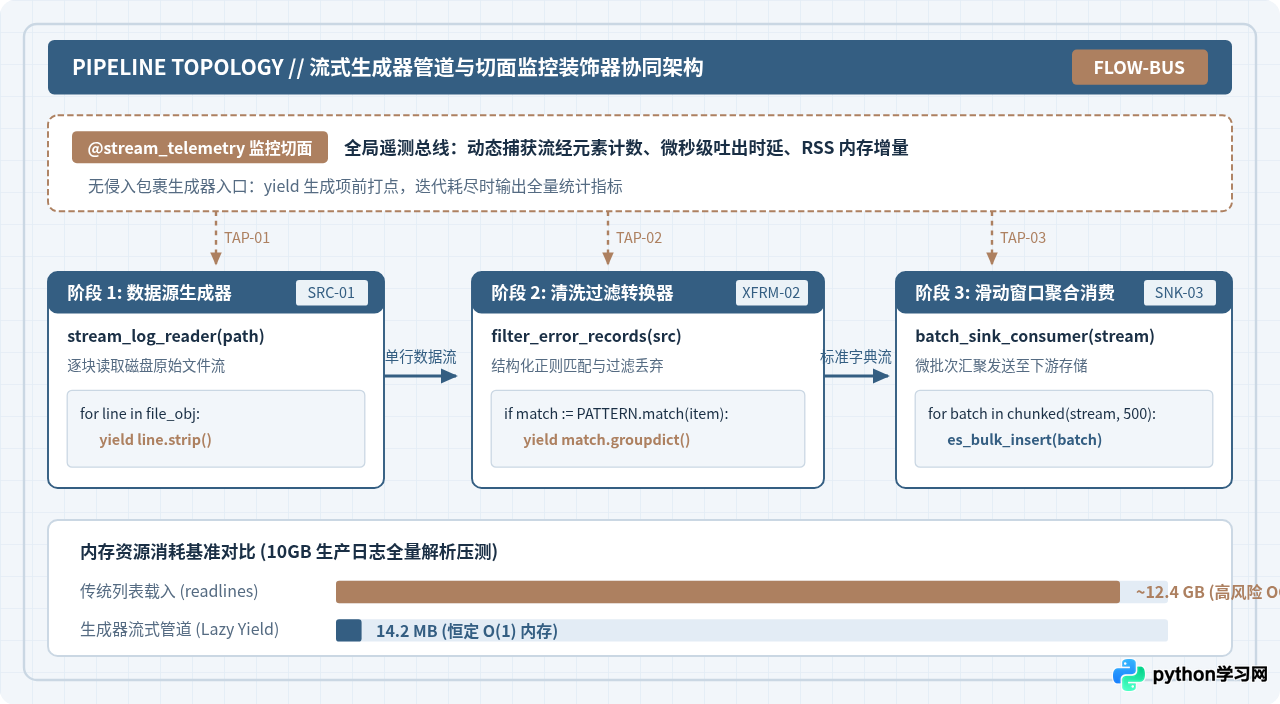
六、核心机制对比与技术选型决策
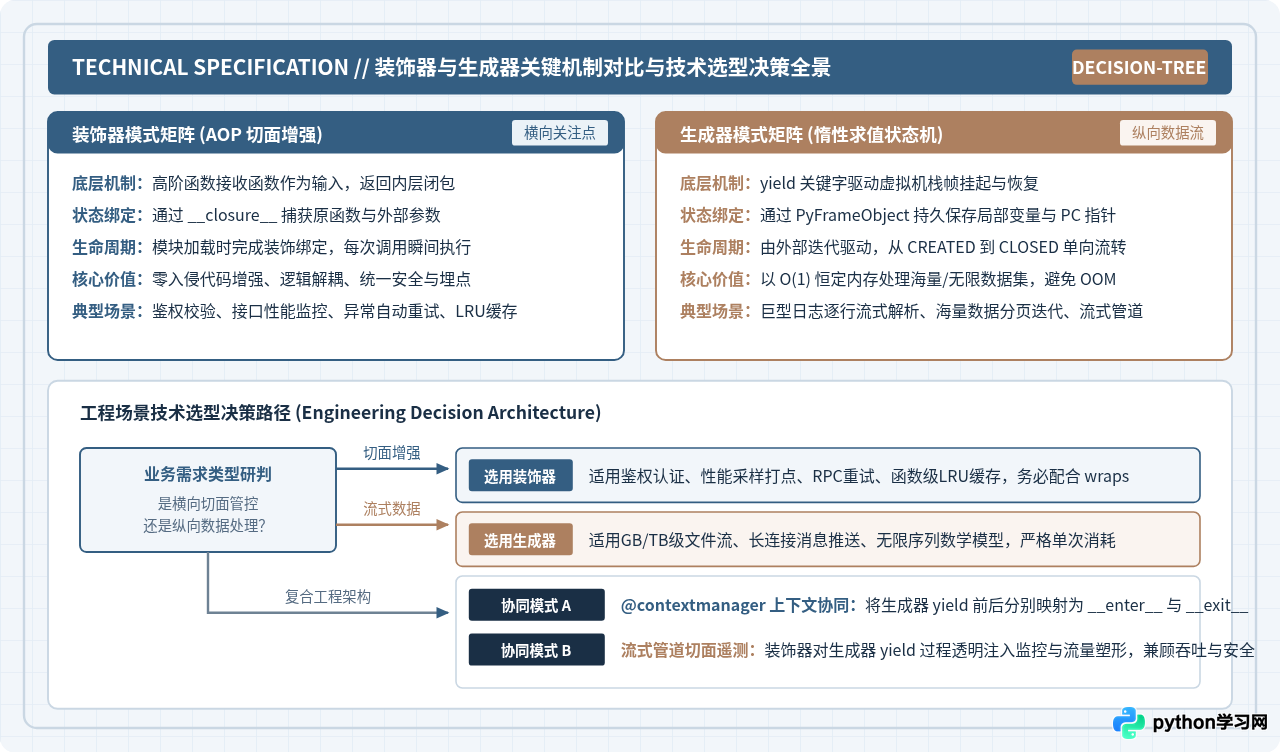
理解装饰器与生成器的差异,关键在于分清它们在软件设计体系中所处的维度:装饰器是横向的“拦截与增强”模式,生成器是纵向的“生产与消费”流式模式。
| 对比维度 | Python 装饰器 (Decorator) | Python 生成器 (Generator) |
|---|---|---|
| 核心设计目的 | 函数行为增强、切面逻辑复用、横向关注点解耦 | 按需流式计算、消除全量内存堆积、协程并发调度 |
| 底层实现机制 | 高阶函数 + 闭包(__closure__)变量环境捕获 |
yield 关键字 + 虚拟机栈帧(PyFrameObject)挂起与恢复 |
| 控制流特征 | 在调用发生时瞬时同步(或异步)完成预制逻辑与后置逻辑 | 由外部调用方按需多次驱动(next()),支持暂停、恢复与双向传值 |
| 内存复杂度 | $O(1)$,仅增加一层内层包装函数与闭包对象的微小开销 | $O(1)$,无论产生 10 条还是 1 亿条数据,仅维持当前栈帧状态 |
| 典型适用边界 | 日志埋点、RPC重试、鉴权认证、缓存包装、参数强校验 | 大文件逐行读写、海量数据清洗、流式批处理管道、无限序列计算 |
七、总结
在 Python 工程化实践中,合理组合装饰器与生成器能够大幅提升代码的可维护性与运行效率:
- 编写装饰器时,务必始终通过
@functools.wraps保护函数的签名与元信息;在闭包中修改外部计数量时明确声明nonlocal; - 编写生成器时,始终牢记其单次消耗的生命周期特征,防止因重复遍历而引发静默空数据异常;
- 面对大规模数据流水线,以生成器构建各个轻量级变换算子,以装饰器实现吞吐量采样与健康度切面遥测,既能避免内存溢出,又能保障系统的可观测性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















