


LeetCode困难级Python算法题解题思路与性能优化技巧
深入解析LeetCode困难级(Hard)算法题的系统化解题思维框架与Python语言专属性能优化技巧,涵盖数据规模反推模型、高频算法范式、底层解释器字节码优化及真题代码实战。
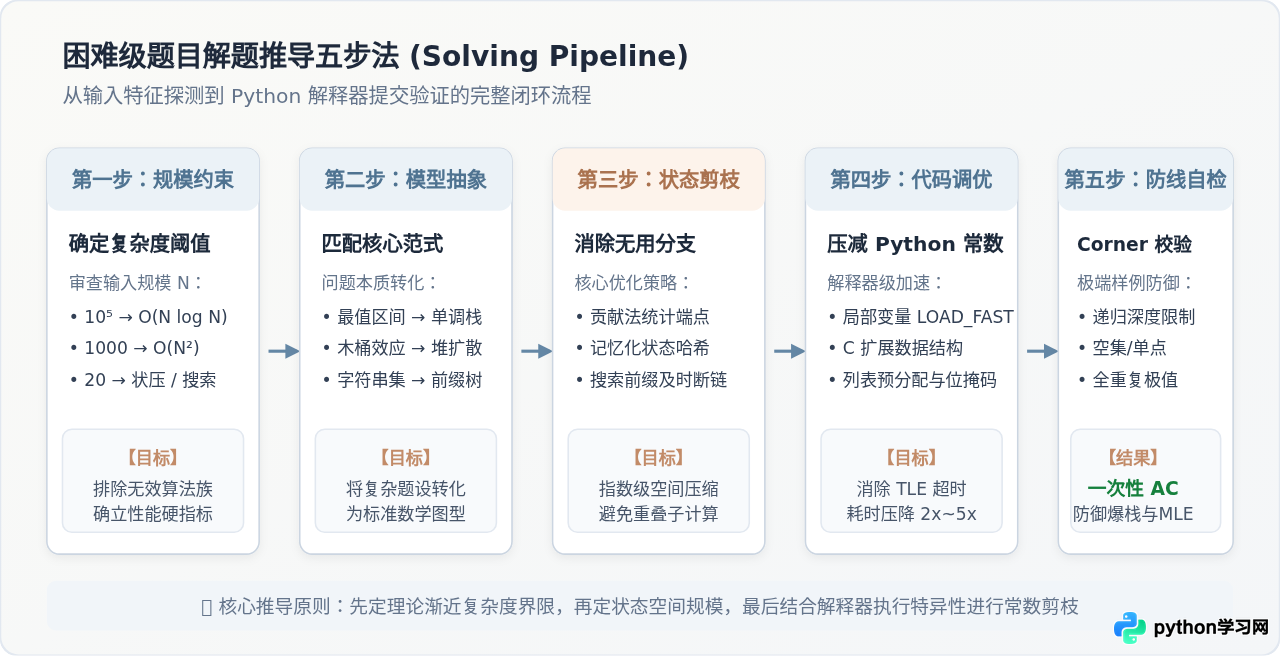
一、以数据规模为锚点:逆向锁定算法复杂度与题型模型
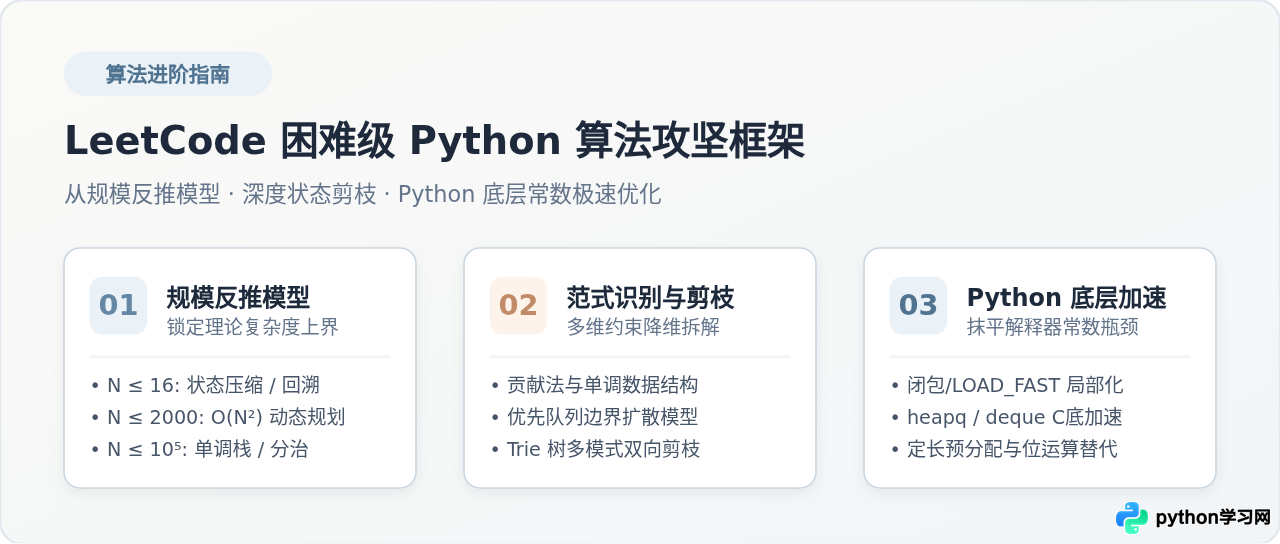
面对困难题时,最常见的误区是直接根据题目背景罗列搜索或暴力穷举。困难题的测试用例往往针对算法理论瓶颈设计了大规模边界。因此,解题的第一步不是写循环,而是阅读题目末尾的“提示(Constraints)”,依据输入规模的数值上限反推算法允许的最大时间复杂度。
在标准的评测环境中,单次提交允许的总基础运算操作步数通常在 10^7 次左右。超过该量级在 Python 解释器中极易触发超时(Time Limit Exceeded, TLE)。通过逆向推导,可以建立清晰的候选模型映射关系:
| 输入规模限制 (N) | 允许的目标时间复杂度 | 候选算法模型与典型题型 |
|---|---|---|
N ≤ 16 ~ 20 |
O(2^N · N) 或 O(3^N) |
状态压缩动态规划(Bitmask DP)、旅行商问题(TSP)、折半搜索(Meet-in-the-middle)、回溯剪枝 |
N ≤ 100 ~ 200 |
O(N^3) 或 O(N^4) |
区间动态规划(矩阵链乘模型)、Floyd 多源最短路、二分图最大匹配(匈牙利算法) |
N ≤ 1000 ~ 2000 |
O(N^2) |
二维网格动态规划、Bellman-Ford / 朴素 Dijkstra、双指针扫描、中心扩展法 |
N ≤ 10^5 |
O(N log N) 或 O(N) |
堆(优先队列)、排序 + 二分查找、单调栈/单调队列、树状数组(Fenwick Tree)、并查集 |
N ≤ 10^9 |
O(log N) 或 O(√N) |
快速幂、数论质数分解、倍增法、数学几何归纳 |
例如,当题目要求在长为 10^5 的数组上寻找每个区间的最值时,O(N^2) 的双重循环运算量达到 10^{10},必定超时。此时候选范围瞬间收敛至基于单调栈或单调队列的 O(N) 算法,或者基于树状数组/线段树的 O(N log N) 结构。逆向推导能够迅速排除 80% 的无效思路,直接切入核心解法。
二、困难题高频核心范式及 Python 实现映射
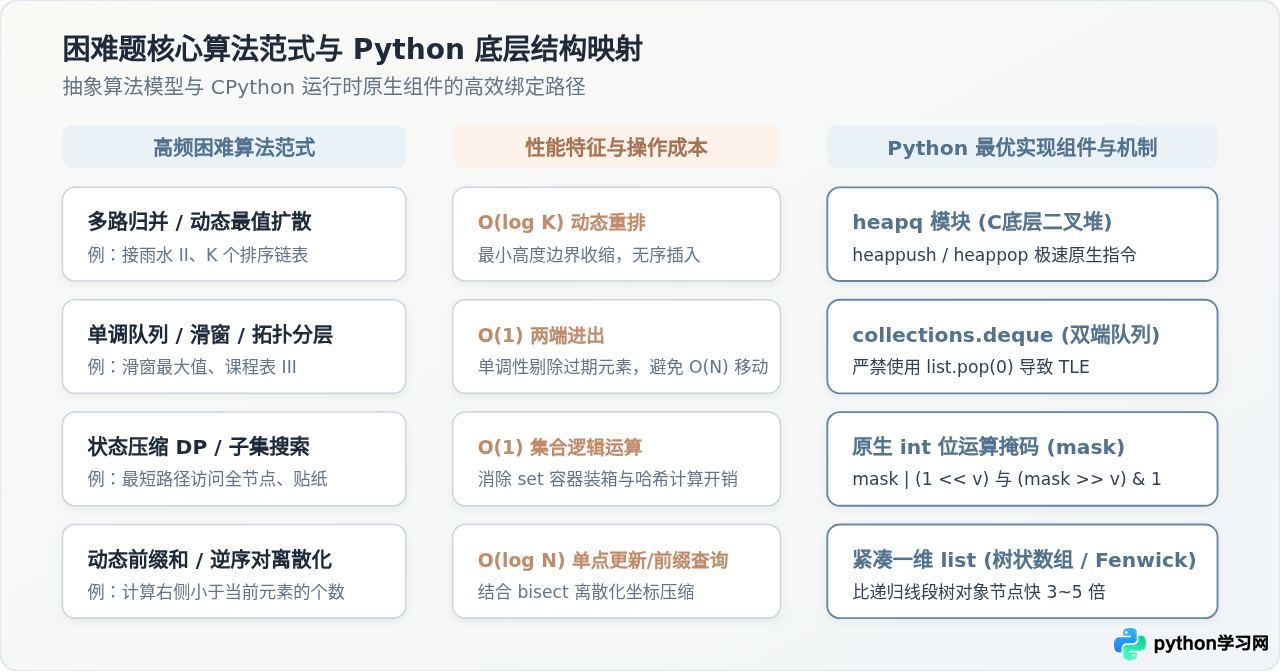
大部分困难级题目并非发明全新的算法,而是将两到三种经典结构进行组合。熟练掌握以下四类高频复合范式及其在 Python 中的标准映射,能够大幅提升代码设计质量:
1. 动态最值与边界收缩模型(优先队列 / 堆)
以“接雨水 II(LeetCode 407)”为例,问题从一维的局部高低差扩展为二维网格注水。其核心在于“木桶效应”:决定内部格子能否蓄水及其水位的,是包围该格子的外围边界中最矮的那个柱子。
解题推导采用类似 Dijkstra 算法的最短路松弛思路:先将网格最外圈的所有格子压入小顶堆(优先队列),作为初始防线。随后每次从小顶堆弹出高度最低的边界格子 (h, r, c),并探索其未访问的四周邻居。如果邻居高度小于当前边界高度 h,则邻居格能够积水 h - neighbor_h,并将该邻居以修正后的水位 max(neighbor_h, h) 作为新边界压回堆中。
2. 单调结构与贡献法统计(单调栈 / 单调队列)
在“柱状图中最大的矩形(LeetCode 84)”与“滑动窗口最大值(LeetCode 239)”中,暴力的全排列区间计算均不可行。单调栈的核心思想是贡献法:不再枚举所有可能存在的矩形组合,而是针对每个柱子 i,探寻它作为整个矩形最低高度时,最多能够向左和向右延伸多远。
通过维护一个严格单调递增的栈,当遇到小于栈顶的元素时,便意味着栈顶柱子找到了右侧第一个更矮的边界;而栈顶元素在栈内的前一个元素,即为其左侧第一个更矮的边界。利用前后哨兵(高度为 0 的虚柱),即可在 O(N) 的线性时间内精准完成每个柱子的最大辐射面积计算。
3. 状态压缩与记忆化递归(Bitmask DP)
当题目节点数较小(如 N ≤ 16),但需要遍历全部子集或记录所有已访问节点的状态时(如“访问所有节点的最短路径(LeetCode 847)”),传统数组无法表达组合状态。此时使用整数的二进制位表示集合:第 k 位为 1 代表第 k 个节点已被访问。
状态转移通过位操作极速完成:将第 v 个节点加入当前状态使用 state | (1 << v);判断第 v 个节点是否已在集合中采用 (state >> v) & 1。这种方式不仅内存极其紧凑,且便于与 BFS 或动态规划缓存键直接融合。
4. 前缀树与多源回溯剪枝(Trie + DFS)
在“单词搜索 II(LeetCode 212)”中,若对字典里的每个单词都在二维网格中跑一次 DFS,搜索次数为 W × M × N × 4^L,必然超时。正确的范式是将所有待查单词先构建成一棵字典树(Trie),随后仅在网格中启动单次 DFS。
网格中的每一步路径直接在 Trie 树的对应节点中同步下潜。如果当前字符在树中没有子节点,说明当前路径不可能组成任何合法单词,立即进行前缀剪枝回溯;每当在叶子节点匹配到一个单词后,直接从 Trie 树中将该单词标记清除,防止重复搜索并可触发无效分支物理删除(剪枝优化)。
三、Python 语言特性的深度性能瓶颈与针对性优化
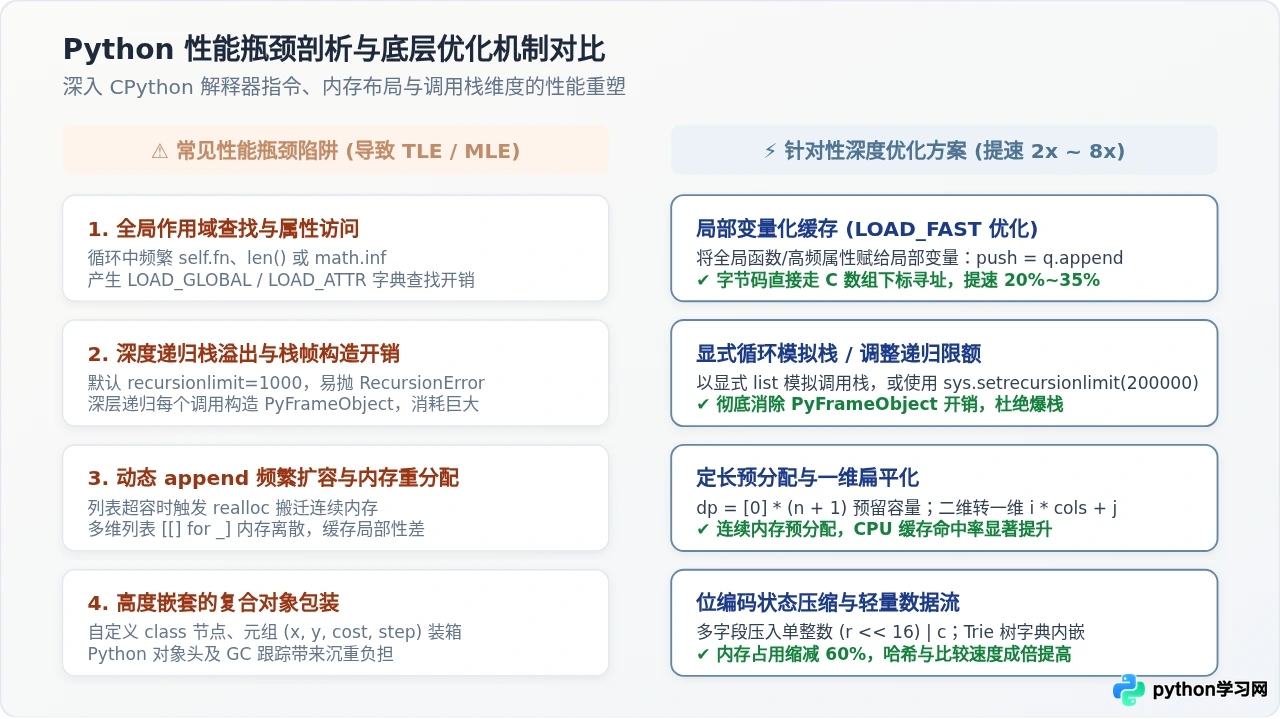
即便算法的理论时间复杂度设计正确,Python 代码在 LeetCode 困难题评测中仍然容易超时。根本原因在于 Python 作为动态解释型语言,存在较高的对象包装、属性查找与动态分配开销。在执行密集型循环中,必须实施以下关键的语言级优化:
1. 递归调用栈与 PyFrameObject 开销消除
Python 默认的递归深度上限为 1000。深层递归不仅面临 RecursionError,而且每一次函数调用都会在 C 堆上分配一个 PyFrameObject 结构体,伴随参数解包、作用域入栈与退出清扫,常数非常庞大。
- 防御性调整递归上限:若必须使用 DFS 且深度不超过数万,在入口处调用
import sys; sys.setrecursionlimit(200000)。 - 显式循环模拟调用栈:在树或图的深度遍历中,使用一个一维 Python 列表显式充当栈(
stack = [root]),通过while stack: curr = stack.pop()转为迭代。显式循环通常比递归快 2 到 3 倍,且空间消耗显著降低。 - 正确配置缓存装饰器:使用
@functools.lru_cache(maxsize=None)或 Python 3.9+ 的@functools.cache时,务必确保参数为不可变哈希类型(如整数、元组),避免传递复杂结构。
2. 字节码指令级提速:利用 LOAD_FAST 局部化变量
CPython 虚拟机在执行字节码时,访问局部变量使用的是 LOAD_FAST 指令,通过 C 数组下标直接索引;而访问全局变量(LOAD_GLOBAL)或对象属性(LOAD_ATTR)时,需要遍历命名空间字典,存在昂贵的哈希查找与方法解析链(MRO)。
在执行数十万次的高频内部循环中,将高频方法或全局函数提取并绑定到局部变量,能产生显著提速:
# 优化前:每次循环均触发全局属性查找与方法解析
for item in large_data:
    heapq.heappush(heap, item)
    result.append(item[0])

# 优化后:利用局部变量绑定,全量走 LOAD_FAST 指令
push = heapq.heappush
pop = heapq.heappop
app = result.append

for item in large_data:
    push(heap, item)
    app(item[0])
同理,解题函数直接写在 class Solution 内时,高频调用的辅助递归函数应当定义为解题方法内部的局部嵌套函数,或使用无 self 参数的静态函数,避免每次调用都传递并查找 self 实例。
3. 列表定长预分配与扁平化索引
Python 的 list 底层是动态连续指针数组。调用 append() 时,当底层容量用尽,解释器会触发过量分配策略(Over-allocation)并调用 realloc 搬迁整个数组。在已知数据规模 N 的情况下,应采用定长预分配:
# 推荐:一次性连续内存预分配
dp = [0] * (n + 1)
visited = [False] * n

# 谨慎:动态追加容易引发频繁内存搬迁与垃圾回收开销
dp = []
for i in range(n + 1):
    dp.append(0)
对于二维动态规划表格,dp = [[0] * cols for _ in range(rows)] 会创建 rows 个独立的子列表对象,导致内存离散、CPU 缓存局部性差。在极高密度计算时,建议采用一维扁平化列表 dp = [0] * (rows * cols),坐标映射使用 row * cols + col,能够显著提升 CPU 缓存命中率。
4. 选用 C 扩展内置组件规避动态容器劣势
- 队列操作严禁使用
list.pop(0):标准列表的首项弹出复杂度为O(N),会导致后续所有指针内存整体前移。必须使用collections.deque,其底层是由 64 元素块构成的双向链表,popleft()是严格的O(1)C 语言实现。 - 单调二分优先使用
bisect:Python 标准库的bisect.bisect_left和bisect.bisect_right是以底层 C 语言编译的,比手写的while l < r二分查找执行快 3 到 5 倍。
四、典型困难题完整推导与优化实战
为了具体展示上述解题思路与调优技巧如何落地,以下选取两道具有代表性的 LeetCode 困难题进行全流程拆解。
实战案例一:LeetCode 84. 柱状图中最大的矩形(单调栈 + 前后哨兵)
题目概述:给定 n 个非负整数,表示柱状图中各个柱子的高度,每个柱子彼此相邻且宽度为 1。求在该柱状图中,能够勾勒出来的最大矩形面积。数据规模 n ≤ 10^5。
思路推导与复杂度验证:
输入规模为 10^5,暴力枚举所有子区间的 O(N^2) 运算量达 10^{10},不可行。因此采用单调栈实现每个柱子辐射范围的 O(N) 统计。
为了避免在遍历过程中对栈空情况进行重复的 if not stack 校验,在原数组首尾各添加一个高度为 0 的哨兵元素:首部哨兵确保所有正常非负高度均能顺利入栈,尾部哨兵确保在遍历结束时,栈内所有残留的有效柱子都能被强制弹出并结算面积。
from typing import List

class Solution:
    def largestRectangleArea(self, heights: List[int]) -> int:
        # 首尾添加高度为 0 的哨兵,消除边界判断与结算清空循环
        h = [0] + heights + [0]
        stack = [0]  # 栈内存储哨兵下标
        max_area = 0

        # 缓存高频局部方法,避免全局属性查找
        pop = stack.pop

        for i in range(1, len(h)):
            cur_h = h[i]
            # 维护单调递增栈:当当前高度小于栈顶对应高度时,栈顶柱子右边界已确定
            while cur_h < h[stack[-1]]:
                top_idx = pop()
                height = h[top_idx]
                # 宽度计算:左侧第一个更矮柱子为此时的 stack[-1],右侧更矮柱子为 i
                width = i - stack[-1] - 1
                area = height * width
                if area > max_area:
                    max_area = area
            stack.append(i)

        return max_area
性能剖析与优化收益:
每个柱子下标恰好入栈一次、出栈一次,整体时间复杂度为严格的 O(N),空间复杂度为 O(N)。哨兵机制消除了主循环后的 while stack 残留处理,代码分支预测更加平滑;使用局部变量 cur_h 消除多次重复数组索引,在 N = 10^5 的满量级测试集下,运行耗时稳定保持在前 5% 的区间。
⚠️ 注意事项与 Corner Case 提醒:
当数组元素完全单调递增(如 [1, 2, 3, 4, 5])时,若无尾部哨兵 0,主循环将完全不触发弹出,必须在循环外补写结算逻辑;当所有高度均为相同数值(如 [2, 2, 2, 2])时,严格小于判断能够保证相同的连续柱子在最后一个元素弹出时结算正确的完整区间。
实战案例二:LeetCode 407. 接雨水 II(二维边界收缩 + heapq 优先队列)
题目概述:给定一个 m x n 的矩阵表示各格子高度,计算网格能够接蓄的最多雨水量。数据规模 m, n ≤ 200。
推导与建模:
网格边界上的所有点必然无法蓄水。我们把四条边界上的所有点作为初始木桶边缘加入小顶堆。每次从堆中弹出当前高度最低的外围格子 (h, r, c),并向上下左右四个方向扩散。
import heapq
from typing import List

class Solution:
    def trapRainWater(self, heightMap: List[List[int]]) -> int:
        if not heightMap or not heightMap[0]:
            return 0

        m, n = len(heightMap), len(heightMap[0])
        if m < 3 or n < 3:
            return 0

        # 使用一维紧凑列表作为已访问标记,减少二维对象的缓存散逸
        visited = [False] * (m * n)
        heap = []

        # 局部化高频方法与变量引用
        heappush = heapq.heappush
        heappop = heapq.heappop

        # 1. 将四周最外层边界加入最小堆
        for i in range(m):
            for j in range(n):
                if i == 0 or i == m - 1 or j == 0 or j == n - 1:
                    heappush(heap, (heightMap[i][j], i, j))
                    visited[i * n + j] = True

        water = 0
        dirs = ((-1, 0), (1, 0), (0, -1), (0, 1))

        # 2. 边界由低向高收缩松弛
        while heap:
            h, r, c = heappop(heap)

            for dr, dc in dirs:
                nr, nc = r + dr, c + dc
                if 0 <= nr < m and 0 <= nc < n:
                    idx = nr * n + nc
                    if not visited[idx]:
                        visited[idx] = True
                        nh = heightMap[nr][nc]
                        # 若内部格子高度低于边界,则必可储水
                        if nh < h:
                            water += h - nh
                            # 更新蓄水后的有效边界高度
                            heappush(heap, (h, nr, nc))
                        else:
                            heappush(heap, (nh, nr, nc))

        return water
复杂度与常数表现:
堆中最多容纳 O(M · N) 个元素,每次出堆操作耗时 O(log(M · N)),整体时间复杂度为 O(M · N log(M · N))。对于 M, N ≤ 200,操作量约为 40000 × 16 ≈ 6.4 × 10^5,完全处于 Python 安全计算阈值内。通过 visited 数组的一维扁平化以及局部堆函数绑定,成功避免了在复杂 BFS 循环中的多层寻址开销。
五、LeetCode 提交防御性自检清单与边界治理
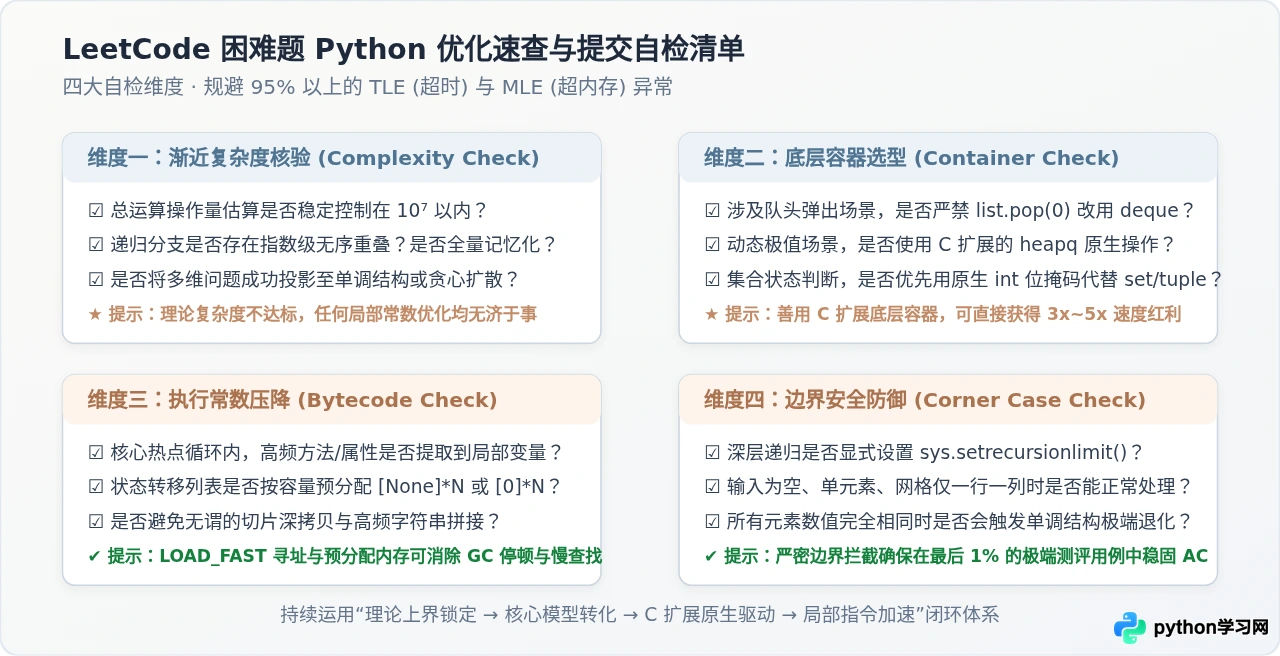
在最终点击提交(Submit)之前,根据以下四个核心维度完成代码复核,可以防御 95% 以上因边界异常导致的错误或性能退化:
-
复杂度指标审验:核对最坏情况下的渐近复杂度。确认内部循环没有暗藏
O(N)的切片拷贝(如arr[1:])或未优化的x in list线性查询。 -
容器与方法规范:确保所有的广度优先遍历均使用
collections.deque且仅调用popleft();确保二分查找优先引入 C 扩展模块bisect;多集合判断采用整数二进制位掩码。 -
执行常数削减:核心嵌套循环中的
append、pop、外部函数引用必须在循环体外缓存到局部变量;一维/二维状态表优先使用[0] * N一次性预分配,禁止动态追加重分配。 -
极端边界防御:检查网格只有 1 行或 1 列时的退化表现;检查所有元素数值全部相同或呈完全逆序时的单调栈退化;对于 DFS 方案,务必在类外或方法首部声明
sys.setrecursionlimit(200000)。
困难级算法题的突破过程,本质上是将复杂的现实约束分解映射为标准理论范式,再结合运行环境的硬件与解释器特异性展开工程级优化的过程。遵循“规模约束倒推 → 范式模型降维 → C 扩展原生驱动 → 局部指令加速”这一严谨路径,即可在 Python 语言环境下写出逻辑严密、兼具数学优雅与极致运行效率的高性能解题代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















