


Python负数索引在切片中的计算逻辑
深入解析Python负数索引在切片操作中的核心计算逻辑。通过双轨坐标转换公式、边界栅格模型、四步标准化推导流水线以及正逆向步长分支对比,彻底讲透切片越界钳夹与静默空切片的产生机制。
k + len(s))转化为非负绝对坐标,随后依据步长的正负方向执行边界钳夹(Clamping)和区间有效性判定。切片操作截取的并非离散的数据点,而是元素之间的“分界切口”,掌握这一公式与几何栅格模型,能够彻底消除“切片为何返回空列表”以及“逆向切片漏掉首个元素”的疑惑。
一、双轨坐标系与栅格切口模型
初学者容易把切片语法 s[start:stop] 中的两个数值理解为要提取的起始元素与结束元素的位置。但在 Python 中,切片遵循数学上的“左闭右开”区间 [start, stop),更严谨的工程理解方式是栅格切口模型(Fencepost Model)。
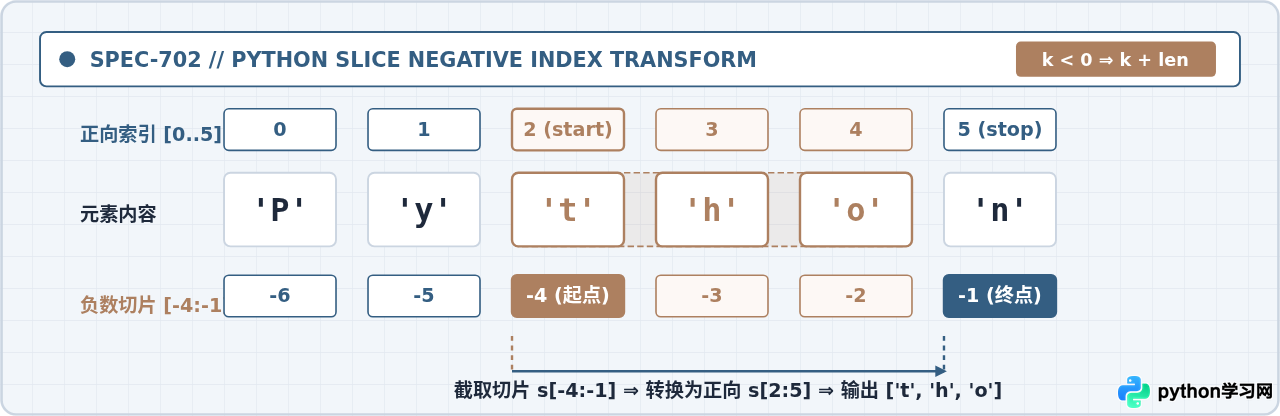
对于长度为 N 的序列,正向索引从 0 到 N-1,负向索引从 -N 到 -1。负数索引的物理含义是“从序列末尾向前倒数的偏移量”。在底层,负数索引到正数坐标的数学换算关系为:
index < 0 时,换算坐标为 index + len(s)。
例如,对于长度为 6 的序列 s = ['A', 'B', 'C', 'D', 'E', 'F'],最后一个元素 'F' 的正向索引为 5,负向索引为 -1,由公式计算 -1 + 6 = 5;倒数第四个元素 'C' 的负向索引为 -4,计算得 -4 + 6 = 2。
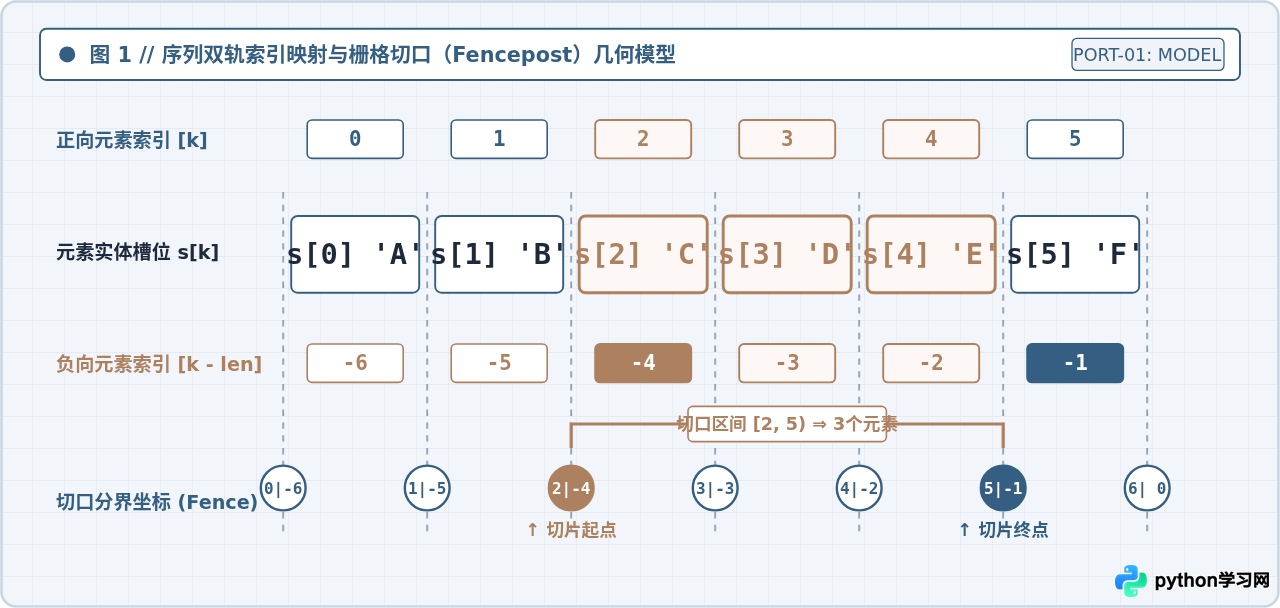
如上图所示,切口(Fencepost)是落在元素之间的边界线。一个长度为 6 的列表拥有 7 条切口线(标号 0 到 6)。切片 s[-4:-1] 在经过负数换算后,对应的就是切口 2 与切口 5 之间的区域。该区域包含索引为 2、3、4 的三个元素,即 ['C', 'D', 'E']。因为切口 5 是终点右边界,元素 5(即 'F')自然被排除在区间之外,这正是“左闭右开”在几何切口上的体现。
代码验证:正负切片等价性
# 环境:Python 3.8+
# 测试正向索引与负向索引切片的等价性
s = ['A', 'B', 'C', 'D', 'E', 'F']

# 提取中间子序列
result_negative = s[-4:-1]
result_positive = s[2:5]

print("s[-4:-1] 提取结果:", result_negative)
print("s[2:5]   提取结果:", result_positive)
print("两者是否等价:", result_negative == result_positive)二、负数切片的四步标准化推导流水线
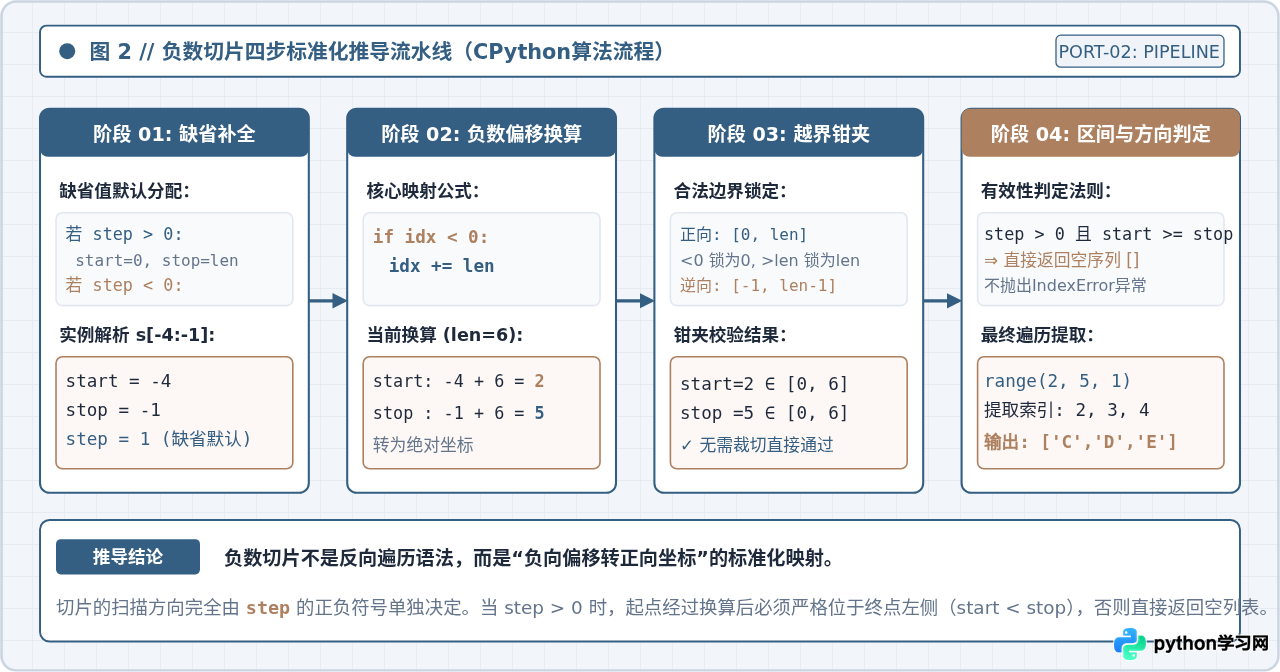
当我们在代码中书写 s[start:stop:step] 时,Python 解释器底层(CPython 实现中的 PySlice_GetIndicesEx)并非直接根据输入参数做简单的循环,而是经过一套严格的四阶段流水线进行规范化处理:
- 阶段 01:缺省值补全(Default Filling)
若step未指定,默认为1;当step > 0时,缺省的start补为0,缺省的stop补为len(s)。当step < 0时,缺省的start补为len(s) - 1,缺省的stop补为特殊标记-1。 - 阶段 02:负数偏移换算(Offset Translation)
对start和stop分别检查:若值小于 0,则执行idx += len(s)。 - 阶段 03:越界边界钳夹(Clamping)
即使索引严重超出序列范围,切片也绝不会抛出IndexError。正步长下,小于 0 的值被钳夹(截断)为0,大于len(s)的值被钳夹为len(s)。 - 阶段 04:区间有效性与方向判定(Direction & Span Check)
根据步长方向判断跨度有效性。当step > 0且start >= stop时,或者当step < 0且start <= stop时,有效跨度为 0,解释器直接生成空列表[]。
实例推导:极端负数索引的钳夹表现
以 s = [10, 20, 30](长度为 3)执行 s[-10:2] 为例,我们按照四步流水线推导:
- 步骤 1: 输入
start = -10,stop = 2,step = 1。 - 步骤 2:
start < 0,执行-10 + 3 = -7。 - 步骤 3: 换算后
-7依然小于 0,触发边界钳夹,start被锁定为0;stop = 2在[0, 3]之间,保持2。 - 步骤 4:
start(0) < stop(2)且step > 0,生成切片区间[0, 2),提取索引 0 和 1 的元素。
# 极端负数越界切片测试
nums = [10, 20, 30]
print("极端负数索引切片 nums[-10:2]:", nums[-10:2])三、正向步长与逆向步长的计算分支对比
许多开发者在遇到空切片或者逆向切片截断时感到困惑,其根本原因在于混淆了索引的正负与步长的正负。请牢记:切片的前进方向仅由 step 的正负号决定,与 start 和 stop 是正数还是负数完全无关。
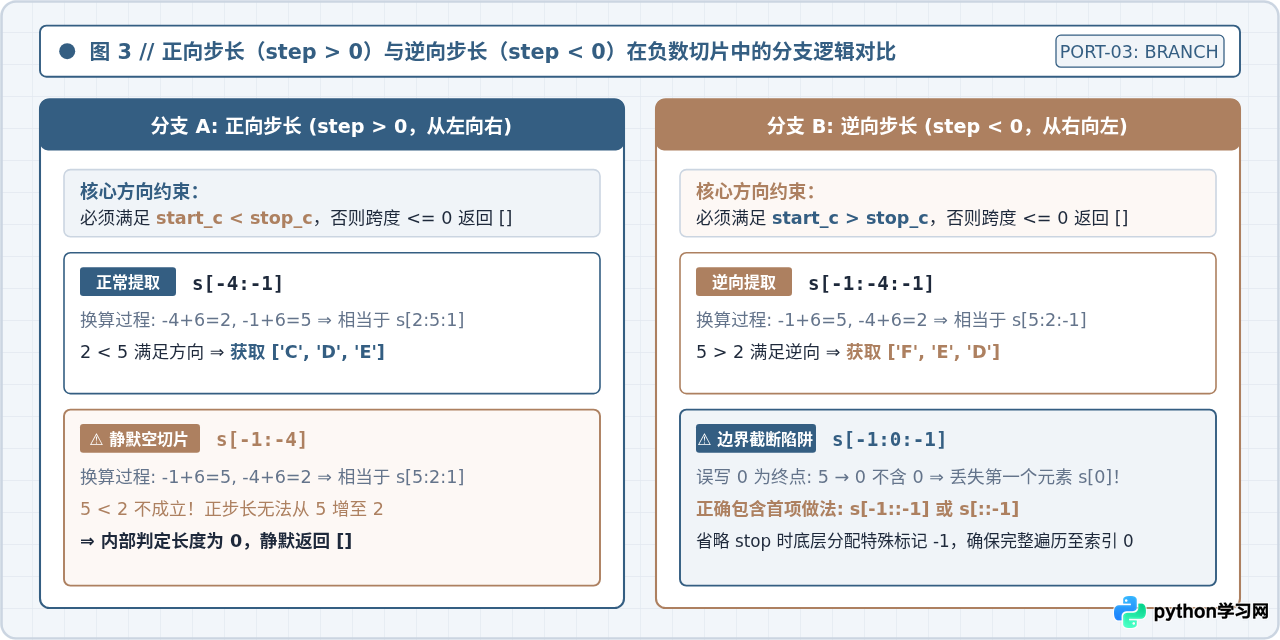
1. 静默空切片陷阱:s[-1:-4] 为什么返回 []?
在序列 s = ['A', 'B', 'C', 'D', 'E', 'F'] 中,有人试图通过 s[-1:-4] 获取末尾往前数的几个元素。但这行代码省略了 step,此时默认 step = 1(正向从左往右遍历)。
根据标准化公式:
start = -1 + 6 = 5stop = -4 + 6 = 2
此时切片被等价转换为 s[5:2:1]。从索引 5 出发,以步长 +1 递增,永远无法到达较小的终点 2。由于 start >= stop 违反了正向步长的方向约束,Python 内部判定元素个数为 0,直接静默返回空列表 [],不报任何错误。
2. 逆向切片的零界点陷阱:为什么不能写 s[-1:0:-1]?
如果希望从末尾逆向切片到第一个元素,直觉上容易写成 s[-1:0:-1]。但在 Python 切片的左闭右开规则中,stop 位置的元素是不被包含的。
在 s[-1:0:-1] 中,stop = 0 表示遍历在到达索引 0 之前停止,因此索引为 0 的第一个元素(如 'A')被排除在外。若要完整切片到开头,必须省略 stop 参数或传入 None,即写作 s[-1::-1] 或 s[::-1]。此时底层会将 stop 标记为一个虚拟边界,确保索引 0 能够被成功提取。
# 步长正负与方向冲突对比
items = ['A', 'B', 'C', 'D', 'E', 'F']

# 案例 A:正向步长但起点在终点右侧 -> 返回空列表
print("s[-1:-4] 结果:", items[-1:-4])

# 案例 B:逆向步长配合负数索引 -> 正确倒序提取
print("s[-1:-4:-1] 结果:", items[-1:-4:-1])

# 案例 C:误写 stop=0 导致丢失第一个元素
print("s[-1:0:-1] 结果 (丢失首项):", items[-1:0:-1])

# 案例 D:省略 stop 正确包含首项
print("s[-1::-1] 结果 (完整倒序):", items[-1::-1])四、官方内置验证工具:slice.indices(length)
为了让开发者和扩展模块作者准确模拟和验证切片的计算过程,Python 的内置类型 slice 提供了一个标准方法:slice.indices(length)。它直接向外部暴露了 CPython 内部的规范化算法。
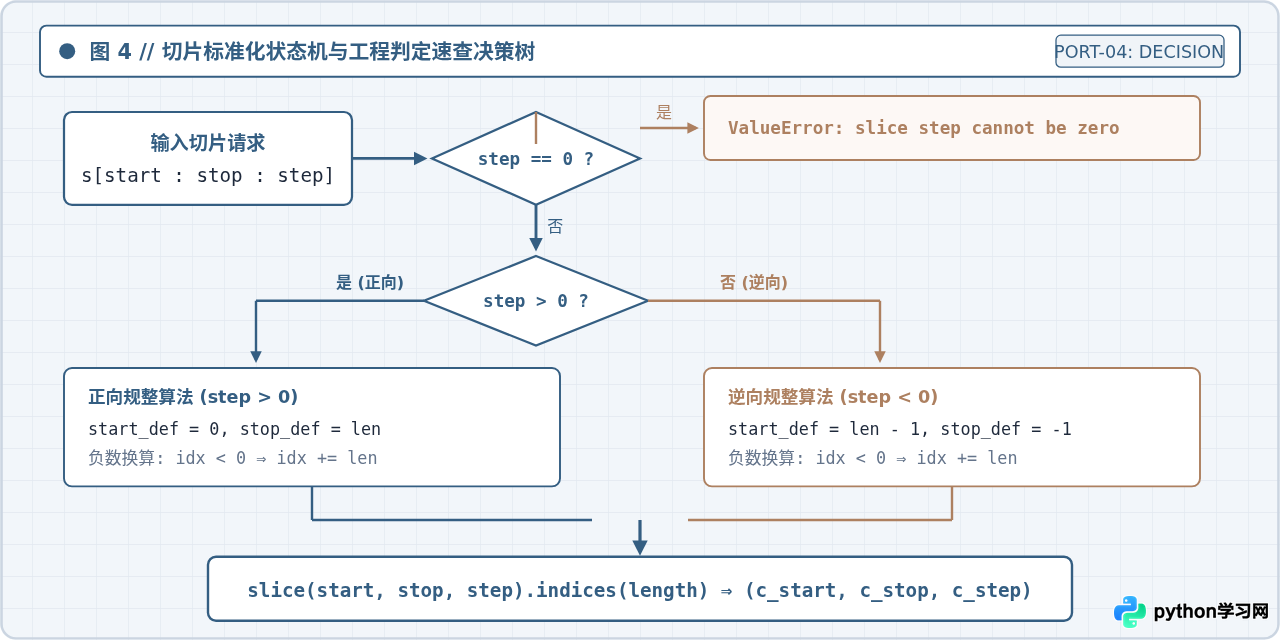
该方法接收序列的实际长度 length,返回一个三元组 (start, stop, step)。返回的三元组具有三个确定性保证:
- 所有索引全部转换为符合方向的非负有效区间(逆向终止时为 -1);
- 所有越界值均已完成钳夹收敛;
- 可以直接传入 Python 原生
range(*slice_obj.indices(len(s)))进行迭代。
# 使用 slice.indices() 观察内部计算逻辑
length = 6

test_cases = [
    slice(-4, -1, None),   # s[-4:-1]
    slice(-1, -4, None),   # s[-1:-4](方向冲突)
    slice(-1, -4, -1),     # s[-1:-4:-1]
    slice(-1, None, -1),   # s[-1::-1]
    slice(-10, 10, 1)      # 两端大幅越界
]

print(f"{'切片语法':<18} | {'转换后三元组 (start, stop, step)':<32} | {'对应range提取个数'}")
print("-" * 75)

for sl in test_cases:
    start_c, stop_c, step_c = sl.indices(length)
    indices_list = list(range(start_c, stop_c, step_c))
    syntax_repr = f"slice({sl.start}, {sl.stop}, {sl.step})"
print(f"{syntax_repr:<18} | ({start_c:>2}, {stop_c:>2}, {step_c:>2}) | {len(indices_list)} 个元素 -> {indices_list}")五、工程实践总结与速查清单
为了在工程开发中编写清晰、健壮的序列截取代码,建议遵循以下判断与编写规范:
| 需求场景 | 标准切片写法 | 底层换算等价式(len=N) | 避坑要点 |
|---|---|---|---|
| 截取末尾 K 个元素 | s[-K:] |
s[N-K : N : 1] |
省略 stop,不要写 s[-K:-1],否则会漏掉最后一个元素。 |
| 剔除末尾 K 个元素 | s[:-K] |
s[0 : N-K : 1] |
当 K >= N 时,换算后 stop <= 0,安全返回 []。 |
| 从倒数第 A 个到倒数第 B 个(正向) | s[-A:-B](须 A > B) |
s[N-A : N-B : 1] |
因为是正向步长,必须保证 -A < -B(即 A > B),否则静默返回空。 |
| 序列完整反转 | s[::-1] |
s[N-1 : -1 : -1] |
最简写法,底层自动覆盖 [N-1, 0] 的完整倒序闭区间。 |
| 倒序截取末尾 K 个元素 | s[:-K-1:-1] 或 s[-1:-K-1:-1] |
s[N-1 : N-K-1 : -1] |
逆向步长要求 start > stop,计算边界时务必借助 slice.indices 验证。 |
s[-2:-7:-2])可读性较差,极易引起维护者的理解偏差。若逻辑较为复杂,推荐先反转序列或命名有意义的切片对象(如 TAIL_WINDOW = slice(-5, None)),以提升代码的自解释性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















