


企业级开发选Java还是Python?后端性能与生态成熟度对比
深入对比Java与Python在企业级后端开发中的真实表现:从底层并发与JIT性能机理,到Spring与FastAPI/Django框架生态、分布式事务、APM可观测性及工程治理。提供明确的选型决策树与实战场景建议。
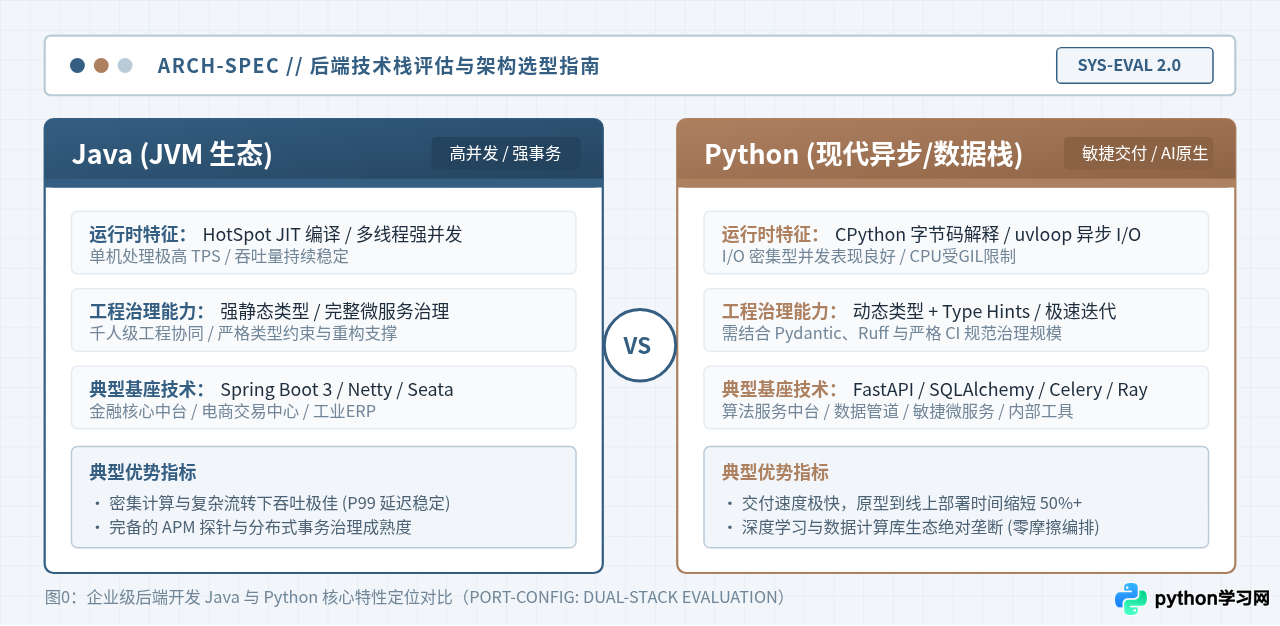
缩略图:Java 与 Python 在企业级后端场景中的核心定位与关键指标速览
一、后端选型决策路径:四步推导法则
面对复杂的企业业务,避免盲目按照“团队谁更熟悉”或“技术是否流行”做单一维度的拍板。企业级架构选型应当从业务指标输入出发,经历四个明确的逻辑推导步骤:
- 指标边界量化:明确系统的单机并发峰值(QPS/TPS 目标是否超过 5,000)、分布式事务是否要求强一致性,以及允许的故障恢复窗口。
- 组织与治理规模评估:评估当前与未来两年参与维护同一套代码库的研发人员基数。如果是跨多地协同的大规模团队,强类型与严格的编译期检查将大幅降低协作沟通损耗。
- 算法与数据资产依赖:判断业务流程是否重度嵌入数据挖掘、深度学习推理或大语言模型(LLM)的编排调度。
- 架构演进路线判定:确定是采用“单栈一统”,还是采用目前业界主流的“核心交易走 Java,智能分析走 Python”的双栈协同模式。
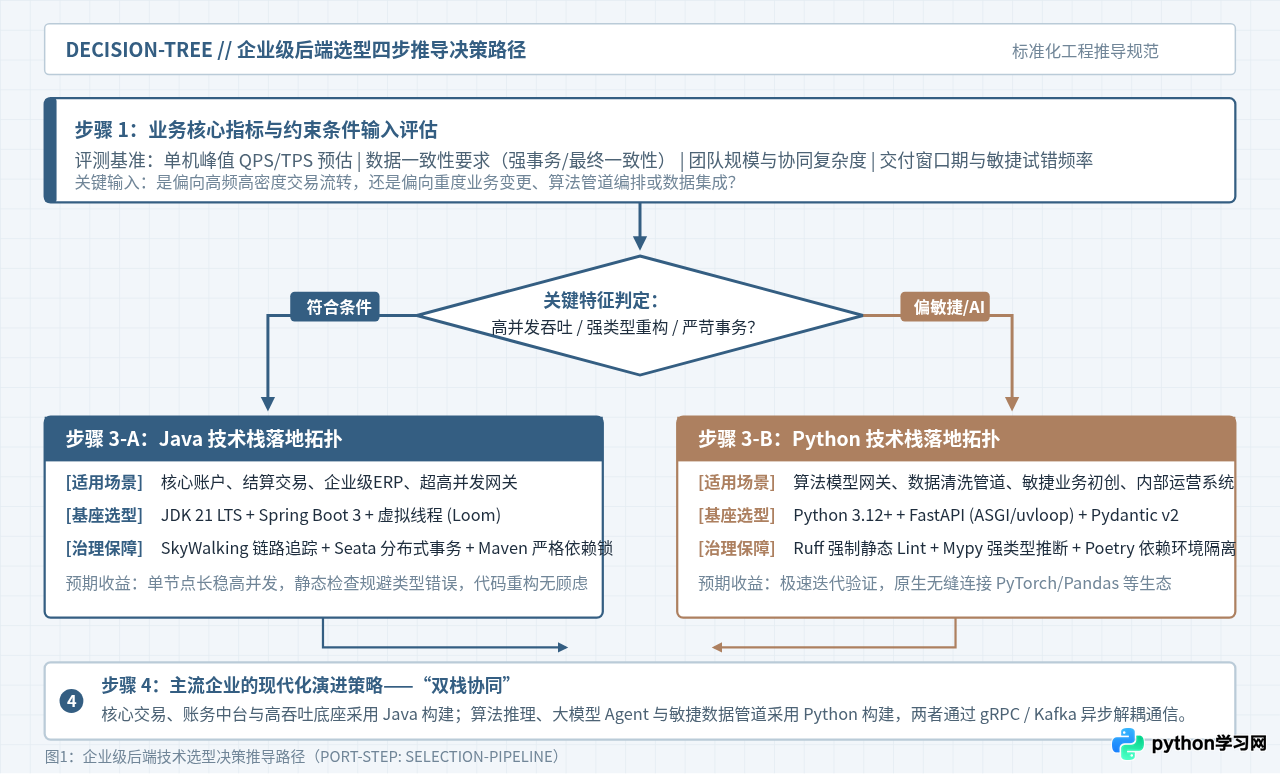
图1:企业级后端开发技术选型四步推导决策路径图
在上述决策路径中,当业务落在“核心中台”分支时,系统的生命周期通常长达 5~10 年,代码需要经历数轮交接与重构,此时 Java 带来的类型约束和接口强制规范展现出显著优势;当业务落在“创新验证”或“AI应用”分支时,时间就是生命线,Python 声明式编写与动态组合能让产品在两周内完成线上闭环。
二、底层并发机制与运行时性能深度剖析
很多开发者只知道“Java 运行快、Python 运行慢”,但要进行严肃的企业级架构设计,必须理解两者产生性能差异的底层计算机体系结构机理。
1. JIT 编译与本地机器码执行
Java 采用 HotSpot JVM 虚拟机运行。源代码编译为 .class 字节码后,JVM 在运行期通过分层编译(C1 即时编译器 + C2 高度优化编译器)对执行频繁的“热点代码”进行逃逸分析、方法内联和循环展开,最终将其编译为宿主机 CPU 的原生机器码直接在硬件上执行。因此,当系统预热完成后,纯粹的业务计算、协议解析与数据流转开销极低。
标准 Python(CPython)则是纯正的解释执行模型。.py 脚本被翻译为字节码后,由 C 语言实现的 ceval.c 主循环逐条读取解释。虽然 Python 3.11/3.12 引入了专有化自适应解释器(Specializing Adaptive Interpreter),在局部执行路径上有明显提速,但面对高强度的紧密计算循环与密集对象实例化时,与 JIT 编译生成的本地机器码相比仍有 5 到 15 倍的算力差距。
2. 多线程并行模型与全局解释器锁(GIL)
这是决定后端高并发吞吐架构的最关键分野:
- Java 的线程体系:Java 线程天然是一对一映射到操作系统的原生内核线程,能够充分利用服务器的每一个物理 CPU 核心执行并行计算。同时,JDK 21 已经正式落地虚拟线程(Virtual Threads,Project Loom),将用户态协程以 M:N 方式挂载在载体线程上,单机可轻松承载上百万并发连接,在 I/O 阻塞时自动让出调度,彻底解决了传统线程池耗尽内存的问题。
- Python 的 GIL 限制:CPython 解释器内保留了全局解释器锁(Global Interpreter Lock),同一时刻仅允许一个系统线程执行 Python 字节码。即使服务器具备 64 个 CPU 核心,单个 Python 进程的计算任务也只能跑在单核上。为了吃满服务器资源,Python 后端必须采用 Gunicorn 或 Uvicorn 启动多 Worker 进程,每个 Worker 占用独立内存空间,无法像 Java 一样零成本共享海量堆内缓存。
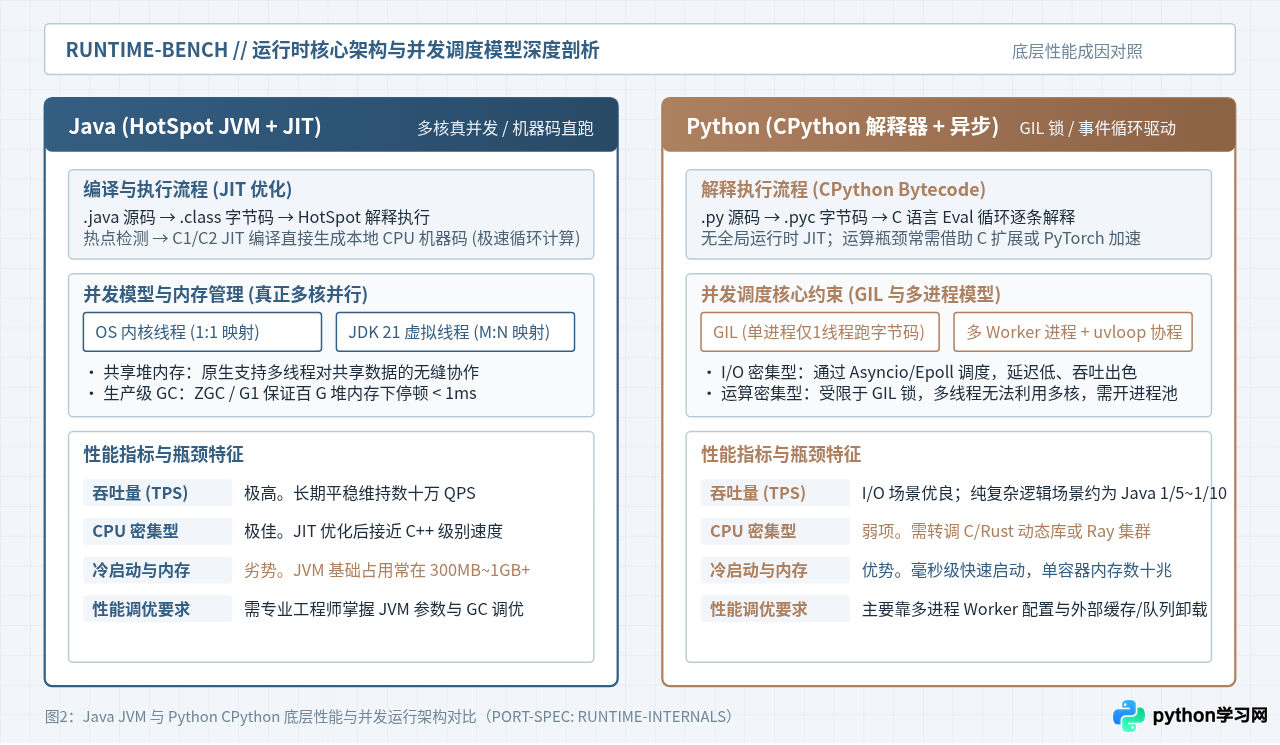
图2:Java JVM 与 Python CPython 底层性能机理与并发模型剖析
asyncio + uvloop 的现代 Python 框架(如 FastAPI)能够实现出色的低延迟与数万 QPS。但在混合了重度加解密、动态规则脚本解析、海量数据排序过滤的复杂业务逻辑下,Python 的 CPU 占用率会迅速冲顶,而 Java 依然能凭借 JIT 保持稳定的低毛刺表现(P99 延迟优异)。
三、企业级生态成熟度与工程治理体系对比
“能够写出业务代码”与“能够长期治理企业级系统”是完全不同的层级。企业级后端开发高度依赖中间件生态的健壮度、监控工具的可观测性以及团队规模扩大时的防御性编程支撑。
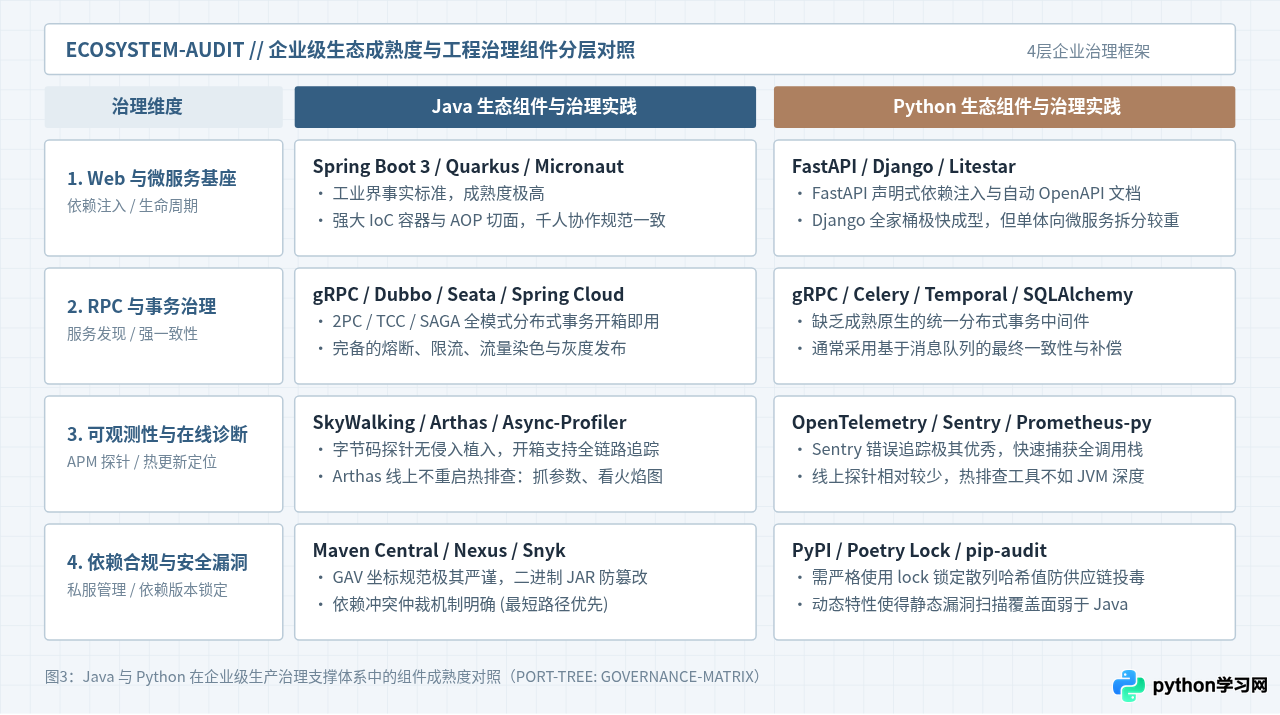
图3:Java 与 Python 在企业级生产治理支撑体系中的组件成熟度对照
1. 依赖管理与供应链安全治理
在 Java 体系中,Maven 与 Gradle 建立了严格的 GAV(GroupId:ArtifactId:Version)规范与中心化仓库索引。Maven 的二进制 JAR 包天然防篡改,配合清晰的依赖传递与仲裁机制(最短路径优先),在大规模工程中管理数千个子模块时稳定可靠。
Python 在早期因 pip 依赖解析松散而广受诟病,近年现代工具如 Poetry 和 uv 已经极大地改善了这一现状。但在企业安全红线审查中,PyPI 源曾多次发生依赖混淆和恶意包供应链攻击。在生产部署 Python 系统时,必须强制生成 poetry.lock,记录每个 Wheel 包的 SHA256 哈希值,并通过企业私有镜像仓库(如 Nexus 或 JFrog)进行严格的安全漏洞扫描。
2. 分布式事务与数据一致性支撑
金融、电商与政企系统中,跨微服务的分布式事务是难以回避的硬骨头。Java 拥有全行业最成熟的分布式事务协调解决方案,以阿里开源的 Seata 为代表,全面覆盖了 AT、TCC、SAGA 以及 XA 模式,与 Spring 生态无缝对接,只需添加注解即可完成两阶段提交与自动反向补偿日志生成。
Python 生态中鲜有同等级别的原生统一分布式事务框架。在 Python 后端架构中,处理跨库数据一致性通常依赖异步事件驱动架构(EDA):通过 Celery 或 Kafka 消息总线,由业务开发人员在应用层手工编写事务反向补偿代码(Saga 模式)或使用 Outbox 模式。这意味着架构师必须在应用层承担更多的一致性设计成本。
3. 线上可观测性与热点诊断(APM)
当线上生产环境发生偶发性慢查询、死锁或内存溢出时,排查工具的深度直接决定了故障恢复时间(MTTR):
- Java 诊断:Java 具备极其强大的 JVM TI(JVM Tool Interface)机制。类似 Apache SkyWalking 的探针通过字节码动态增强(Byte Buddy)无侵入地挂载到应用上,自动串联起全链路 Trace。此外,阿里巴巴开源的 Arthas 允许运维工程师在线连入容器,在不重启服务的前提下动态监控方法入参返回值、统计执行耗时,甚至反编译线上代码排查补丁生效状态。
- Python 诊断:Python 的动态追踪主要依赖 OpenTelemetry 探针与 Sentry。Sentry 对 Python 异常堆栈的捕获和现场变量还原堪称业界典范。但在运行态诊断方面,除了基本的系统级
py-spy采样分析外,很难做到像 JVM 那样深度的类加载器分析、堆内存精细对象引用链路排查。
四、典型生产场景实操对比与技术组合
为了帮助技术团队做出毫无争议的技术选型,以下给出四类最具代表性的企业业务场景,并列出推荐的技术栈落地方案与注意事项。
| 业务场景类别 | 核心特征与核心诉求 | 首选技术栈推荐 | 选型依据与架构落地要点 |
|---|---|---|---|
| 大型金融与电商交易核心 | 严苛强事务、高 TPS、不能出现数据脏读、长稳运行 | Java (Spring Boot 3 + MyBatis-Plus + Seata + Dubbo) | 利用 JVM 高度优化的内存模型与类型安全体系,消除运行期未知类型错误;完备的分布式事务中间件保障账务精确无误。 |
| AI 算法网关与 Agent 服务 | 密集调用 LLM、向量检索、数据预处理、快速实验 | Python (FastAPI + Pydantic v2 + Ray / Celery) | 无缝连接 PyTorch、HuggingFace、LangChain 等核心 AI 资产;异步 I/O 调度高延迟的大模型 Streaming 响应极其高效。 |
| 超高并发轻量接入网关 | 单机连接数万、极高吞吐、微秒级转发、低延迟要求 | Java (Netty / Spring Cloud Gateway) 或 Go | Netty 的零拷贝与堆外内存技术经过十余年海量高并发检验;Python 进程在此类高吞吐场景下硬件成本显著偏高。 |
| 企业内部管理后台与中台工具 | 需求变更频繁、业务字段繁多、预算与人月周期紧张 | Python (Django Ninja / FastAPI + Vue) | 开发效率高,利用自动 ORM 迁移与自动化 API 文档生成,可在数天内上线交付初版,极大降低前期研发投入。 |
代码级工程体验对比示例
以编写一个标准的企业级用户信息分页查询接口为例,观察两者的开发心智差异:
Python (FastAPI + Pydantic 风格示例):
from fastapi import FastAPI, Depends, Query
from pydantic import BaseModel, EmailStr
from typing import List

app = FastAPI(title="User Query Service")

class UserDTO(BaseModel):
    id: int
    username: str
    email: EmailStr
    department: str

@app.get("/api/v1/users", response_model=List[UserDTO])
async def list_users(
    page: int = Query(1, ge=1, description="页码"),
    size: int = Query(20, le=100, description="每页条数"),
    db_session = Depends(get_db)
):
    # 异步非阻塞查询,代码紧凑直观,入参校验和文档生成全自动化完成
    users = await db_session.query_users(offset=(page - 1) * size, limit=size)
    return users
Java (Spring Boot 3 风格示例):
@RestController
@RequestMapping("/api/v1/users")
@Validated
public class UserController {

    private final UserService userService;

    public UserController(UserService userService) {
        this.userService = userService;
    }

    @GetMapping
    public ResponseEntity<PageResult<UserDTO>> listUsers(
            @RequestParam(defaultValue = "1") @Min(1) Integer page,
            @RequestParam(defaultValue = "20") @Max(100) Integer size) {

        // 严格分层控制,编译期安全绑定,大型项目中便于切面安全拦截与统一错误兜底
        PageResult<UserDTO> result = userService.findUserPage(page, size);
        return ResponseEntity.ok(result);
    }
}
从代码层面可以看出:Python 的语法极其平实洗练,能够让开发者把绝大部分精力集中在业务本身;而 Java 呈现出高度规范的模块化分层,虽然初期编写略显繁琐,但通过接口解耦,极大地便利了数百个微服务团队统一制定日志、鉴权、限流切面(AOP)。
五、综合决策矩阵与全景总结
为了让企业决策者全面权衡投入产出比,下述评估卡对两者的核心生产维度进行了量化归纳,并给出了不容逾越的“技术选型红线”。
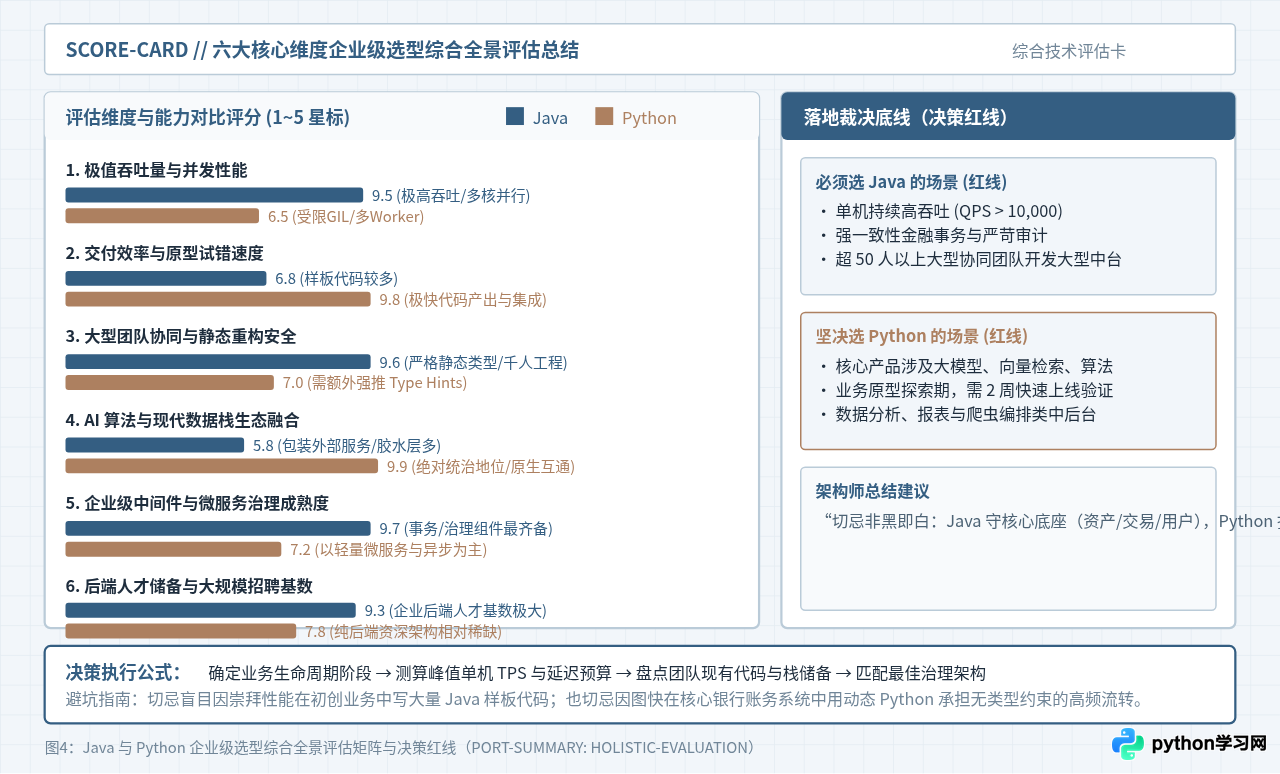
图4:Java 与 Python 企业级选型全景评估矩阵与决策红线
最终选型裁决总结
在当今现代企业软件架构中,追求“全公司只用一种语言”往往会带来巨大的工程折衷代价。最成熟的技术组织正在走向“双栈协同”:
- 将 Java 作为系统稳健运行的“压舱石”,部署在核心账务、权限控制、底层高吞吐数据流转与 ERP 枢纽中,利用其极致的单机吞吐、完善的分布式治理工具守住业务安全底线;
- 将 Python 作为业务创新与数据智能的“急先锋”,部署在算法网关、数据清洗流、大模型交互中枢与前沿微服务中,利用其丰富的算法库与闪电般的交付速度抢占市场先机。
两者通过标准的 gRPC 接口定义语言(Protobuf)建立跨语言的类型安全调用,以 Kafka 消息总线解耦异步数据流,从而让企业在享受 Python 敏捷红利的同时,牢牢拥有 Java 带来的生产级可靠底座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















