


Jupyter Notebook中怎么直接升级Python库而不重启内核
在Jupyter Notebook中直接升级Python库而不重启内核的完整实用指南。详解为什么pip升级后无法立即读取新模块,演示%pip与importlib.reload配合操作步骤,分析符号引用陷阱及C扩展库的重启边界。
%pip install --upgrade <包名> 将新版本正确写入当前内核绑定的 Python 环境,随后使用内置库 importlib.reload(模块对象) 或开启 %autoreload 机制刷新进程内的 sys.modules 模块缓存。掌握这种方法,可以在长时间运行模型训练、大数据清洗或复杂计算会话时,免去清除当前全局变量与中间状态的代价。
为什么直接 pip 升级后 Notebook 不会自动生效
很多开发者在 Notebook 单元格里执行了 !pip install -U package 并看到命令行提示安装成功,但紧接着在后续单元格调用新功能或打印版本号时,发现仍然是旧版本。这并不是 pip 没有升级成功,而是 Python 解释器的模块导入机制决定了这一现象。
Python 进程在首次执行 import <模块名> 时,会从物理磁盘的 site-packages 目录读取该库的源码,进行编译并创建一个模块对象,然后将其注册到全局字典 sys.modules 中。此后只要内核不关闭,任何单元格中再次执行 import <模块名>,Python 都会优先在 sys.modules 中命中缓存,直接返回内存中已经存在的对象指针,绝不会再次读取磁盘文件。
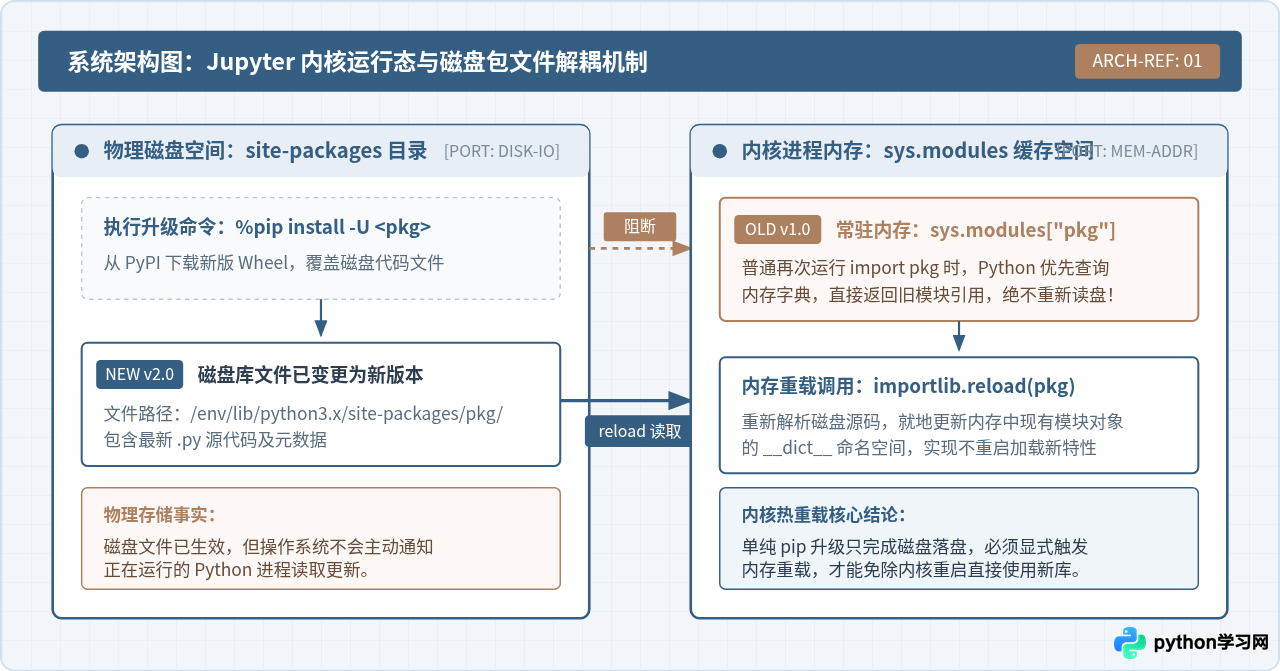
当我们在运行中调用 pip 升级时,pip 只是下载了新的 wheel 文件并覆盖了物理磁盘上的 .py 脚本或二进制文件。此时磁盘文件确实变成了新版本,但 Jupyter 内核的操作系统进程并未感知文件变动,内存中的 sys.modules 依然持有启动时初始化的旧版本对象。因此,必须使用专门的内存刷新手段打通磁盘与内存的断层。
第一步:在 Notebook 中正确升级库(%pip 对比 !pip)
在 Notebook 内部安装或升级库时,优先使用 %pip 魔法命令,而不是感叹号命令 !pip。
!pip 是通过子 Shell 执行系统路径下的 pip,在存在多 Python 环境、conda 虚拟环境或 pyenv 时,!pip 调用的 pip 经常指向系统的全局 Python,而非当前 Jupyter 内核正在使用的那个环境。而 %pip 是 IPython 原生提供的包管理魔法指令,它保证调用的正是驱动当前内核运行的那个解释器对应的 pip 可执行文件。
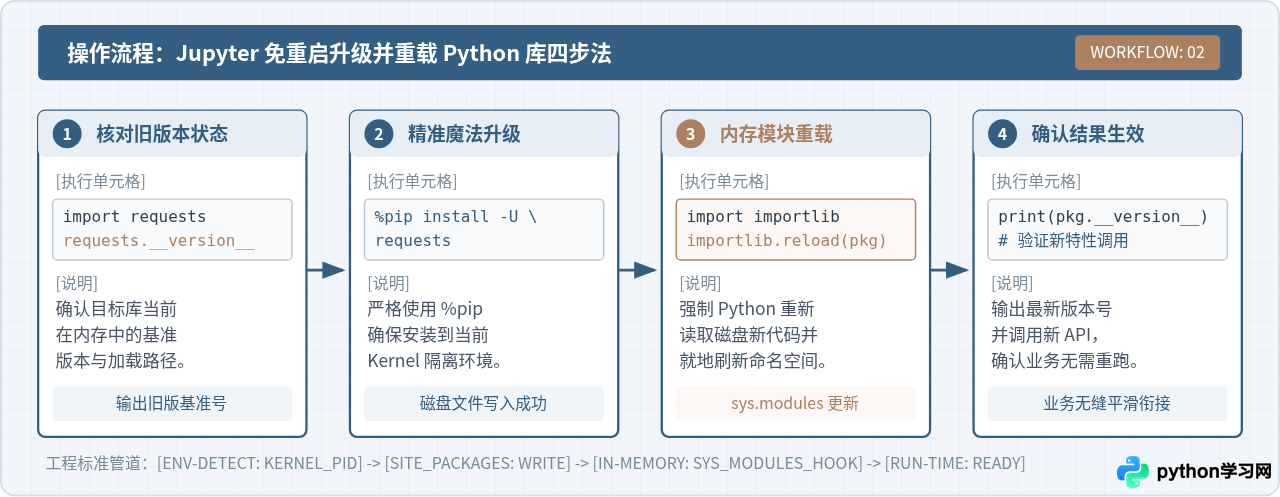
在 Notebook 单元格中执行以下升级命令:
# 升级指定库到最新版本(以 requests 为例)
%pip install --upgrade requests
如果需要指定安装特定版本,也可以使用标准的 pip 版本约束表达式:
# 升级或变更到特定安全版本
%pip install --upgrade "requests>=2.31.0"
单元格运行输出显示类似 Successfully installed requests-2.31.0 时,物理磁盘更新已准备完毕。
第二步:在内存中重载已加载的模块
磁盘文件更新后,需要让当前正在运行的 Python 解释器重新加载该库。常用的重载方法有两种,分别适用于一次性单库重载与持续开发调试场景。
方法一:使用 importlib.reload 进行精准重载(推荐)
Python 3 标准库自带了 importlib 模块,其中的 reload() 函数可以接受一个已导入的模块对象,重新从磁盘读取其代码并就地刷新该模块的命名空间:
import requests
import importlib

# 打印重载前的版本信息
print("重载前版本:", requests.__version__)

# 执行内存重载
importlib.reload(requests)

# 打印重载后的版本信息
print("重载后版本:", requests.__version__)
importlib.reload(requests) 会找到 requests 对应的模块文件,重新编译并执行其顶层代码,将新的函数、类与变量更新到原有的模块字典中。执行完毕后,再次通过 requests.func() 调用即可访问新版逻辑。
方法二:使用 IPython 的 autoreload 扩展(适合库开发与联调)
如果你正在开发自己的本地 Python 库或算法包,并且需要在 Notebook 中频繁修改代码并实时验证,可以使用 IPython 内置的自动重载扩展。它会在每个单元格执行前自动检测并重新导入已发生变更的模块:
# 启用 IPython 的自动重载扩展
%load_ext autoreload

# 设置为模式 2:每次执行代码前自动重载所有修改过的模块
%autoreload 2
%autoreload 2 会监听所有已加载模块的源码文件时间戳,一旦文件被 pip 覆盖或被文本编辑器保存,下一次在 Notebook 单元格按下运行键时,IPython 就会在后台自动完成重新加载,无需手动反复书写 importlib.reload。
关键陷阱:为什么重载后部分函数仍然是旧代码
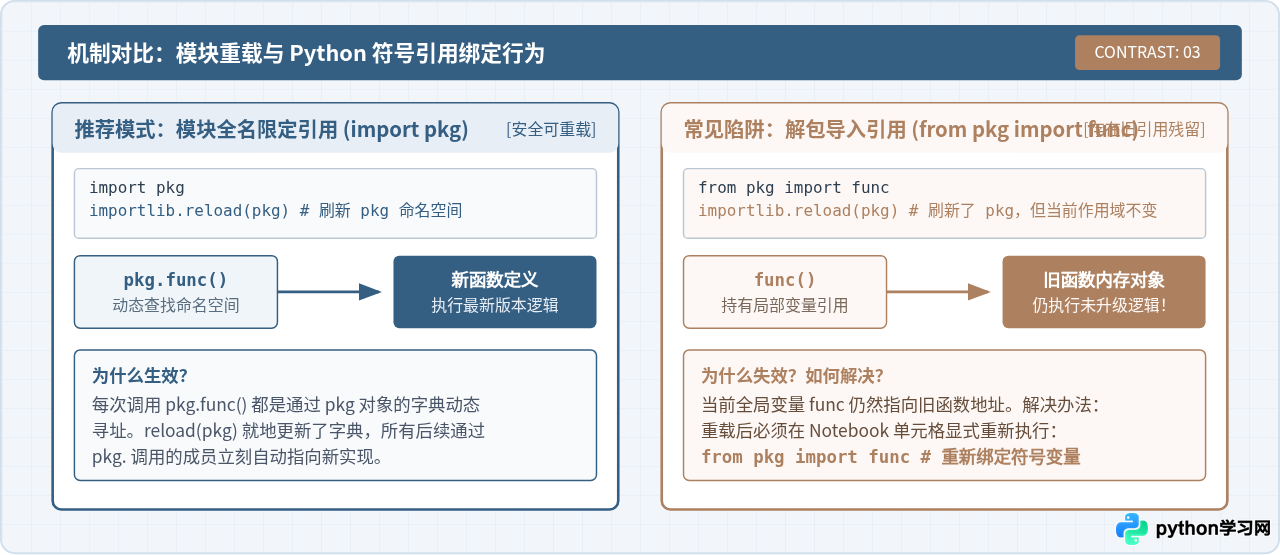
在实际使用 importlib.reload 时,不少开发者会遇到一个令人困惑的现象:版本号 requests.__version__ 明明更新了,但之前从该库导入的某个函数调用起来依然抛出旧版本的异常。这是由 Python 的符号引用机制(Symbol Binding)引起的。
观察以下两种不同的代码编写方式:
# 方式 A:保留模块前缀引用
import my_package
importlib.reload(my_package)
my_package.calc()  # 正常:每次通过 my_package.__dict__ 动态查找,立刻获得新版函数!

# 方式 B:解包导入到当前作用域
from my_package import calc
importlib.reload(my_package)
calc() # 异常:calc 变量在当前 Notebook 命名空间中仍指向旧函数对象!from package import func, MyClass 这种语法,执行 importlib.reload(package) 只会更新 package 内部的字典,而 Notebook 全局作用域中的 func 变量依然指向内存中旧的函数实体。此时必须在重载后显式重新执行一次 from package import func, MyClass,完成符号的重新绑定。
验证升级与重载是否真正生效
为了确保升级确实加载到了当前内核中,建议在重载后通过以下标准检查项进行确认:
- 核对版本属性:打印
module.__version__,确认版本号已变成目标新版本。 - 核对文件路径:打印
module.__file__,确认内核加载的绝对路径位于当前虚拟环境的site-packages下,排除加载了同名本地脚本的可能。 - 调用新增 API:直接调用新版本新增的方法或参数,确认不会抛出
AttributeError或TypeError。
import my_module
import importlib
importlib.reload(my_module)

print("当前加载文件:", my_module.__file__)
print("当前生效版本:", getattr(my_module, "__version__", "未知"))

# 验证新引入的 API
if hasattr(my_module, "new_feature_2026"):
    print("新特性已成功加载,可直接在当前会话使用。")
else:
    print("未检测到新特性,请检查包版本或是否存在缓存干扰。")
限制与边界:哪些情况必须重启内核
免重启热升级机制虽然强大,但并非所有 Python 库都适合通过 importlib.reload 进行无缝热重载。在以下场景中,重启内核是不可避免且唯一稳妥的解决办法:
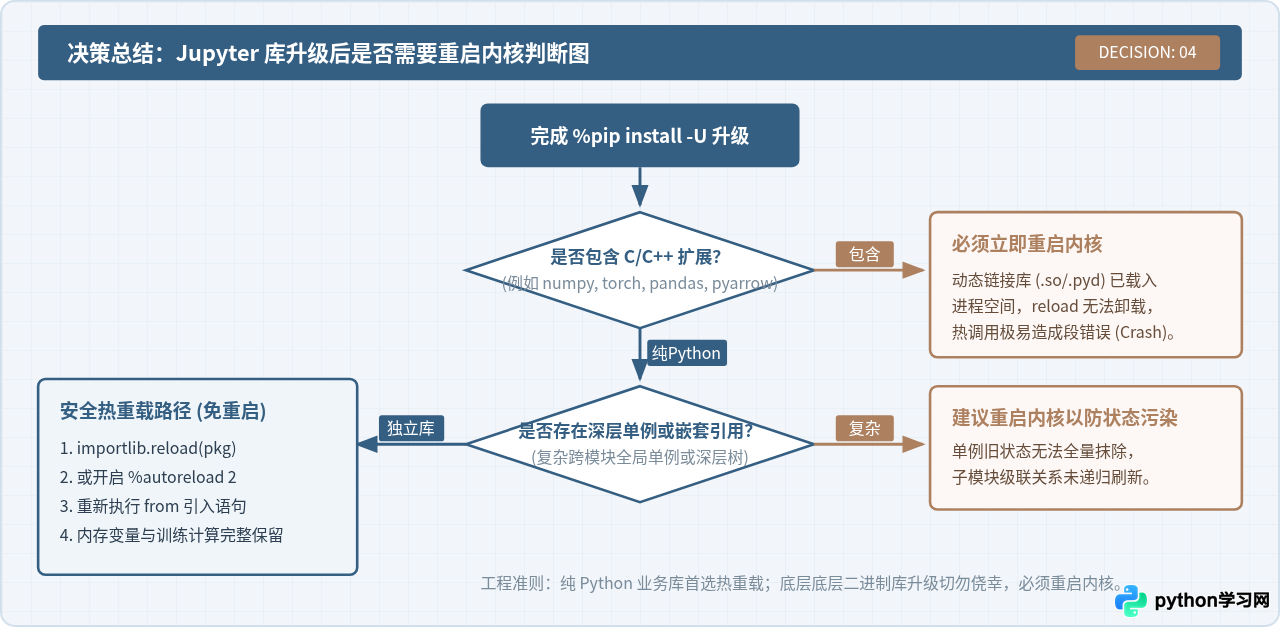
1. 包含 C / C++ 编译扩展的底层库(如 NumPy、PyTorch、Pandas)
这类库的核心计算逻辑通常由编译好的动态链接库(Linux/macOS 下为 .so / .dylib,Windows 下为 .pyd / .dll)实现。操作系统在进程启动后将这些动态库映射到内存中。Python 的 importlib.reload 无法在进程运行期安全地卸载或热替换底层 C 动态库。强行对这些库执行 reload 通常会触发 ImportError: cannot reload C extension,或者因 C 结构体内存对齐不一致导致解释器直接崩溃(Segmentation Fault / Kernel Crash)。
2. 深度复杂的嵌套依赖关系
importlib.reload(pkg) 是非递归的(Shallow Reload),它只重载 pkg/__init__.py 本身,而不会递归地去重载 pkg.submodule_a、pkg.submodule_b。如果升级涉及数十个子模块间的类继承与内部调用,单独重载顶层包会导致新旧子模块混杂,产生不可预期的逻辑冲突。
3. 不可逆的单例模式或全局状态注册
某些框架在导入时会在进程全局注册单例对象、初始化线程池或注册信号处理器(如某些日志、监控或数据库驱动)。重新执行其初始化代码可能导致重复注册或抛出资源占用错误。
总结与最佳实践对照表
为了在日常数据分析和算法开发中保持高效,可以参考以下操作决策对照表:
| 库的类型 / 升级场景 | 推荐操作方式 | 是否需要重启内核 | 主要风险与注意事项 |
|---|---|---|---|
| 纯 Python 业务库、工具库(如 requests、jinja2、自定义开发包) | %pip install -U <pkg> + importlib.reload(<pkg>) |
否(免重启) | 注意解包导入 (from ... import) 需要重新运行绑定。 |
| 本地脚本或自研模块持续调试 | %load_ext autoreload + %autoreload 2 |
否(免重启) | 保存文件后自动生效,保持引用使用 module.function 形式。 |
| 数值计算与深度学习底层库(如 numpy、scipy、torch、tensorflow) | %pip install -U <pkg> 后立即重启 Kernel |
是(必须重启) | C 扩展共享内存无法热卸载,避免热重载引发内核静默闪退。 |
| 跨多个层级的大型重构或主要大版本升级(Major Release) | 保存当前数据为中间文件(如 pickle/parquet),重启内核 | 是(建议重启) | 子模块版本不一致容易产生隐蔽 Bug,重启可获得最干净的环境。 |
综上所述,在 Jupyter Notebook 中升级库而不重启内核,最安全可靠的做法是:先评估目标库是否为纯 Python 实现,随后使用 %pip 在内核环境中完成物理更新,并通过 importlib.reload() 重新加载。只要避开 C 扩展库与符号解包引用的限制,就可以在保持长时间会话与内存变量完整的前提下,平滑体验新版本库的全部能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















