


零基础Python爬虫书单:从Requests到Scrapy的进阶阅读路径
专为零基础学习者打造的Python爬虫进阶书单与阅读路径,从HTTP网络底层协议、Requests脚本实战,到动态渲染逆向与Scrapy工业级框架,提供清晰的阅读阶梯与实战指导。
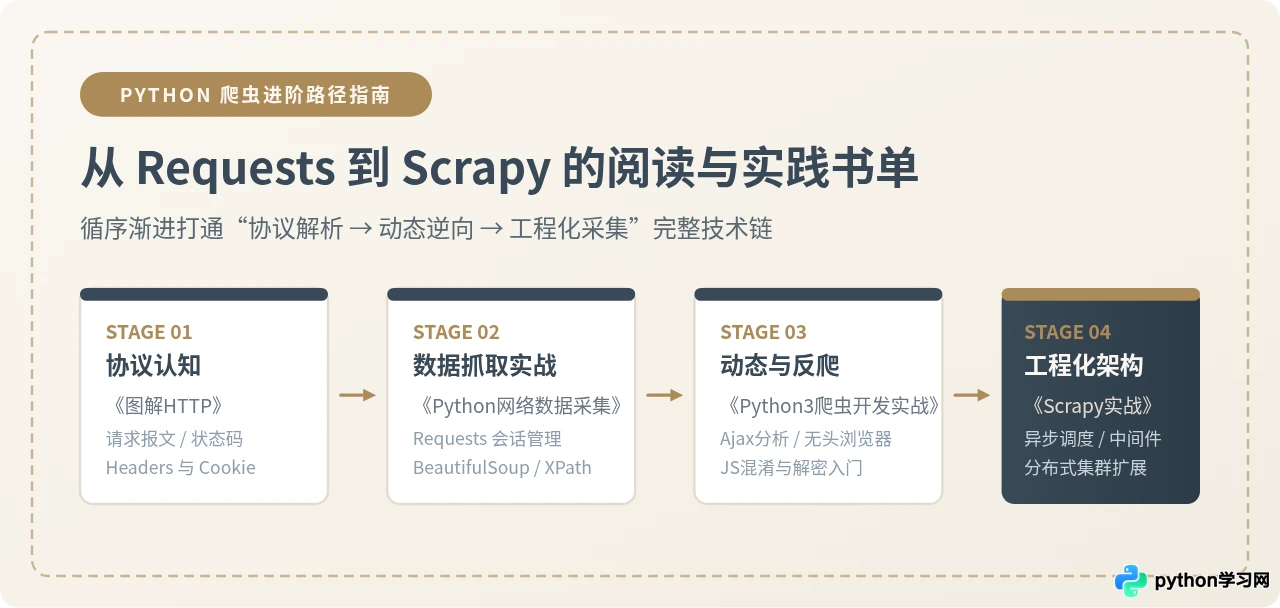
第一阶段:筑基篇——掌握 HTTP 协议与网络交互本质
网络爬虫从本质上讲,是一个模拟真实浏览器行为的自动化 HTTP 客户端。许多初学者在遇到 403 Forbidden、重定向循环或登录失效等问题时感到无从下手,根本原因在于缺乏对底层 HTTP 协议的认知。如果不知道请求头(Headers)、状态码、查询参数与 Cookie 在通信链路上扮演的角色,代码写得再熟练也只是在盲目拼凑。
推荐书目一:《图解HTTP》
这是一本不需要读者写一行代码、却能帮爬虫开发者彻底理顺底层通信逻辑的经典著作。全书采用大量手绘图解剖析了 HTTP/1.1 协议的运作机制。
- 核心必读章节:第 2 章(简单的 HTTP 协议)、第 3 章(HTTP 报文内的信息)、第 6 章(HTTP 首部字段)、第 7 章(确认访问用户身份的 HTTPS)。
- 阅读目标:搞清楚请求报文的请求行、首部与实体主体;准确理解
User-Agent、Referer、Host、Cookie、Content-Type对服务器鉴权的作用;牢记常见状态码(200、301/302、400、401、403、404、500、502)的真实语义。 - 可略过部分:书中关于网络安全历史事件和早起协议演变的小插曲,初次阅读时快速浏览即可。
阅读本书时,最有效的实践方式是打开 Chrome 或 Edge 浏览器的“开发者工具”(按 F12 键),切换到 Network(网络)标签页。随意访问一个新闻网站,观察浏览器向服务器发送了哪些请求首部,服务器又返回了哪些响应首部。当你能一眼看懂一个网络数据包由哪些部分组成时,第一阶段的目标就已达成。
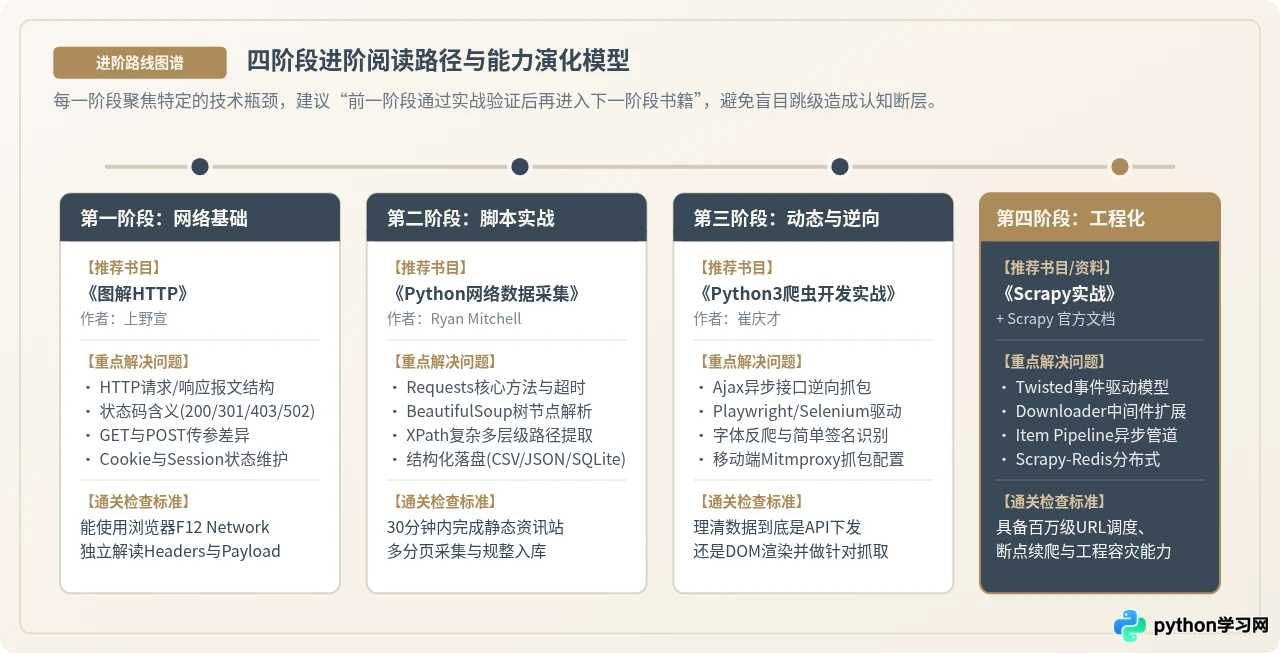
第二阶段:实战篇——从 Requests 脚本到结构化数据解析
搞清楚 HTTP 交互原理后,即可进入 Python 实战阶段。在这一阶段,目标是掌握 Python 社区中最优雅、应用最广的 HTTP 请求库 requests,以及主流的 HTML DOM 树解析库(BeautifulSoup 与 lxml 的 XPath)。
推荐书目二:《Python网络数据采集(第2版)》
本书是全球公认的 Python 爬虫经典教材。作者没有一上来就罗列复杂的框架,而是从标准库逐步过渡到第三方库,将网络请求、HTML 解析、数据清洗、多格式持久化串联得极为扎实。
- 核心必读章节:第 1 章(初见网络爬虫)、第 2 章(复杂 HTML 解析)、第 3 章(开始采集)、第 5 章(存储数据)。
- 阅读目标:掌握
requests.get()与requests.post()的参数构造;掌握requests.Session()进行状态持久化;掌握 BeautifulSoup 的 CSS 选择器与 lxml 的 XPath 语法;学会将提取出的字段有序保存至 CSV、JSON 文件或 SQLite 数据库。 - 阅读建议:书中后半部分涉及自然语言处理、图像识别和机器人的篇章,在零基础阶段先跳过,集中精力把前 5 章的抓取与存储彻底练透。
在这一阶段,务必建立规范的代码书写习惯,而不是写一串没有异常处理的脆弱脚本。以下是一个典型的 Requests + XPath 健壮请求示例:
import requests
from lxml import etree

url = "https://example.com/books"
headers = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
}

session = requests.Session()
try:
    # 明确设置连接超时与读取超时,防止程序假死
    response = session.get(url, headers=headers, timeout=(3.0, 10.0))
    response.raise_for_status()  # 若状态码非 200 则抛出异常
    response.encoding = response.apparent_encoding  # 自动解决中文乱码

    # 使用 lxml 构造 DOM 树并执行 XPath 解析
    html = etree.HTML(response.text)
    items = html.xpath('//div[@class="book-card"]')

    for item in items:
        title = item.xpath('.//h3/text()')
        price = item.xpath('.//span[@class="price"]/text()')
        if title and price:
            print(f"书名: {title[0].strip()} | 价格: {price[0].strip()}")

except requests.exceptions.Timeout:
    print("请求超时,正在记录至重试队列...")
except requests.exceptions.HTTPError as err:
    print(f"HTTP 响应状态异常: {err}")
except requests.exceptions.RequestException as e:
    print(f"网络通信发生不可恢复错误: {e}")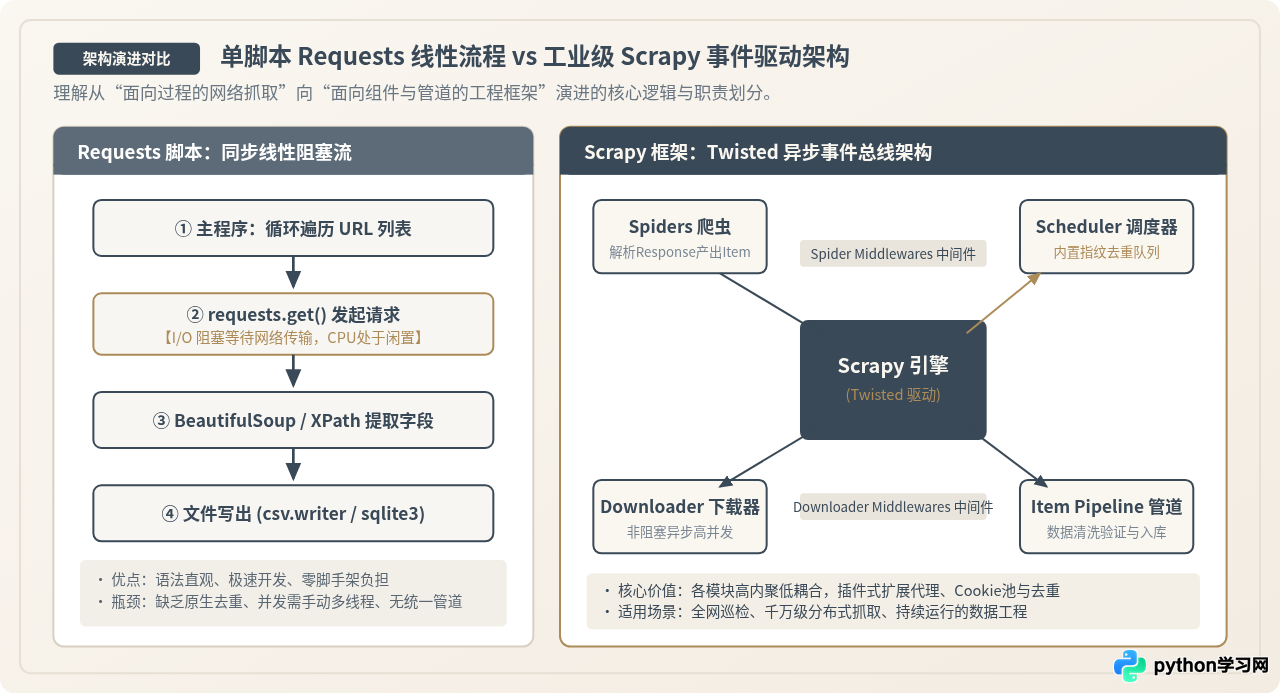
第三阶段:进阶篇——突破动态渲染、接口分析与反爬对抗
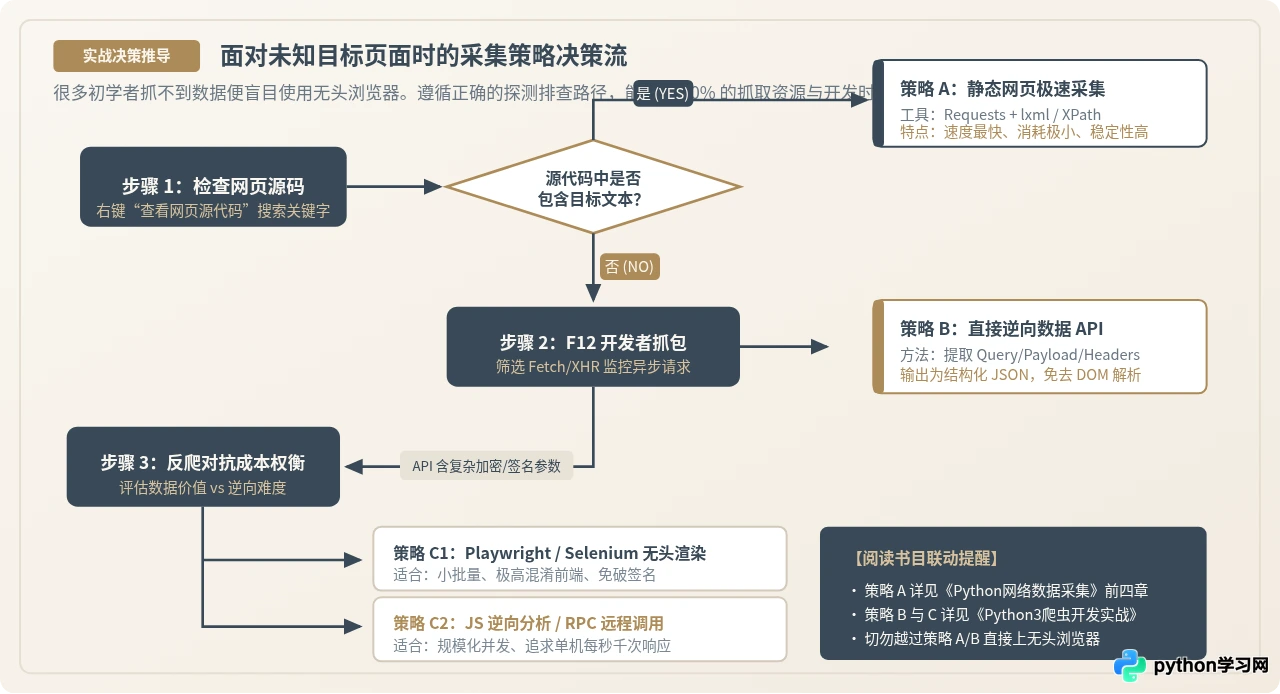
当你用 Requests 熟练抓取一批静态站点后,很快会遇到现代前端技术的阻碍:打开目标网页,页面呈现丰富的内容,但用 Requests 抓下来的 HTML 源码里却只有一片空白的 <div id="app"></div>,或者关键接口带有一长串看似乱码的加密参数 _signature。这标志着学习者必须进入“动态渲染与反爬逆向”的进阶阶段。
推荐书目三:《Python 3网络爬虫开发实战(第2版)》
本书是目前中文爬虫图书中最详实、体系最全面的巨著。作者结合当今互联网主流站点的防护策略,系统讲解了从动态抓包到浏览器驱动,再到前端 JavaScript 逆向的完整解法。
- 核心必读章节:第 6 章(Ajax 数据的爬取)、第 7 章(动态渲染页面的爬取:Playwright / Selenium)、第 10 章(客户端与移动端抓包分析)、第 11 章(JavaScript 逆向分析入门)。
- 阅读目标:学会利用 Chrome 开发者工具定位 Ajax 异步请求;在接口无法直接请求时,掌握现代自动化工具 Playwright 的页面事件监听与无头渲染;理解常见的反爬手段(频率限制、User-Agent 校验、IP 封锁、字体反爬)及其应对方案。
- 避坑指南:全书超过 1000 页,切忌从头按字硬读。前几章关于基础语法与基础库的内容若在第二阶段已掌握,请直接跳过,把时间集中分配在第 6、7、10、11 章上。
面对动态渲染站点时,学习者最容易犯的错误是“一律启动浏览器驱动”。无头浏览器(Headless Browser)虽然开发省心,但其内存消耗是纯 HTTP 请求的数十倍,并发极低。在实际项目中,应严格执行以下决策流程:
第四阶段:飞跃篇——Scrapy 企业级框架与分布式爬虫架构
当数据采集任务从“抓取几个页面的小样本”升级为“长期跟踪百万级甚至千万级 URL”时,单纯依靠单脚本加多线程会迅速暴露出严重缺陷:内存泄漏、重复抓取、缺乏失败重试与断点续爬机制、数据清洗与持久化代码与抓取逻辑混杂在一起难以维护。此时,必须引入成熟的工业级爬虫框架——Scrapy。
推荐核心资料与书目四:《Scrapy网络爬虫实战》与 Scrapy 官方文档
Scrapy 基于 Twisted 异步网络引擎构建,是一套将爬虫、调度器、下载器、管道完全解耦的工业级框架。进入这个阶段,读者应当脱离“脚本小子”思维,建立系统级的架构观。
- 核心攻坚内容:
- 架构理解:深刻理解 Engine(引擎)、Spiders(爬虫)、Scheduler(调度器)、Downloader(下载器)、Item Pipeline(管道)五大核心组件的数据流转与信号机制。
- 中间件开发:掌握
DownloaderMiddleware的实现原理,学会编写通用的代理 IP 轮换中间件、自动添加随机 User-Agent 中间件、捕获封禁状态码并重试。 - 数据管道流转:通过 Item 规范字段,编写 Pipeline 实现数据去重、字段清洗、批量写入 MongoDB 或 MySQL。
- 分布式扩展:学习
scrapy-redis组件,将内存调度队列与指纹集合迁移至 Redis 共享集群,实现多服务器节点并行分布式爬取。
学习避坑法则与合规安全红线
在阅读进阶的过程中,技术的提升往往伴随着责任的增加。爬虫技术如果使用不当,不仅会导致目标网站服务瘫痪,更可能触犯法律红线。
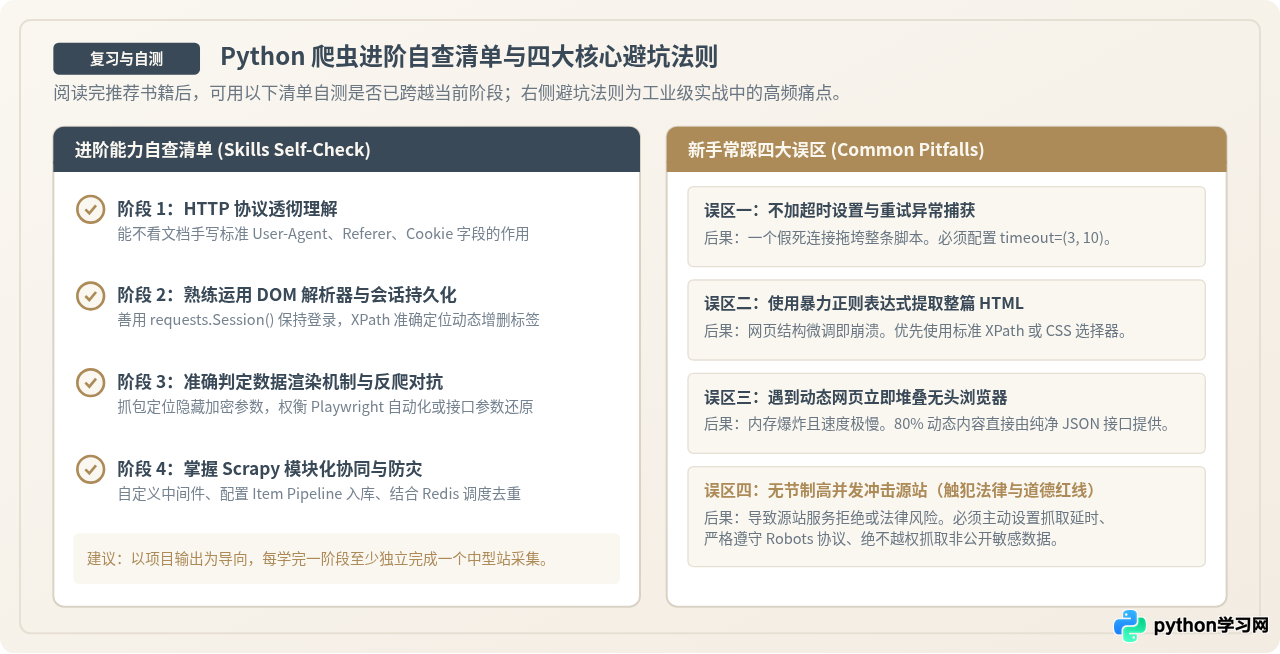
在开展任何实际抓取项目前,请严格遵守以下三条基本原则:
- 尊重 Robots 协议与抓取速率:查看目标网站的
/robots.txt文件,了解允许抓取的范围;在代码中显式配置DOWNLOAD_DELAY = 1.0或合理的请求间隔,绝不对小型目标站点实施野蛮高并发轰炸。 - 严禁越权抓取敏感数据:不利用爬虫绕过网站的安全防护访问非公开数据;不抓取涉及公民个人隐私、商业机密、金融交易等受法律严格保护的数据资产。
- 合理规划学习周期:建议为整套进阶路径预留 8 至 12 周时间。每周保持“3 天阅读概念 + 4 天实战写代码”的节奏,每学完一本书,必须独立写出一个完整且带异常处理的项目,方能真正将书本知识内化为工程能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















