


Python随机数用法避坑:类型错误、范围越界与伪随机性
深入解析Python随机数常见陷阱:TypeError类型错误、randint与randrange端点越界、空序列与超抽异常,以及伪随机算法MT19937在安全场景下的隐患与secrets替代方案。
random 模块几乎是每位开发者最早接触的内置库之一。但在实际业务中,由于对区间开闭约定的混淆、输入容器类型的隐式限制以及伪随机数算法(PRNG)的安全边界缺乏了解,常常引发线上 IndexError、TypeError 崩溃,甚至引发 Token 可预测的安全漏洞。本文系统梳理 Python 随机数常见误区,提供严格的防错模式与选型方案。
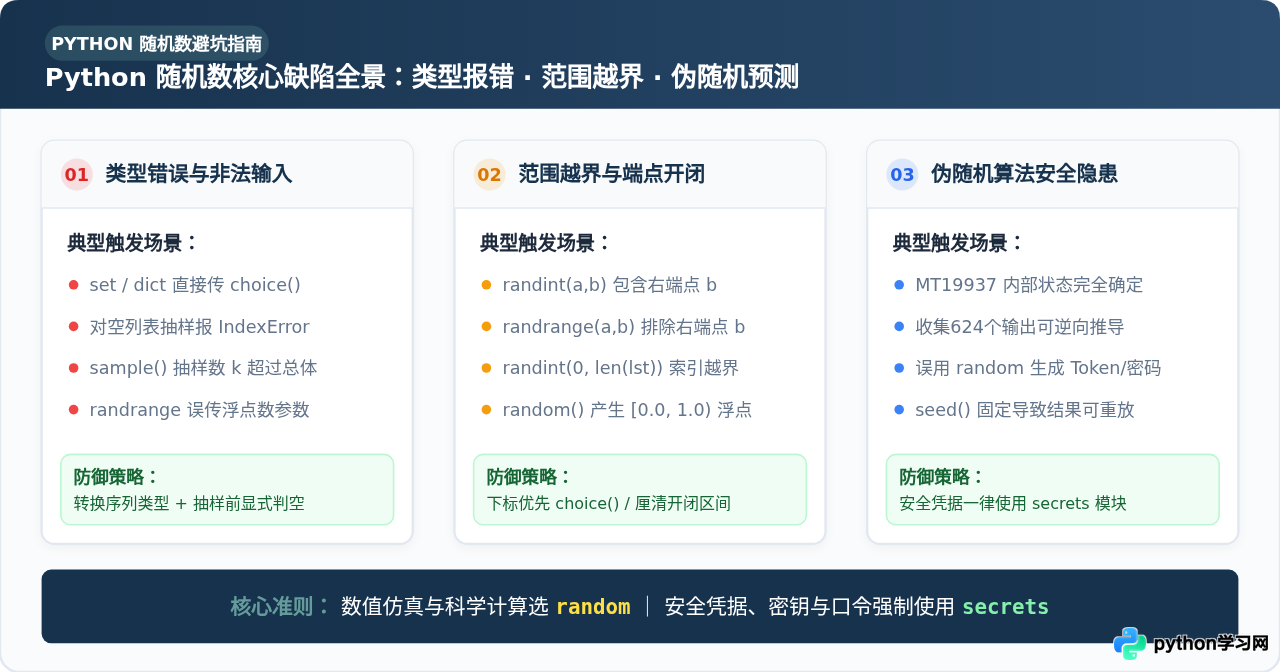
一、范围越界与端点开闭:最容易踩的“差一错误”
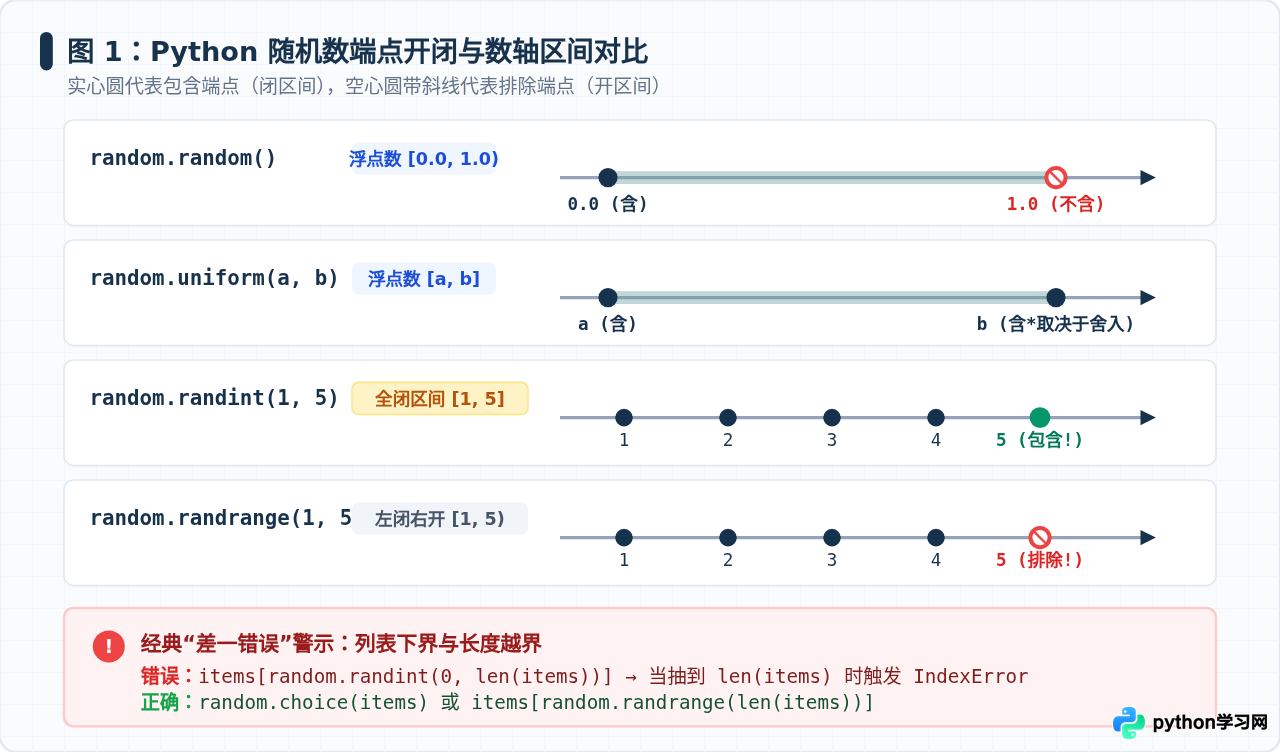
Python 的 random 模块中,不同函数对上下限“是否包含端点”的约定并不统一。这是新手与资深开发者都容易踩中的经典“差一错误”(Off-by-one Error)。
1. randint(a, b) 是全闭区间 [a, b]
Python 内置的 range(start, stop) 习惯是“左闭右开”(包含 start,但不包含 stop)。然而,random.randint(a, b) 却是一个例外:它返回的是全闭区间,即同时包含 a 和 b。
import random

# 很多初学者误以为只会在 1, 2, 3, 4 中抽取
val = random.randint(1, 5)
print(val)  # 实际结果完全可能等于 5!
2. randrange(start, stop, step) 是半开区间 [start, stop)
与 randint 形成鲜明对照的是 random.randrange(a, b),它严格遵循 range() 的语义,不包含右端点 b。
实际上在 Python 源码中,randint(a, b) 底层直接调用的是 randrange(a, b + 1)。如果你在重构代码时将 randint 机械替换为 randrange,就会导致最大值永远无法取到,破坏原有的业务概率分布。
3. 列表下标越界崩塌:randint(0, len(lst))
正因为 randint 包含右端点,当开发者用它生成序列下标时,最常见的崩溃写法如下:
fruits = ["apple", "banana", "cherry"]  # len(fruits) == 3,合法索引为 0, 1, 2

# 危险写法:当随机抽中 3 时,引发 IndexError!
selected = fruits[random.randint(0, len(fruits))]- 直接使用
random.choice(fruits)从列表中选取元素,无需手动生成下标; - 若必须使用下标,应使用遵循半开区间的
random.randrange(len(fruits))或random.randint(0, len(fruits) - 1)。
二、类型错误与非法输入:序列抽样时的常见异常
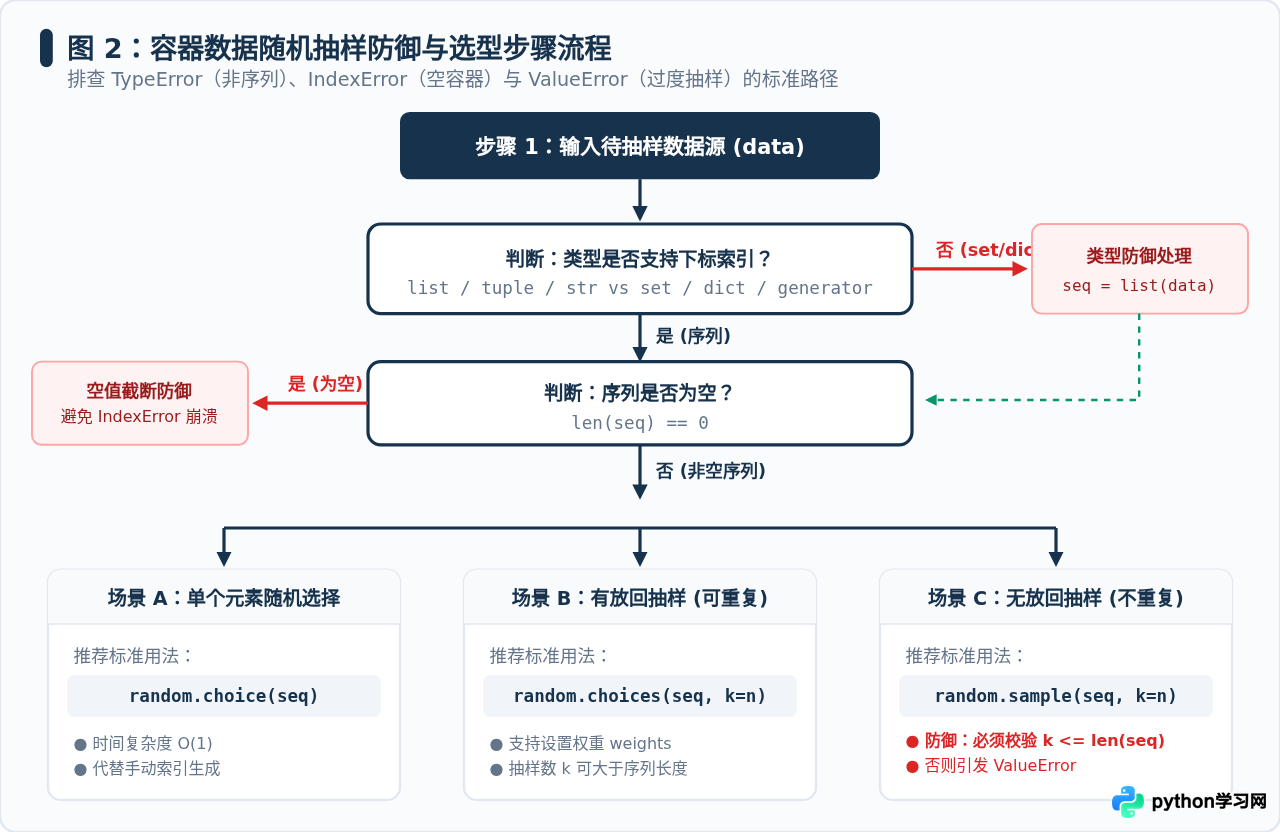
Python 的动态类型特性虽然灵活,但在使用随机数抽样函数时,对容器的数据结构有着严格要求。将不合规的容器类型直接传给随机函数,是引发生产环境 TypeError 和 ValueError 的高发区。
1. 误将集合(Set)或字典(Dict)传给 choice()
random.choice(seq) 内部依赖序列的下标索引操作(即 seq[i])。因为集合 set 和字典 dict 是无序散列结构,不支持通过整数下标访问,直接传入会导致 TypeError。
user_ids = (1001, 1002, 1003)  # set 集合类型

# 错误用法:直接传入 set
lucky_user = random.choice(user_ids)
排查与修复:如果数据源是 set,必须先显式转换为 tuple 或 list:random.choice(list(user_ids));如果是字典,抽键应使用 random.choice(list(my_dict.keys()))。需要注意,对于千万级的大集合,直接转列表有额外的内存与遍历开销,可考虑使用 random.sample()。
2. 对空序列抽样引发 IndexError
当数据列表来自数据库查询、接口返回或筛选过滤时,很容易出现空列表 []。random.choice([]) 无法从空容器中挑选元素,会直接抛出 IndexError:
items = []
# 抛出 IndexError: Cannot choose from an empty sequence
item = random.choice(items)
防御式写法:在调用 choice() 之前始终进行真值校验:
if items:
    selected = random.choice(items)
else:
    selected = None  # 或触发默认兜底业务逻辑
3. sample() 抽样数量 k 超过总体容量
random.sample(population, k) 用于无放回抽样(抽取出的每个元素互不相同)。如果指定的抽样数量 k 大于 population 的实际元素个数,或者 k < 0,将抛出 ValueError:
cards = ["A", "B", "C"]  # 总量 3 张
draw = random.sample(cards, k=5)  # 企图无放回抽 5 张
场景判断:如果业务本身允许重复抽样(有放回),应使用 random.choices(cards, k=5);如果业务严格要求不重复,则必须做参数截断保护:k = min(k, len(cards))。
三、伪随机性与安全陷阱:为什么不能用 random 模块生成凭据
这是软件工程中最致命的隐蔽风险之一。很多初级系统在生成用户密码重置链接、手机短信验证码、API 鉴权 Token 时,习惯性写下 ''.join(random.choice(...) for _ in range(32))。这种做法存在重大安全隐患。
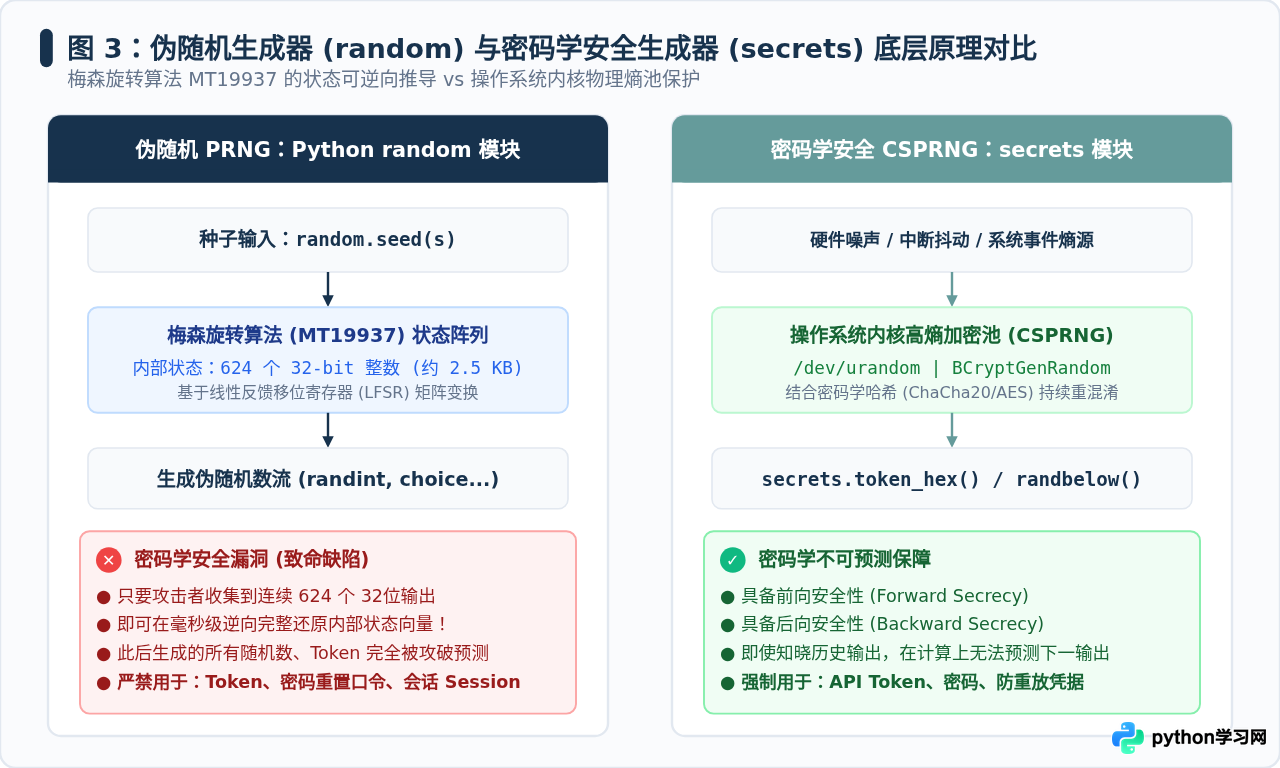
1. 伪随机算法的核心:Mersenne Twister (MT19937)
Python 的 random 模块底层采用的是梅森旋转算法(Mersenne Twister 19937)。MT19937 是一种伪随机数生成器(PRNG),具有周期极长(\(2^19937-1\))和统计均匀性好的优点,因此非常适合做蒙特卡洛模拟、游戏掷骰子、随机洗牌和数值仿真。
但 MT19937 不是加密安全的(Not Cryptographically Secure)。它的内部状态由 624 个 32 位无符号整数构成。这个状态完全通过确定性的位运算和线性矩阵迭代更新。
攻击者只要获取该随机生成器连续产出的 624 个 32 位整数输出(例如通过连续请求获取 624 个公共生成的非敏感伪随机序列),就能通过解线性方程组完全重构出内存中的 624 维状态阵列。一旦状态阵列被克隆,攻击者便能精准推算出系统在下一秒、下一小时生成的所有 Token、会话凭证和临时验证码!
2. 种子(Seed)固化的重放风险
很多开发者在单元测试或调试代码时会调用 random.seed(12345) 来确保结果可复现。如果错误地将 random.seed() 带入生产代码,或者在多进程环境(如 multiprocessing)下未对子进程重新重置种子,所有子进程将产生完全一模一样的伪随机数序列。
3. 安全场景的标准解决方案:使用 secrets 模块
从 Python 3.6 开始,标准库提供了专为安全认证设计的 secrets 模块。secrets 底层依赖操作系统内核提供的加密安全熵源(在 Linux/macOS 上为 /dev/urandom 或 getrandom(),在 Windows 上为 CryptGenRandom / BCryptGenRandom)。
import secrets
import string

# 场景 1:生成 URL 安全的随机认证 Token(32 字节高熵随机)
auth_token = secrets.token_urlsafe(32)
print("Token:", auth_token)

# 场景 2:生成十六进制随机密钥字符串(如 API 密钥)
api_key = secrets.token_hex(16)
print("API Key:", api_key)

# 场景 3:生成 6 位安全的数字短信验证码(避免 randrange 伪随机)
code = "".join(str(secrets.randbelow(10)) for _ in range(6))
print("SMS Code:", code)API Key: e4c7f0a189b2d35678912345abcdef01
SMS Code: 839201
四、避坑决策指南与速查备忘
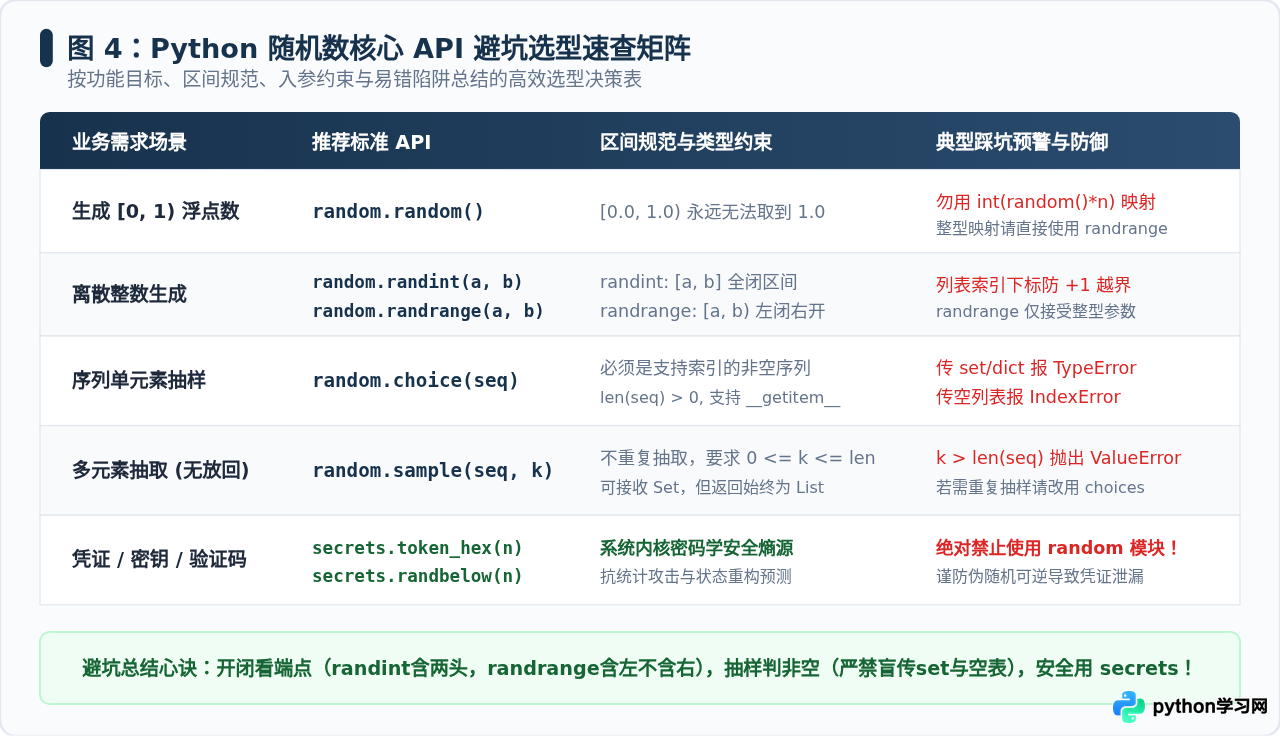
为了在实际开发中避免在多种随机数函数之间产生混乱,下面整理了常用函数的选型对照表,明确输入类型约束、返回区间和常见坑点:
| 业务需求 | 推荐函数 | 返回范围 / 类型 | 高危易错点与防御 |
|---|---|---|---|
| 生成 [0.0, 1.0) 浮点数 | random.random() |
[0.0, 1.0) 半开区间 |
永远取不到 1.0;严禁通过乘以 N 强制转整型,应直接使用 randrange |
| 指定浮点区间 [a, b] | random.uniform(a, b) |
浮点数,理论闭区间 | 端点是否包含受系统浮点舍入影响,不可依赖端点做精确相等判断 |
| 整数闭区间(含两端) | random.randint(a, b) |
[a, b] 全包含 |
包含右端点 b。用作列表长度下标时易造成 IndexError |
| 整数半开区间(不含右端) | random.randrange(a, b) |
[a, b) 左闭右开 |
与 range() 行为完全一致;只能接受整数参数,传浮点数会报错 |
| 从已有容器抽 1 个元素 | random.choice(seq) |
单个元素 | 容器必须支持下标且非空;禁止直接传入 set 或 dict |
| 从已有容器无放回抽 N 个 | random.sample(seq, k) |
列表(元素不重复) | 若 k > len(seq) 会抛出 ValueError,调用前需校验长度 |
| 有放回抽样 / 带权重抽样 | random.choices(seq, k=n) |
列表(元素可重复) | k 可以大于序列长度,支持 weights 和 cum_weights 参数 |
| 打乱现有列表顺序 | random.shuffle(lst) |
None(就地修改) |
该函数是就地修改(in-place),返回值为 None,不能写成 lst = random.shuffle(lst) |
| 身份凭证、密码与密钥 | secrets.token_urlsafe()secrets.token_hex() |
高熵加密安全字符串 | 绝对禁止使用 random 模块代替,防止伪随机序列被逆向推导 |
五、核心防坑自检清单
在代码提交审查(Code Review)或上线前,建议对照以下 5 项检查清单排查随机数使用风险:
-
端点开闭审查:使用
randint(a, b)时,确认是否真的需要包含b;如果是遍历或列表切片下标,优先换成randrange(len(lst))或choice(lst)。 -
容器类型判空:所有调用
random.choice()、random.sample()的位置,必须在调用前完成非空检查(if seq: ...),防范空集合引发生产事故。 -
序列支持检查:确认传入
choice()的对象是列表(list)、元组(tuple)或字符串(str)。如果是集合或字典键,使用前显式调用list()。 -
无放回超抽拦截:使用
random.sample(pop, k)时,确保k始终满足0 <= k <= len(pop);若需求是可重复抽样,立即更换为random.choices()。 -
安全边界隔离:检索项目代码中所有生成 Token、API Key、Session ID、重置口令、验证码的地方,确保全部导入自
secrets模块,严禁出现random。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















