


python必背源代码冒泡排序代码怎么写
本文详细解答python必背源代码冒泡排序代码怎么写,提供基础版与标志位优化版标准源码,深入剖析双重循环边界、单轮相邻交换推导过程、易混淆细节及复杂度分析,帮助读者快速掌握与记忆。
n - 1 轮),内层循环从头开始比较相邻两个元素,若前项大于后项则直接交换。每一轮遍历结束后,当前未排序区间中的最大数值都会像气泡浮上水面一样被推送到序列末尾。掌握这个两两相邻比较的机制以及内层循环的终止边界,就能在几分钟内准确默写出完整的排序函数。
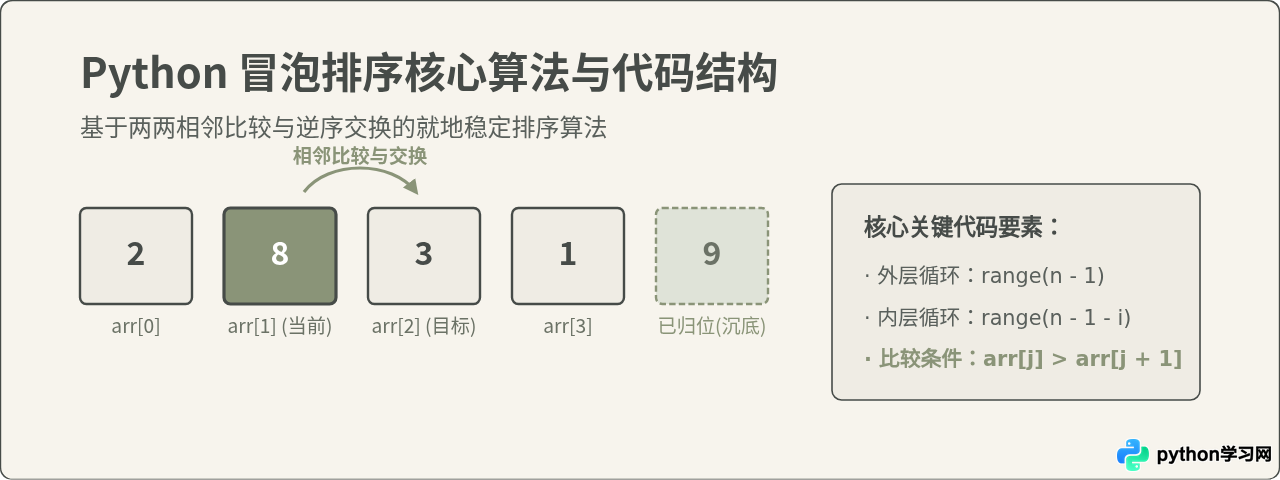
一、冒泡排序标准必背源代码(基础版)
在各类编程面试和算法自测中,最常要求默写的是标准版冒泡排序。Python 提供了方便的多元赋值语法 a, b = b, a,使得在不引入第三个临时变量的情况下就能简洁完成两数交换。以下是无需外部库、直接可运行的标准函数实现:
def bubble_sort(arr):
    n = len(arr)
    # 外层循环控制总轮数(共 n - 1 轮)
    for i in range(n - 1):
        # 内层循环遍历当前未排序区间进行相邻比较
        for j in range(n - 1 - i):
            # 前项大于后项则交换位置
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
    return arr
这段代码定义了一个名为 bubble_sort 的函数,接收一个列表 arr。函数对传入的原地列表直接修改并返回排序后的列表。代码行数少、结构对称,是备考和日常学习中建议优先熟记的基准模板。
二、双重循环分工与核心运行原理
要牢记上述代码,不能仅凭机械记忆,关键在于弄清内外两层循环各自承担的独立职责:
- 外层循环
for i in range(n - 1):决定排序一共要执行多少趟。假设列表有 5 个元素,当把前 4 个较大的元素依次送往正确位置后,剩余的最后 1 个元素必定是全局最小的,自然归位。因此对于长度为n的序列,外层循环只需要执行n - 1次。 - 内层循环
for j in range(n - 1 - i):负责在单趟内让游标j从索引 0 向后扫描,逐一对arr[j]和arr[j + 1]进行两两比较。凡是左边数值大于右边数值,就对换其位置。
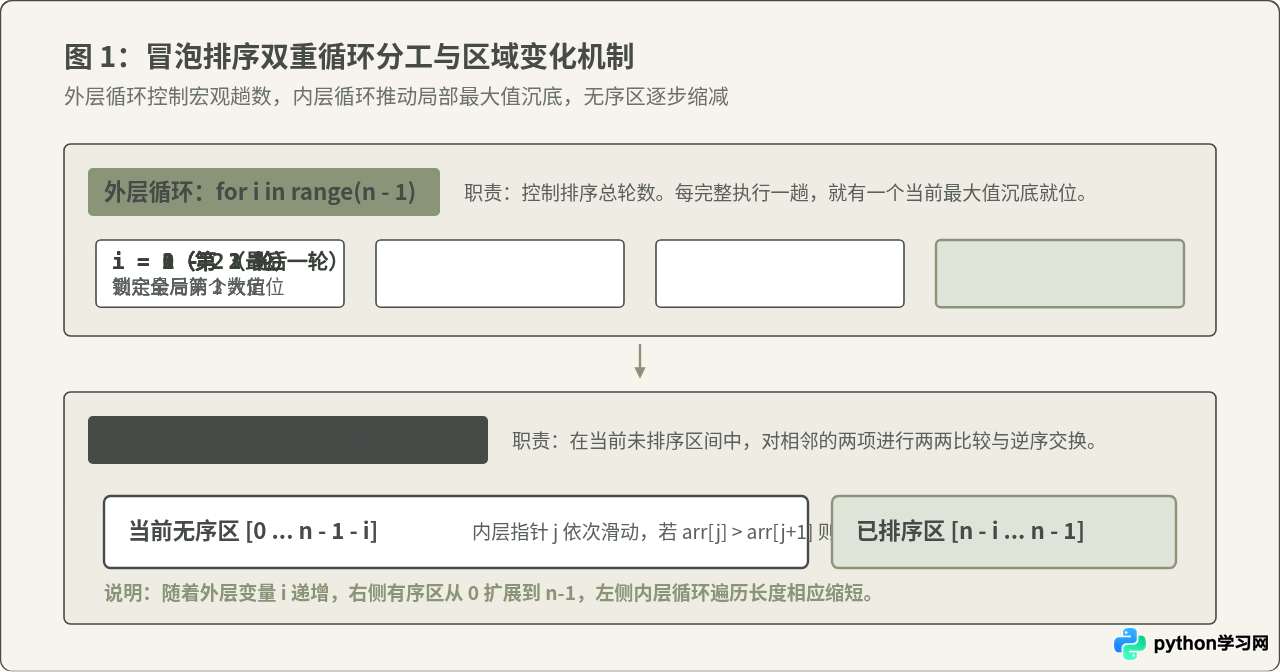
如上图所示,整个数组在运行过程中被动态划分为两部分:左侧为“待排序的无序区”,右侧为“已沉底的有序区”。外层变量 i 每增加 1,右侧有序区就增加 1 个归位元素,左侧无序区相应缩短 1 个单位。
三、单轮推导过程拆解:以具体数据为例
通过一个具体的无序序列 [5, 2, 8, 3, 1],我们可以完整跟踪第一轮(即 i = 0 时)内层循环的 4 次单步比对过程:
- 当 j = 0:比对
arr[0] (5)与arr[1] (2)。由于 5 > 2,二者交换,序列变为[2, 5, 8, 3, 1]。 - 当 j = 1:比对
arr[1] (5)与arr[2] (8)。由于 5 < 8,不满足交换条件,序列保持[2, 5, 8, 3, 1]。 - 当 j = 2:比对
arr[2] (8)与arr[3] (3)。由于 8 > 3,二者交换,序列变为[2, 5, 3, 8, 1]。 - 当 j = 3:比对
arr[3] (8)与arr[4] (1)。由于 8 > 1,二者交换,序列变为[2, 5, 3, 1, 8]。
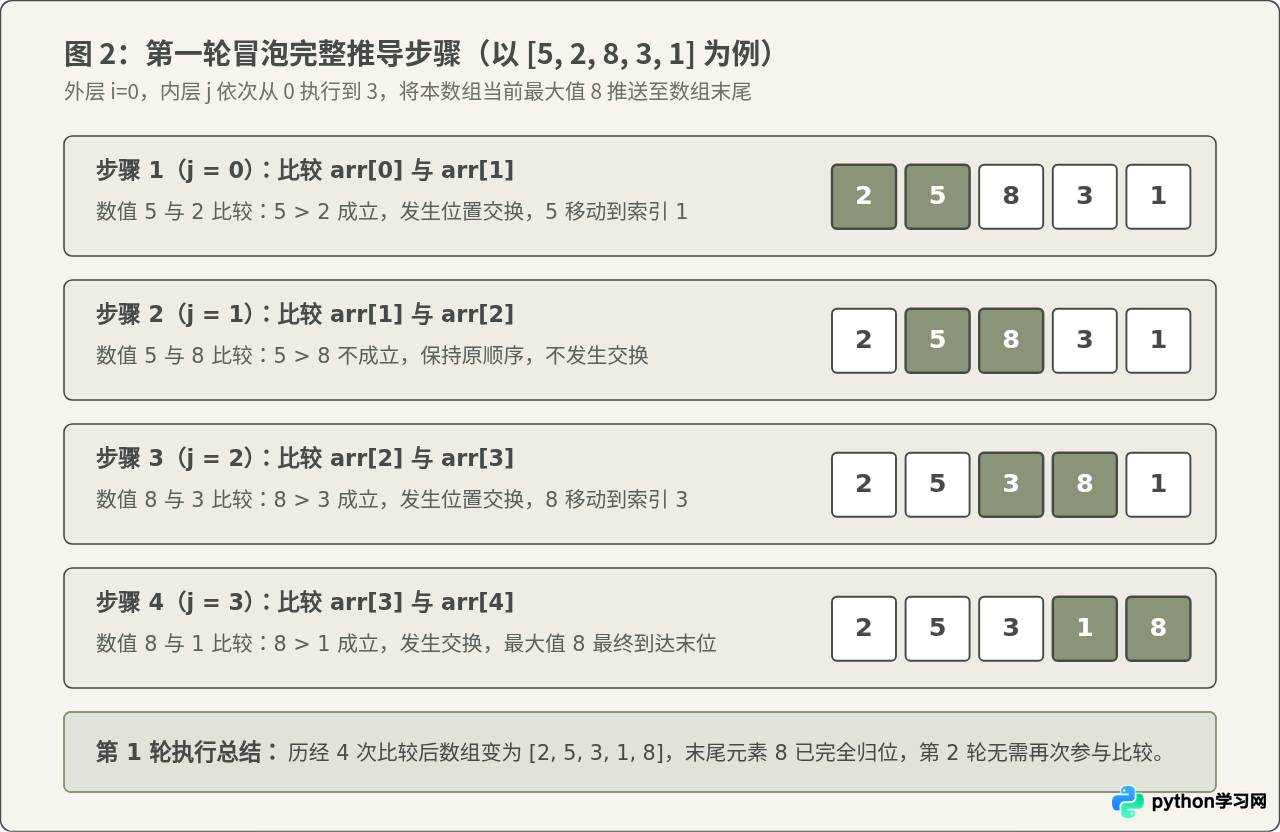
一轮遍历结束之后,当前序列的最大值 8 已经稳稳停留在序列最后一位(索引 4)。在后续的所有轮次中,索引 4 的位置都无需再发生任何变动。
四、核心细节剖析:内层边界为什么是 len(arr) - 1 - i?
很多初学者在默写代码时,最容易写错的就是内层循环的终止边界 range(n - 1 - i)。这个减法表达式其实由两部分组成,各自解决一个不同层面的问题:
1. 为什么减 1? 因为内层判断语句使用了
arr[j + 1]。如果 j 取到 n - 1,那么 j + 1 就会变成 n,直接触发 Python 列表的 IndexError: list index out of range 越界错误。因此游标最大只能停在 n - 2,对应 range(n - 1)。2. 为什么还要减 i? 因为外层循环每推进一轮,末尾就已经有
i 个数完全排好序。如果不减去 i,代码虽然仍能得出正确结果,但会继续对末尾已经有序的数值进行盲目重复比对,造成不必要的 CPU 计算开销。
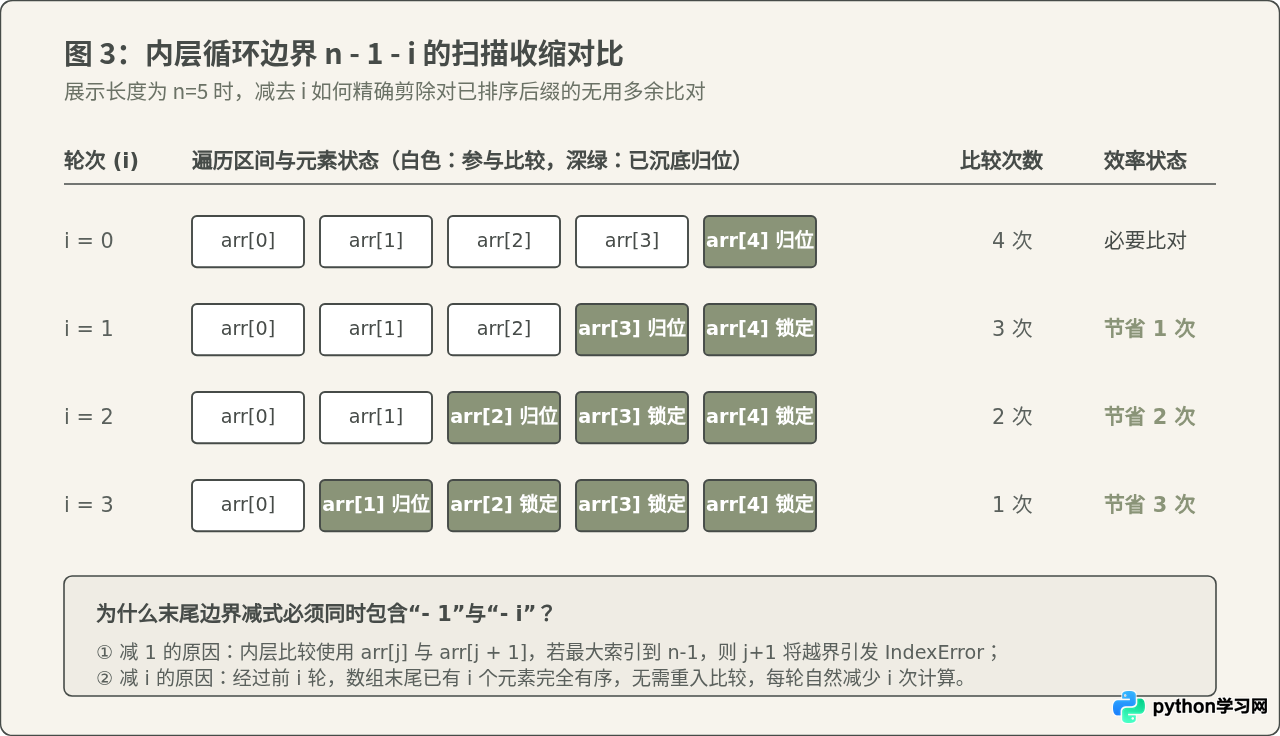
从图 3 可以清楚看出:如果不写 - i,无论执行到第几轮,内层都机械地比对 4 次,全流程需要比对 16 次;而加上 - i 后,每轮比对次数递减为 4、3、2、1,总比对次数降低至 10 次,直接减免了 37.5% 的无用计算量。
五、进阶优化写法:添加标志位提前终止
基础版冒泡排序有一个固有短板:即使给定的列表原本就已经有序(例如 [1, 2, 3, 4, 5]),或者序列在中间某一轮就已经整体排好,基础版代码依然会固执地把所有双重循环执行完毕。
为了解决这个问题,通常会引入一个布尔变量 swapped(交换标志位)。如果某一轮遍历中没有发生任何一次位置交换,说明列表已经完全处于升序状态,可以直接 break 提前跳出整个排序过程:
def bubble_sort_optimized(arr):
    n = len(arr)
    for i in range(n - 1):
        swapped = False  # 每轮开始前初始化标志位
        for j in range(n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True  # 发生了交换则标记为 True
        # 若整轮遍历没有发生任何交换,说明已有序,直接退出
        if not swapped:
            break
    return arr
加上标志位后,当传入原本就已经有序的数组时,代码仅需遍历第 1 轮(比较 n - 1 次)发现未发生交换即可立即退出,将最好情况下的时间复杂度从原本的 O(n²) 优化为 O(n)。
六、常见概念误区与算法特征
在理解和背诵冒泡排序时,以下两组概念最容易被混淆:
- 误区一:混淆冒泡排序与选择排序。有人认为“把最大值或最小值放到一端”就是冒泡。实际上,两者的核心区别在于元素位移的方式:冒泡排序通过“相邻两两比较”不断触发物理交换,一趟下来可能会发生多次数据位置对调;而选择排序是在未排序区中单向遍历寻找最值对应的下标,整趟扫描完成后仅执行一次真正的元素交换。
- 误区二:错误修改比较符号破坏稳定性。冒泡排序是典型的稳定排序算法(值相等的两个元素在排序前后不会颠倒原本的相对顺序)。保证稳定性的关键是比较条件必须是严格的
arr[j] > arr[j + 1]。如果误写成arr[j] >= arr[j + 1],两个相等元素遇到时就会被强行对调,导致算法失去稳定性。
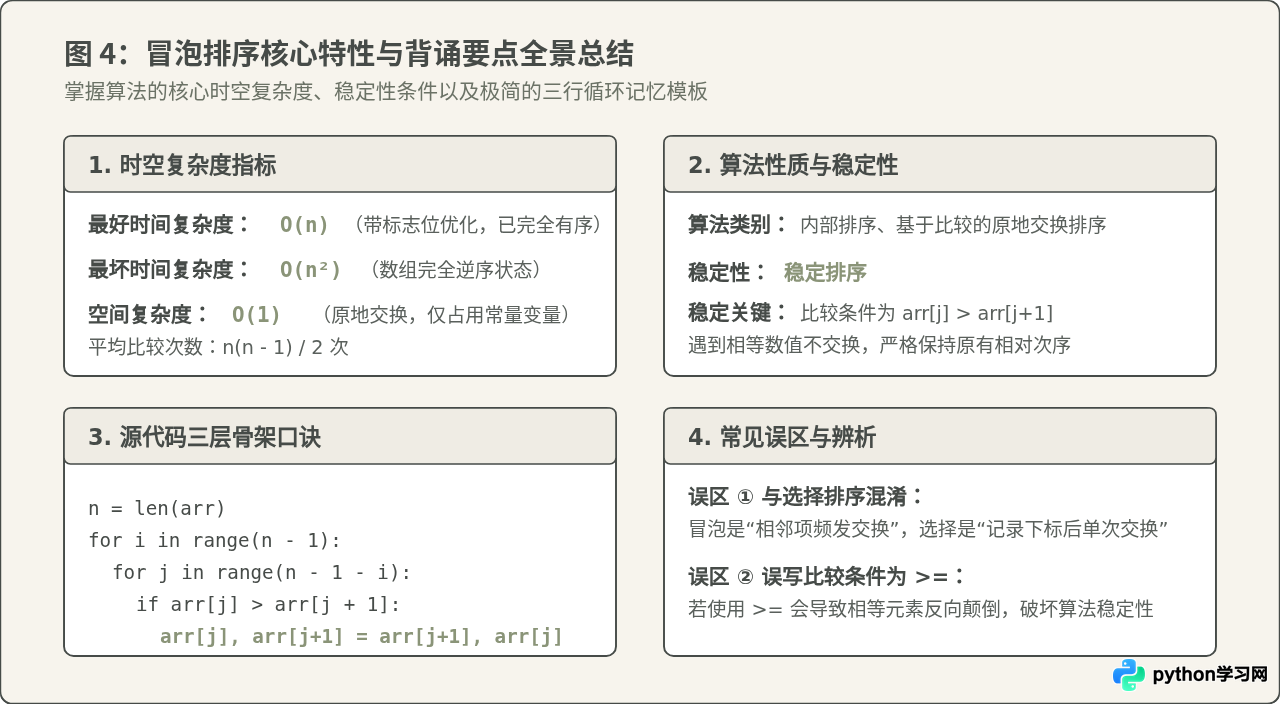
| 算法维度 | 指标表现 | 适用与成立条件 |
|---|---|---|
| 最好时间复杂度 | O(n) | 仅在使用带 swapped 标志位的优化版本且输入序列已完全有序时成立 |
| 最坏时间复杂度 | O(n²) | 输入序列呈现完全逆序状态时,每一对相邻元素都需要进行逆序对换 |
| 平均时间复杂度 | O(n²) | 随机乱序数据集下的平均比对与交换开销 |
| 空间复杂度 | O(1) | 原地排序算法,仅占用常数级别的指针与临时变量空间 |
| 算法稳定性 | 稳定 | 依赖严格大于比较条件 arr[j] > arr[j + 1],相等值绝不交换 |
七、完整可执行示例与输出验证
将上述函数保存后,可在标准 Python 3 环境(Python 3.6 及以上任意版本)中进行调用验证。以下为完整的测试脚本,涵盖乱序序列、已排序序列以及包含重复数值的序列:
def bubble_sort(arr):
    n = len(arr)
    for i in range(n - 1):
        swapped = False
        for j in range(n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True
        if not swapped:
            break
    return arr

# 测试不同场景的数据输入
test_data_1 = [64, 34, 25, 12, 22, 11, 90]
test_data_2 = [5, 1, 4, 2, 8]
test_data_3 = [3, 3, 1, 2, 1]

print(bubble_sort(test_data_1))
print(bubble_sort(test_data_2))
print(bubble_sort(test_data_3))
运行上述脚本后,在终端或控制台中得到的输出结果如下:
验证结果显示:无论是常规整数序列、小规模序列,还是包含重复元素的序列,均已严格按照升序规则完成排列,且重复元素的先后次序未受破坏。只需记住“外层总轮数减一、内层比对边界减一再减当前轮数、相邻逆序直接互换”这三条规律,便能随时写出规范正确的冒泡排序代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















