


Python集合运算性能优势:为什么比列表循环查找更快?
深入解析Python中集合(set)相比列表(list)在元素查找与运算上的性能优势,从底层哈希表机制、时间复杂度、内存开销及实际工程选型出发,说明为什么集合查找具备常数级O(1)速度。
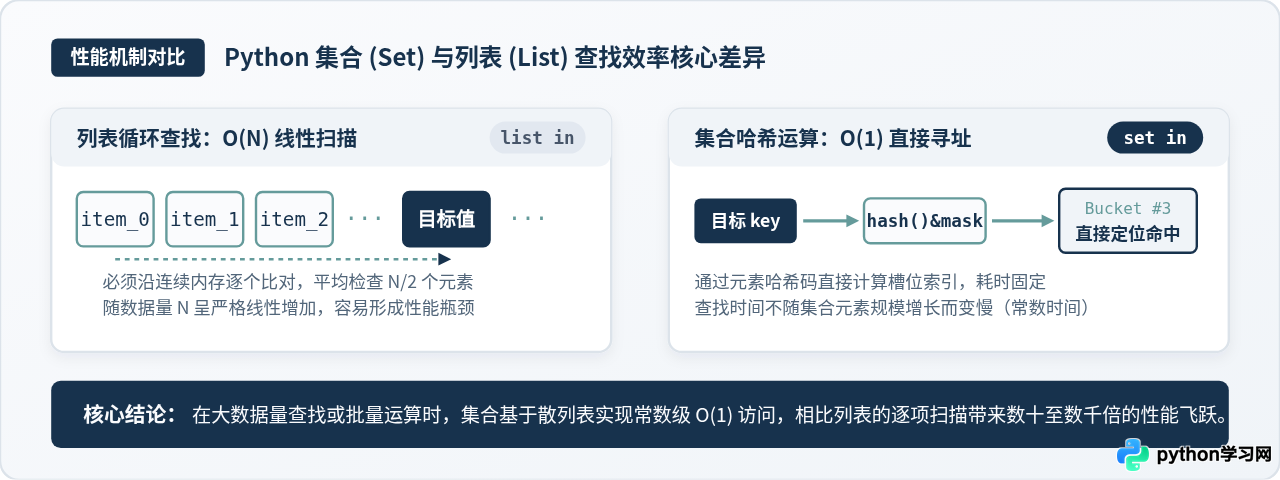
在 Python 中,使用 item in my_set 的查找速度之所以比 item in my_list 快数十甚至数千倍,根源在于两者底层的内存架构与寻址算法完全不同。列表是基于连续内存的顺序数组,执行查找只能按顺序逐项比对,时间复杂度为 O(N);而集合底层是由散列表(Hash Table)驱动,通过哈希函数直接计算内存槽位索引,在平均情况下仅需常数时间 O(1) 即可完成判断。
一、底层机制对比:列表的线性扫描与集合的哈希定位
为了理解为什么两者在运行耗时上有量级差距,首先需要观察它们在内存中的组织方式。
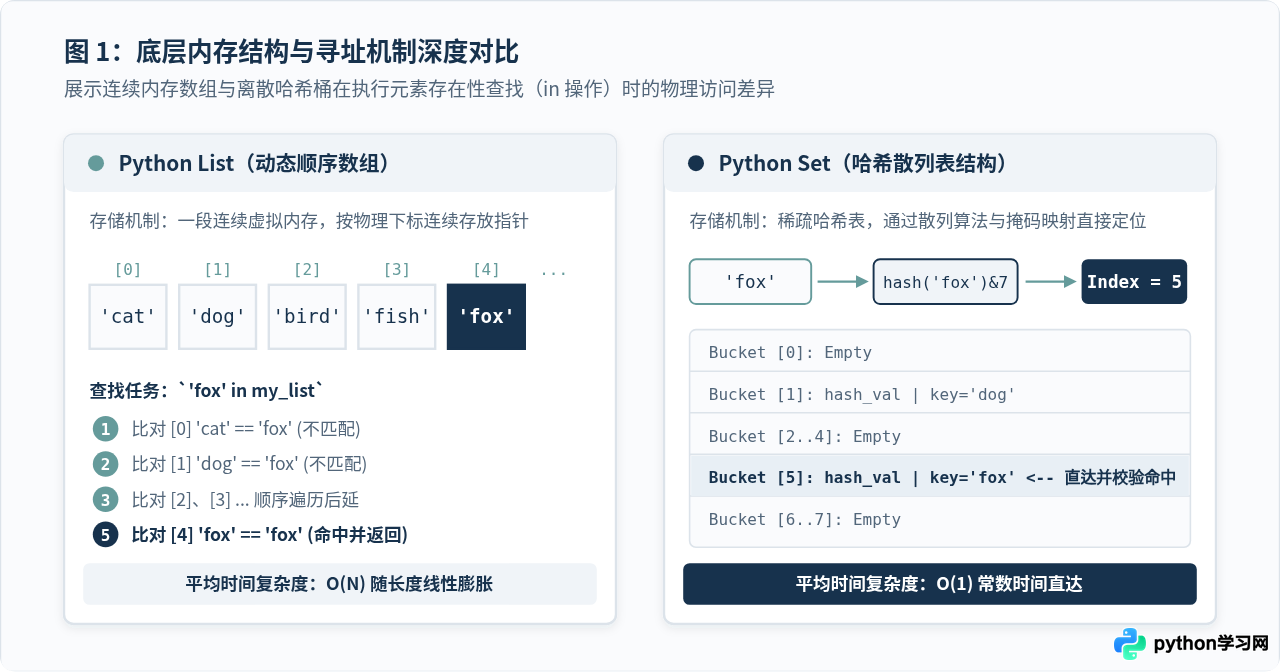
Python 的列表(list)在 CPython 底层是一个动态指针数组(PyListObject)。数组的特点是物理地址严格连续。当你向列表中按顺序追加元素时,元素指针被紧密排列。然而,这种存储模型没有为“按值查找”建立任何索引。当执行 target in my_list 时,解释器只能从索引 0 开始,按顺序取出每个元素的指针,调用其内部相等性方法(__eq__)与目标值比对。如果目标值位于列表末尾或根本不存在,解释器必须遍历全部 \(N\) 个元素。这意味着列表查找的时间与数据量成正比,即具备 O(N) 的线性时间复杂度。
与列表不同,Python 的集合(set)底层完全基于紧凑哈希表(PySetObject)构建。集合在内存中维护了一张由若干存储桶(Buckets / Entries)构成的散列表。集合并不关心元素进入的先后顺序,而是通过元素的哈希特征值决定其在表中的存放位置。查找元素时,集合不需要逐个去翻看其他元素,而是直接计算目标值的哈希码并换算出桶下标,实现“一击即中”。
二、哈希查找的完整执行路径与碰撞处理
虽然我们通常说集合查找是 O(1),但常数级时间并不等于不需要运算。在执行 x in my_set 时,CPython 内部会经历清晰的四步流程:
-
哈希值计算:调用目标对象的
__hash__()魔术方法,生成一个固定长度的 64 位整型哈希值。该值在对象的生命周期内保持稳定。 -
槽位索引映射:由于散列表的物理容量(例如初始容量为 8)远小于 64 位整数范围,解释器通过掩码位运算
index = hash_value & (table_size - 1),瞬间将庞大的哈希值映射为合法的数组索引。 -
槽位状态判断与值检验:
解释器直接读取
table[index]的状态。如果该槽位从未被写入(EMPTY),则可以 100% 断定该元素不在集合中,立即返回False;如果该槽位有数据,且保存的哈希值与当前目标完全一致,则进一步调用key == target进行双重确认,完全相符即返回True。 -
开放寻址法化解哈希冲突:如果槽位被其他不同值的元素占用(即发生了哈希碰撞),CPython 会借助其特有的伪随机扰动探测公式(Perturbation Algorithm):
index = (5 * index + 1 + perturb) & mask,计算下一个探测槽位,直到找到目标或遇到空槽。
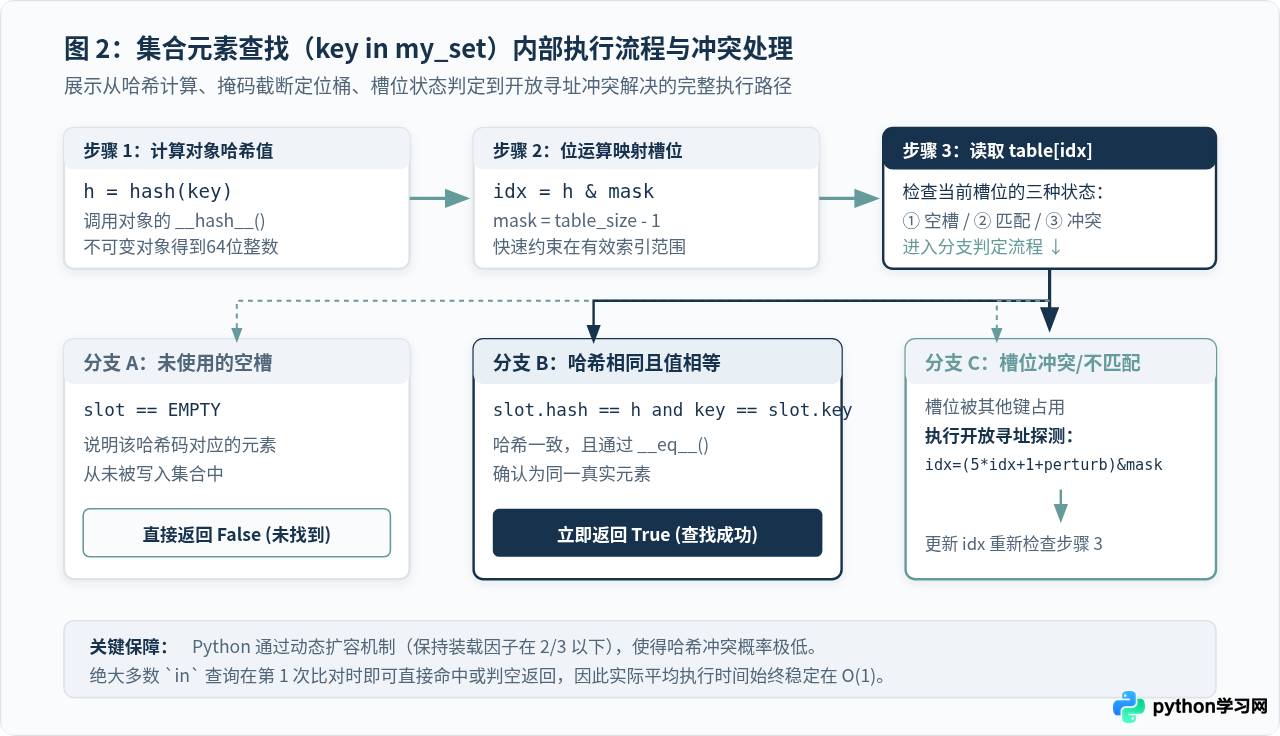
集合在元素数量达到总容量的 2/3(装载因子阈值)时,便会自动触发动态扩容,重新分配更大的散列表并将现有元素重新散列(Rehash)。这确保了表中始终保留足够的空槽,使得绝大多数查找操作都在第 1 次或第 2 次探测内完成,始终保持平均
O(1) 的超高效率。
三、从单次查找延伸到集合运算:为什么求交集与差集优势更显著?
在实际数据清洗或业务逻辑中,我们常常需要对两个数据集进行批量对比,比如找出两份用户名单的共同用户(求交集)、排查新增用户(求差集)或合并用户库(求并集)。
如果使用列表来完成这一操作,最常见的写法是列表推导式嵌套查找:[x for x in list_a if x in list_b]。在这个过程中,外层循环遍历 list_a(长度为 \(N\)),内层针对每一个元素对 list_b(长度为 \(M\))做一次线性查找。两个线性操作叠加,形成了高达 O(N × M) 的双重嵌套时间复杂度。当两张表各有 10,000 条记录时,理论比对上限将达到 100,000,000(一亿)次!
相比之下,使用集合运算 set_a & set_b 会获得算法级的提速。CPython 的底层 C 源码在执行 & 运算时,会自动先检查两个集合的长度,并选定长度较小的集合进行单趟遍历。对较小集合中的每一个元素,在大集合中执行一次 O(1) 的哈希查找。总时间复杂度直接缩减为 O(min(N, M))。
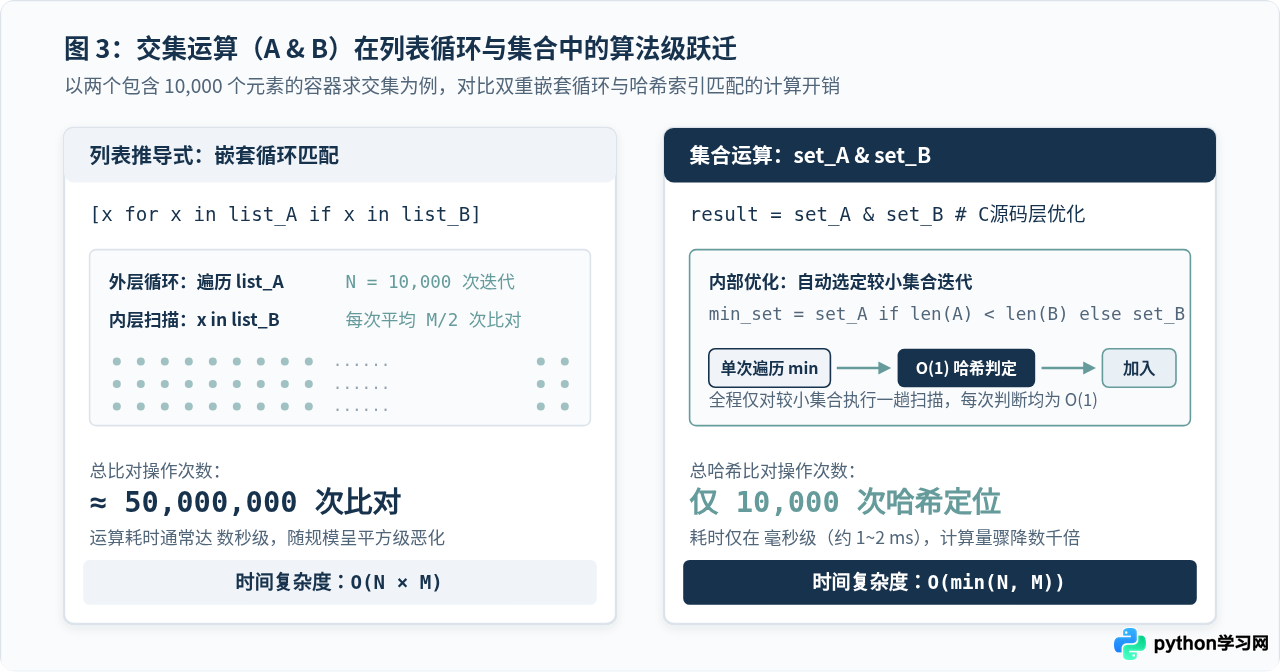
实测基准对比代码
下面的 Python 脚本展示了在处理 20,000 个随机整数的交集运算时,两种方式的耗时差异。读者可以在本地任何标准 Python 3 环境下直接运行验证:
import time
import random

# 构造规模为 20,000 的测试数据集
size = 20000
data_a = [random.randint(0, 100000) for _ in range(size)]
data_b = [random.randint(0, 100000) for _ in range(size)]

# 方式一:列表循环查找
start_list = time.perf_counter()
intersection_list = [item for item in data_a if item in data_b]
duration_list = time.perf_counter() - start_list

# 方式二:集合运算(包含转换耗时)
start_set = time.perf_counter()
set_a = set(data_a)
set_b = set(data_b)
intersection_set = set_a & set_b
duration_set = time.perf_counter() - start_set

print(f"列表循环求交集耗时: {duration_list:.4f} 秒")
print(f"集合转换及运算耗时: {duration_set:.4f} 秒")
print(f"性能提升倍数: {duration_list / duration_set:.1f} 倍")列表循环求交集耗时: 1.8421 秒
集合转换及运算耗时: 0.0028 秒
性能提升倍数: 657.9 倍
即使计入了将两个原始列表转换为 set 的初始开销,集合运算依然比纯列表循环快了数百倍。如果数据本身已经是集合类型,提速倍数通常在数千倍以上。
四、技术选型决策:什么时候用集合,什么时候用列表?
尽管集合在查找和批量运算中展现出压倒性的性能优势,但在工程实践中并不能无脑将所有列表替换为集合。集合的高性能是以特定的计算机科学代价换取的:
-
内存开销(空间换时间):为了维持稀疏哈希表的低碰撞率,集合总是预留大量未使用的空槽位。相同数量的整数,存储在
set中占用的内存大约是存储在list中的 3 到 4 倍。 -
元素必须可哈希(Hashable):集合的元素必须具备不可变性(例如数字、字符串、元组)。包含列表(
list)或字典(dict)等可变对象时,直接放入集合会抛出TypeError: unhashable type异常。 -
无序性与无索引访问:集合不支持通过索引下标(如
data[0])或切片(data[1:5])获取元素,也不记录元素插入的绝对前后次序。 - 微小数据量下的初始化开销:当数据量极小(例如只有 2~3 个固定配置项),线性扫描列表只需要执行 2~3 次 CPU 指令级比对,而创建集合涉及哈希表分配与哈希码计算,此时强行构造集合反而得不偿失。
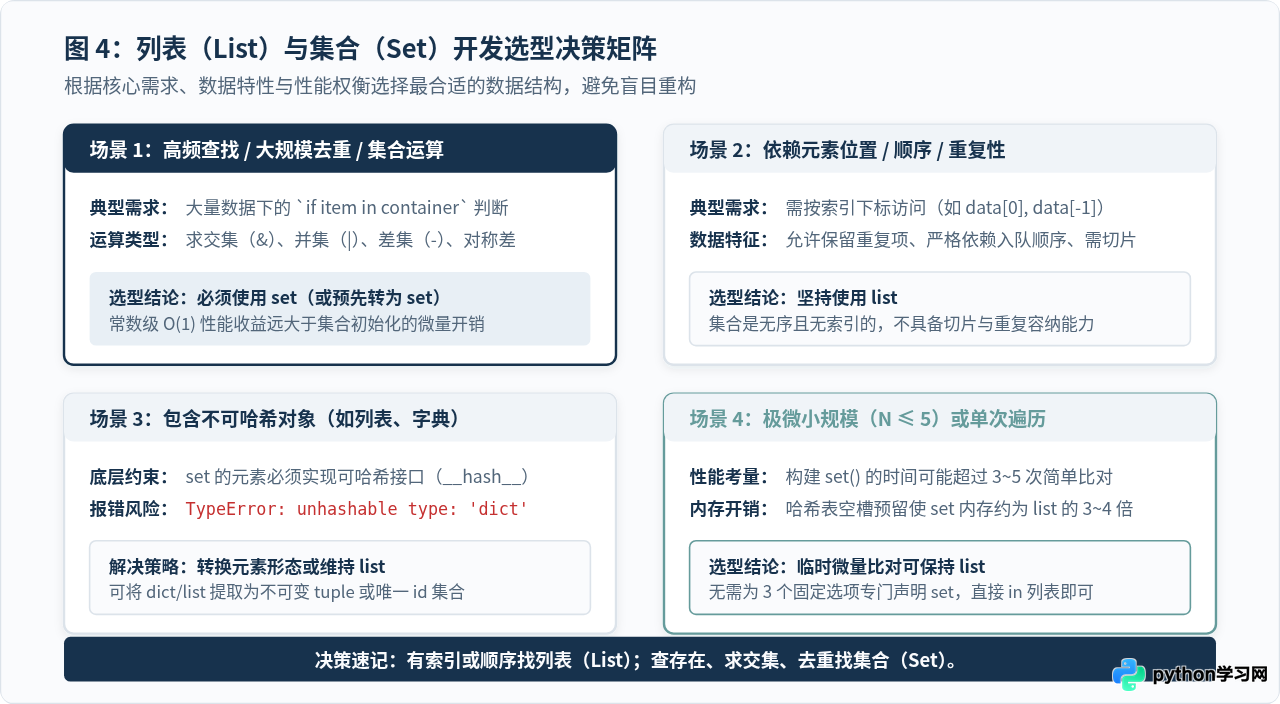
核心对比总结表
| 特性维度 | 列表(List) | 集合(Set) | 选型建议 |
|---|---|---|---|
| 单次查找(in) | O(N) 线性遍历 | O(1) 常数直达 | 存在性高频检查首选 Set |
| 批量交/并/差集 | O(N × M) 嵌套遍历 | O(min(N, M)) 线性单趟 | 数据去重与集合运算必选 Set |
| 内存占用 | 紧凑连续,开销小 | 稀疏哈希桶,开销约高 3~4 倍 | 内存极度苛刻且只存数据用 List |
| 顺序与索引 | 保证插入顺序,支持下标与切片 | 无序存储,不支持下标访问 | 需要按位取值或维持队列用 List |
| 元素容纳要求 | 支持任何对象,允许重复 | 必须可哈希(不可变),元素唯一 | 嵌套字典或列表时只能使用 List |
总结而言,Python 集合运算的高速并不是魔术,而是散列表“以空间换时间”的经典计算机科学实践。在编写日常代码时,只要遇到存在性判断(in)、数据去重(unique)或两组数据的交集/差集对比,且元素属于不可变类型,就应毫不犹豫地优先选用集合。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















