


怎么用python-mprofile给程序做性能分析?
详细介绍如何使用 python -m profile 对 Python 脚本进行命令行与代码级性能分析,包含输出字段解读、排序参数、结果保存与 pstats 筛选、开销校准及 cProfile 对比。
在命令行提到的“python-mprofile”,规范写法是在 python 与 -m、profile 之间各留一个空格,即 python -m profile 脚本路径。它是 Python 标准库自带的确定性性能分析命令,不需要安装第三方包,也不用修改业务代码,就能统计程序运行期间每个函数的调用次数、内部纯耗时和包含子函数的累计耗时,从而快速定位拖慢程序的瓶颈函数。
一、准备示例脚本并执行首次分析
要使用 python -m profile,只需要具备标准 Python 3 环境。为了直观展示分析过程,先在工作目录下创建一个名为 order_calc.py 的示例脚本。该脚本模拟订单价格汇总与字符串格式化两个步骤,故意设置不同的耗时结构以便观察分析报告。
# 文件名:order_calc.py
import math

def compute_discount(price):
    # 模拟密集数值计算
    total = 0.0
    for i in range(1, 200):
        total += math.sqrt(price * i) / (i + 1)
    return total

def format_record(order_id, value):
    return f"ORDER-{order_id:05d}: {value:.2f}"

def process_orders(count):
    records = []
    for idx in range(count):
        discounted = compute_discount(idx + 100)
        records.append(format_record(idx, discounted))
    return len(records)

if __name__ == "__main__":
    processed = process_orders(1500)
    print(f"已完成订单处理数量: {processed}")
打开终端并进入 order_calc.py 所在目录,执行以下命令启动性能分析:
python -m profile order_calc.pypython-mprofile 或 python -mprofile(部分旧版本环境不支持省略空格),终端会提示找不到命令或参数错误。正确格式始终是 python -m profile,其中 -m 表示以脚本方式运行标准库中的 profile 模块。
已完成订单处理数量: 1500
         303006 function calls in 0.612 seconds

   Ordered by: standard name

   ncalls  tottime  percall  cumtime  percall filename:lineno(function)
        1    0.000    0.000    0.612    0.612 order_calc.py:1(<module>)
     1500    0.005    0.000    0.005    0.000 order_calc.py:11(format_record)
        1    0.009    0.009    0.612    0.612 order_calc.py:14(process_orders)
     1500    0.348    0.000    0.598    0.000 order_calc.py:4(compute_discount)
   298500    0.250    0.000    0.250    0.000 :0(sqrt)
     1500    0.000    0.000    0.000    0.000 :0(append)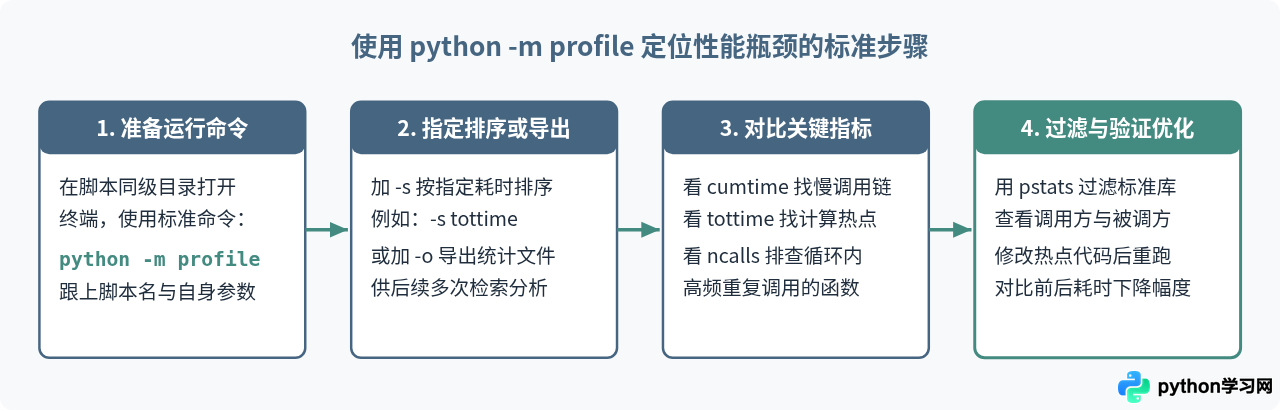
二、读懂性能报告中的 6 个核心字段
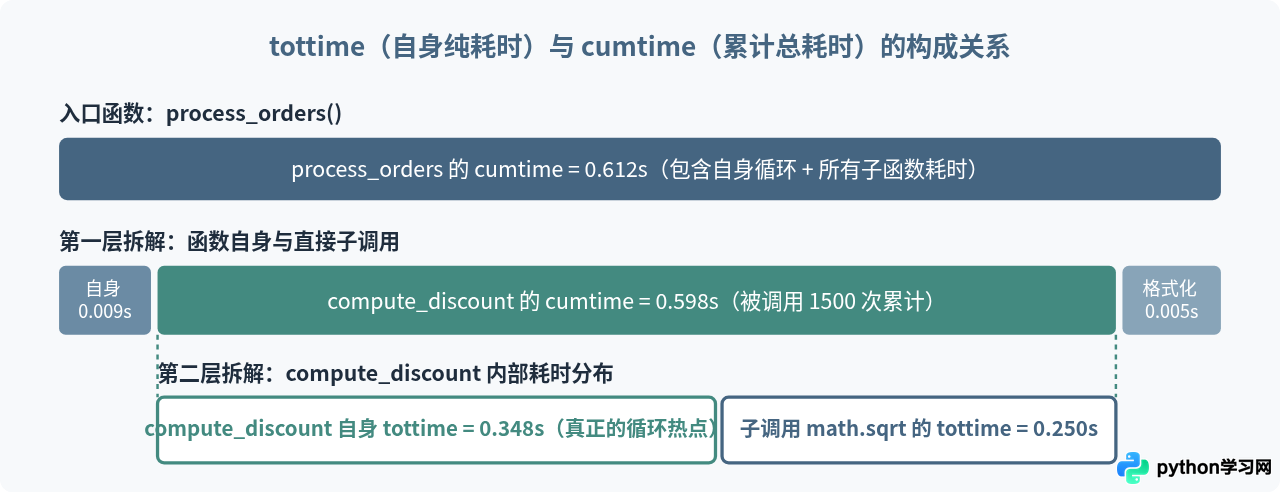
看到终端打印的表格后,最关键的是区分 tottime(内部纯耗时)与 cumtime(累计总耗时)。很多初次接触性能分析的读者会把两者混淆,导致找错优化目标。下面结合上文的示例输出逐列说明:
ncalls(调用次数):函数被调用的总次数。如果出现类似150/1的分式写法,前半部分表示总调用次数(150 次),后半部分表示去除递归后的原始调用次数(1 次)。在示例输出中,sqrt被调用了 298500 次,一眼就能看出它处于多层循环内部。tottime(函数内部纯耗时):函数自身代码执行所花费的时间(单位:秒),不包含该函数内部调用其他子函数所花的时间。如果某个函数的tottime很高,说明慢在该函数本身的循环或运算逻辑。示例中compute_discount的tottime为 0.348 秒,占了总耗时的最大比例。percall(紧跟 tottime 后):等于tottime / ncalls,即单次执行该函数自身逻辑的平均耗时。cumtime(累计耗时):从进入该函数到退出该函数所经历的总时间,包含它调用的所有子函数的耗时。示例中process_orders自身的tottime只有 0.009 秒,但cumtime达到 0.612 秒,因为它把时间都花在了调用子函数compute_discount上。percall(紧跟 cumtime 后):等于cumtime / 原始调用次数,反映每次完整调用该入口的平均总耗时。filename:lineno(function):函数所在的文件名、行号及函数名称。如果是 C 语言实现的内置函数(如:0(sqrt)),行号会显示为0。
三、使用命令行参数排序与保存分析结果
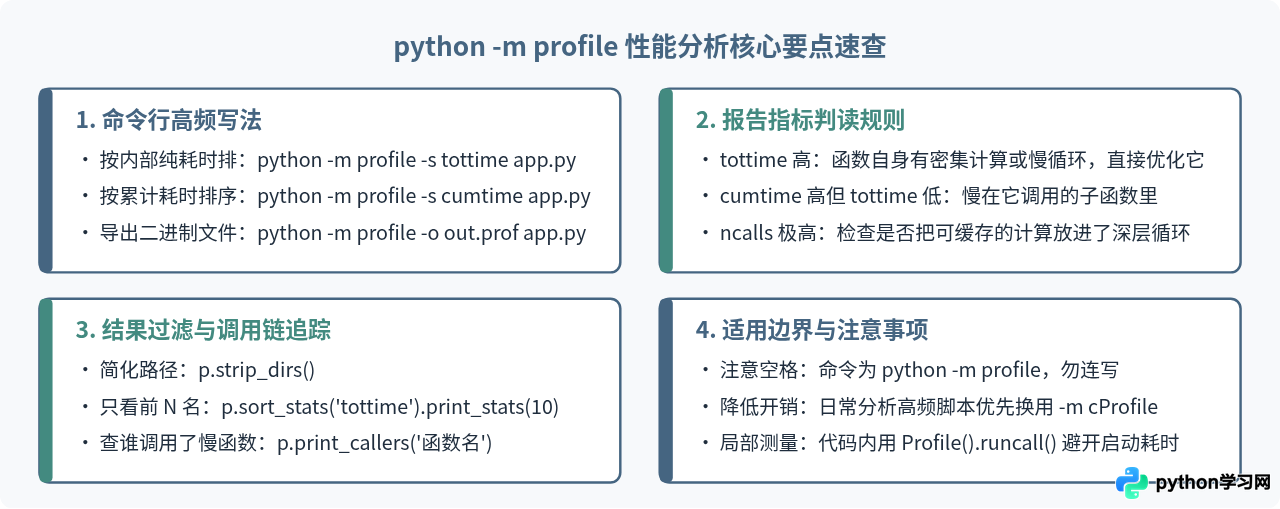
默认情况下,python -m profile 会按照 standard name(文件名与行号字母序)排列输出。当真实项目包含上百个函数时,默认排序很难一眼看到最慢的函数。此时可以通过 -s 参数指定排序字段,或用 -o 参数把结果保存到文件。
1. 用 -s 参数按耗时高低排序
要在终端直接把最耗时的函数排在最前面,最常用的是按内部纯耗时(tottime)或累计耗时(cumtime)排序:
# 按函数自身纯耗时(tottime)从高到低排序,直接揪出计算热点
python -m profile -s tottime order_calc.py

# 按包含子函数的累计耗时(cumtime)从高到低排序,理清慢在哪个主流程
python -m profile -s cumtime order_calc.py

# 按函数被调用次数(calls)从高到低排序,排查高频重复调用
python -m profile -s calls order_calc.py
2. 给被测脚本自身传递命令行参数
如果被分析的 Python 脚本本身需要接收命令行参数(例如 order_calc.py --count 5000),只需把 profile 自身的参数写在脚本名之前,把脚本的参数写在脚本名之后:
python -m profile -s tottime order_calc.py --count 50003. 用 -o 参数保存报告并用 pstats 筛选
如果终端输出太长,或者希望只查看前 10 个最慢的函数并过滤掉系统内置函数,可以使用 -o 参数将分析数据保存为二进制统计文件(例如 result.prof),再用标准库自带的 pstats 模块读取:
python -m profile -o result.prof order_calc.py执行上述命令后,终端只会打印脚本自身的输出(已完成订单处理数量: 1500),性能数据已写入当前目录的 result.prof。接着可以编写一段简短的分析代码,或直接在终端运行单行命令查看前 5 名热点函数:
python -c "import pstats; p = pstats.Stats('result.prof'); p.strip_dirs().sort_stats('tottime').print_stats(5)"Tue Nov 10 17:30:12 2026 result.prof
303006 function calls in 0.608 seconds
Ordered by: internal time
List reduced from 42 to 5 due to restriction <5>
ncalls tottime percall cumtime percall filename:lineno(function)
1500 0.345 0.000 0.594 0.000 order_calc.py:4(compute_discount)
298500 0.249 0.000 0.249 0.000 :0(sqrt)
1 0.009 0.009 0.608 0.608 order_calc.py:14(process_orders)
1500 0.005 0.000 0.005 0.000 order_calc.py:11(format_record)
1500 0.000 0.000 0.000 0.000 :0(append)其中 strip_dirs() 用于去掉冗长的文件夹绝对路径,sort_stats('tottime') 按内部纯耗时排序,print_stats(5) 限制只输出前 5 行。如果只想看 order_calc.py 文件里的函数,可以传入正则过滤参数:print_stats('order_calc', 10);如果想查看是谁调用了慢函数,可以把最后的 print_stats(5) 换成 print_callers(5)。
四、在代码内部只分析特定函数
当程序包含漫长的初始化过程(如加载大型配置文件、建立数据库连接),而你只想分析某个特定函数的性能时,用命令行跑整个脚本会混入大量启动阶段的数据。此时可以在代码中直接导入 profile 模块,使用 profile.Profile() 只包裹需要测量的代码段:
import profile
from order_calc import process_orders

profiler = profile.Profile()
# 仅对 process_orders(1500) 的执行过程进行采样统计
profiler.runcall(process_orders, 1500)
profiler.print_stats(sort="tottime")
profiler.runcall(func, *args, **kwargs) 会直接执行目标函数并记录耗时,不会把模块导入或前置准备工作的耗时算进去,定位局部函数问题更加精准。
五、关键细节:理解 profile 的测量开销与校准
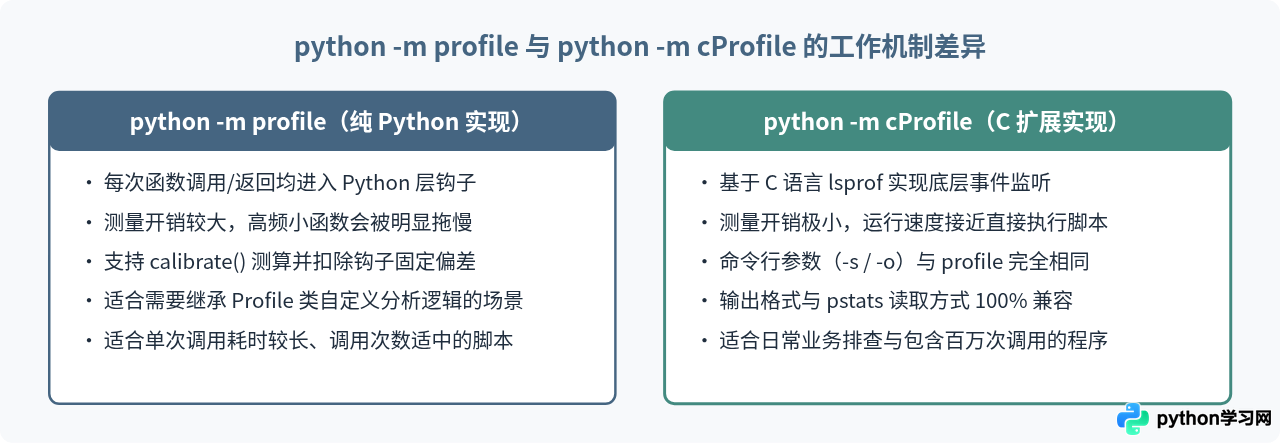
在使用 python -m profile 时,有一个必须了解的特性:profile 模块是用纯 Python 编写的。它在每次函数调用和返回时都会触发 Python 层的事件钩子,因此分析器自身会带来明显的性能开销(通常会让程序变慢数倍)。
1. 什么时候直接使用 cProfile 替代?
Python 标准库同时提供了 C 语言实现的 cProfile 模块,它的命令行参数(-s、-o)和输出格式与 profile 完全一致,但运行开销小得多。如果你不需要通过子类化修改分析器行为,在日常排查中可以直接把命令中的 profile 替换为 cProfile:
python -m cProfile -s tottime order_calc.py同样运行上面的 order_calc.py,python -m profile 总耗时约为 0.61 秒,而 python -m cProfile 总耗时通常只需 0.08 秒左右,且能更准确地反映高频内置函数(如 math.sqrt)与业务函数的真实耗时比例。
2. 必须使用 profile 时如何做偏差校准(Calibration)
如果你确实需要使用纯 Python 的 profile 模块(例如在不支持 cProfile 的特殊解释器环境,或重写了 Profile 子类),可以通过 calibrate() 方法测算当前机器的单次事件开销,并将其写入 Profile.bias,从而在统计结果中自动扣除这部分固定误差:
import profile

pr = profile.Profile()
# 连续执行 5 次 10000 步校准,取最小偏差值作为全局补偿
bias = min(pr.calibrate(10000) for _ in range(5))
profile.Profile.bias = bias

# 校准后再运行目标函数,tottime 和 cumtime 会自动减去分析器自身开销
pr.run("import order_calc; order_calc.process_orders(1500)")
六、常见疑问与排查建议
| 遇到的现象或需求 | 原因说明 | 直接解决方法 |
|---|---|---|
总耗时很长,但所有业务函数的 tottime 都很低 |
程序可能在等待网络请求、磁盘读写或 time.sleep,此时耗时集中在底层 I/O 调用上 |
改用 -s cumtime 排序,沿着 cumtime 最高的调用链向下查找阻塞在哪个系统调用 |
| 只能看到哪个函数慢,看不到慢在函数内的哪一行代码 | profile 和 cProfile 都是函数级分析器,只监听函数进入和退出事件,不逐行计时 |
先用 python -m profile 锁定慢函数;如果该函数长达上百行,将其拆分为几个子函数再次测量,或配合逐行分析工具检查该函数 |
| 多线程程序运行后,只统计到了主线程的函数耗时 | profile 默认只在启动它的当前线程注册钩子,不会自动跨线程收集数据 |
在子线程的入口函数内部单独实例化 profile.Profile(),各自保存为独立的 .prof 文件后,用 pstats.Stats('a.prof', 'b.prof') 合并查看 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















