


Python类初始化报错AttributeError怎么解决
针对Python在类实例化或__init__初始化阶段抛出AttributeError的问题,从底层机制、排查路径、四大核心诱因及修复代码提供完整详尽的排查指南。
AttributeError 通常意味着程序在对象尚未完成属性绑定时,就尝试读取了该属性。解决该问题的核心路径是:先定位堆栈指示的报错行,检查属性是否在当前对象或其父类中声明;确认 __init__ 方法名称拼写无误;梳理赋值语句与方法调用顺序,确保“先赋值、后调用”;以及排查继承链中是否正确执行了 super().__init__()。本文将从异常表现入手,按逻辑顺序剖析排查流程与四大常见诱因,并给出针对性的代码修复与防护方案。
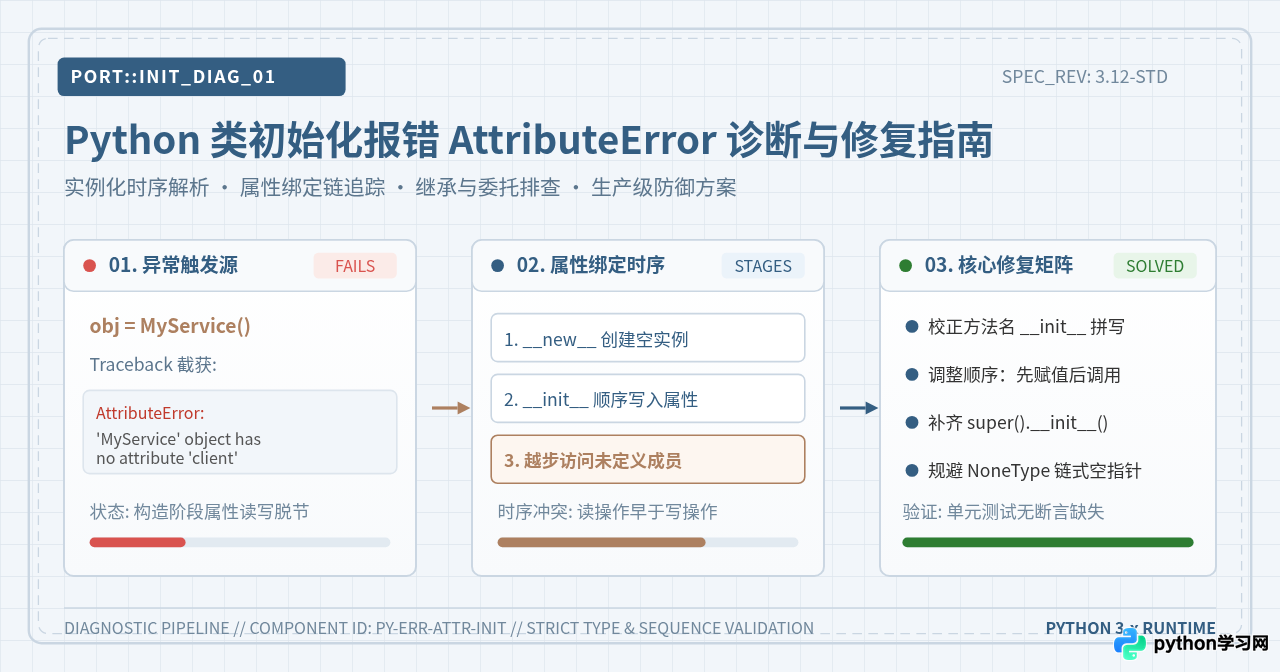
一、初始化异常的具体表现与核心机制
在 Python 运行环境中,通过类实例化对象(例如 instance = MyService())会先后触发内置方法 __new__ 和 __init__。其中,__new__ 负责向操作系统申请内存并创建原始对象,而 __init__ 负责接收参数并对该对象执行属性绑定。
当初始化过程出现纰漏时,解释器通常会打印如下形式的异常调用栈(Traceback):
Traceback (most recent call last):
  File "service.py", line 28, in <module>
    app = DataPipeline(source="api")
  File "service.py", line 12, in __init__
    self.setup_connection()
  File "service.py", line 18, in setup_connection
    print(f"Connecting to {self.endpoint}")
AttributeError: 'DataPipeline' object has no attribute 'endpoint'
这个报错揭示了问题的本质:在第 18 行代码访问 self.endpoint 时,Python 解释器在当前实例的底层属性字典 __dict__ 以及类属性空间中均未查找到 endpoint 这个键名。这种缺失并非不可预测的系统故障,而是代码执行时序或名称定义产生了断层。
二、结构化排查定位流程
排查类初始化阶段的 AttributeError 时,应遵循由浅入深、自外向内的决策链条,切忌盲目乱改代码。下图展示了完整的排查决策流:
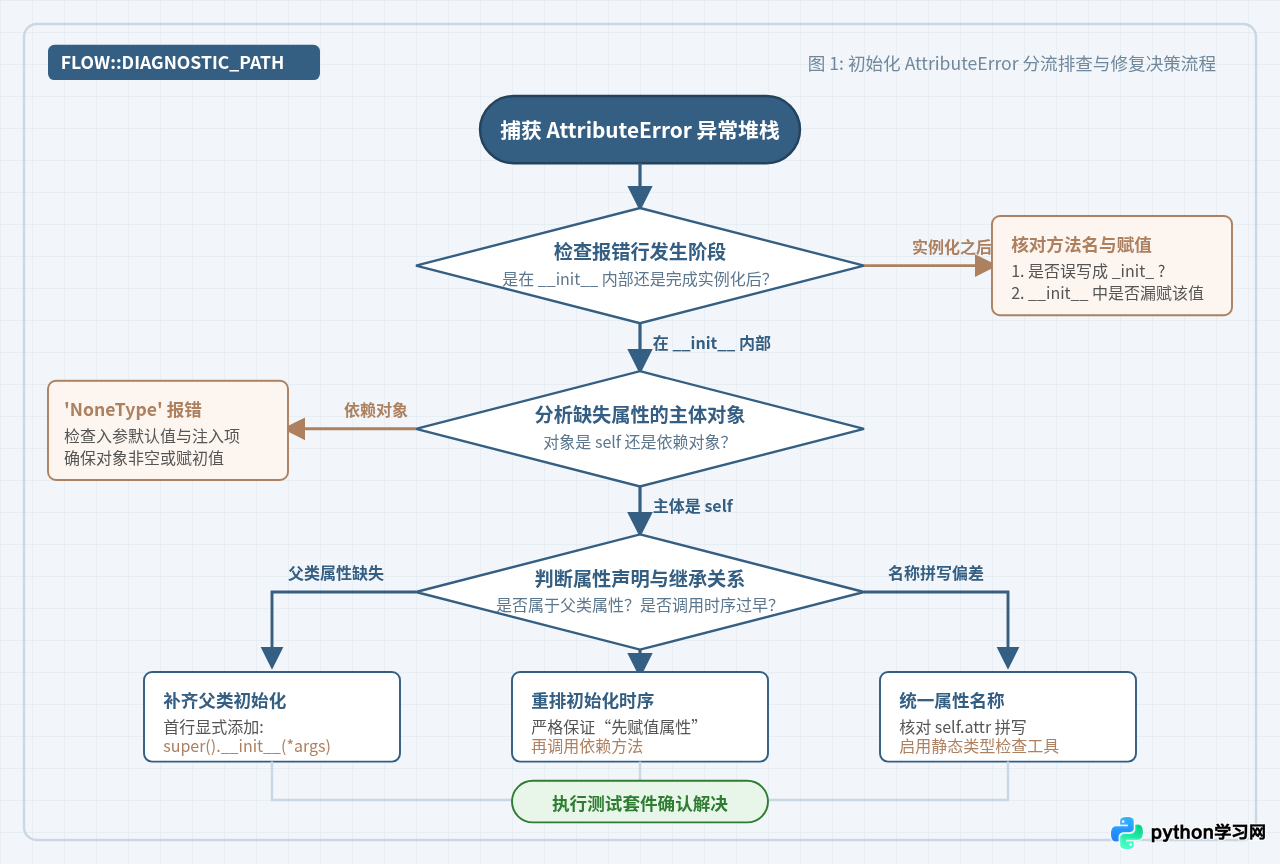
排查的具体操作分为四个步骤:
- 定位报错位置:观察 Traceback 的最底部一行。若报错出现在
__init__内部调用的函数中,说明初始化尚未收尾;若报错出现在obj = MyClass()之后的外部业务逻辑行,则重点检查构造函数是否遗漏了赋值。 - 鉴别主体对象类型:检查报错信息中引号包裹的对象类型。如果提示
'NoneType' object has no attribute 'xxx',说明问题不在当前类的self,而是某个入参或外部依赖对象返回了None。 - 验证方法名拼写:核对类中构造函数的书写,确认首尾各有两个下划线,避免写成
_init_或__int__。 - 核对继承链路:若当前类继承了其他基类,且报错属性属于基类,检查子类
__init__首部是否显式调用了super().__init__()。
三、实例化运行原理与属性生命周期
为了从根本上避免属性读取失败,必须理解 Python 实例在堆内存中的构造过程。实例化并非瞬时完成的原子操作,而是一条有明确先后次序的管道。
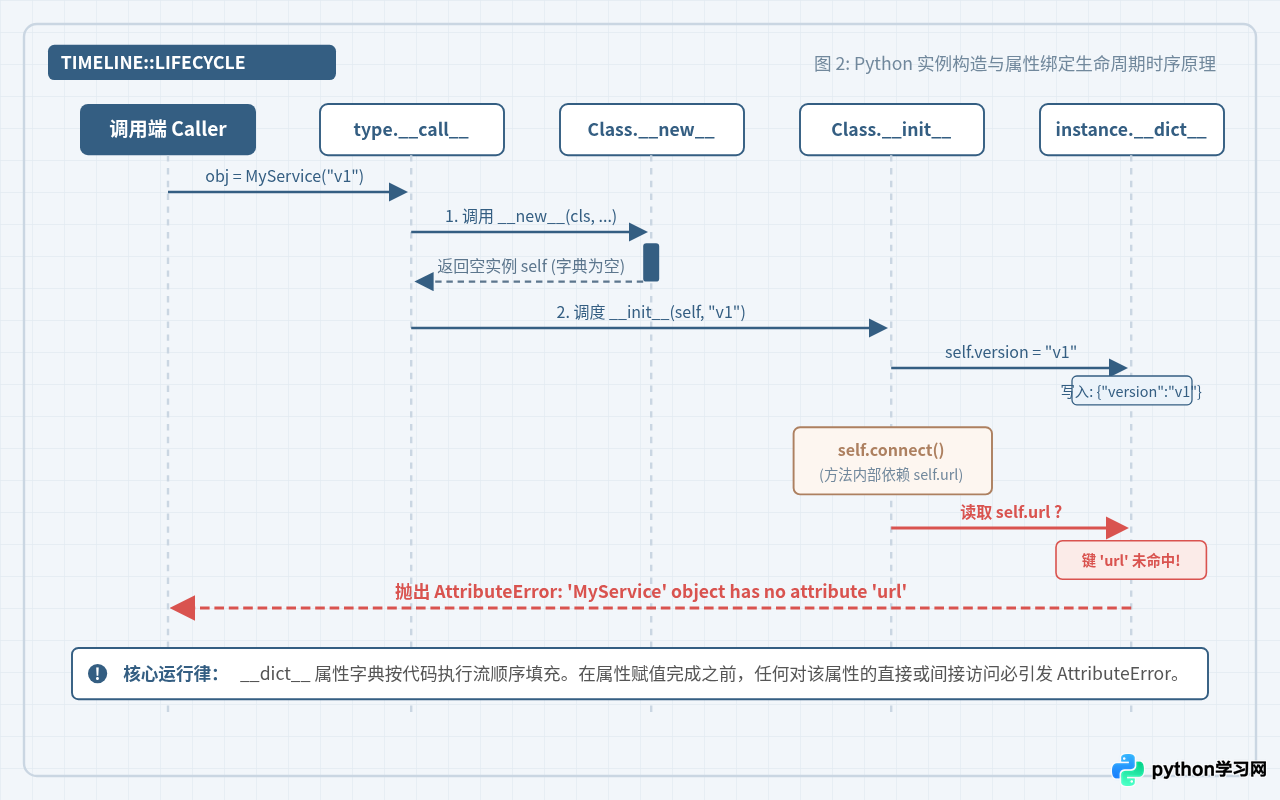
从图 2 可以清晰看出,__new__ 分配出的裸对象一开始仅仅包含一个空的 __dict__ 容器。随后 __init__ 中的代码按照从上到下的顺序逐行执行。如果在 self.attr = val 执行之前,通过内部方法或外部回调访问了该属性,解释器就会在 __dict__ 中查找失败,立即中断后续流程并抛出 AttributeError。
四、四大典型高频诱因与代码修复方案
在实际开发过程中,类初始化阶段的 AttributeError 绝大多数由以下四种代码编写缺陷引起。通过针对性的代码对比,可以直观掌握正确的修复方式。
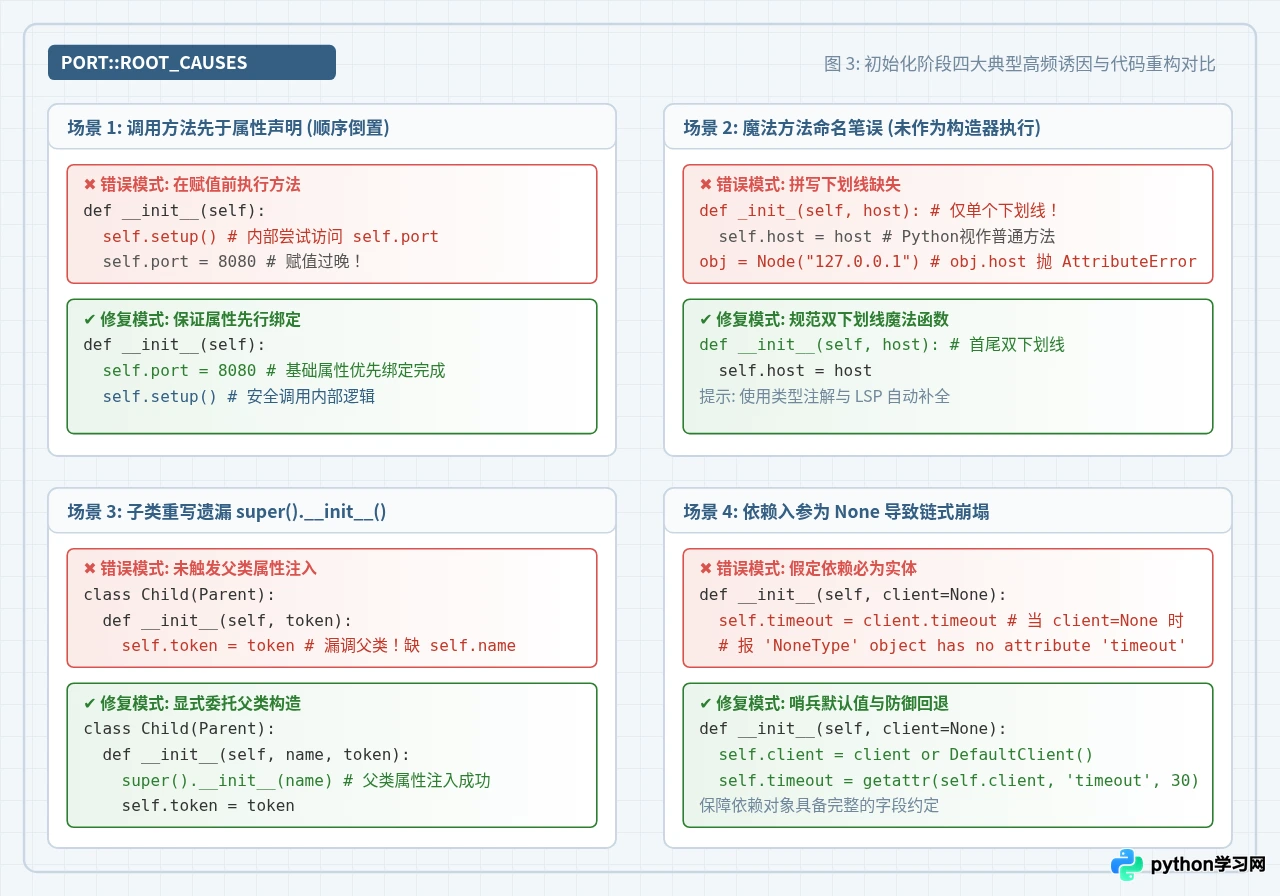
1. 诱因一:方法调用早于属性声明(时序颠倒)
许多开发者习惯在 __init__ 中调用内部辅助方法(如 self.init_db()、self.prepare())。如果该辅助方法依赖某个属性,而该属性被写在了辅助方法调用之后,就会直接引发异常。
错误示范:
class DatabaseManager:
    def __init__(self, host: str, port: int):
        # 错误:在属性赋值前调用了内部依赖方法
        self.connect()
        self.host = host
        self.port = port

    def connect(self):
        # 此时 self.host 尚未绑定,抛出 AttributeError
print(f"Connecting to {self.host}:{self.port}")修复方案:将所有基础属性的绑定置于 __init__ 的最前部,确保辅助方法执行时所需上下文已全部就绪。
class DatabaseManager:
    def __init__(self, host: str, port: int):
        # 正确:先完成全部基础属性绑定
        self.host = host
        self.port = port
        # 后执行依赖逻辑
        self.connect()

    def connect(self):
        print(f"Connecting to {self.host}:{self.port}")
2. 诱因二:构造器或属性名拼写笔误
Python 对魔法方法有严格的命名约定。常见的笔误包括将 __init__ 误写为单下划线的 _init_,或者手滑写成 __int__。在这些情况下,Python 解释器不会报错,而是将其视为一个普通的自定义成员方法。当执行 obj = MyClass() 时,Python 默认调用基类 object 的空构造函数,开发者写在假构造函数中的所有属性绑定代码全部被跳过。
错误示范:
class ApiClient:
    # 错误:少写了下划线,解释器不将其作为构造器调度
    def _init_(self, token: str):
        self.token = token

client = ApiClient("secret-token-123")
# AttributeError: 'ApiClient' object has no attribute 'token'
print(client.token)修复方案:核实方法名并修正为标准的双下划线格式,同时建议使用现代 IDE(如 VS Code 或 PyCharm)的代码补全功能。
class ApiClient:
    # 正确:规范的双下划线魔法方法
    def __init__(self, token: str):
        self.token = token

client = ApiClient("secret-token-123")
print(client.token)  # 正常输出: secret-token-123
3. 诱因三:子类重写继承时遗漏 super().__init__()
面向对象开发中,子类如果重写了 __init__,Python 不会自动向上执行父类的构造方法。如果子类没有显式调用 super().__init__(),父类中声明的所有实例属性均不会被注入到当前子类实例中。
错误示范:
class BaseWorker:
    def __init__(self, worker_id: str):
        self.worker_id = worker_id
        self.is_active = True

class AsyncWorker(BaseWorker):
    def __init__(self, worker_id: str, concurrency: int):
        # 错误:未调用 super().__init__(worker_id)
        self.concurrency = concurrency

worker = AsyncWorker("w-01", 4)
# AttributeError: 'AsyncWorker' object has no attribute 'is_active'
print(worker.is_active)修复方案:在子类 __init__ 的第一行显式使用 super() 将参数传递给父类构造函数。
class AsyncWorker(BaseWorker):
    def __init__(self, worker_id: str, concurrency: int):
        # 正确:首行委托父类完成基础环境初始化
        super().__init__(worker_id)
        self.concurrency = concurrency

worker = AsyncWorker("w-01", 4)
print(worker.is_active) # 正常输出: Truesuper().__init__() 而是硬编码 BaseWorker.__init__(self, ...),可能会导致方法解析顺序(MRO)断裂或重复初始化。统一使用无参的 super().__init__(...) 是现代 Python 3 的标准实践。
4. 诱因四:依赖对象为 NoneType 引发链式报错
在依赖注入或配置加载场景中,属性往往不是基础类型,而是另一个类实例。若配置项未找到或参数默认传入了 None,在初始化时链式访问下层属性就会抛出 AttributeError: 'NoneType' object has no attribute 'xxx'。
错误示范:
class CacheService:
    def __init__(self, redis_client=None):
        self.client = redis_client
        # 错误:未做判空校验直接访问下层属性
self.max_ttl = self.client.default_ttl # 当 client 为 None 时崩溃!修复方案:结合空值判断、哨兵对象或 getattr 提供默认回退值。
class CacheService:
    def __init__(self, redis_client=None):
        self.client = redis_client
        # 正确:提供默认回退防护或明确校验
        if self.client is not None:
            self.max_ttl = getattr(self.client, 'default_ttl', 3600)
        else:
            self.max_ttl = 3600
五、验证方法与防御性编码实践
修复代码后,应当建立完备的校验与防护机制,防止同类错误在后续迭代中再次发生。
1. 编写单元测试验证边界情况
利用 Python 自带的 unittest 或第三方测试框架 pytest,针对类的不同初始化分支编写用例,特别注意覆盖不传可选参数时的默认场景。
import pytest

def test_worker_initialization():
    # 测试带参初始化
    worker = AsyncWorker(worker_id="t-1", concurrency=2)
    assert hasattr(worker, "worker_id")
    assert hasattr(worker, "is_active")
    assert worker.concurrency == 2

def test_cache_service_none_fallback():
    # 验证传入 None 时的健壮性
    service = CacheService(redis_client=None)
    assert service.max_ttl == 3600
2. 静态分析工具提前拦截
静态类型检查工具可以在代码未运行前就精准捕获属性未声明、拼写错误或类型不匹配问题:
- Mypy / Pyright:在终端执行
mypy your_script.py,若类中引用了未在__init__声明的属性,工具将直接指出行号。 - Ruff / Flake8:捕捉未使用的局部变量与形参,如果误将
self.name = name写成name = name,代码检查器会立即触发警告。
3. 利用 dataclass 消除手动样板代码
在 Python 3.7+ 中,对于以属性存储为主的数据类,推荐使用内置的 dataclasses 模块。装饰器 @dataclass 会在编译期自动生成合规、健壮的 __init__ 方法,从源头上杜绝拼写错误和顺序混乱。
from dataclasses import dataclass

@dataclass
class ServerConfig:
    host: str
    port: int = 8080
    timeout: float = 30.0

# 自动生成严谨的 __init__(self, host: str, port: int = 8080, timeout: float = 30.0)
config = ServerConfig(host="10.0.0.1")
print(config.port)  # 正常输出: 8080
六、总结速查手册
解决 Python 类初始化阶段的 AttributeError,关键在于掌握对象的构建时序与作用域边界。下表整理了高频报错场景与应对措施:
| 异常现象 / 错误堆栈特征 | 底层根本原因 | 标准修复动作 |
|---|---|---|
AttributeError: 'MyClass' has no attribute 'x' (在方法内部) |
内部调用先于属性赋值执行 | 重构 __init__ 内部次序,将属性赋值移至方法调用之前 |
| 实例化后访问任何属性均报不存在 | 构造方法名拼写错误(如 _init_) |
修正为标准双下划线 __init__ |
| 子类无法访问基类属性或方法 | 子类重写构造器时漏调 super() |
在子类 __init__ 首行添加 super().__init__(...) |
'NoneType' object has no attribute 'y' |
外部注入的依赖参数为 None |
增加 None 哨兵分支判定,或配置合理的默认回退实例 |
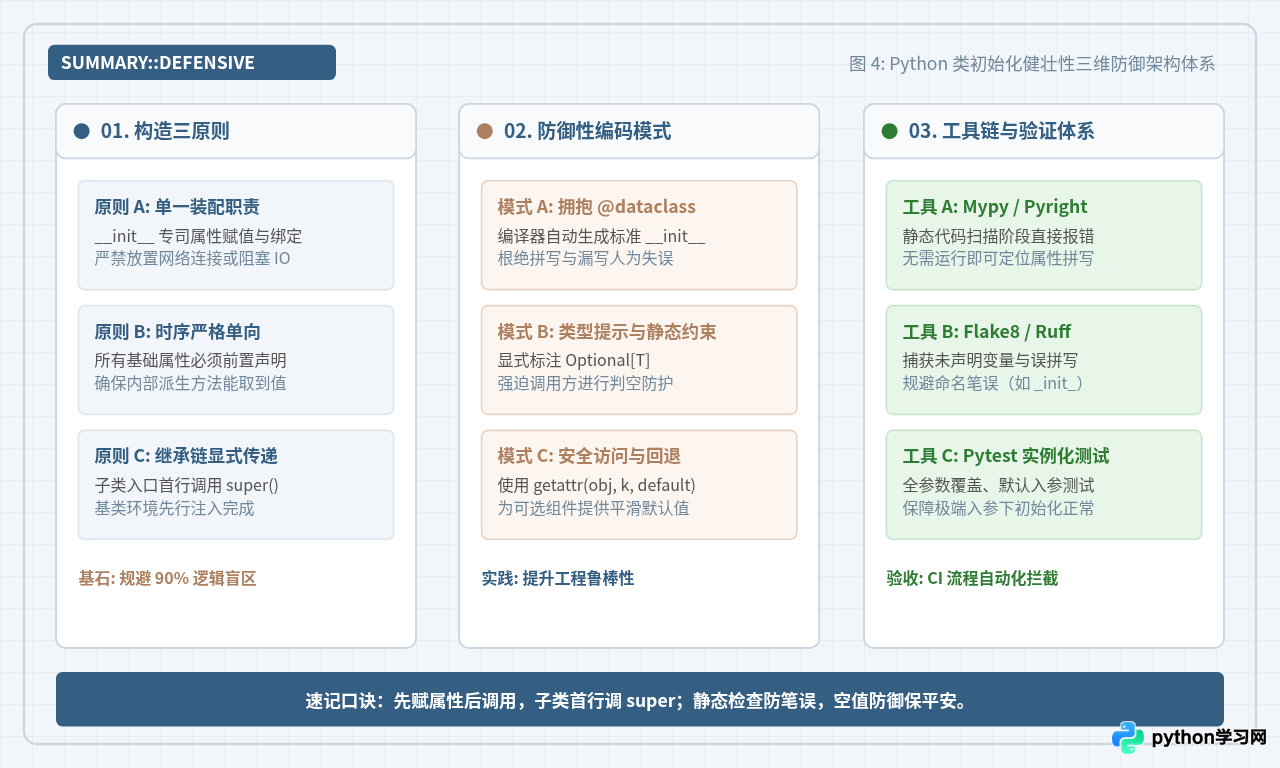
__init__ 方法中直接编写耗时较长的主动网络握手、磁盘大文件读取或复杂的轮询逻辑。构造函数应只负责对象状态的建立与依赖注入。耗时或存在外部不稳定性的任务应独立封装为显式生命周期方法(如 start() 或异步 initialize()),以降低初始化过程的异常概率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















