


Python列表降序排序怎么实现
详细讲解Python中实现列表降序排序的两种主要实现途径:原地修改的list.sort(reverse=True)与生成新列表的sorted(iterable, reverse=True),涵盖复杂对象排序、底层机制对比及高频避坑要点。
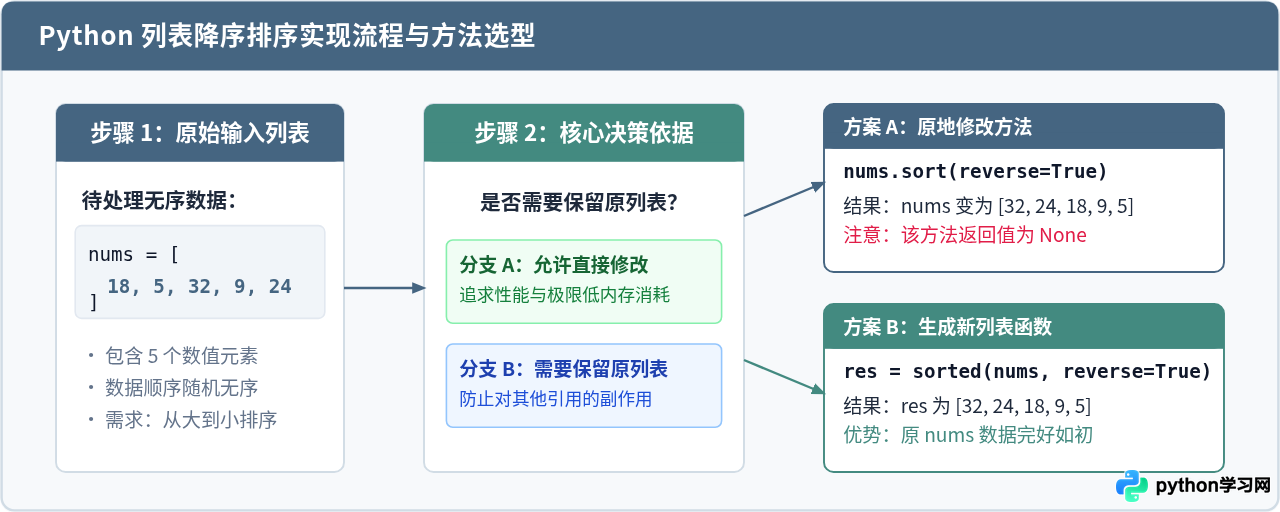
reverse=True 参数。具体取决于是否需要保留原数据:如果允许直接修改原列表且追求更高的性能与更低的内存开销,使用列表专有的 list.sort(reverse=True) 方法;如果需要保留原列表完整不变并生成一个全新的降序列表,或者处理不可变的序列对象,则使用内置函数 sorted(iterable, reverse=True)。对于包含字典或元组的复杂列表,还可以配合 key 参数指定具体的比较维度。
一、原地降序:使用 list.sort(reverse=True)
当手头的列表只在当前上下文使用,且不需要保留原有的乱序状态时,最推荐的做法是调用列表自身的成员方法 sort()。通过传入关键字参数 reverse=True,Python 会直接在底层连续内存块中调换元素指针,将其调整为从大到小的排列状态。
代码示例与语法调用
# 定义一个乱序整数列表
numbers = [18, 5, 32, 9, 24]

# 调用 sort 方法就地进行降序重排
numbers.sort(reverse=True)

# 打印排序后的列表
print("原地降序后的列表:", numbers)numbers.sort(reverse=True) 直接对变量 numbers 指向的列表本身进行了修改,没有创建新的列表对象。这种原地操作(In-place)的内存空间开销仅为 O(1),在处理几十万乃至上百万条数据时,具有明显的性能优势。
list.sort() 是一个具有就地副作用的方法,其执行后的返回值固定为 None。切勿写出 numbers = numbers.sort(reverse=True) 这样的代码,否则原列表不仅会被修改,变量 numbers 还会直接被赋值为 None,导致后续所有针对该列表的操作抛出异常。
二、生成新列表:使用内置函数 sorted(reverse=True)
在很多业务场景中,原列表的数据可能来自外部调用、接口响应或历史记录,需要保留初始顺序以供其他模块复用;或者在编写纯函数风格的代码时,严格要求函数无副作用。此时应当使用 Python 的内置全局函数 sorted()。
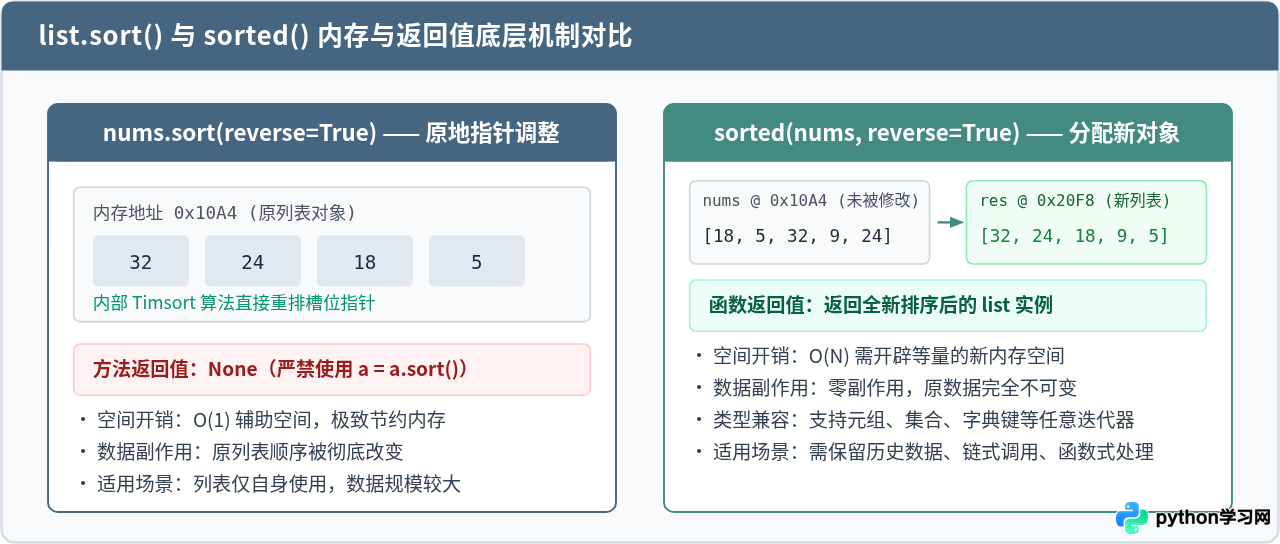
与 list.sort() 不同,sorted() 会在内存中申请一块全新的存储区域,将排序完成后的所有元素构造成一个全新列表并作为返回值返回,而原列表中的元素及其相对顺序保持完全不变。
代码示例与语法调用
# 原始输入列表
original_list = [18, 5, 32, 9, 24]

# 使用 sorted 函数生成降序新列表
descending_list = sorted(original_list, reverse=True)

# 分别检查新列表与原列表
print("新生成的降序列表:", descending_list)
print("原列表内容及顺序:", original_list)从输出中可以看到,original_list 依然保持最初的输入形态,而 descending_list 则是按从大到小排列好的新列表。此外,sorted() 并不局限于处理 list 类型,它能够接收元组(tuple)、集合(set)、字典的键或生成器等任何可迭代对象,并统一返回排好序的新列表。
三、两类核心方法的选择依据与差异对比
两种方法的核心区别在于对原对象是否存在“副作用”以及“内存分配方式”。在编写具体业务逻辑时,可以根据以下几点清晰界定选型:
| 对比维度 | list.sort(reverse=True) | sorted(iterable, reverse=True) |
|---|---|---|
| 调用方式 | 列表专属方法(data.sort(...)) |
内置全局函数(sorted(data, ...)) |
| 返回值 | 固定返回 None |
返回全新构建的 list 实例 |
| 原数据状态 | 原列表被直接改写为降序 | 原对象保持原样,零副作用 |
| 额外空间消耗 | O(1) 辅助空间,极致轻量 | O(N) 空间,需要分配新列表内存 |
| 适用对象 | 仅支持可变列表(list) | 支持任何可迭代对象(元组、集合、生成器等) |
| 典型应用场景 | 海量数据原地整理、追求极速与低内存 | 多处共享数据、不可变序列、函数式链式调用 |
四、进阶场景:结合 key 参数实现复杂数据降序
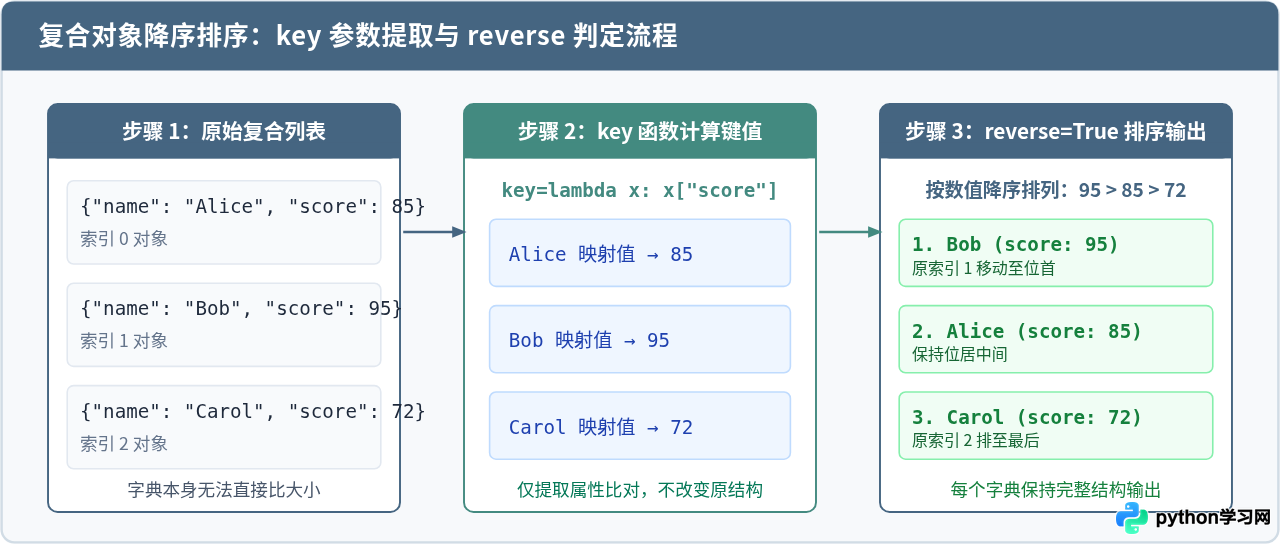
现实开发中,列表中存放的往往不仅是基础数值,还经常是字典、元组或自定义类的实例。此时单纯设置 reverse=True 无法让 Python 知道该按哪个字段比较大小。为此,sort() 与 sorted() 都提供了 key 参数,允许我们传入一个单参数函数(通常使用 lambda 表达式或 operator 模块)来动态提取比对权值。
1. 字典列表按指定数值字段降序
# 包含学生姓名和考试成绩的字典列表
students = [
    {"name": "Alice", "score": 85},
    {"name": "Bob",   "score": 95},
    {"name": "Carol", "score": 72}
]

# 通过 key 提取 score 字段,并指定 reverse=True 进行降序排序
sorted_students = sorted(students, key=lambda s: s["score"], reverse=True)

# 打印排序结果
for rank, student in enumerate(sorted_students, start=1):
print(f"第 {rank} 名: {student['name']} (成绩: {student['score']})")在执行过程中,Python 会对列表中的每个字典调用一次 key 函数,提取出对应的 score 作为排序键(95、85、72),再根据 reverse=True 进行降序排布,最终输出完整的字典对象。
2. 多条件混合排序(例如:主条件降序、副条件升序)
如果需要在多维条件下排序——比如“成绩高的排在前面;若成绩相同,则年龄小的排在前面”,这时需要注意:直接使用 reverse=True 会将所有维度同时倒序。如果需要部分维度降序、部分维度升序,对于数值类型字段,可以利用“取负号”的技巧灵活处理:
# 包含成绩与年龄的数据列表
records = [
    {"name": "张三", "score": 90, "age": 20},
    {"name": "李四", "score": 95, "age": 22},
    {"name": "王五", "score": 90, "age": 18}
]

# 需求:成绩按降序排列,成绩相同时年龄按升序排列
# 技巧:外部使用默认升序,主键 score 取负数即可将降序转化为升序比较
records.sort(key=lambda x: (-x["score"], x["age"]))

for r in records:
print(f"姓名: {r['name']}, 成绩: {r['score']}, 年龄: {r['age']}")可以看到,李四的 95 分最高排在首位;张三和王五同为 90 分,但 18 岁的王五排在 20 岁的张三前面,准确实现了多维度的升降混排。
五、常见混淆点与避坑指南
在实现列表降序的过程中,初学者容易遇到几个典型的理解误区与语法陷阱,了解这些边界条件有助于写出更稳健的代码。
1. 切勿使用 reverse() 或切片 [::-1] 替代降序
Python 列表中自带 list.reverse() 方法,切片语法也支持 list[::-1]。这两个操作的作用是物理反转顺序(即将原列表倒过来看,首尾颠倒),而不是按大小数值进行降序排序。
只有当列表本身已经是严格升序排列时,反转后的结果才恰好等同于降序。如果输入原本是乱序列表(例如 [3, 1, 4, 2]),反转后只会得到 [2, 4, 1, 3],根本不是降序。因此,若要按大小从大到小排布,必须使用 sort(reverse=True) 或 sorted(reverse=True)。
2. 避免在列表中混入不可比的跨类型元素
在 Python 2 中,数字与字符串等异构数据可以在一定规则下比较;但在 Python 3 中,为了代码严谨性,取消了不同非兼容类型之间的默认比较运算。如果列表中同时混入了字符串和数字:
bad_list = [10, "20", 5]
# 下行代码将抛出 TypeError: '>' not supported between instances of 'str' and 'int'
bad_list.sort(reverse=True)
执行时会直接抛出 TypeError。如果数据确实来自不同格式的混合输入,应当在排序前通过列表推导式或 key=int 等转换函数统一元素的数据类型。
3. Timsort 算法的稳定性保障
Python 内部采用的是高度优化的 Timsort 混合排序算法。该算法的一个重要特征是稳定排序(Stable Sort)。所谓稳定排序,是指对于键值相同的两个元素,排序前后的相对前后顺序绝对不会发生颠倒。这一特性使得在进行多轮排序时,上一轮的排序结果能够被安全地保留并叠加。
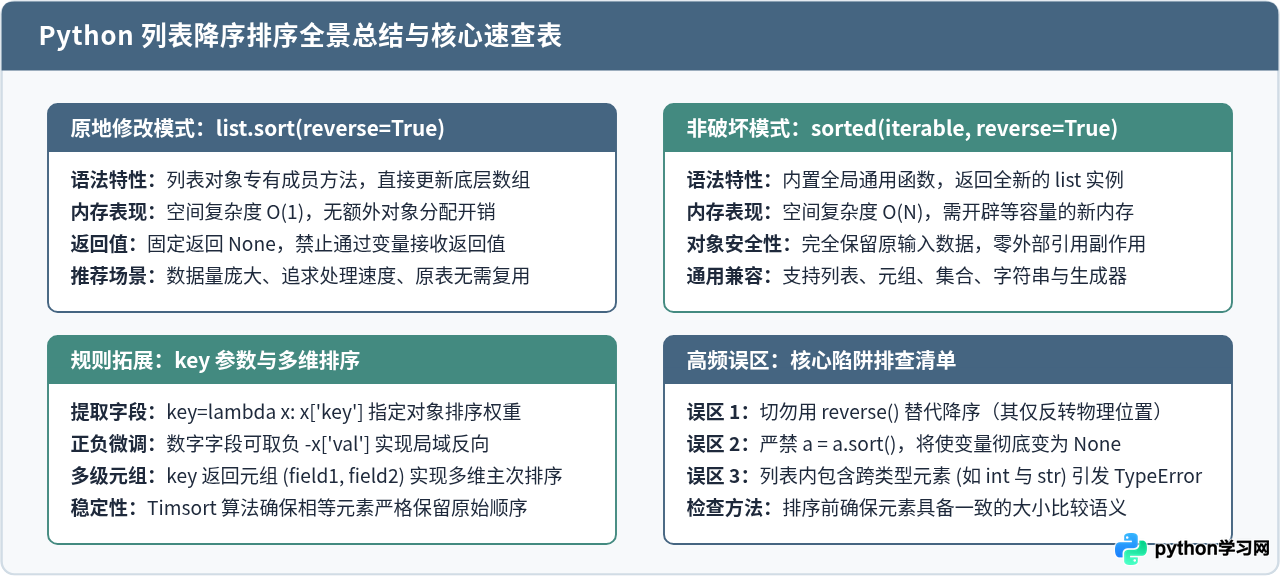
六、全文速查与总结
实现 Python 列表降序排序的核心要点可以归纳为以下三句话:
- 追求性能、无需保留原列表:首选
list.sort(reverse=True),注意其返回值为None,直接修改原列表。 - 需要保留原列表或处理通用序列:使用
sorted(iterable, reverse=True),它会创建并返回一个全新的降序列表。 - 针对字典或复合结构:搭配
key=lambda x: ...精准提取排序键;需要升降混排时,数值字段可借助取负号巧妙转换。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















