


python函数太长怎么拆分成小函数
详细讲解 Python 函数过长时的系统化拆解方法。涵盖如何识别逻辑切割边界、梳理输入输出依赖、使用 Dataclass 解决多参数传递难题、避免隐式副作用,并通过真实的订单处理重构案例,将数十行泥潭长函数重构为高内聚、易测试的小函数管道。
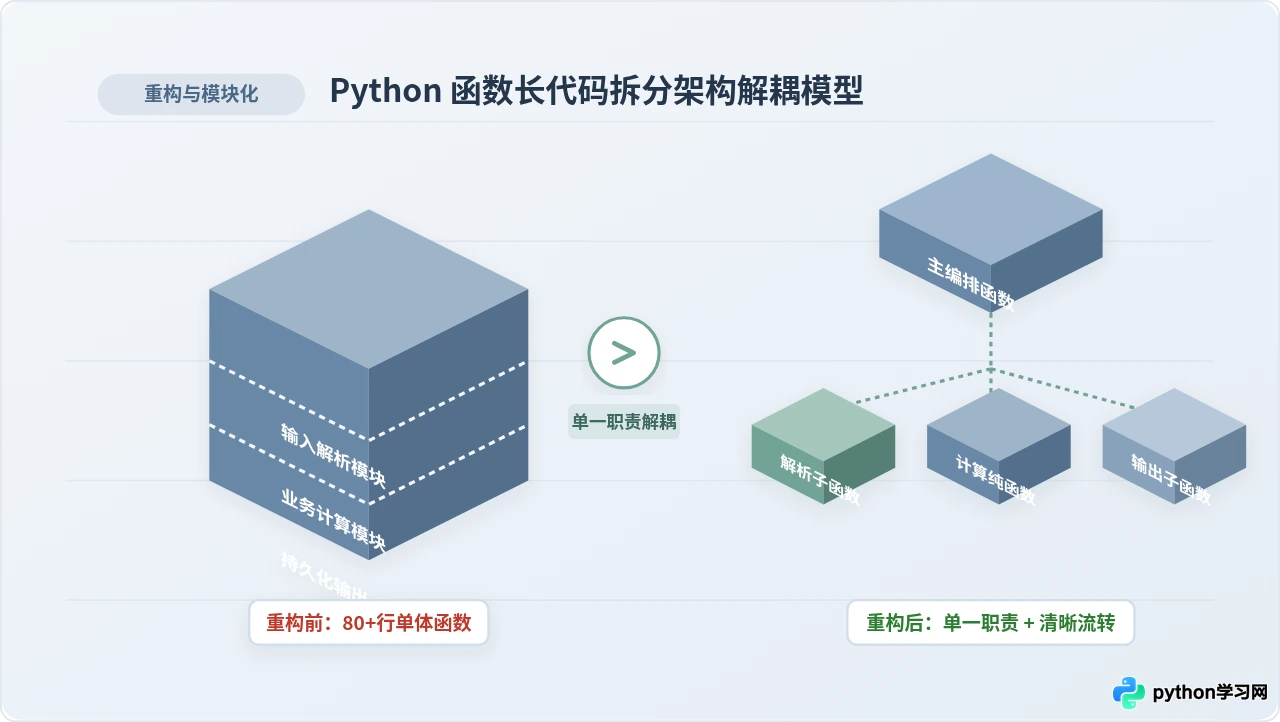
一、什么时候必须拆分?识别代码中的切分信号
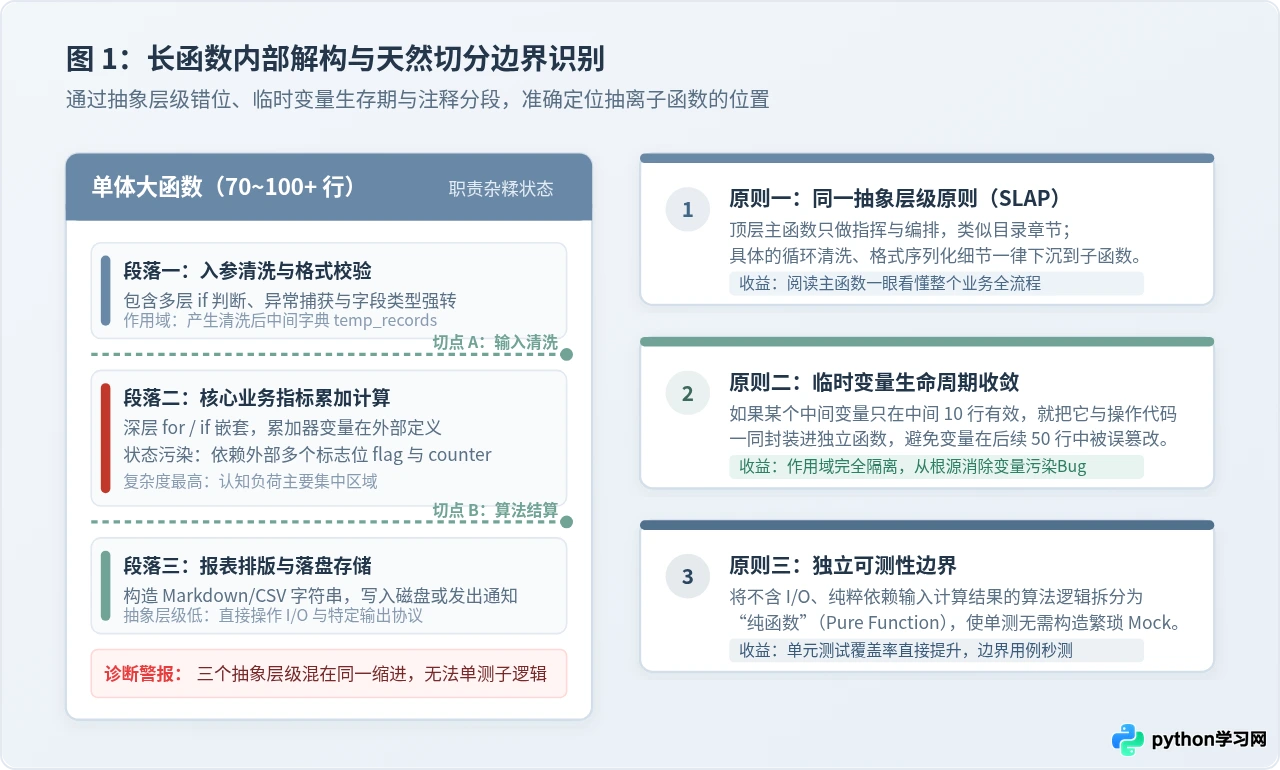
在 Python 开发中,函数的长度往往直接映射了代码的理解成本。通常当一个函数超过 30 到 50 行,或者在屏幕上需要反复滚动才能看完上下文时,代码就已经出现了“坏味道”。但行数只是表象,真正决定函数是否需要拆分的是其内部的逻辑复杂度。
如果你在维护或阅读一个函数时遇到以下几种典型现象,就表明它已经到了必须拆分的时刻:
- 代码中自然出现了多段“步骤注释”:例如在函数内部频繁出现
# 步骤 1: 校验入参、# 步骤 2: 计算优惠折扣、# 步骤 3: 格式化写出日志。如果一段代码必须依赖注释来标识边界,说明该段代码本身就应该是一个独立的命名函数。 - 临时变量的生命周期过长:在函数开头定义了 5 个局部变量,其中某个变量只在第 20 到 30 行参与运算,之后便再未被使用,但它却一直存在于整个函数的作用域中,增加了后续代码误读和篡改的风险。
- 抽象层级严重错位:同一个函数既处理最高层的业务调度流程,又在最内层进行字符串切片、正则表达式提取或底层网络套接字重试。高层指挥与底层泥潭细节挤在同一作用域。
- 嵌套层级超过 3 层:多层
for循环嵌套if ... else导致代码严重向右倾斜(“箭头型代码”),认知负荷急剧攀升。
二、拆解长函数的四步实操流程
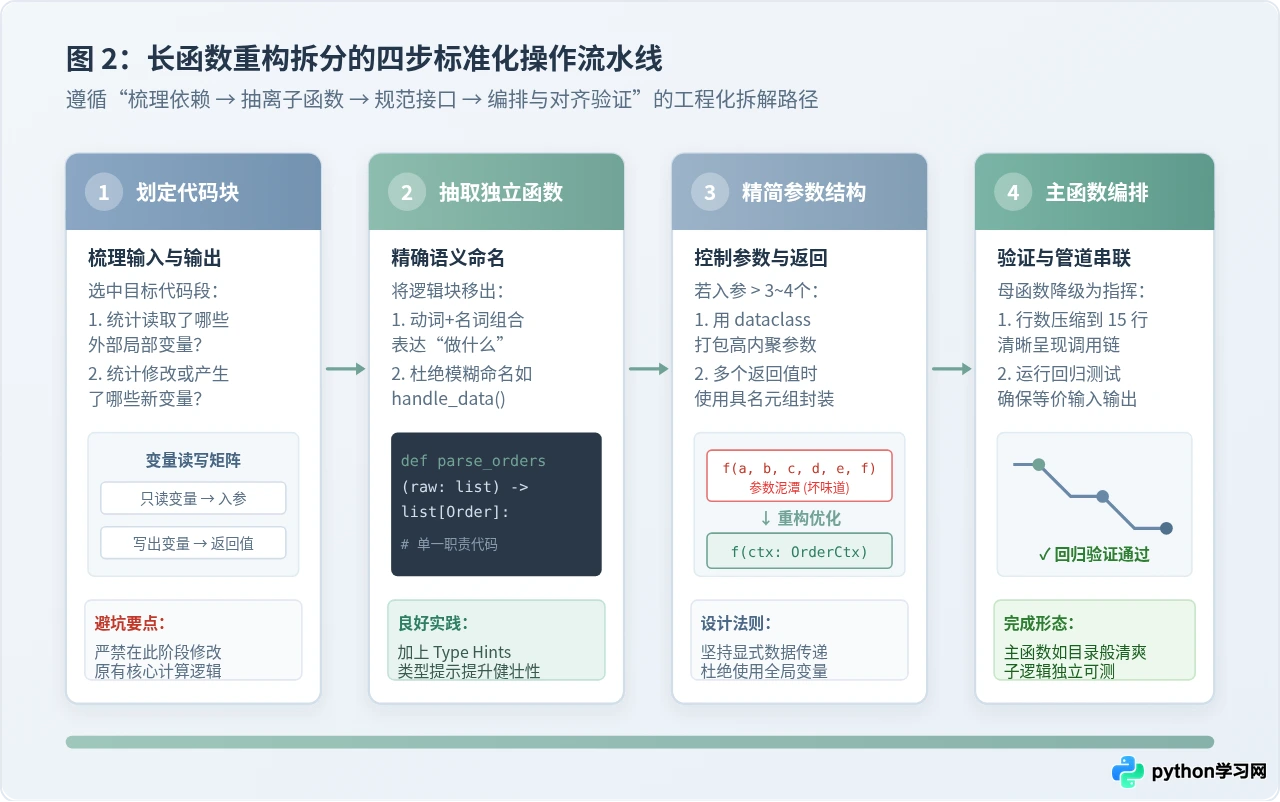
拆分函数最忌讳凭感觉直接剪切粘贴。如果缺乏清晰的工程步骤,很容易在拆分过程中遗漏外部变量或破坏原有的运行顺序。建议遵循以下四步标准重构流程:
第 1 步:划定边界并梳理输入输出矩阵
在决定将某一段代码提取为子函数前,先用眼睛或者临时注释框定该代码块,逐行排查两个关键问题:
- 输入依赖:这段代码从外部局部作用域中读取了哪些变量?这些变量就是新子函数潜在的入参。
- 产出结果:这段代码修改或新生成了哪些变量,且这些变量后续的代码还会继续使用?这些变量就是新子函数必须返回的值。
如果发现某段代码读取了 7 个局部变量并修改了其中 3 个,说明该代码段与上下文耦合过紧,不宜直接硬切,应先梳理数据流,削减不必要的中间临时变量。
第 2 步:提取子函数并赋予精准的意图命名
将框定的代码块剪切到外部定义为新的独立函数。命名是拆分小函数的核心,函数名必须直接回答“做了什么”,而不是“怎么做的”。
- 好的命名:
parse_user_records(raw_data)、calculate_order_discount(order, coupon)、notify_admin_on_failure(error)。 - 应当规避的模糊命名:
handle_data()、process_info()、do_step2()。模糊的名称说明子函数的职责依然没有厘清。
第 3 步:精简参数传递与返回值结构
理想的小函数参数数量应当控制在 1 到 3 个以内。如果拆出的小函数需要传入过多离散参数(例如 5 个以上的浮点数和字符串),应当考虑将相关联的参数打包为统一的数据载体,例如使用 Python 原生的 dataclass 或 NamedTuple。返回值同样如此,避免返回无序且无语义的超长多值元组。
第 4 步:重写主函数为顶层编排器并回归验证
子函数拆分完毕后,原先臃肿的主函数应当退化为一个“指挥官”。主函数内部不再包含繁重的算法和循环细节,而是由一连串清晰的子函数调用链构成,犹如一篇目录。重构完成后,立即运行现有的单元测试或验证脚本,确保重构前后的输出完全一致。
三、完整重构范例:从 70 行长函数到清晰管道
下面通过一个处理电商订单数据的典型场景,直观展示长函数拆解前后的结构差异。
1. 重构前:职责混杂、变量乱飞的单体长函数
以下函数承担了数据清洗、业务折扣与运费计算、报表汇总以及告警落盘等所有逻辑。代码行数长,临时变量穿插其间,极难单独针对运费算法编写单元测试:
# 重构前代码:一个大包大揽的长函数(anti-pattern)
def process_order_data_and_generate_report(raw_orders, export_filepath):
    # 步骤 1: 清洗和校验
    valid_orders = []
    for item in raw_orders:
        if not isinstance(item, dict):
            continue
        order_id = item.get("id")
        amount = item.get("amount", 0)
        user_level = item.get("user_level", "standard")
        if order_id and amount > 0:
            valid_orders.append({
                "id": order_id,
                "amount": float(amount),
                "level": user_level
            })

    if not valid_orders:
        raise ValueError("无有效订单记录")

    # 步骤 2: 核心计算(折扣与运费)
    total_sales = 0.0
    total_discount = 0.0
    vip_count = 0
    detailed_results = []

    for order in valid_orders:
        amount = order["amount"]
        level = order["level"]
        discount = 0.0

        # 折扣规则
        if level == "vip":
            discount = amount * 0.15
            vip_count += 1
        elif level == "gold":
            discount = amount * 0.20
            vip_count += 1
        elif amount > 500:
            discount = amount * 0.05

        shipping_fee = 0.0 if (amount - discount) >= 99 else 15.0
        final_payable = (amount - discount) + shipping_fee

        total_sales += amount
        total_discount += discount

        detailed_results.append({
            "order_id": order["id"],
            "payable": round(final_payable, 2),
            "discount": round(discount, 2)
        })

    # 步骤 3: 格式化报表与输出
    net_sales = total_sales - total_discount
    report_lines = [
        "==== 财务销售日结汇总 ====",
        f"有效订单总数: {len(valid_orders)}",
        f"VIP用户订单数: {vip_count}",
        f"原始销售总额: ¥{total_sales:.2f}",
        f"总让利折扣额: ¥{total_discount:.2f}",
        f"实际净销售额: ¥{net_sales:.2f}",
        "--------------------------"
    ]
    report_content = "\n".join(report_lines)

    with open(export_filepath, "w", encoding="utf-8") as f:
        f.write(report_content)

    return {
        "total_orders": len(valid_orders),
        "net_sales": round(net_sales, 2),
        "details": detailed_results
    }
2. 重构后:职责单一、类型明确的优雅架构
运用拆分原则,我们将数据流抽象为结构体,拆出三个专职子函数,主函数仅保留 10 行高层编排逻辑:
# 重构后代码:模块化拆分与纯函数管道
from dataclasses import dataclass
from typing import List, Dict, Tuple

@dataclass(frozen=True)
class CleanedOrder:
    order_id: str
    amount: float
    user_level: str

@dataclass(frozen=True)
class SettlementSummary:
    total_orders: int
    vip_count: int
    total_sales: float
    total_discount: float
    net_sales: float
    details: List[Dict]

def parse_and_validate_orders(raw_orders: List[Dict]) -> List[CleanedOrder]:
    """子函数 1: 仅负责数据入参校验与类型规整"""
    cleaned = []
    for item in raw_orders:
        if isinstance(item, dict) and item.get("id") and item.get("amount", 0) > 0:
            cleaned.append(CleanedOrder(
                order_id=str(item["id"]),
                amount=float(item["amount"]),
                user_level=str(item.get("user_level", "standard"))
            ))
    if not cleaned:
        raise ValueError("无有效订单记录")
    return cleaned

def calculate_single_order(order: CleanedOrder) -> Tuple[float, float]:
    """子函数 2: 纯算法,计算单笔订单的(折扣额, 应付总额)"""
    discount_rates = {"vip": 0.15, "gold": 0.20}
    discount = order.amount * discount_rates.get(order.user_level, 0.05 if order.amount > 500 else 0.0)

    after_discount = order.amount - discount
    shipping_fee = 0.0 if after_discount >= 99 else 15.0
    return discount, (after_discount + shipping_fee)

def compute_financial_summary(orders: List[CleanedOrder]) -> SettlementSummary:
    """子函数 3: 批量结算并汇总经营指标(无 I/O,便于秒测)"""
    total_sales = sum(o.amount for o in orders)
    vip_count = sum(1 for o in orders if o.user_level in ("vip", "gold"))

    total_discount = 0.0
    details = []
    for order in orders:
        discount, payable = calculate_single_order(order)
        total_discount += discount
        details.append({
            "order_id": order.order_id,
            "payable": round(payable, 2),
            "discount": round(discount, 2)
        })

    return SettlementSummary(
        total_orders=len(orders),
        vip_count=vip_count,
        total_sales=total_sales,
        total_discount=total_discount,
        net_sales=total_sales - total_discount,
        details=details
    )

def export_report_to_disk(summary: SettlementSummary, filepath: str) -> None:
    """子函数 4: 专门负责 I/O 落地"""
    lines = [
        "==== 财务销售日结汇总 ====",
        f"有效订单总数: {summary.total_orders}",
        f"VIP用户订单数: {summary.vip_count}",
        f"原始销售总额: ¥{summary.total_sales:.2f}",
        f"总让利折扣额: ¥{summary.total_discount:.2f}",
        f"实际净销售额: ¥{summary.net_sales:.2f}",
        "--------------------------"
    ]
    with open(filepath, "w", encoding="utf-8") as f:
        f.write("\n".join(lines))

# 最终的主函数:高层流式编排,一眼看尽全流程
def process_order_pipeline(raw_orders: List[Dict], export_filepath: str) -> SettlementSummary:
    orders = parse_and_validate_orders(raw_orders)
    summary = compute_financial_summary(orders)
    export_report_to_disk(summary, export_filepath)
    return summary
四、拆分中的关键难题与避坑指南
很多开发者在拆分函数时容易走向另一个极端,或者引发隐藏的运行时缺陷。以下是拆分过程中最容易遇到的三大陷阱及解决对策:
陷阱 1:拆分后出现“参数爆炸”
表现:子函数定义写成了 def calc(a, b, c, d, e, f, g):,调用时容易传错位置。
解法:运用数据载体(Context 对象)。如果多个参数总是结伴同行出现,说明它们本质上属于同一个业务实体,应使用 @dataclass 封装为一个对象传递。这不仅减少了参数数量,还赋予了参数明确的类型约束和 IDE 自动补全能力。
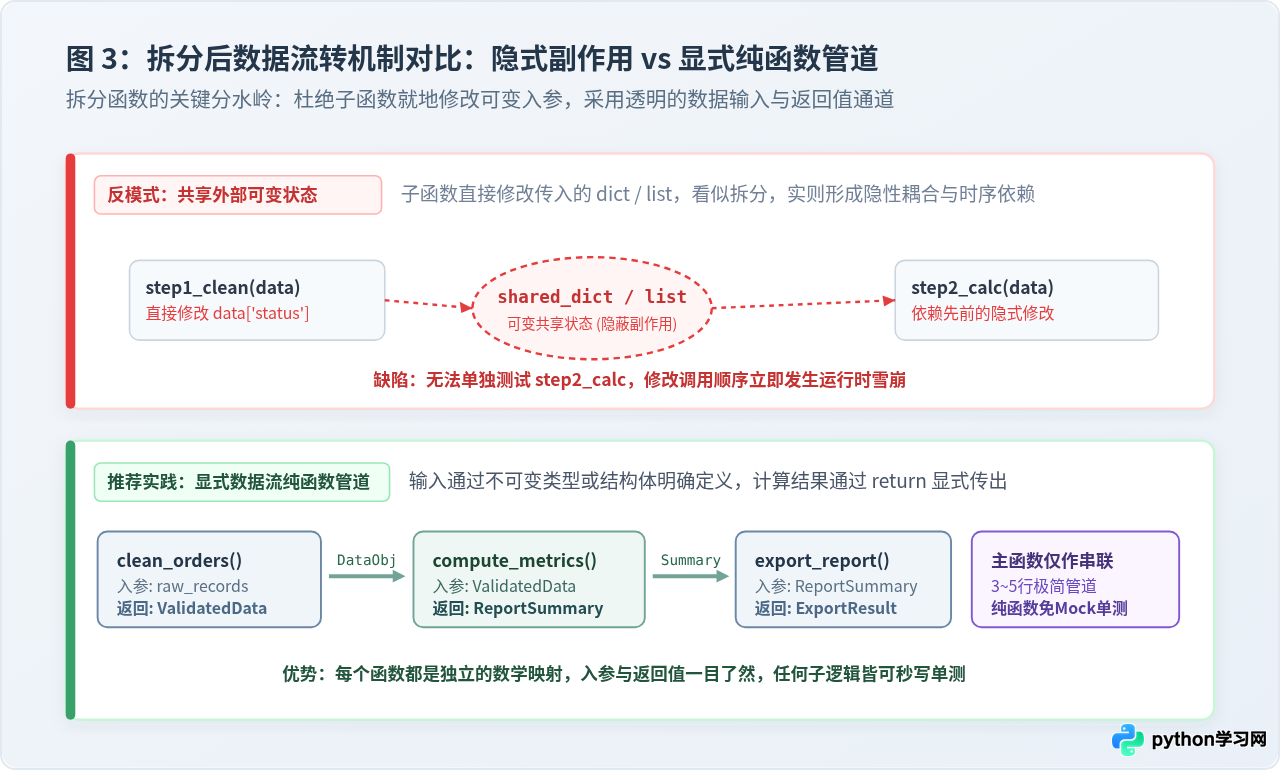
陷阱 2:隐式就地修改引发状态副作用
表现:在子函数内直接对传入的 list 调用 .append(),或者修改 dict 的键值,且不通过 return 返回。
危害:这是重构中最致命的隐患。外部调用者无法直观获知数据在何时被改动,且拆出的子函数强依赖前后执行顺序,无法单独编写单元测试。正确做法:子函数应尽量设计为“纯函数(Pure Function)”,接收不可变数据或只读访问,计算完毕后显式通过 return 返回新的结构体。
陷阱 3:过度碎片化拆分(Over-splitting)
表现:把原本只有两三行非常紧凑的赋值语句也强行封装为单独函数,导致阅读代码时需要在四五个微小函数之间频繁跳转,破坏了阅读连续性。
衡量准则:拆分的目的是提高可读性与可维护性。如果一段逻辑只被调用一次,且本身足够清晰(比如只是一个标准库调用),就没有必要为了追求“短小”而单独提取。小函数的合理长度通常在 5 到 25 行之间最为舒适。
五、拆分后如何检验质量?
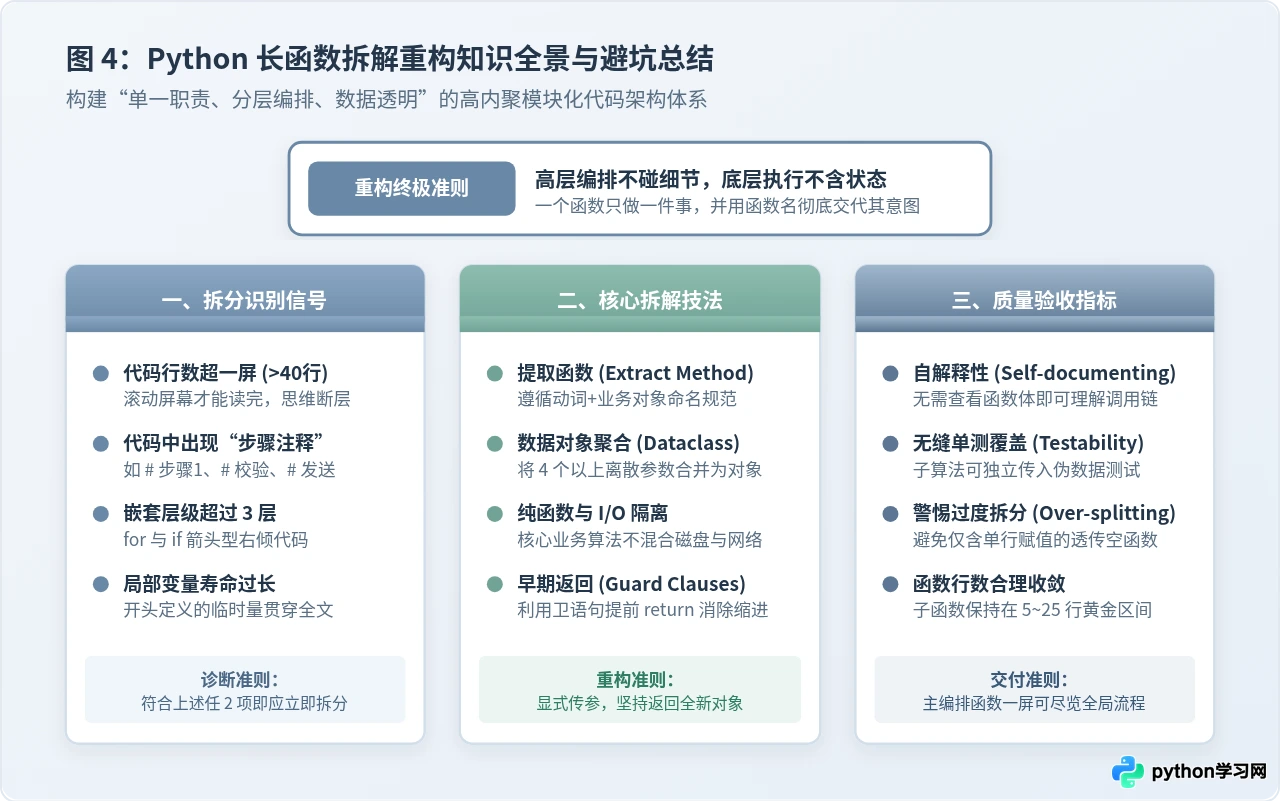
函数拆分完成后,可以通过以下三项可量化的指标来检验拆分质量:
| 检验维度 | 拆分合格的标准 | 不合格的危险表现 |
|---|---|---|
| 代码自解释性 | 无需点击跳转查看子函数代码,只看主函数中的函数名就能说出全部业务步骤。 | 主函数充斥大量 flag_1、temp_data 和含义模糊的 do_process()。 |
| 单测容易度 | 计算类子函数无需启动网络、数据库或 Mock 文件系统,直接传入测试参数即可瞬间验证。 | 测试某一个子算法前,必须先在测试用例中准备一个包含 20 个字段的超大复合上下文。 |
| 改动影响范围 | 业务规则(如 VIP 折扣比例)发生变动时,只需修改对应的一个独立子函数,主流程无需改动。 | 修改某一处计算规则,引发后续子函数取值 KeyError 或类型错误。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















