


为什么大型Python项目推荐添加函数参数类型提示
深入解析大型Python项目推荐添加函数参数类型提示的核心原因,从消除隐式契约、驱动IDE智能感知、提升重构安全性到CI静态检查落地,提供系统化的原理解析与工程实践规范。
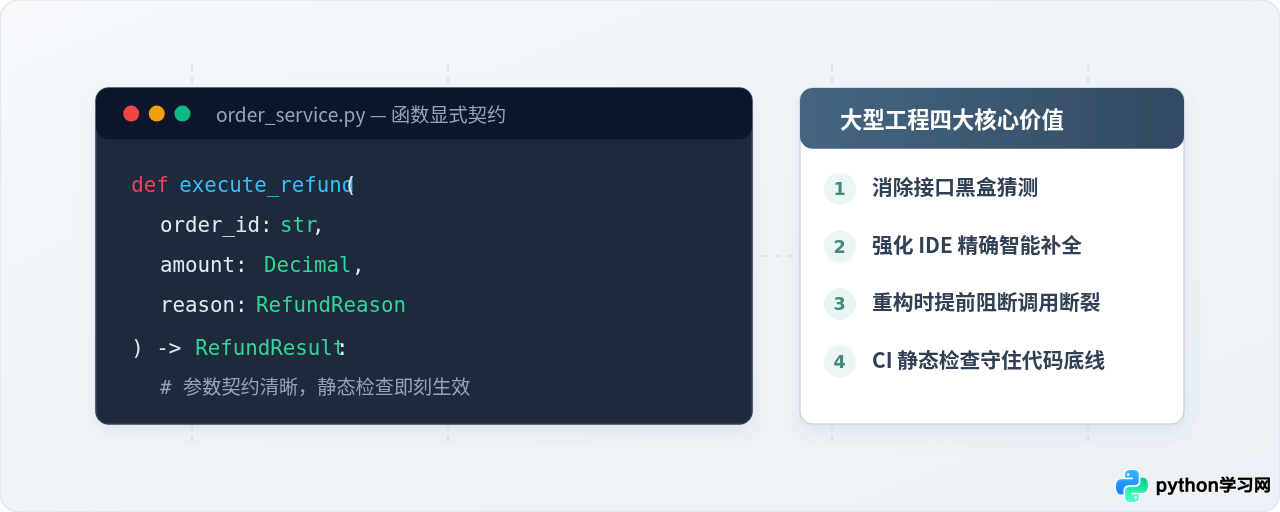
一、消除“隐式契约”:从参数黑盒到显式接口约束
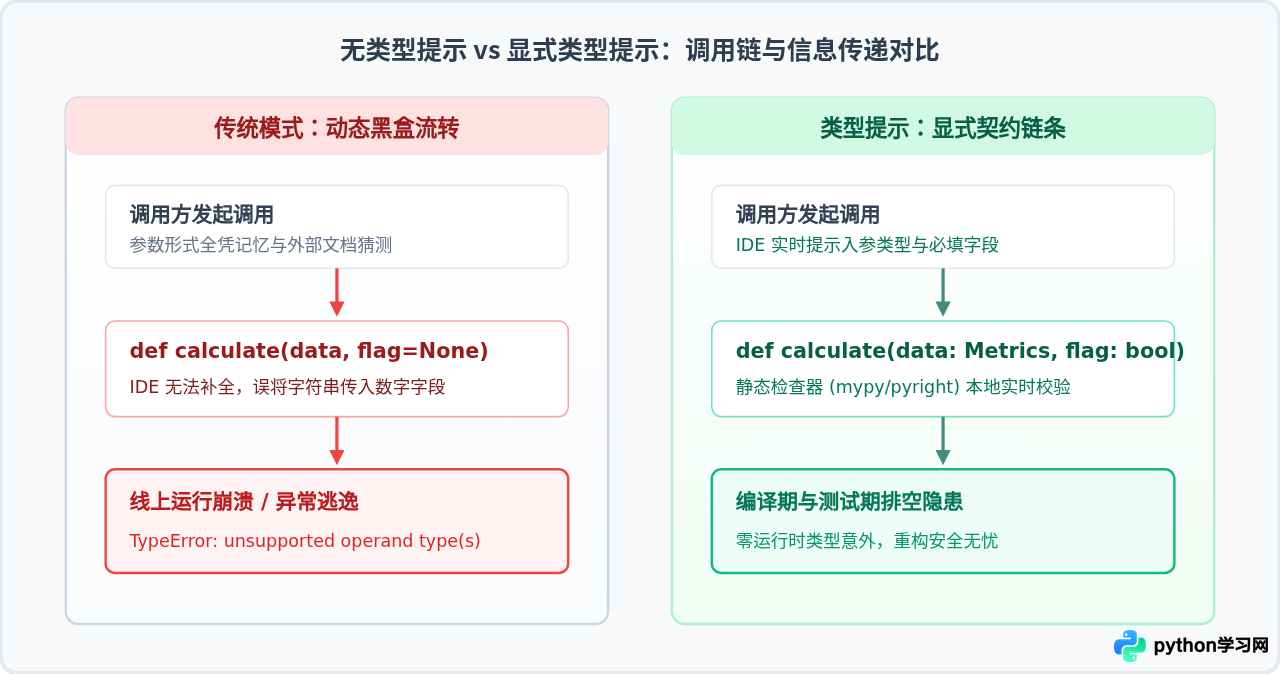
在不使用类型提示的 Python 代码中,函数签名通常是一个“信息黑盒”。调用方必须通读函数体源码、翻阅可能早已过期的文档字符串,或者通过打断点打印 type() 才能确定应该传入什么数据结构。
❌ 传统无类型函数签名(黑盒状态)
无法直接看出 user 是用户 ID 整数、用户名字符串、ORM 实例还是业务字典;config 到底支持哪些键名完全依赖口口相传。
✅ 现代带类型函数签名(显式契约)
参数意图、支持的空值情况、嵌套结构一目了然,静态分析工具在开发者敲下键盘的瞬间即可检验入参是否合规。
通过以下直观的代码对比,可以体会两者的巨大差异:
# 场景 1:无类型提示 —— 维护者必须通读函数实现才能推导参数形态
def process_payment(order, channels, retry_limit=3):
    # 这里的 order 是 dict 还是 OrderModel 实例?
    # channels 是字符串列表、枚举列表,还是特定的集合类型?
    # 内部如果出现 order["amount"] 与 order.amount 的混用,只有在运行时才会崩溃
    payment_id = order.get("id")
    ...

# 场景 2:添加参数类型提示 —— 签名即文档,契约即约束
from typing import Sequence
from decimal import Decimal
from app.models import OrderPayload, PaymentChannel, PaymentReceipt

def process_payment(
    order: OrderPayload,
    channels: Sequence[PaymentChannel],
    retry_limit: int = 3
) -> PaymentReceipt:
    payment_id = order.order_id
    ...
在无类型时代,开发者很容易把 float 当作金额传入,造成精度截断;或者在字典中漏传关键字段。添加参数类型提示后,函数入口成为坚固的边界,任何类型不匹配的调用行为都能在编码阶段被发现。
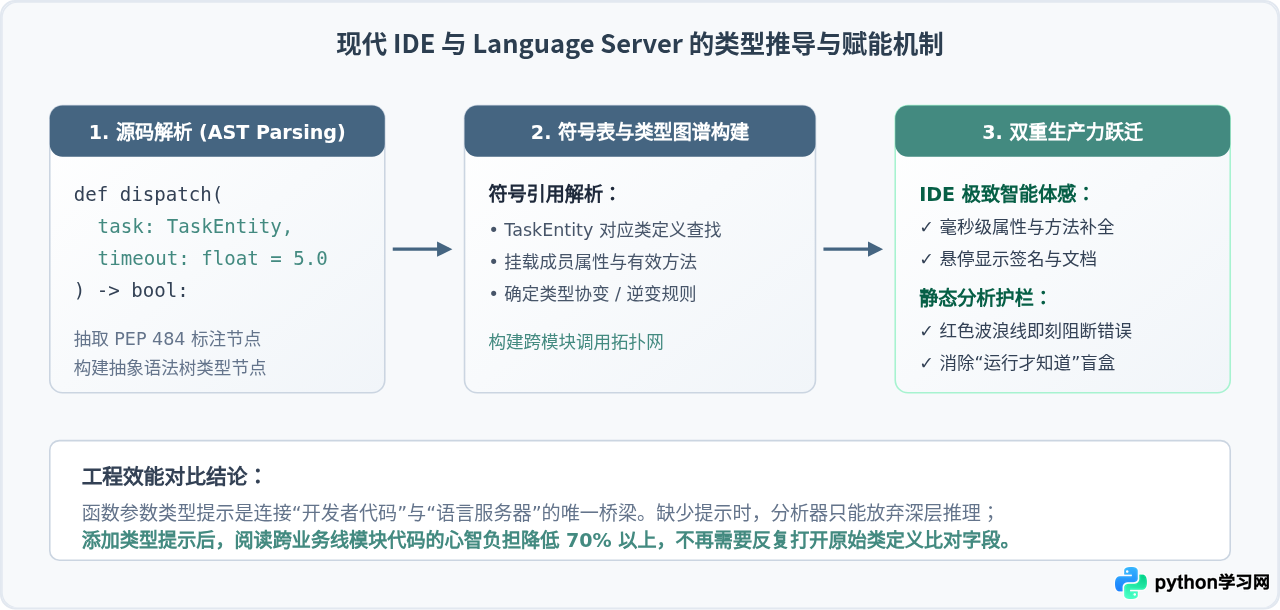
二、驱动现代 IDE 深度感知:成倍降低跨模块理解成本
大型项目最消耗工程师时间的不是编写新代码,而是“阅读和理解既有代码”。当项目体量达到数十万行时,没有任何一名开发者能够把全工程的类层次装入大脑。
Python 本身是一门动态解释型语言,现代语言服务器(如 VS Code 的 Pylance/Pyright,PyCharm 内置类型分析引擎)无法凭空推导复杂的动态调用。一旦函数参数缺少类型提示,IDE 就只能将参数推断为通用的 Any 或 Unknown。这会导致两大生产力断崖:
- 自动补全失效:无法通过点号(
.)唤出对象的属性和方法列表,开发者被迫反复跳转到原文件确认拼写。 - 重命名与安全跳转断裂:IDE 无法确认当前引用的属性究竟属于哪个类,全局符号重构时极易漏改或误伤同名属性。
三、架构重构的安全底气:让静态类型检查器守卫代码底线
大型软件项目的生命周期中,重构是常态。调整核心函数的参数结构、拆分领域服务、升级底层 SDK,都会牵动成百上千处调用点。
在纯动态的 Python 环境中重构如同“在雷区漫步”。单元测试虽然必不可少,但在大型工程中,针对所有参数组合的分支覆盖率极难达到 100%。许多致命错误(例如传参位置颠倒、漏传新必填字段、类型隐式不兼容)会悄然绕过测试,直接流入生产环境。
引入类型提示后,我们可以借助 mypy 或 pyright 等工业级静态检查器,在几秒内遍历全仓代码,精准定位所有被破坏的调用点。
# 重构案例:修改核心函数参数
# 原签名:def register_merchant(merchant_name: str, contact_email: str) -> None:
# 新签名:收敛为明确的 MerchantRegistrationDTO 对象

from dataclasses import dataclass

@dataclass(frozen=True)
class MerchantRegistrationDTO:
    merchant_name: str
    contact_email: str
    tax_identifier: str  # 新增法规要求的合规税号字段

def register_merchant(dto: MerchantRegistrationDTO) -> None:
    ...

# 执行静态检查时,mypy 能够瞬间抓出跨模块所有未同步改造的历史旧调用:
# orders/services.py:84: error: Too many positional arguments for "register_merchant"
# api/v1/auth.py:120: error: Argument 1 to "register_merchant" has incompatible type "str"; expected "MerchantRegistrationDTO"
这种能力赋予了团队“重构的确定性”。不再依赖祈祷或全量回归测试去碰运气,类型检查器会生成一张毫无遗漏的待修复清单,完成修复即代表契约重新对齐。
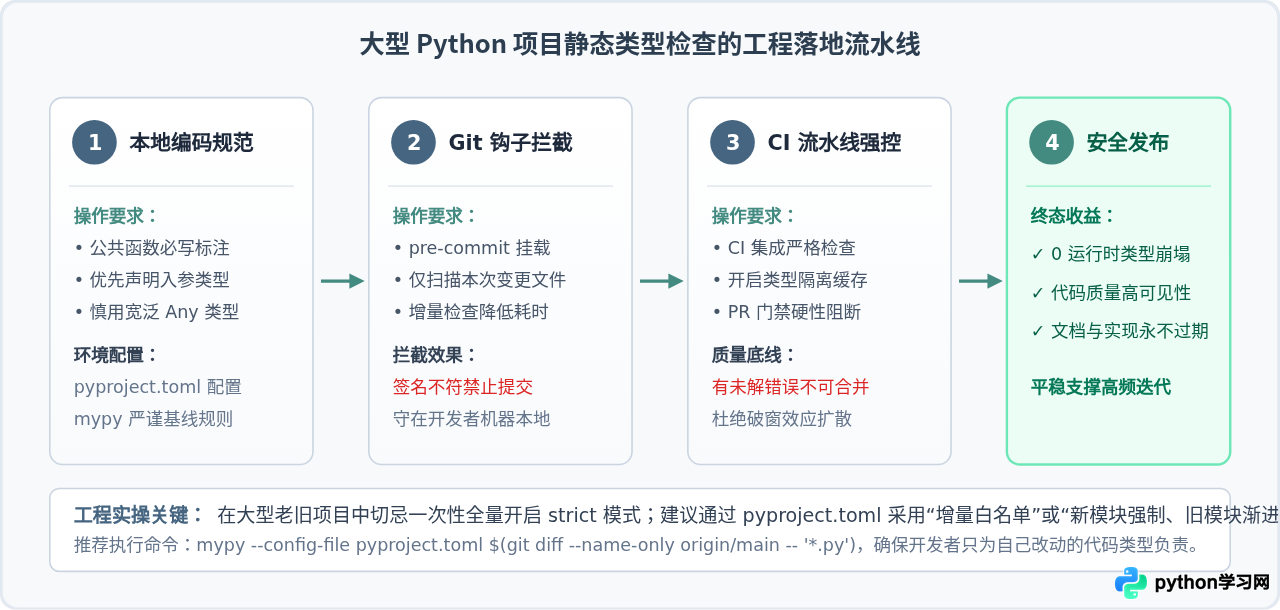
四、大型工程中的参数类型编写规范与避坑指南
给函数参数添加类型提示并不是机械地把所有参数标上原生类型,大型项目有一套行之有效的规范与避坑准则:
1. 遵循“入参宽容,出参严格”原则(Postel's Law)
在定义函数参数时,尽量面向抽象接口(抽象基类或协议),而不是绑定具体的数据结构实现。这能极大提升函数的通用性和解耦度。
# ❌ 反模式:过度限定参数具体类型,导致调用方如果传入元组或集合就报错
def batch_update_status(user_ids: list[int], status: str) -> None:
    for uid in user_ids:
        ...

# ✅ 推荐:入参使用抽象容器类型 Sequence 或 Iterable,接受 list、tuple、set 等多种结构
from collections.abc import Sequence

def batch_update_status(user_ids: Sequence[int], status: str) -> None:
    for uid in user_ids:
        ...
2. 明确区分 None 的可能性(告别隐式 Optional)
在老版本 Python 中,许多人习惯写 def find_user(user_id: int = None),这在早期会被隐式推导为允许 None。现代 Python(3.10+)要求必须显式声明联合类型 int | None。明确标注空值不仅能提醒调用方进行判空防守,更能彻底杜绝著名的 'NoneType' object has no attribute 生产故障。
3. 使用 Protocol 替代多重继承实现结构化子类型
在微服务架构或插件系统中,不同模块间往往不想产生沉重的直接类依赖。通过 typing.Protocol,我们可以基于“鸭子类型”定义参数规范——只要对象具备相应的方法与属性,就能通过类型检查,既保持了松耦合,又获得了完全的静态类型安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















