


Python函数定义接收元组:直接传参与*args解包的区别
深入解析Python中函数定义接收元组的两种核心方式:单一形参直接传参与*args可变位置参数打包。详细对比两者的内存引用、调用语法、双重嵌套陷阱及最佳实践决策依据。
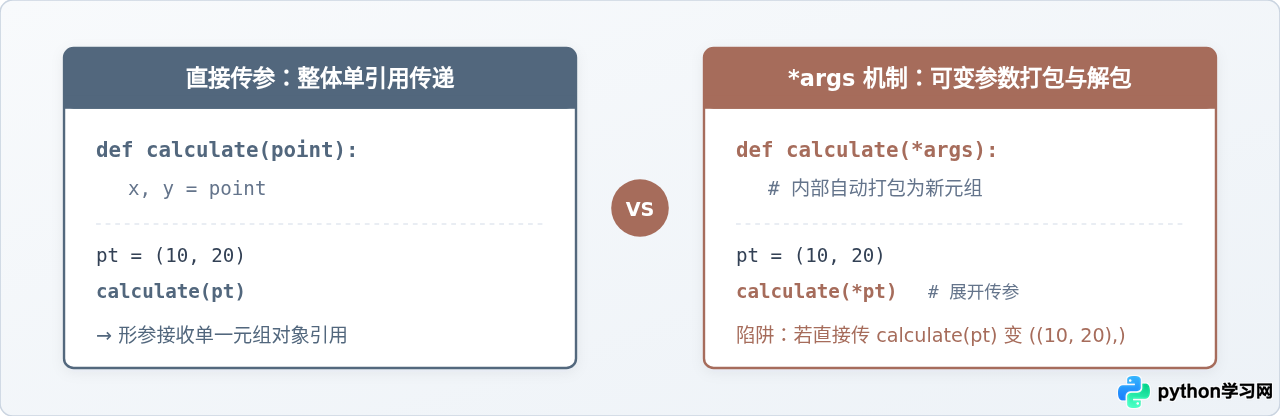
在 Python 中编写接收多个关联数据的函数时,很多开发者常在两种写法之间纠结:是在函数定义中声明一个普通的形参直接接收元组(如 def func(data)),还是使用带星号的变长位置参数(如 def func(*args))配合解包。这两种方式在语法表现、形参契约、内存管理以及对调用方的数据结构要求上存在本质区别。理解它们的机制差异与适用边界,能有效避免数据意外嵌套、类型不匹配等运行时隐患。
一、两种传参模式的核心概念与定义形式
为了清晰区分两者,需要先明确 Python 解释器在“函数定义端”与“函数调用端”对元组的不同处理原则:
- 直接传参(普通形参):函数定义中只有一个常规变量,例如
def render_point(point):。调用时,必须传入一个完整的元组对象(如render_point((10, 20)))。在该模型中,元组被视为一个不可分割的单一实体。 - *args 打包接收:函数定义中形参前带有单星号
*,例如def render_point(*args):。这并不是要求调用方传入一个元组,而是让 Python 运行时负责将调用时传入的所有离散位置实参,按顺序自动“打包”为一个新的元组args。
很多混淆往往发生在调用端已有元组的情况。如果目标函数使用 *args 定义,调用方若直接传入元组 render_point(pt),并不会被自动展开,而是会被打包成“包含元组的单元素元组”;只有在调用端显式使用解包语法 render_point(*pt),元组元素才会作为独立参数注入。
二、普通形参直接接收元组:语义严谨与零复制
采用普通形参接收元组,本质上是 Python 标准的对象引用传递。调用方将元组传递给函数时,并没有进行任何内存复制,形参直接指向堆内存中已经存在的同一个元组对象。
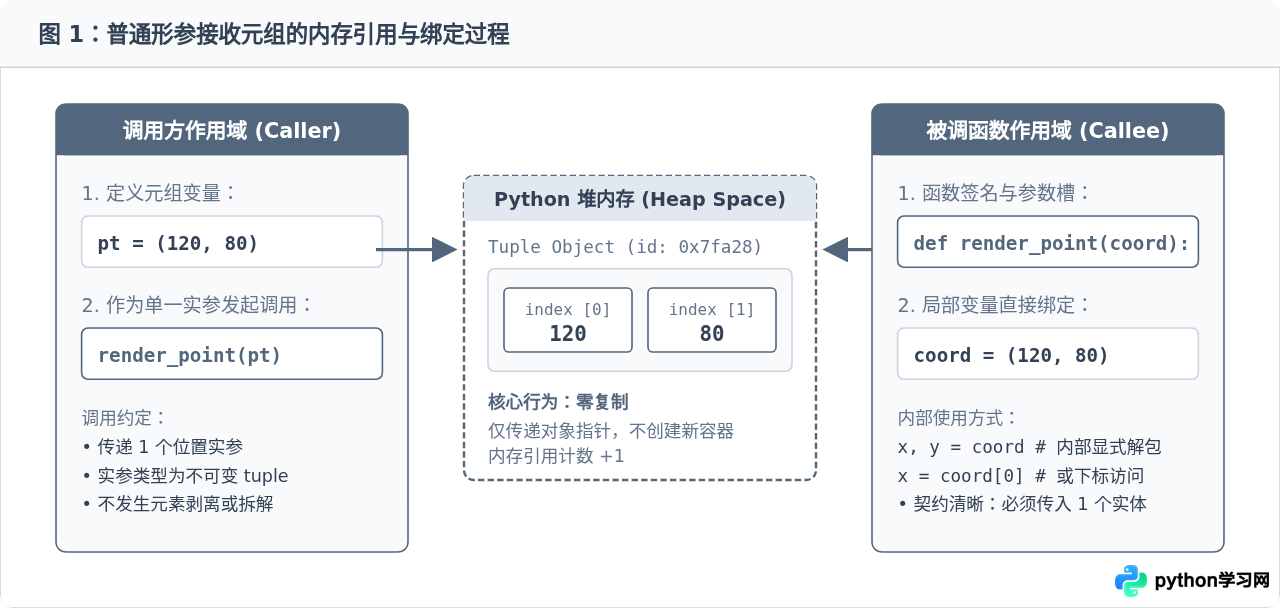
看下面的具体代码实现:
def render_point(coord: tuple[float, float]) -> None:
    # 在函数体内按需读取或显式解包
    x, y = coord
    print(f"X坐标: {x}, Y坐标: {y}")

# 准备元组数据
target_pos = (120.5, 80.0)

# 正确调用:直接传递元组对象作为唯一的实参
render_point(target_pos)

# 错误调用示例:传入两个离散实参将抛出 TypeError
# render_point(120.5, 80.0)  # TypeError: render_point() takes 1 positional argument but 2 were given
tuple[float, float])即可获得 IDE 和类型检查器(Mypy)的即时保障。
三、*args 接收与打包机制:变长参数与“双重元组”陷阱
当在函数定义中使用 def func(*args) 时,形参前面的星号并不代表类型,而是一个语法指令,指示 Python 虚拟机(C代码内部的 BUILD_TUPLE 指令)把所有未被命名位置形参捕获的位置参数汇聚打包,构造成一个新的元组实例赋给变量名 args。
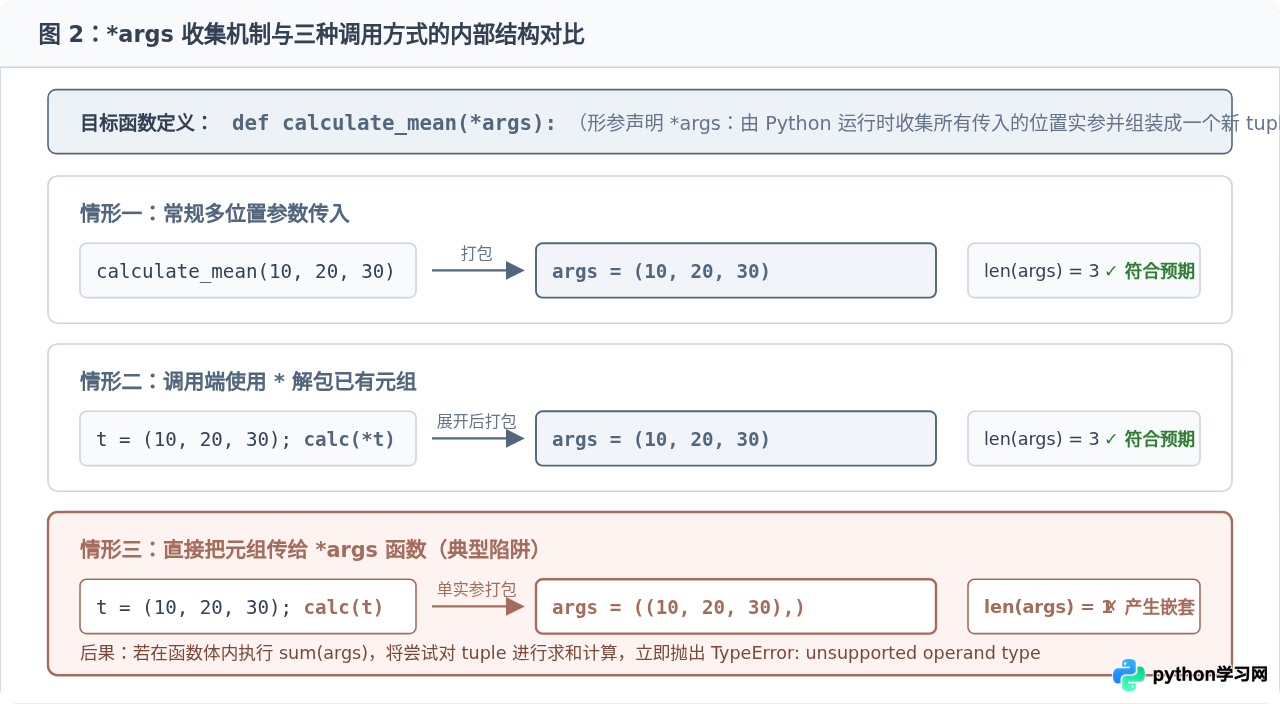
这一机制带来了极高的灵活性,但也导致了最常见的编码错误——嵌套元组陷阱(The Double Tuple Pitfall)。对比以下三种调用情景:
def calculate_mean(*args: float) -> float:
    # args 在函数内部始终是一个元组
    print(f"内部 args 类型: {type(args)}, 长度: {len(args)}, 内容: {args}")
    return sum(args) / len(args)

data_tuple = (10, 20, 30)

# 情形 1:平铺传入离散实参(符合设计初衷)
mean1 = calculate_mean(10, 20, 30)
# 输出: 内部 args 类型: <class 'tuple'>, 长度: 3, 内容: (10, 20, 30)

# 情形 2:对已有元组使用 * 解包后传入(正确做法)
mean2 = calculate_mean(*data_tuple)
# 输出: 内部 args 类型: <class 'tuple'>, 长度: 3, 内容: (10, 20, 30)

# 情形 3:直接把元组传给 *args 函数(典型陷阱)
# mean3 = calculate_mean(data_tuple)
# 输出: 内部 args 内容为 ((10, 20, 30),),长度仅为 1
# 随后执行 sum(args) 尝试对包含元组的序列做累加,引发运行时崩溃:
# TypeError: unsupported operand type(s) for +: 'int' and 'tuple'
calculate_mean(data_tuple) 时,只提供了一个实参(即 data_tuple 对象本身)。Python 的 *args 规则忠实地将这“唯独一个”实参装入新元组中,形成了形如 ((10, 20, 30),) 的二维结构。在编写支持变长参数的通用函数时,如果不小心省略了调用端的星号,程序往往直到执行聚合运算或下标访问时才会暴露出莫名的类型错误。
四、关键差异梳理:定义端与调用端的行为对比
理清二者区别的核心在于分清“定义端的打包”与“调用端的解包”两组动作:
- 操作主体不同:
- 定义端的
def f(*args)是收集打包:调用端送来多个元素,函数定义负责将它们聚集成一个元组。 - 调用端的
f(*my_tuple)是拆解展开:将现存元组拆解为逗号分隔的独立位置参数,传递给底层调用栈。
- 定义端的
- 性能与内存分配:
直接传参
f(t)是纯指针引用传递,无任何额外对象创建;而调用f(*args)时,无论实参是否已经来自某个元组,解释器都会在函数栈帧准备阶段新分配一个 tuple 容器用于承载这些参数。如果该函数在千万次高频循环中被执行,直接传参由于避免了重复创建中间元组,具有略优的运行开销。 - 类型提示(Type Hinting)表达力:
使用直接传参时,可以通过
tuple[int, str, bool]清晰表达异构定长元组的字段契约;而*args: int只能约束“所有位置实参均为整数”这种同质序列,难以对特定位置的元素类型和总长度进行有效静态约束。
五、接口设计决策:何时直接传参,何时使用*args?
在实际工程架构与 API 接口设计中,选择直接传参还是 *args 并非个人代码风格偏好,而是取决于数据本身的业务语义与消费场景。
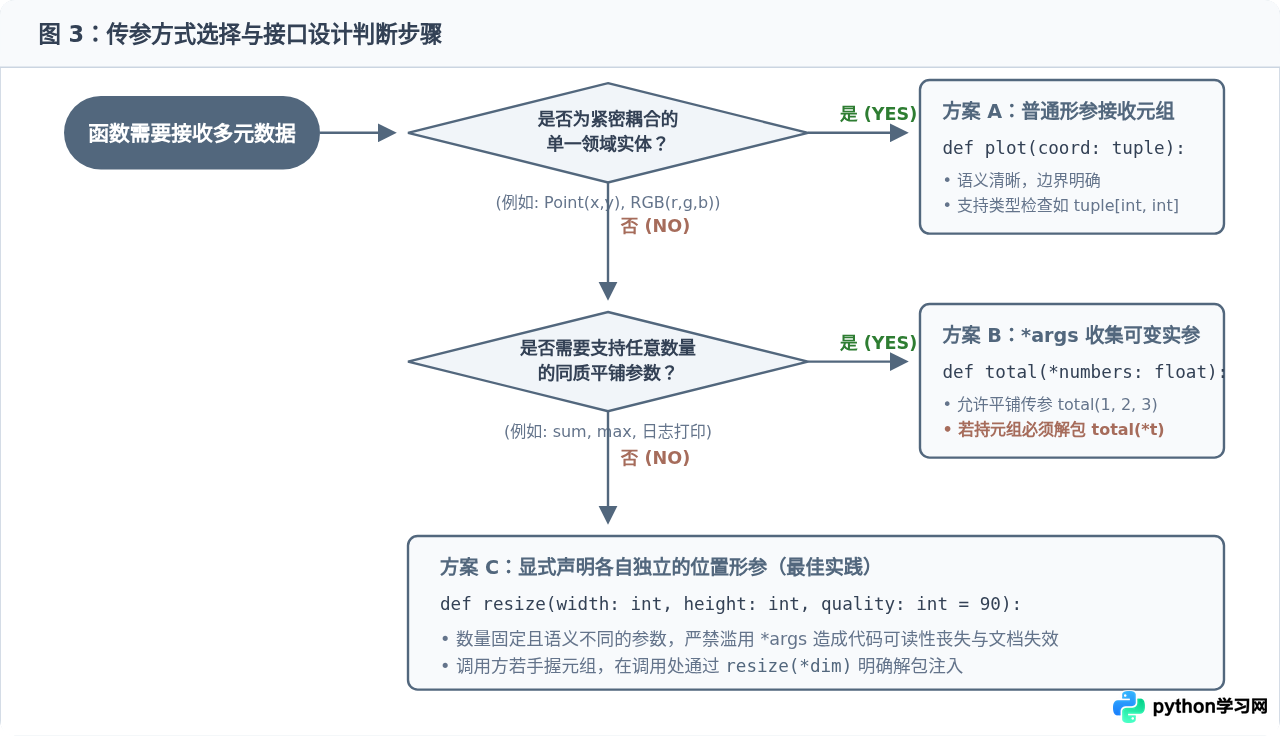
1. 优先使用普通形参直接接收元组的场景
- 数据属于单一领域实体(Domain Entity):例如屏幕坐标
(x, y)、三维向量(x, y, z)、颜色值(r, g, b, a)或包围盒(left, top, right, bottom)。这些数据项之间彼此绑定、缺一不可,作为一个整体流转时可读性最高。 - 需要作为字典键或缓存参数:元组是不可变的,直接接收并作为
dict键或@lru_cache依赖传递时,保持对象形态最为平滑。 - 避免歧义与调用污染:如果函数未来可能扩展其他独立参数(如配置选项、调试标志),使用独立元组可以保持签名清晰,例如
def process(data_tuple, timeout=30, verbose=False):,不会因为*args吞没后续的所有位置输入。
2. 优先使用 *args 变长参数的场景
- 同质聚合型函数:类似于标准库的
min(*args)、max(*args)、os.path.join(*paths),函数旨在对数量任意的同类型元素进行批量处理。 - 装饰器与通用代理转发:在编写包装器时,利用
def wrapper(*args, **kwargs): return target(*args, **kwargs)实现对原函数参数的原样穿透透传。 - 提供自然流畅的调用接口:当希望调用方无需额外书写外层括号即可直接罗列参数时,例如命令行解析工具或数学多项式求值。
六、总结与特性对照
为了在开发与代码审查中快速查验,下表对两种方案的核心特性与行为进行了全面对比:
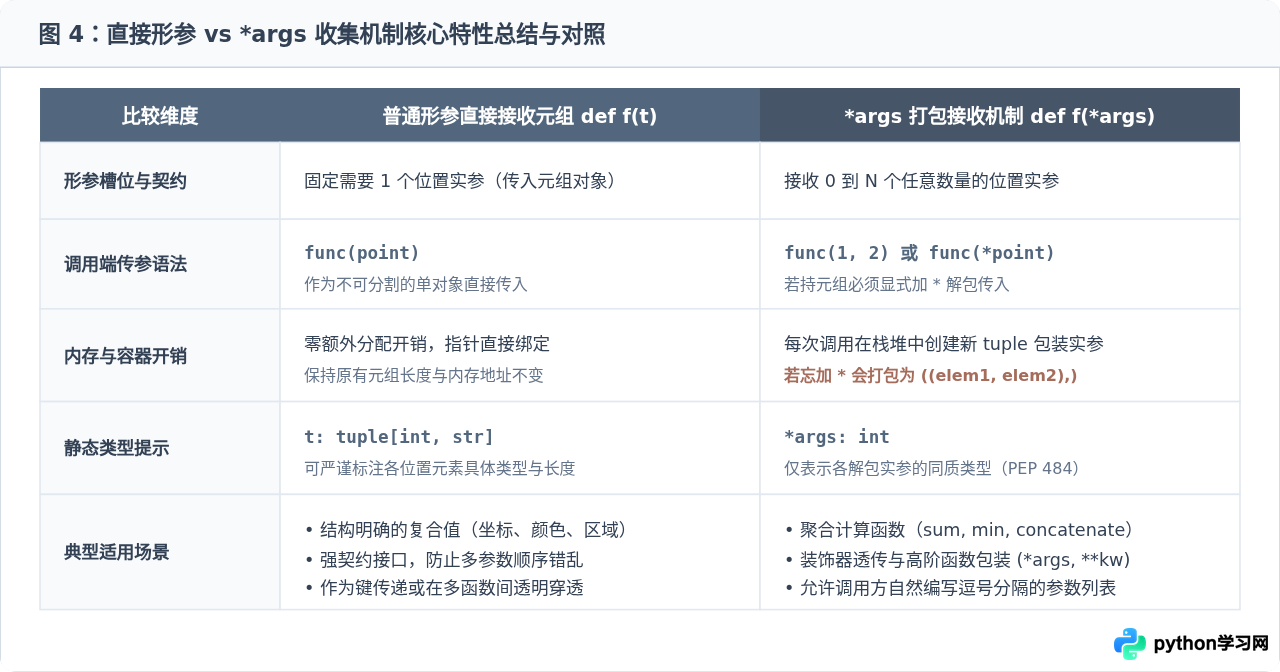
综上所述,Python 函数定义中接收元组的两种方式各有其定位:直接传参以明确的结构和单实体为导向,适合表达边界严密、结构固定的领域数据;*args 则以灵活的位置参数收集为导向,适合平铺传入与动态转发。在日常开发中,切忌把 *args 当作单纯接收容器的万能语法,若调用端持有现有元组,牢记显式使用 * 进行解包,方能避免不经意的结构嵌套与运行时异常。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















