


Python strip、lstrip和rstrip去除首尾字符的技巧
深入解析Python中strip、lstrip与rstrip三个字符串去字符方法的运行机制、使用技巧与常见陷阱,帮助开发者准确清理空白与指定字符集合。
在 Python 文本清洗与字符串预处理中,strip()、lstrip() 和 rstrip() 是清理首尾杂质的核心工具。本文将详细解析这三个方法的作用范围、底层“字符集合”匹配机制,并通过具体对比说明它们与 Python 3.9+ 字符串前后缀删除方法的本质区别。
一、三大方法的作用边界与默认行为
在不传入任何参数时,strip()、lstrip() 与 rstrip() 的默认行为是移除目标字符串两端或单侧的所有空白字符。这些空白字符不仅包含常见空格(ASCII 32),还涵盖制表符 \t、换行符 \n、回车符 \r、换页符 \f 以及垂直制表符 \v。
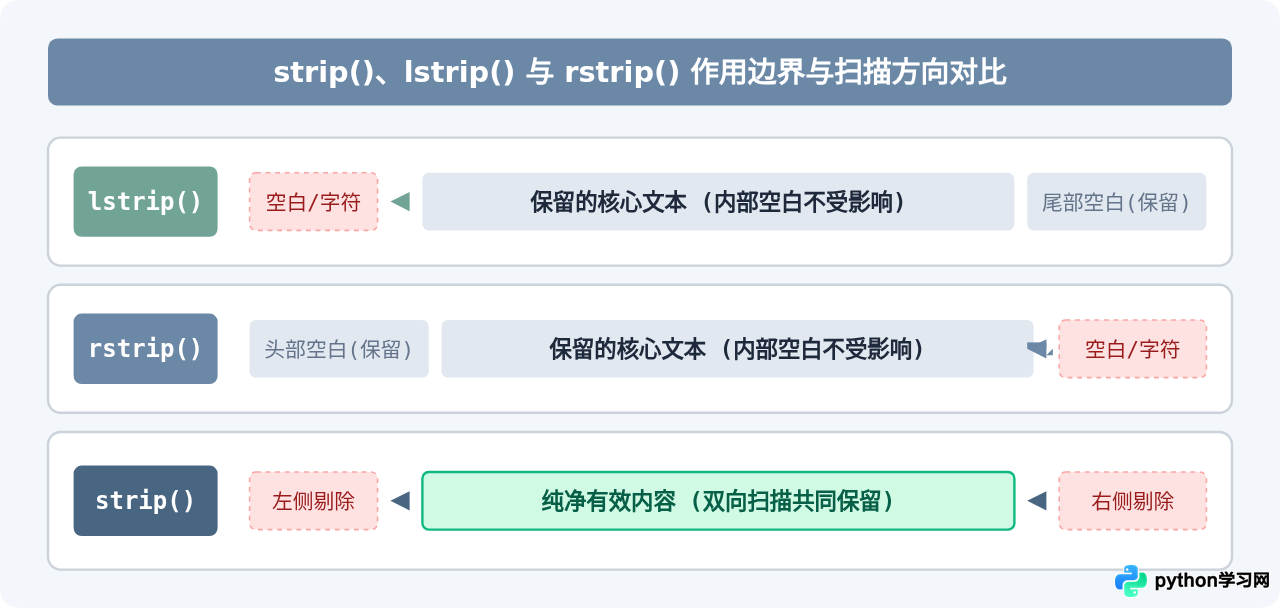
三者的根本差异在于扫描处理的方向与端点边界:
lstrip()(Left Strip):仅从字符串的左侧(起始端)向右扫描,剥离连续命中的目标字符,一旦遭遇首个不在清理范围内的字符便立刻终止。rstrip()(Right Strip):仅从字符串的右侧(结束端)向左扫描,剥离连续命中的目标字符,同样在遇到首个非清理字符时停止。strip():同时从左侧和右侧双向独立执行扫描剥离,等价于先执行lstrip()再执行rstrip()。位于字符串中间部位的任何字符均不会被触及。
# 默认去除首尾空白字符的基本示例
raw_text = "  \t\n  Hello Python World! \r\n  "

left_cleaned = raw_text.lstrip()
right_cleaned = raw_text.rstrip()
both_cleaned = raw_text.strip()

print(repr(left_cleaned))
print(repr(right_cleaned))
print(repr(both_cleaned))'Hello Python World! \r\n '
' \t\n Hello Python World!'
'Hello Python World!'
二、核心机制:chars 参数是“字符集合”而非“字符串前缀”
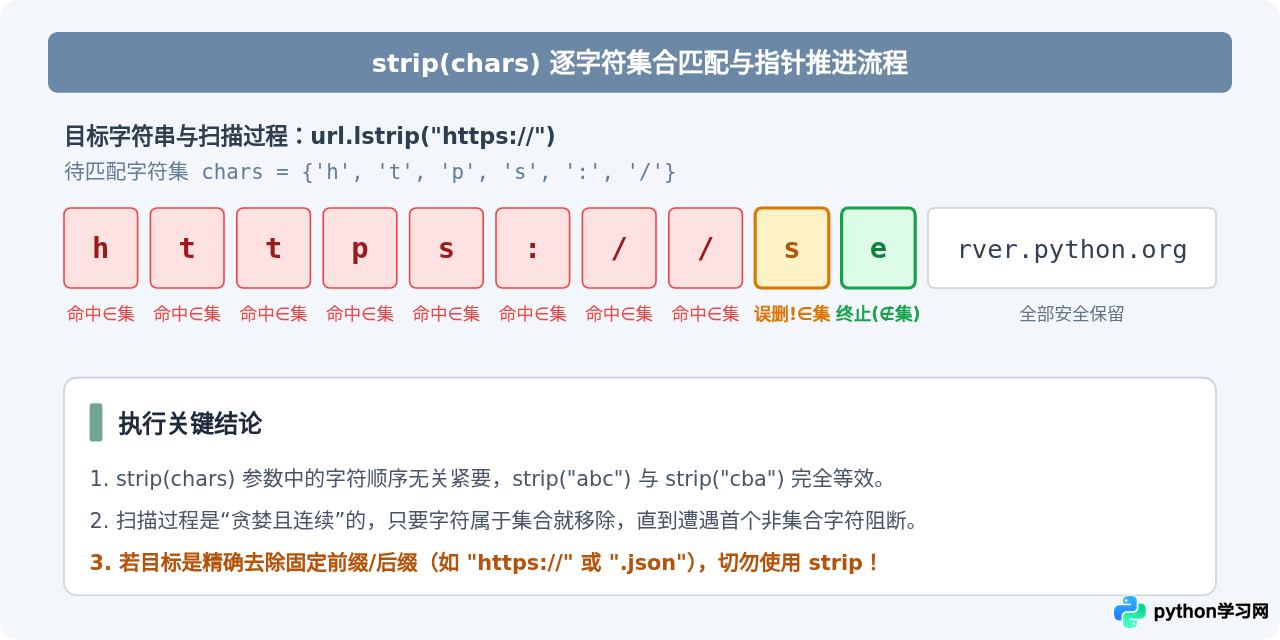
这是 Python 初学者乃至部分中级开发者最常出现误解的地方。当向方法传入参数,如 str.strip(chars) 时,chars 并不是 一个按照字面顺序严格匹配的子字符串或固定前缀,而是一个由所有待删除字符组成的无序集合(Set of Characters)。
底层算法的实际执行逻辑为:
- 初始化指针定位在字符串的首端或末端;
- 检查当前指针位置的单字符是否包含在
chars所给出的字符集内; - 如果在集合内,则剔除该字符,指针顺次向内推进一步;
- 一旦遇到第一个不在
chars字符集中的字符,扫描立即终止并返回剩余切片; - 因此,字符在
chars参数中的排列顺序完全不影响剥离结果。
url.strip("https://") 去除网址协议头,这会导致严重的数据损毁。因为参数 "https://" 实际上构建了一个字符集 {'h', 't', 'p', 's', ':', '/'}。只要网址开头的域名包含这些字符(例如 s 或 p),它们就会被一并删掉!
# 演示 chars 集合匹配引发的非预期行为
url = "https://server.python.org"

# 错误用法:误将 strip 当作子字符串去除
faulty_result = url.strip("https://")
print("错误剥离结果:", faulty_result)

# 为什么会变成 "erver.python.org"?
# 因为在删完 "https://" 后,域名的第一个字母是 's',
# 而 's' 恰好在集合 {'h', 't', 'p', 's', ':', '/'} 中,所以被继续剥离!
# 直到遇到 'e'(不在集合中),扫描才停止。错误剥离结果: erver.python.org
三、实用技巧:高频数据清洗场景实战
虽然不能用它来安全去除固定前缀,但在处理杂乱文本、配置项解析以及多重边界符清理时,strip() 的集合特性反而成为极为强大的利器。
技巧 1:多重标点与符号的一次性剥离
在解析自然语言词汇或爬取页面文本时,单词两端常常伴随不规则的引号、括号、多余下划线或逗号。此时可以向 chars 传入包含所有可能边界符号的字符串,一条语句即可清理干净。
# 一次性剥离多种边界标点与包裹符号
raw_words = ['"name",', "('description')", "__init__", "[$199.99]!"]

# 目标:提取纯净标识或数值核心
clean_words = []
for word in raw_words:
    # 传入需要剥离的符号集合:双引号、单引号、括号、下划线、方括号、逗号、感叹号及美元符号
    cleaned = word.strip('"\'()_[]!,$')
    clean_words.append(cleaned)

print("清洗后的词汇列表:", clean_words)清洗后的词汇列表: ['name', 'description', 'init', '199.99']
技巧 2:与 splitlines 及列表推导式协同解析文本
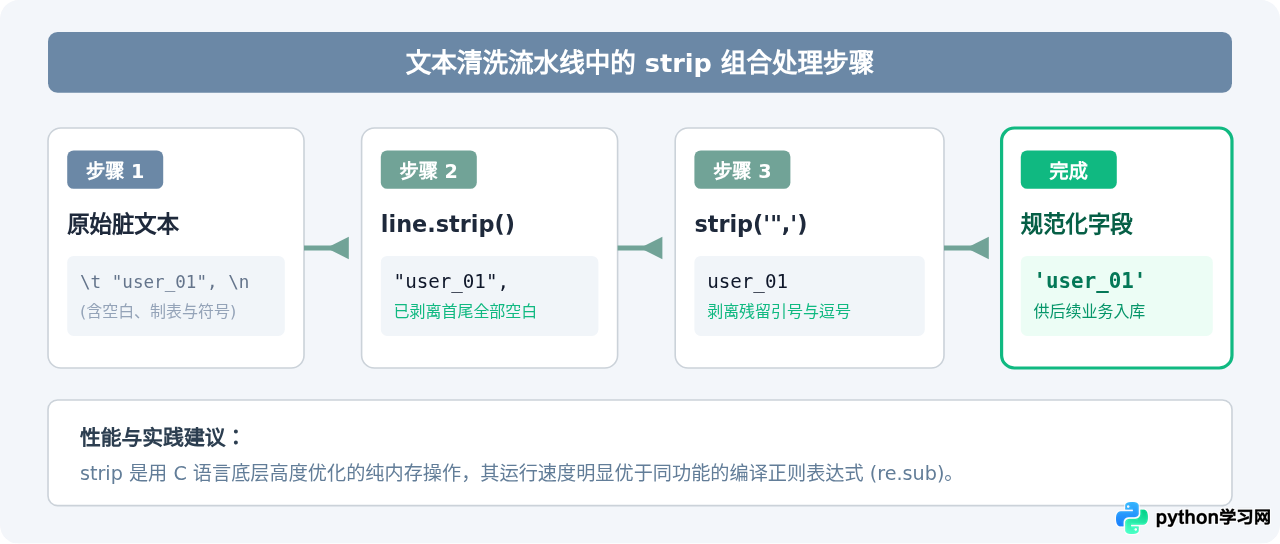
读取文件或处理多行输入时,空行与行首缩进往往会干扰业务逻辑。利用 strip() 与列表推导式配合,可以快速完成行过滤与规范化。
config_data = """
    # 数据库连接配置
    host = localhost
    port = 5432

    username = postgres

    # 结束标记
"""

# 清洗配置项:去除每行两端空白,同时过滤空行和注释行
parsed_lines = [
    line.strip()
    for line in config_data.splitlines()
    if line.strip() and not line.strip().startswith("#")
]

print("有效配置条目:")
for item in parsed_lines:
print(" -", item)有效配置条目:
- host = localhost
- port = 5432
- username = postgres
四、精准去除前后缀:现代 Python 的选型建议
如果业务需求是精确去除特定的字符串前缀或后缀(例如剔除 http://、去除文件名末尾的 .py 或 .tar.gz),不应该使用 strip() 系列方法。
针对这一普遍痛点,Python 3.9 正式引入了两个专门的原生方法:
str.removeprefix(prefix):如果字符串以prefix开头,则切除该前缀并返回剩余部分;否则原样返回。str.removesuffix(suffix):如果字符串以suffix结尾,则切除该后缀并返回剩余部分;否则原样返回。
filename = "report_test.py.py"
protocol_url = "https://server.python.org"

# 正确精确去除前缀 (Python 3.9+)
clean_url = protocol_url.removeprefix("https://")
print("removeprefix 结果:", clean_url)

# 正确精确去除后缀 (只切除末尾对应的一个完整后缀)
base_name = filename.removesuffix(".py")
print("removesuffix 结果:", base_name)

# 对比:如果误用 rstrip(".py")
wrong_name = filename.rstrip(".py")
print("rstrip 错误结果:", repr(wrong_name))
# 解释:rstrip 会将 '.'、'p'、'y' 均视作待删字符,
# 导致 "report_test" 结尾的 't' 若在集合中也会被波及。removeprefix 结果: server.python.org
removesuffix 结果: report_test.py
rstrip 错误结果: 'report_test'
startswith() 或 endswith() 封装自定义函数,而不是冒险使用 strip():
def safe_remove_prefix(text, prefix):
    if text.startswith(prefix):
        return text[len(prefix):]
    return text
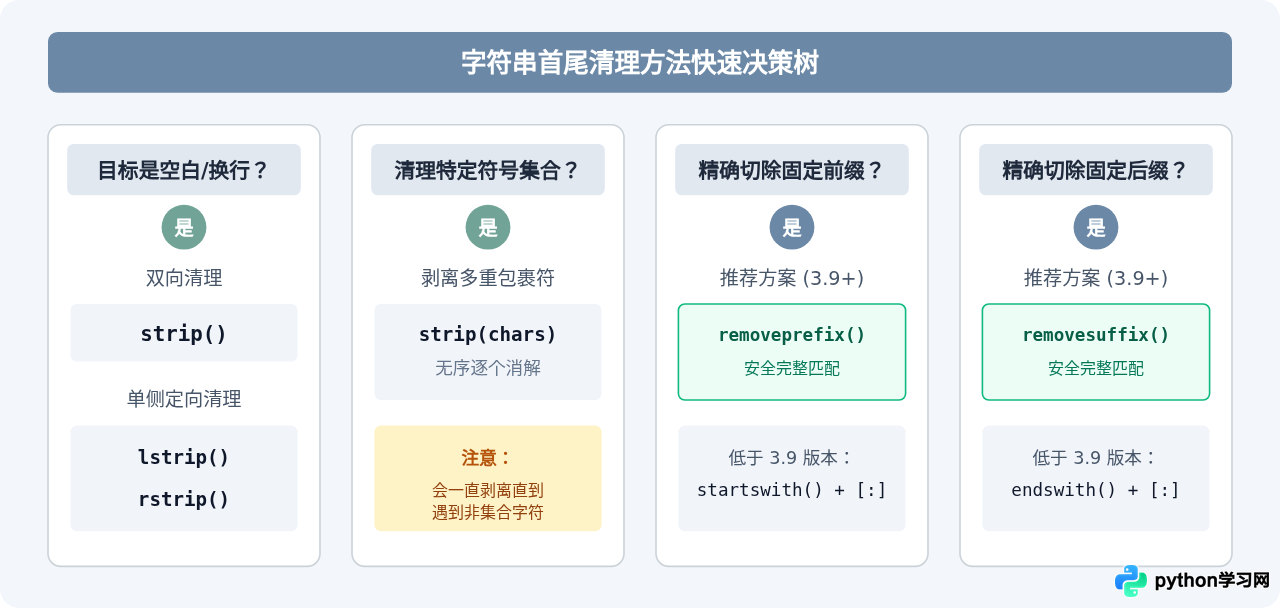
五、选型总结与决策指南
为了在实际开发中做出准确的选择,可以依据以下规则进行方法选型:
| 处理目标 | 推荐方法 | 匹配模式 | 典型适用示例 |
|---|---|---|---|
| 清理两侧未知的空白/换行 | text.strip() |
字符集合(默认所有空白) | 表单输入清理、文本行归一化 |
| 仅清理行首缩进 / 行尾换行 | text.lstrip() / text.rstrip() |
字符集合(单侧) | 格式化代码缩进、逐行读取文件 |
| 去除两端多种无序符号 | text.strip(chars) |
字符集合(自定义组合) | 剥离多重包裹引号、括号、多余下划线 |
| 精确切除固定协议/前缀 | text.removeprefix(prefix) |
严格子字符串前缀 | 网址去协议头、统一剥离模块命名前缀 |
| 精确切除文件扩展名/后缀 | text.removesuffix(suffix) |
严格子字符串后缀 | 剥离指定后缀 .json、_backup |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















