


Python正则表达式分组捕获与反向引用规则
深入解析Python正则表达式中的分组捕获机制、编号规则与反向引用语法,对比模式内匹配与re.sub替换场景的区别与避坑要点。
re 模块中,正则表达式的分组捕获用于结构化提取目标文本,而反向引用则允许我们在同一个匹配模式或后续的替换操作中精准复用已捕获的片段。理解并掌握普通捕获组、命名分组、非捕获组的编号序列,以及在匹配模式(\1、(?P=name))与替换字符串(\g<1>、\g<name>)中的具体差异,是写出安全、高效、可维护正则代码的关键。
一、捕获组基础与括号编号规则
在正则表达式中,普通圆括号 (...) 会创建一个“捕获组(Capturing Group)”。捕获组不仅将括号内的子模式视为一个整体以便应用量词,还会将匹配到的子字符串保存下来,供后续提取或引用。
Python 遵循绝大多数现代正则引擎的通用编号准则:捕获组的序号由左圆括号 ( 从左至右出现的次序决定,从数字 1 开始递增。整个正则表达式的匹配结果默认由编号 0 表示(即 match.group(0))。即使存在多层括号嵌套,也严格按照左括号的位置逐一计数,内层括号的编号必定在其左外层括号之后。
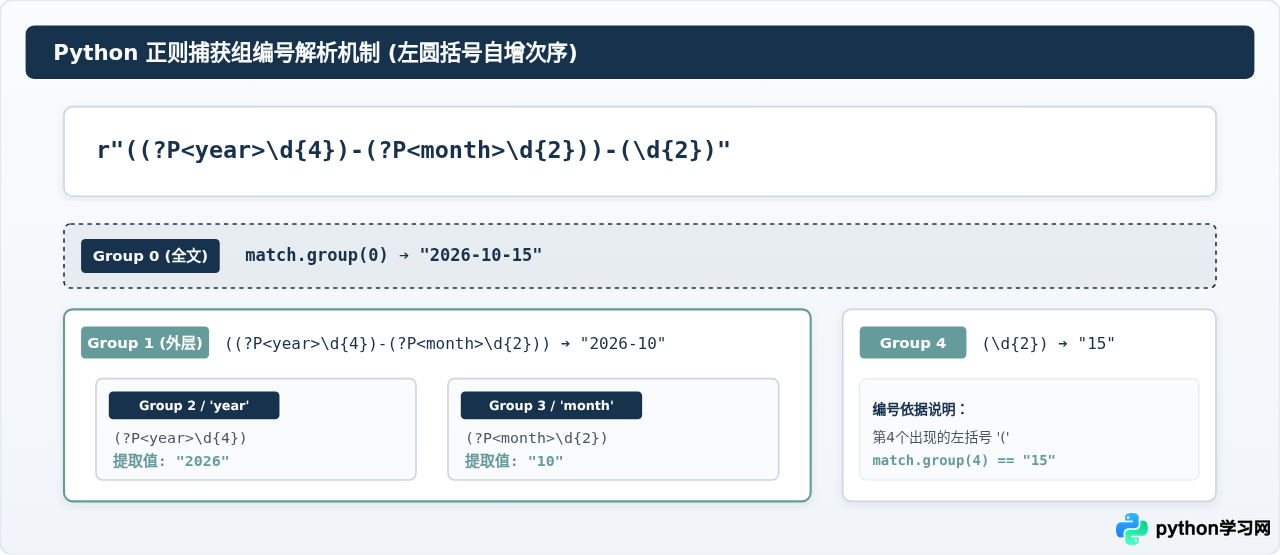
在 Python 代码中,通过 Match 对象的几个核心方法即可检视各分组内容:
match.group(0):返回完整匹配结果;match.group(1, 2, ...):传入一个或多个组号,返回对应捕获文本构成的单值或元组;match.groups():返回包含所有捕获组(从编号 1 开始)文本的元组;match.groupdict():返回所有命名分组构成的键值对字典。
import re

text = "2026-10-15"
pattern = r"((?P<year>\d{4})-(?P<month>\d{2}))-(\d{2})"

match = re.search(pattern, text)
if match:
    print("全文 group(0):", match.group(0))  # 2026-10-15
    print("外层 group(1):", match.group(1))  # 2026-10
    print("内层年份 group(2):", match.group(2)) # 2026
    print("内层月份 group(3):", match.group(3)) # 10
    print("日 group(4):", match.group(4))     # 15
    print("所有捕获组 groups():", match.groups()) # ('2026-10', '2026', '10', '15')
二、非捕获组与命名捕获组
随着正则表达式逻辑变复杂,普通捕获组会带来两个常见问题:一是许多括号仅仅为了设置操作符优先级(如 (https?|ftp)),并不需要提取数据,多余的捕获会消耗额外内存并打乱其他组的数字序号;二是纯数字编号在大型模式中极难维护,一旦在前方增删括号,后方所有数字索引都要重写。
1. 非捕获组:(?:...)
如果圆括号内部开头带有 ?:,例如 (?:https?|ftp),该组即被标记为非捕获组。非捕获组具备括号的分组聚合特性,但不分配序号、不记录捕获内容、不出现在 match.groups() 中,也不会被数字索引或反向引用寻址。推荐在不需要保留该部分匹配文本时,始终优先采用非捕获组以提升匹配效率。
2. 命名捕获组:(?P<name>...)
Python 引入了 (?P<name>...) 语法,允许为捕获组赋予人类可读的字符串键名。命名组不仅具备普通捕获组的全部能力(它在后台依然会按照左括号次序分配一个数字编号),还额外支持通过 match.group('name') 访问,并通过 match.groupdict() 批量导出。
# 非捕获组与命名捕获组协同使用
pattern = r"(?:https?://)?(?P<domain>[a-zA-Z0-9.-]+)(?::(?P<port>\d+))?"

url = "http://api.example.com:8080"
match = re.search(pattern, url)
if match:
    # 协议部分使用的是 (?:...),因此不占用组号
    print(match.groupdict())  # {'domain': 'api.example.com', 'port': '8080'}
    print("域名:", match.group('domain'))  # 也可以写 match.group(1)
    print("端口:", match.group('port'))    # 也可以写 match.group(2)
三、匹配模式内部的反向引用规则
反向引用(Backreference)是正则表达式最具威力的特性之一。它的本质含义是:“此处的字符必须与前面某个捕获组实际匹配到的文本完全一致”。请注意,它并非再次应用那段正则规则,而是要求字面内容完全相等。
1. 模式内部反向引用的语法形式
- 数字反向引用:使用
\1、\2... 引用对应编号的捕获组; - 命名反向引用:使用
(?P=name)引用此前声明过的命名捕获组。
例如,若要匹配成对的 HTML 标签(如 <h1>标题</h1>),如果仅仅写 <[a-z0-9]+>.*?</[a-z0-9]+>,就会错误地匹配类似 <h1>标题</div> 的错误闭合结构。使用捕获组与反向引用则能强制闭合标签与开启标签完全相同。
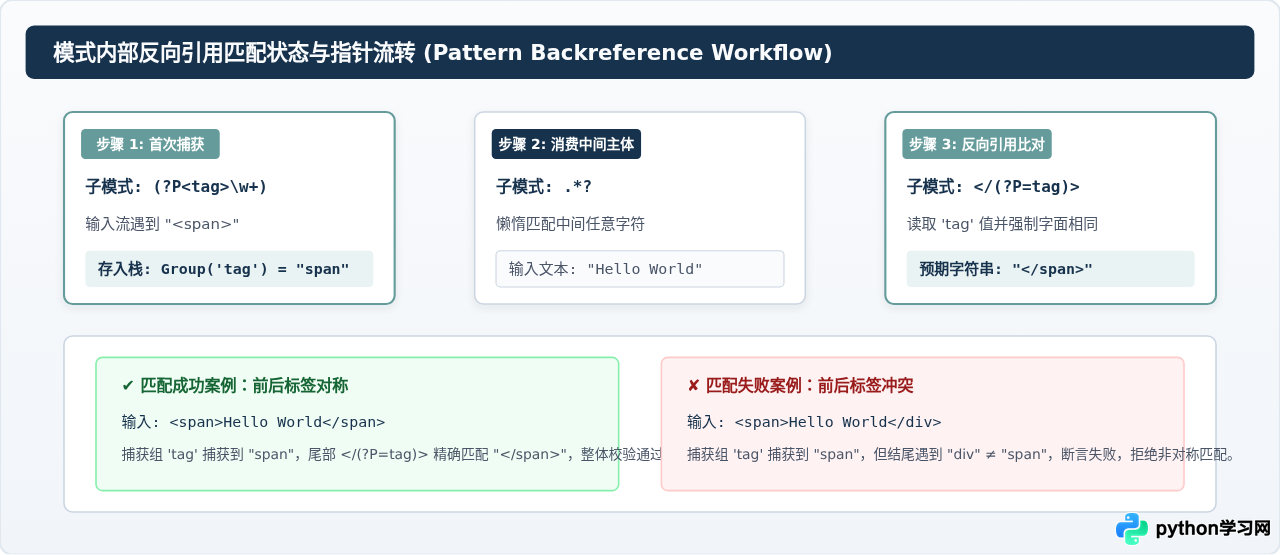
常见的经典场景还包括成对引号匹配与重复单词检测:
import re

# 场景 1: 成对引号匹配 (防止单双引号混用如 "abc')
quote_pattern = r"(?P<q>['\"])(.*?)(?P=q)"
text1 = '有效字符串:"Hello", \'World\'; 无效字符串:"Wrong\''
matches = [m.group(0) for m in re.finditer(quote_pattern, text1)]
print("成功匹配的成对引号项:", matches)  # ['"Hello"', "'World'"]

# 场景 2: 检测连续出现的重复单词 (例如 "the the")
dup_pattern = r"\b(\w+)\s+\1\b"
text2 = "This is is a test test string"
print("检测到的重复词:", re.findall(dup_pattern, text2)) # ['is', 'test']
四、替换操作 (re.sub) 中的反向引用规则与八进制避坑
在调用 re.sub(pattern, repl, string) 进行文本替换时,repl 字符串同样可以使用反向引用来调取前面捕获的内容。但在替换字符串中,语法与模式匹配内部存在显著区别。
1. 替换字符串中的引用语法
- 通用安全形式:
\g<1>、\g<2>(通过组号); - 命名分组引用:
\g<name>(通过组名); - 简写形式:
\1、\2(仅在后方不跟随数字时可用); - 引用完整匹配:
\g<0>。
如果需要在第 1 个捕获组的内容后面追加一个字面数字 0,若书写为 \10,Python 正则引擎会尝试解析为第 10 个捕获组;若总捕获组数量少于 10,则会将其解析为八进制 ASCII 字符 \010(即退格键 BS)!因此,在 re.sub 替换串中,推荐无条件采用 \g<1> 或 \g<name> 规范写法。
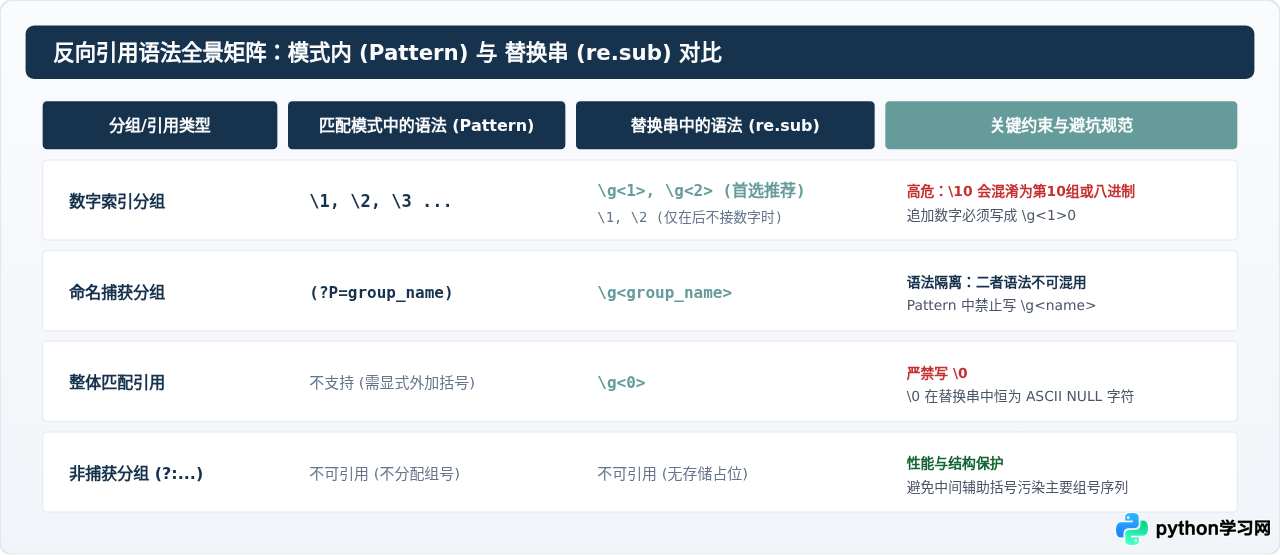
下面是一个具体的日期重排与字段脱敏示例:
import re

# 任务 1: 将 ISO 日期 "2026-10-15" 重排为 "15/10/2026"
date_str = "2026-10-15"
# 使用 \g<name> 语法
new_date = re.sub(r"(?P<y>\d{4})-(?P<m>\d{2})-(?P<d>\d{2})", r"\g<d>/\g<m>/\g<y>", date_str)
print("重排日期:", new_date)  # 15/10/2026

# 任务 2: 在捕获数字后拼接字面数字 "00"
# 错误写法: re.sub(r"(\d+)", r"\100", "5") -> 会寻找编号为 100 的组并崩溃或乱码
# 正确写法: 显式包裹 \g<1>
score = "5"
adjusted = re.sub(r"(\d+)", r"\g<1>00", score)
print("追加数字结果:", adjusted)  # 500
五、综合决策流程与最佳实践清单
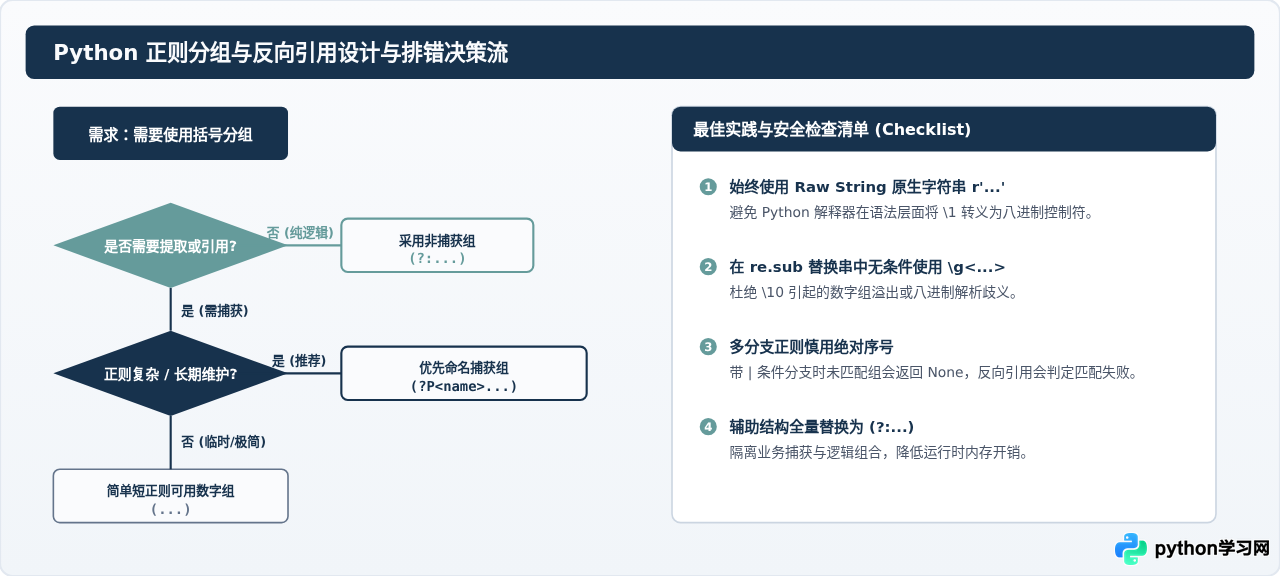
在设计含有分组与反向引用的正则表达式时,可以遵循下述标准工程化流程,从“是否需要持久存储”、“是否跨度较长”、“应用场景”三个维度快速推导出最稳妥的语法组合。
六、核心要点总结速查
| 语法形式 | 名称/机制 | 生效位置 | 典型应用场景 |
|---|---|---|---|
(pattern) |
普通捕获组 | 匹配模式 | 提取子模式文本,以左括号自增分配 1, 2... 序号 |
(?:pattern) |
非捕获组 | 匹配模式 | 仅做逻辑聚合或结合量词,不分配序号,性能最优 |
(?P<name>pattern) |
命名捕获组 | 匹配模式 | 大型工程中为关键数据提供具名语义提取 |
\1, \2 |
数字反向引用 | 匹配模式 | 确保成对符号(引号、括弧、标签)严格一致 |
(?P=name) |
命名反向引用 | 匹配模式 | 与命名捕获组配套,提升模式的可读性 |
\g<1>, \g<name> |
替换串反向引用 | re.sub 的 repl |
文本格式重排、清洗脱敏,彻底规避八进制歧义 |
综上所述,掌握分组捕获与反向引用不仅是提高提取效率的技巧,更是保证正则表达式严谨性与健壮性的基础。在实际开发中,坚持使用原生字符串 r'...'、为复杂结构赋予命名组、在替换时严谨使用 \g<...>,便能彻底避开绝大部分常见的转义与序号陷阱。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















