


Python机器学习经典教材推荐:从数学理论到代码实现
针对机器学习学习者常遇到的理论脱节与代码调包困境,系统梳理从数学原理推导到Python工程落地的经典教材体系,提供四阶段学习路线与实战转化指南。
一、为什么必须建立“数学理论与代码实现”的对应映射
很多初学者容易将机器学习割裂为两个互不相交的世界:数学推导属于纯理论研究,而写代码只是调用 model.fit() 与 model.predict()。这种割裂会在遇到实际工程瓶颈时带来严重阻碍。
当模型的泛化误差过大时,如果缺乏理论直觉,就无法判断究竟是高偏差(欠拟合)还是高方差(过拟合),只能盲目尝试各类算法;而若缺乏矩阵运算与代码实现能力,面对文献中的新型损失函数或定制优化器时,也无法将其转换为稳定的数值计算程序。
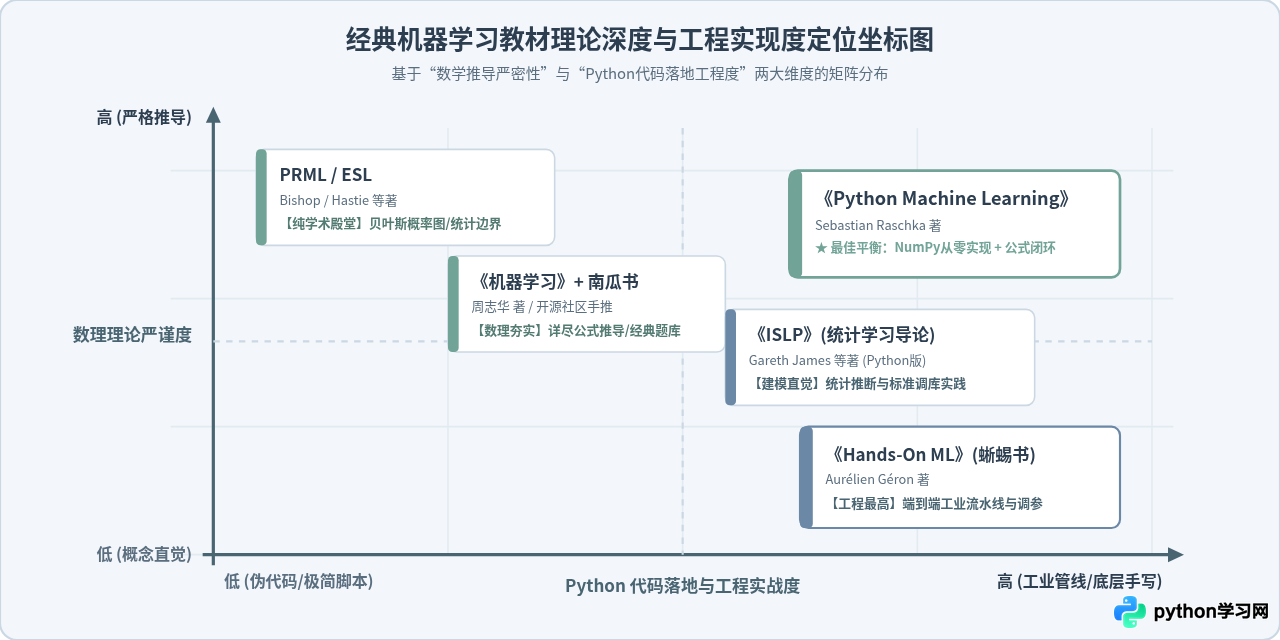
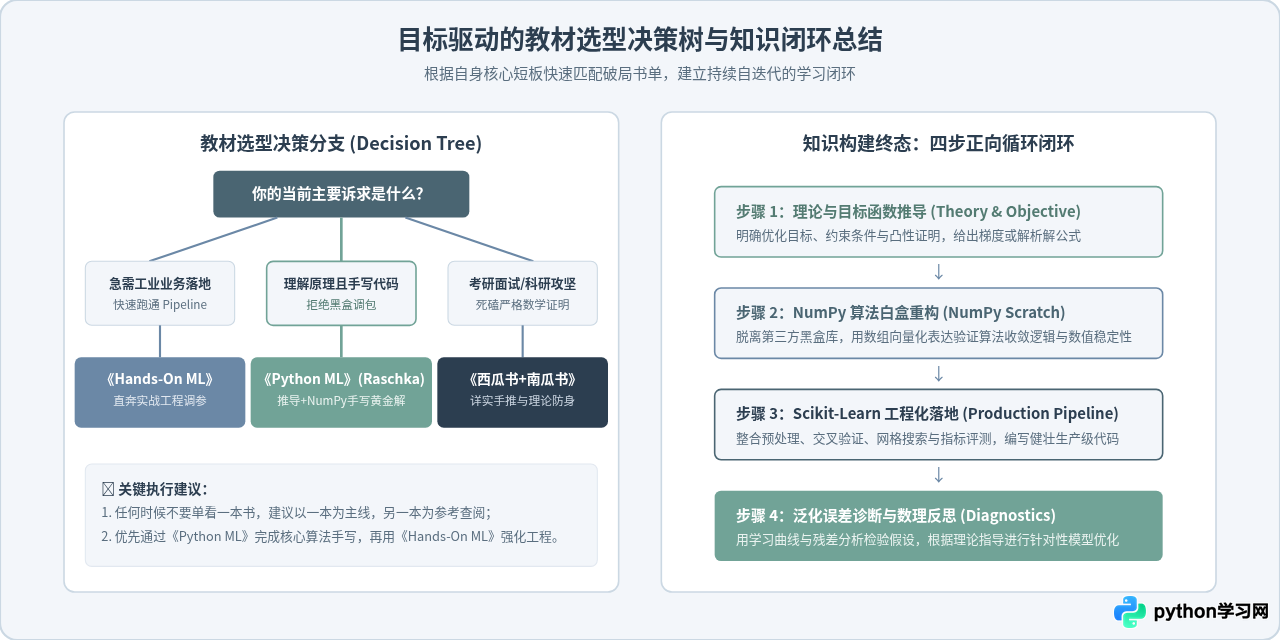
建立两者对应关系的核心在于分层演进。从数学公理出发定义目标函数,利用微积分与凸优化推导参数解析解或梯度更新公式,随后通过 NumPy 进行数组向量化实现,最后对接 Scikit-Learn 的标准评估流程与生产管线。这一层级递进结构是每一位算法工程师的知识骨架。
二、核心经典教材定位与梯度推荐
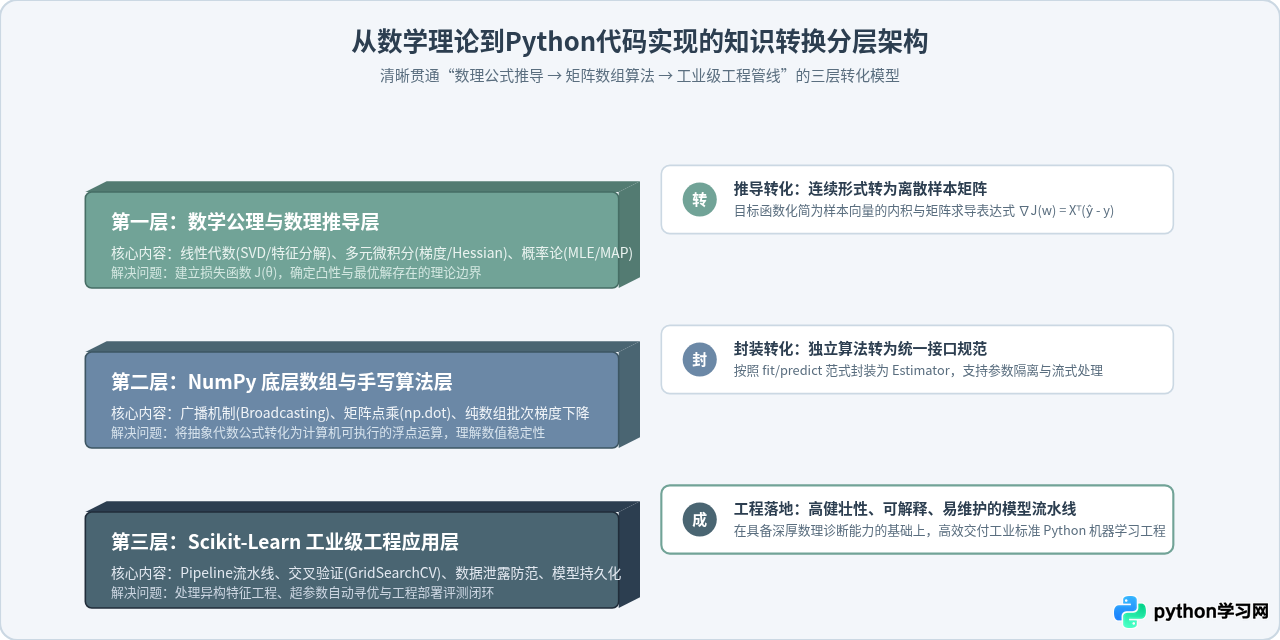
国内外机器学习教材浩如烟海,但能够在“数学理论深度”与“Python代码实现”之间保持良好平衡的书籍屈指可数。我们将这些经典著作按定位划分为三类:
这是目前将算法推导与纯 Python 代码结合得最扎实的经典教材。作者不仅是学术界活跃的学者,也是著名机器学习开源库 mlxtend 的作者。
特色与优势:书中每一个经典算法(感知机、Adaline、逻辑回归、支持向量机、决策树、随机森林)都遵循统一的节奏:先给出严谨的几何直觉与优化目标推导,接着使用纯 NumPy 从零手写一个独立的算法类,最后演示如何在 Scikit-Learn 中调用对应的生产级实现并比较差异。这种“先推导、再手写、后调库”的编排风格,极其适合希望彻底弄清底层逻辑的开发者。
作为统计学顶级巨著 ESL(The Elements of Statistical Learning)的姐妹篇,ISLR 长期以来是全球大学算法课的标准教材。近期官方推出的 Python 版(ISLP)补齐了此前仅有 R 语言示例的缺憾。
特色与优势:避开了高深测度论与繁杂的泛函分析,以极佳的直觉语言剖析过拟合、偏差-方差权衡(Bias-Variance Tradeoff)、交叉验证、收缩估计(Ridge与Lasso)以及决策树与提升法。每章末尾都配有详尽的 Python 实验室代码(Lab),基于 Scikit-Learn、Statsmodels 与 pandas,是建立严谨统计建模思维的最佳第一站。
前 Google 团队技术带头人撰写,封面为两只蜥蜴,常年稳居全球各大机器学习畅销榜首位。
特色与优势:本书是工程实践能力最强的教材。作者以一个完整的加州房价预测项目为开篇,从数据清洗、特征缩放、自定义转换器(Transformer)、Pipeline 封装、交叉验证网格搜索一直写到生产评估。数学部分侧重于核心直觉与边界限制,代码结构极为工整规范,完全遵循企业级工程交付标准。
周志华教授的《机器学习》逻辑紧凑、覆盖全面,是国内学术与考研面试的重要参考。但其特点是省略了大量的推导中间步骤,让初学者容易卡在关键公式上。开源社区编写的《南瓜书》专门针对西瓜书中的公式做了逐行详细推导,并补充了对应的 Python 验证代码。
特色与优势:适合在完成上述前两本书的编程积累后,用来系统梳理公式背后的矩阵微积分推导细节,夯实理论地基。
三、实战转化范式:从数学公式到 NumPy 手写
为了让读者直观理解教材中“推导到代码”的转换过程,以二分类逻辑回归(Logistic Regression)为例:
1. 数学理论推导
设输入特征矩阵为 $X \in \mathbb{R}^{m \times n}$,标签 $y \in \{0, 1\}^m$。模型预测概率由 Sigmoid 函数给出:
$$\hat{p} = \sigma(Xw + b) = \frac{1}{1 + e^{-(Xw + b)}}$$
通过极大似然估计(MLE),构造交叉熵损失函数(Cross-Entropy Loss):
$$J(w, b) = -\frac{1}{m} \sum_{i=1}^{m} \left[ y^{(i)} \log(\hat{p}^{(i)}) + (1 - y^{(i)}) \log(1 - \hat{p}^{(i)}) \right]$$
利用链式法则求梯度,得到参数权重 $w$ 与偏置 $b$ 的偏导数解析式:
$$\frac{\partial J}{\partial w} = \frac{1}{m} X^T (\hat{p} - y), \quad \frac{\partial J}{\partial b} = \frac{1}{m} \sum_{i=1}^{m} (\hat{p}^{(i)} - y^{(i)})$$
2. Python NumPy 向量化底层实现
在理解了上述推导后,我们在代码中无需编写两层嵌套循环去逐样本计算,而是直接利用 NumPy 的广播与矩阵点积完成极度紧凑且高效的向量化计算:
import numpy as np

class ScratchLogisticRegression:
    """
    基于 NumPy 手写实现的逻辑回归二分类器
    对应数学模型:Sigmoid 假设 + 二元交叉熵梯度下降
    """
    def __init__(self, learning_rate=0.05, n_iterations=1000):
        self.lr = learning_rate
        self.n_iterations = n_iterations
        self.weights = None
        self.bias = None
        self.loss_history = []

    def _sigmoid(self, z):
        # 裁剪防止 exp 溢出
        z_clipped = np.clip(z, -250, 250)
        return 1.0 / (1.0 + np.exp(-z_clipped))

    def fit(self, X, y):
        n_samples, n_features = X.shape
        # 参数初始化
        self.weights = np.zeros(n_features)
        self.bias = 0.0

        for _ in range(self.n_iterations):
            # 1. 前向传播:线性加权与激活
            linear_model = np.dot(X, self.weights) + self.bias
            y_pred = self._sigmoid(linear_model)

            # 2. 交叉熵损失监控
            eps = 1e-15
            y_pred_clipped = np.clip(y_pred, eps, 1 - eps)
            loss = - (1 / n_samples) * np.sum(
                y * np.log(y_pred_clipped) + (1 - y) * np.log(1 - y_pred_clipped)
            )
            self.loss_history.append(loss)

            # 3. 反向传播:矩阵向量化梯度计算
            dw = (1 / n_samples) * np.dot(X.T, (y_pred - y))
            db = (1 / n_samples) * np.sum(y_pred - y)

            # 4. 参数更新
            self.weights -= self.lr * dw
            self.bias -= self.lr * db
        return self

    def predict_proba(self, X):
        return self._sigmoid(np.dot(X, self.weights) + self.bias)

    def predict(self, X, threshold=0.5):
return (self.predict_proba(X) >= threshold).astype(int)dw = (1 / n_samples) * np.dot(X.T, (y_pred - y)) 这一行代码完全忠实地映射了数学公式 $\frac{\partial J}{\partial w} = \frac{1}{m} X^T (\hat{p} - y)$。手写过这几行代码的开发者,对学习率(learning_rate)如何影响收敛、梯度爆炸的原因以及特征缩放(StandardScaler)的必要性,会有刻骨铭心的体会。
四、四阶段系统学习路线规划
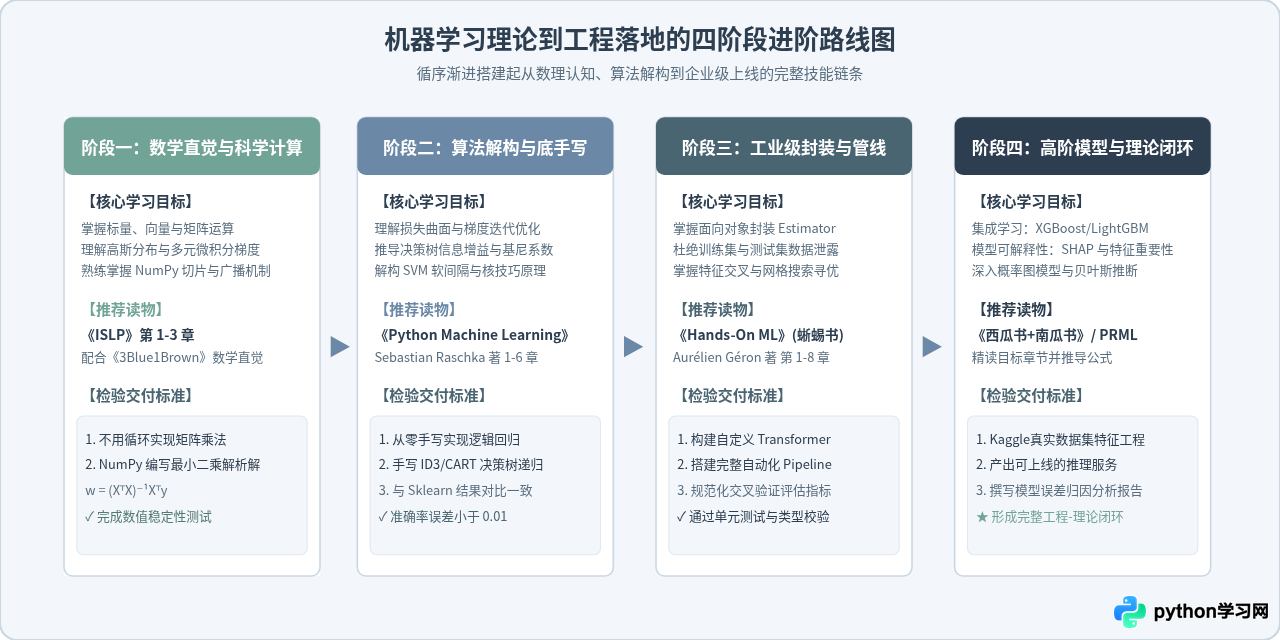
为了避免“看了很多书但不会写代码”或“写了很多脚本但不理解调参原理”的问题,推荐按以下四阶段循序推进:
五、根据背景与目标的教材选型决策指南
不同读者的知识储备和工作场景差异巨大,盲目按照固定书单阅读容易在半途受挫。下表根据读者的常见起点给出了针对性的阅读策略:
| 学习者当前背景 | 主要痛点 | 首选教材组合 | 实战验证产出 |
|---|---|---|---|
| 软件工程师 / 计算机专业 | 代码能力强,但调参全靠运气,缺乏偏差-方差理论直觉与泛化诊断能力 | 《ISLP》 + 《Python Machine Learning》 | 用纯 NumPy 手写逻辑回归与 SVM 决策边界,并用 Matplotlib 可视化损失曲面 |
| 数学 / 统计 / 物理专业 | 公式推导纯熟,但代码写得像数学草稿,无法对接 Scikit-Learn 工业工程管线 | 《Hands-On Machine Learning》(蜥蜴书) | 搭建包含自定义 Transformer、ColumnTransformer 与交叉验证的完整项目 |
| 高校科研 / 算法求职者 | 需要应对深度的白板推导、算法原理提问与经典论文阅读 | 《西瓜书+南瓜书》 + 《PRML》(精选章节) | 手推 SVM 对偶问题、EM 算法、高斯混合模型(GMM)公式并用 Python 验证数值解 |
六、高效阅读与避坑建议
在结合教材学习“从理论到代码”的过程中,有几个最容易浪费时间的误区需要引起注意:
- 避免过早陷入复杂的纯数学证明:如果遇到测度论、微分流形或复杂的泛函求导卡壳,应暂时退回算法的几何意义与二维可视化。先理解算法“在空间中如何切分样本”,再看优化目标公式,最后看代码。
- 拒绝只看不敲的“幻觉学习”:只在书页上看懂了公式或代码,不等于真正掌握。必须合上教材,在空白的 Jupyter Notebook 或 Python 文件中完整敲出前向传播、损失计算与参数更新,一旦报错,就是理解漏洞所在。
- 警惕缺乏规范的“草稿流脚本”:初学者常将所有变量散落在全局作用域中,命名混乱且无固定输入输出。在手写算法时,要养成封装成独立 Class 并遵循 Scikit-Learn 的
fit()、predict()接口规范,这能为后续阅读开源大项目代码打下坚实基础。
掌握机器学习从数学理论到 Python 代码实现并不是一蹴而就的短跑,而是一场反复打磨思维与工程习惯的远足。挑选一本最契合当前认知阶段的经典教材作为主轴,把书中的核心公式逐一转译为清晰健壮的 NumPy 代码,你将建立起真正可靠的算法工程底气。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















