


Python使用pathlib模块构建CSV文件路径的方法
详细讲解在Python中使用内置pathlib模块构建、管理及验证CSV文件路径的实用方法与最佳实践,包含动态命名、目录创建与读写集成。
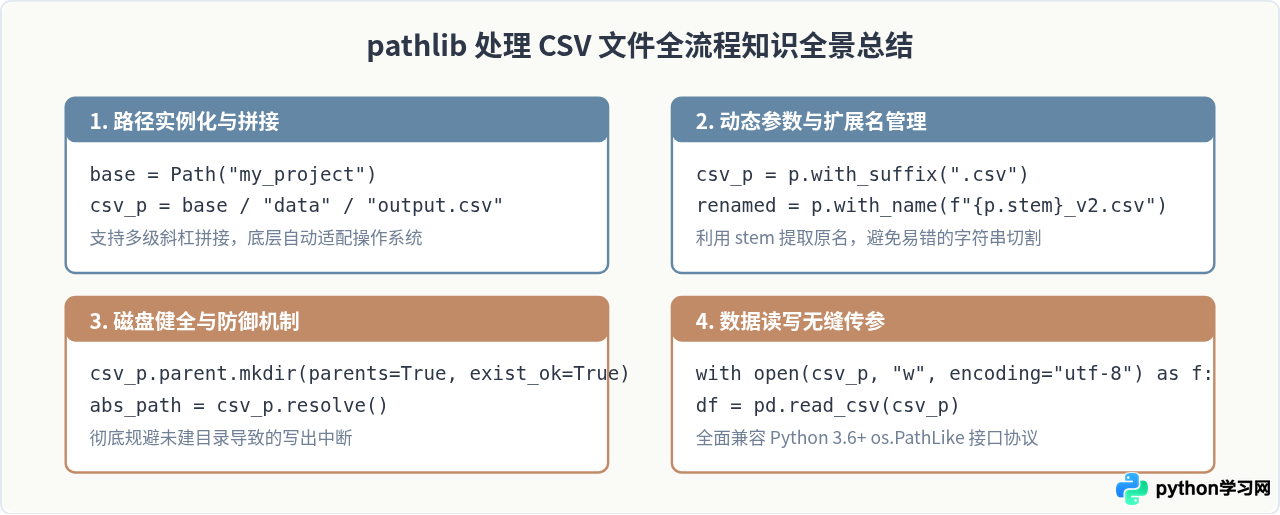
在Python中,使用内置的 pathlib 模块构建CSV文件路径,最核心的方式是通过 Path 类实例化路径对象,并利用直观的重载除号运算符 / 进行路径层级拼接。这种面向对象的设计不仅让代码结构清晰、语义直观,还能在底层自动抹平Windows反斜杠(\)与Linux/macOS正斜杠(/)的操作系统差异,配合 .with_suffix()、.resolve() 等方法,可构建出健壮且规范的跨平台CSV数据读写路径。
一、为什么推荐使用 pathlib 构建文件路径
在Python 3.4之前,路径拼接主要依赖 os.path.join()。这种方式本质上是对纯字符串进行处理,代码容易嵌套冗长,且字符串本身不包含路径属性与操作逻辑。而 pathlib 提供了面向对象的抽象,将文件系统中的路径封装为实体对象。对于经常需要批量读写、动态按日期命名或跨平台导出的CSV数据任务,pathlib 展现出多维度的优势:
- 语法直观:使用斜杠
/拼接子目录与文件名,比反复调用函数更加符合心智模型。 - 自带环境感知:自动根据运行环境生成对应的
WindowsPath或PosixPath,杜绝跨平台斜杠硬编码问题。 - 丰富的操作方法:无需反复引用
os、glob、shutil,路径对象本身就内置了检查存在、提取后缀、创建父目录等实用方法。 - 无缝衔接主流库:Python内置的
open()函数以及数据分析库pandas(如pd.read_csv())均原生支持接收Path对象。
二、基础构建:使用 Path 与斜杠运算符拼接 CSV 路径
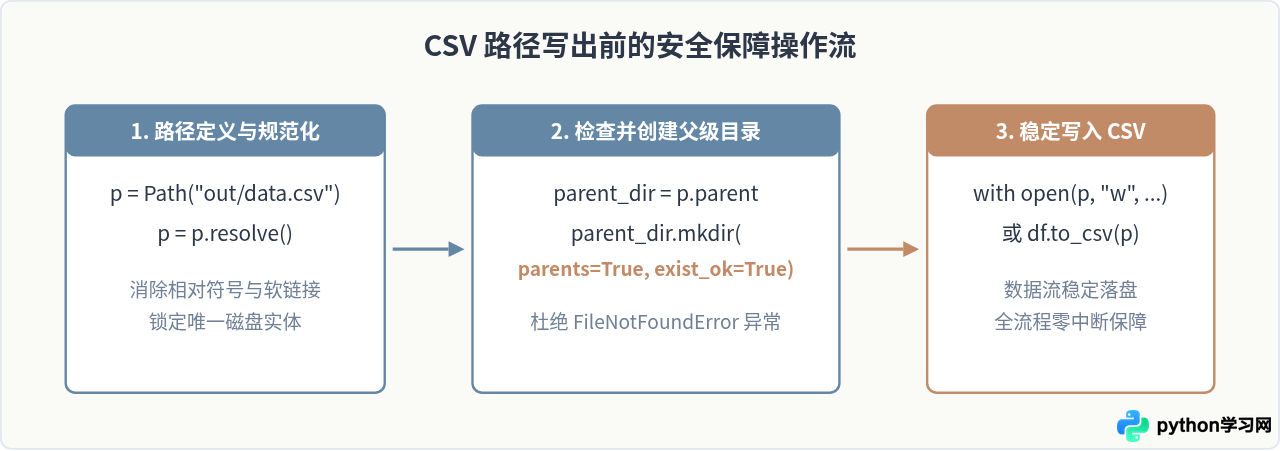
构建CSV路径的第一步是导入模块并定义基准目录。基准目录通常可以是当前工作目录、项目根目录或特定的数据存放路径。随后通过 / 逐步向后追加子目录与带 .csv 后缀的目标文件名。
from pathlib import Path

# 1. 以当前执行目录为基准构建
current_dir = Path.cwd()
csv_path = current_dir / "data" / "reports" / "sales_2026.csv"
print("生成的CSV路径:", csv_path)

# 2. 从相对路径构建
raw_data_path = Path("dataset/raw") / "users.csv"
print("相对路径对象:", raw_data_path)
在上述代码中,只要运算链条的起点或某一项是 Path 对象,后续使用 / 连接字符串都会自动返回一个新的 Path 对象,避免了手动拼写分隔符的语法风险。
三、动态构建:处理时间戳、批次命名与后缀安全替换
在日常数据处理与报表导出场景中,CSV文件名往往是根据日期、批次编号或运行参数动态生成的。pathlib 提供了高效且安全的动态路径处理机制:
1. 结合格式化字符串生成动态名称
from datetime import datetime
from pathlib import Path

export_dir = Path("exports")
today_str = datetime.now().strftime("%Y%m%d")
batch_id = "003"

# 动态组合包含业务参数的CSV路径
report_csv = export_dir / f"daily_report_{today_str}_batch_{batch_id}.csv"
print(report_csv)  # 输出示例: exports/daily_report_20261015_batch_003.csv
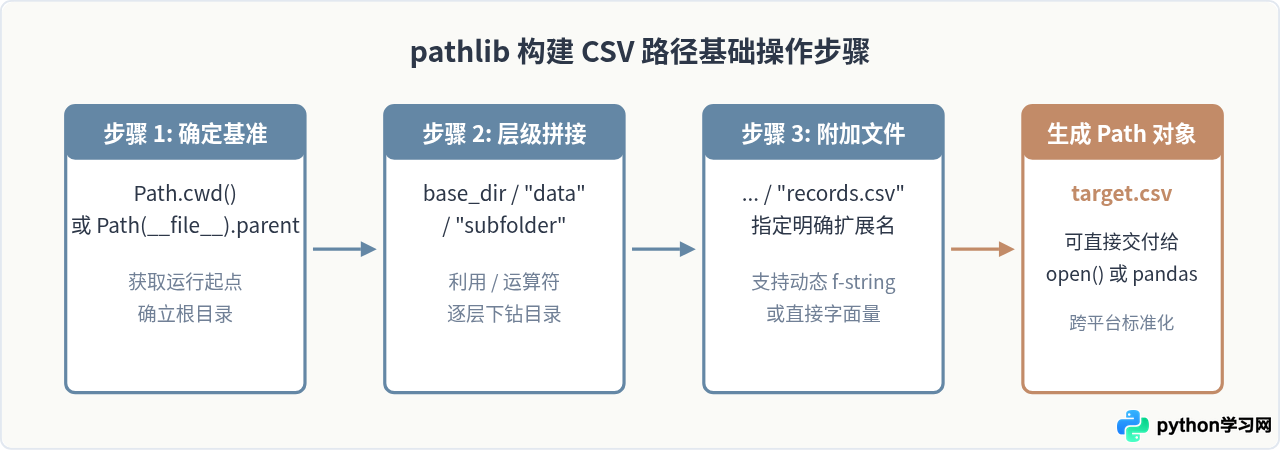
2. 使用 .with_name() 与 .with_suffix() 安全替换
当你已经有一个现成的文件路径对象,但需要切换文件名或变更后缀为 .csv 时,不需要手动进行字符串裁剪,直接使用 pathlib 提供的内置替换方法更安全:
with_name("new_filename.csv"):保持父级目录不变,仅替换文件全名。with_suffix(".csv"):保持主文件名与目录不变,精准替换或添加扩展名。若原路径无扩展名,则自动补齐。
template_file = Path("data/source/inventory_template.xlsx")

# 场景A:仅将扩展名从 .xlsx 转为 .csv
csv_from_suffix = template_file.with_suffix(".csv")
print(csv_from_suffix)  # data/source/inventory_template.csv

# 场景B:保持原目录,替换整个文件名
custom_csv = template_file.with_name("final_summary.csv")
print(custom_csv)       # data/source/final_summary.csv
四、工程保障:父目录自动创建与绝对路径解析
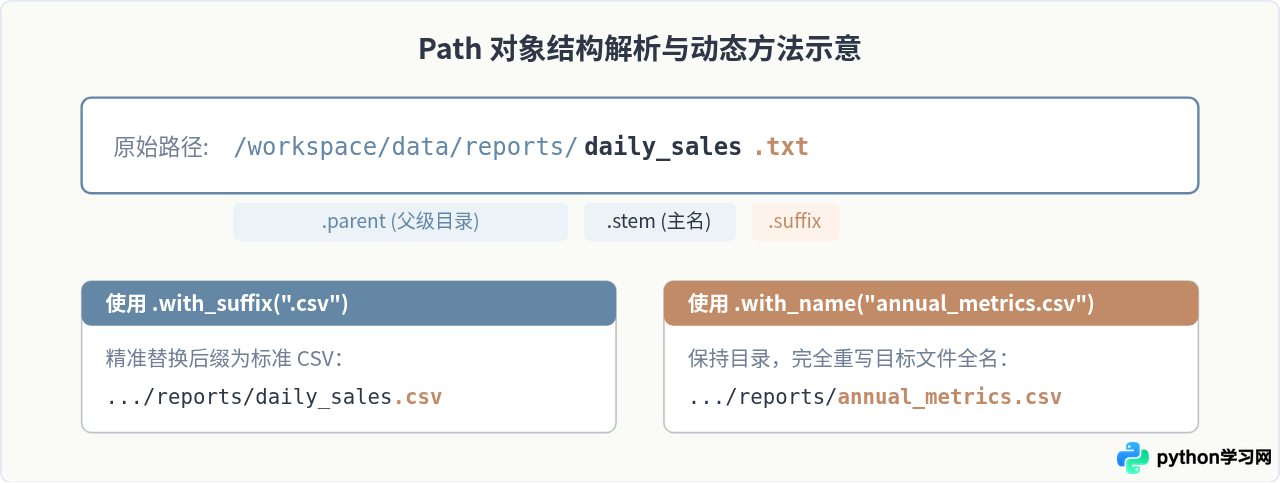
在实际代码执行过程中,仅在内存中拼装出路径字符串是不够的。如果目标上级文件夹在磁盘中尚不存在,直接调用 open(path, 'w') 或 DataFrame.to_csv(path) 会立刻引发 FileNotFoundError。因此,构建路径后通常需要配合自动化目录保障与规范化解析。
1. 安全递归创建上级目录
通过访问 Path.parent 属性可以获取该CSV文件所在的上级目录对象,配合 mkdir(parents=True, exist_ok=True) 可以一次性创建多层嵌套目录,且若目录已存在也不会报错:
from pathlib import Path

target_csv = Path("output/finance/2026/q3") / "transactions.csv"

# 在写出文件前,确保多级父目录全部就绪
target_csv.parent.mkdir(parents=True, exist_ok=True)

# 此时已能安全执行文件写入
with open(target_csv, "w", encoding="utf-8") as f:
    f.write("id,amount,status\n")
    f.write("1001,350.5,success\n")
2. 使用 .resolve() 获取标准绝对路径
相对路径在程序改变工作目录(如调用 os.chdir 或在子线程执行)时可能会指向错误位置。调用 resolve() 会自动消除路径中的 .. 或 .,并返回包含盘符或根目录的完整绝对路径:
relative_csv = Path("./data/../data/cache/temp.csv")
absolute_csv = relative_csv.resolve()
print("规范化绝对路径:", absolute_csv)
# 输出类似: /home/user/project/data/cache/temp.csv
五、数据集成实战:结合内置 csv 模块与 pandas 读写
构建好的 Path 实例可以直接传递给 Python 数据分析常用工具,无需显式转换为字符串。以下演示读写两端的典型组合方式:
1. 与内置 csv 模块配合
import csv
from pathlib import Path

csv_file = Path("data/processed") / "metrics.csv"
csv_file.parent.mkdir(parents=True, exist_ok=True)

# 写入数据
with open(csv_file, mode="w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["item", "price", "count"])
    writer.writerow(["Widget A", 19.99, 100])

# 读取验证
if csv_file.exists():
    with open(csv_file, mode="r", encoding="utf-8") as f:
        reader = csv.DictReader(f)
        for row in reader:
            print(f"商品: {row['item']}, 售价: {row['price']}")
2. 与 pandas 配合读取
如果系统已安装 pandas,则 read_csv 和 to_csv 均原生接收 Path 对象:
import pandas as pd
from pathlib import Path

file_path = Path("raw_data") / "customer_events.csv"

# 如果文件存在则直接加载分析
if file_path.is_file():
    df = pd.read_csv(file_path)
    print("读取行数:", len(df))
六、常见避坑点与操作注意事项
斜杠运算符 / 的路径拼接功能源自 Path 对象的运算符重载。如果两端均为原生字符串,如 "folder" / "data.csv",Python解释器会抛出 TypeError: unsupported operand type(s) for /: 'str' and 'str'。务必确保除号左侧或首个元素为 Path 实例,例如 Path("folder") / "data.csv"。
在 pathlib 规则中,如果右侧拼接的操作数是一个以根符号开头的绝对路径(如 Windows 下的 "C:/test" 或 Linux 下的 "/data.csv"),系统会判定右侧覆盖左侧,直接返回右侧路径而丢弃左侧所有内容。因此,子层级拼接时请使用相对路径写法,去掉开头的斜杠。
构建完路径打开CSV文件时,在 Windows 上默认字符编码为 ANSI/GBK,而 Linux/macOS 默认为 UTF-8。写入或读取包含中文的CSV文件时,始终应显式指定 encoding="utf-8" 或针对 Excel 兼容性指定 encoding="utf-8-sig";在使用 csv.writer 时,务必在 open() 中传入 newline="",防止 Windows 平台多出空行。
七、核心方法与路径属性对照总结
熟练运用 pathlib 处理 CSV 文件路径,关键在于熟记常用属性与变换方法的搭配。下表归纳了高频属性及其功能:
| 属性 / 方法 | 返回值类型 | 典型应用场景 |
|---|---|---|
Path.cwd() |
Path | 获取当前进程的工作目录,常作为构建项目相对路径的锚点 |
path / "filename.csv" |
Path | 跨平台连接子目录或目标CSV文件名 |
path.parent |
Path | 获取上一级文件夹路径,用于配合创建保存目录 |
path.stem |
str | 获取不带扩展名的文件名,用于生成对应的备份名或日志名 |
path.suffix |
str | 获取文件扩展名(如 .csv),用于格式合规性校验 |
path.with_suffix('.csv') |
Path | 快速将路径扩展名转换为 .csv |
path.with_name('new.csv') |
Path | 保留原路径的目录结构,仅替换文件名与后缀 |
path.resolve() |
Path | 获取规范化绝对路径,解析符号链接 |
path.is_file() / exists() |
bool | 在执行 read_csv 前检测文件是否物理存在 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















