


Python多进程中仅用join同步与使用Queue传值的区别
深入解析Python多进程编程中仅用join()同步与使用Queue传值的本质区别,涵盖独立内存模型、生命周期等待时序、IPC底层管道与序列化机制、常见死锁陷阱及技术选型对比。
multiprocessing 模块中,join() 与 Queue 解决的是两个不同层面的核心问题:join() 属于进程生命周期控制与时序同步机制,只负责阻塞主进程等待子进程结束并回收操作系统退出状态,无法跨越进程边界传递数据;而 Queue 属于进程间通信(IPC)机制,通过底层操作系统管道与对象序列化,在相互隔离的内存空间中安全传递实际运算结果。
一、核心差异:进程控制与数据传输的本质分工
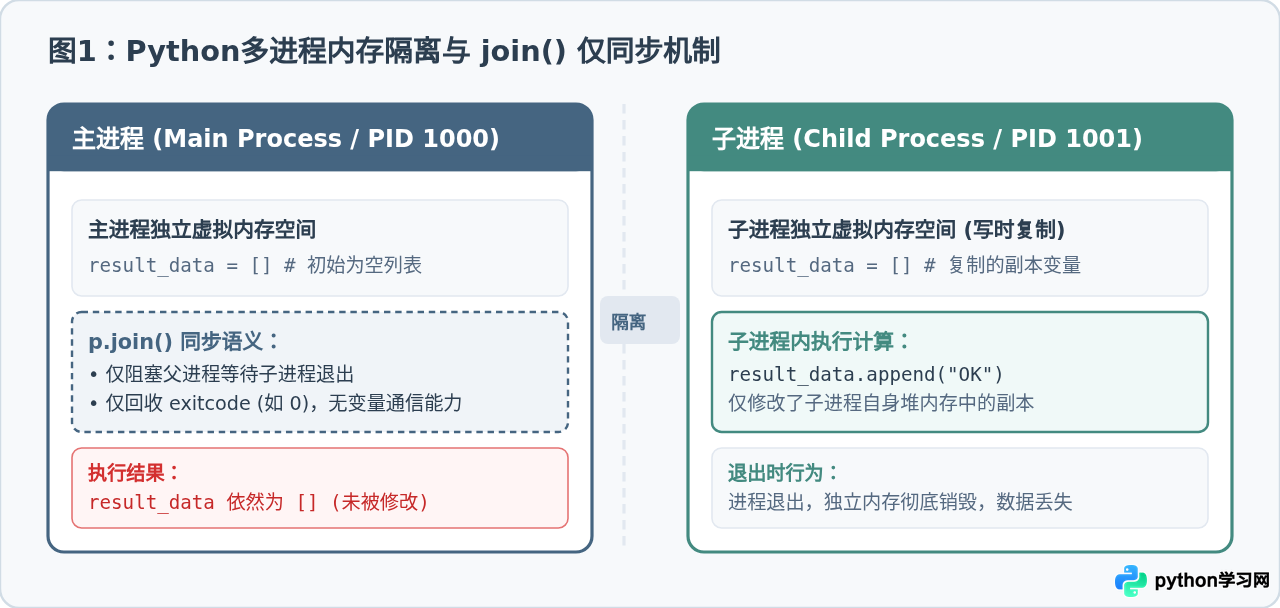
多进程编程与多线程最大的区别在于独立的内存空间。多线程共享同一个进程的全局堆内存,修改全局变量对所有线程可见;而多进程在启动时,操作系统会为子进程分配独立的虚拟地址空间。即使在 Linux/Unix 采用写时复制(Copy-On-Write)技术,子进程对任何对象、列表、字典的修改也仅发生在自身独立的物理内存页上,父进程完全无感知。
正因为这种严格的内存隔离,初学者经常误以为调用 p.join() 之后,子进程在外部作用域中修改的变量就能自然同步给主进程。实际上,join() 仅是系统调用 waitpid() 的封装,其通信容量仅限于操作系统返回的进程退出状态码(exitcode)。
二、仅用 join():运行机制、典型场景与代码表现
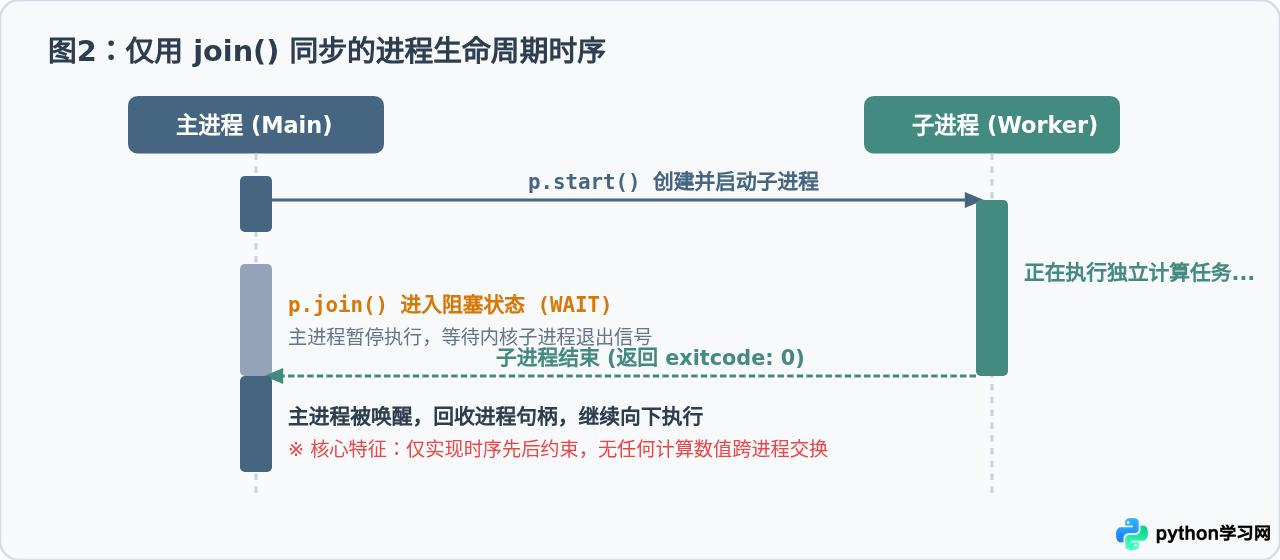
Process.join([timeout]) 的功能非常专一:让当前调用进程(通常是主进程)陷入挂起等待,直到目标子进程执行完毕或超时。
1. 仅用 join() 的运行逻辑
- 时序把控:确保所有后台任务在主程序进入下一步(如程序退出、统计耗时、执行下阶段任务)前已彻底执行完毕。
- 资源回收:防止子进程结束但未被父进程等待而形成僵尸进程(Zombie Process),由操作系统的
wait逻辑回收其进程控制块(PCB)。 - 无值回传:目标函数的
return返回值会被运行时直接丢弃,主进程无法通过进程对象获取返回值。
2. 典型适用场景
仅使用 join() 而无需传值的场景,其任务特点是自给自足或自持久化:
- 独立文件处理:每个子进程读取独立的源文件,处理后各自写入指定的输出文件或数据库分表,无需向主进程汇报计算细节。
- 批量并发请求:子进程负责向外部接口推送数据,结果直接记录在本地日志或外部存储中。
- 纯计算且不依赖汇总:例如对显存/物理内存清理、预热缓存或执行独立的后台系统命令。
3. 代码示例:仅用 join() 完成独立落地任务
import multiprocessing
import time
import os

def worker_task(task_id, output_path):
    """子进程独立运算,并将结果直接持久化到指定文件"""
    print(f"[PID {os.getpid()}] 开始执行任务 {task_id}")
    time.sleep(1)
    # 计算并将结果持久化在磁盘,不向主进程回传数据
    with open(output_path, "w", encoding="utf-8") as f:
        f.write(f"任务 {task_id} 处理完毕,结果值: {task_id * 100}\n")
    print(f"[PID {os.getpid()}] 任务 {task_id} 文件已写入")

if __name__ == "__main__":
    processes = []
    for i in range(3):
        out_file = f"result_task_{i}.txt"
        p = multiprocessing.Process(target=worker_task, args=(i, out_file))
        processes.append(p)
        p.start()

    # 仅用 join() 确保所有子进程文件写入完成后再向下执行
    for p in processes:
        p.join()

    print("所有子进程已全部退出,主进程确认落地文件完整,程序结束。")
三、使用 Queue 传值:IPC 机制与完整数据闭环
当主进程必须汇总子进程的计算结果、或者需要在多个进程之间传递流水线数据时,仅靠 join() 无法达成目标,必须引入进程间通信(IPC)。在标准库中,最常用且最安全的方式是 multiprocessing.Queue。
1. multiprocessing.Queue 的内部实现机制
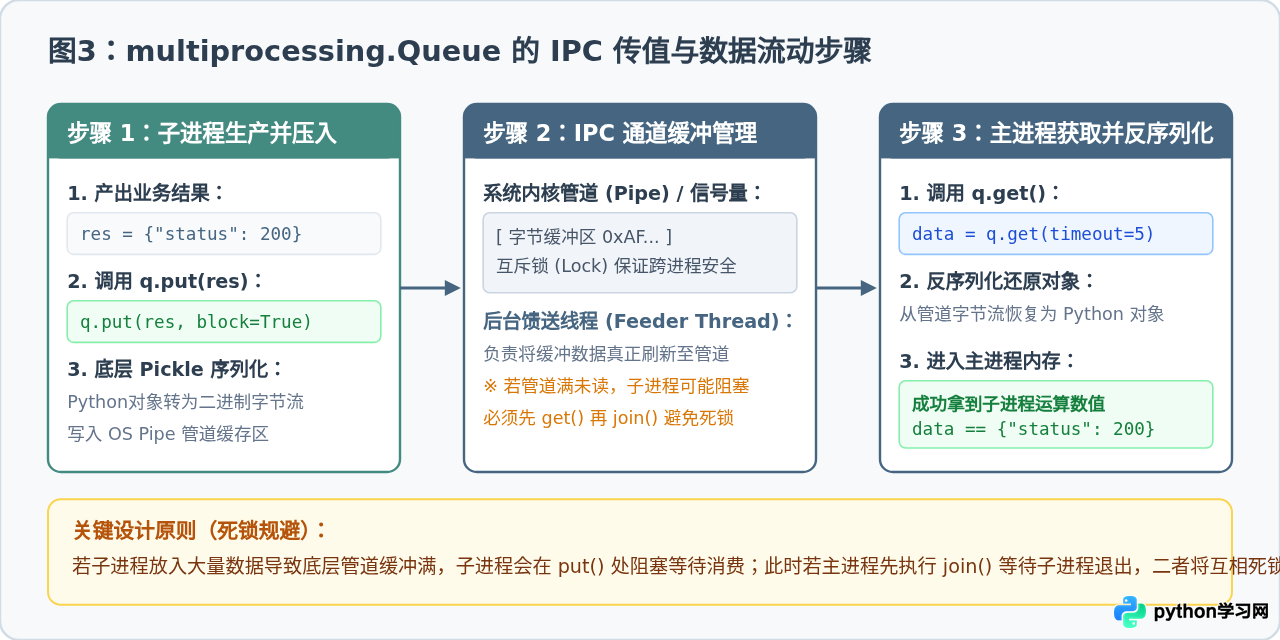
multiprocessing.Queue 并不是普通线程安全的 queue.Queue,其底层是由操作系统管道(Pipe)、无名信号量(Semaphore)以及一个专门的后台馈送线程(Feeder Thread)协作构成的:
- 序列化(Pickle):子进程调用
q.put(data)时,Python 先使用pickle.dumps()将对象序列化为连续字节流。 - 管道写入:后台馈送线程将字节流压入操作系统管道缓冲区。
- 安全加锁:内部通过进程锁和信号量控制多读多写的并发冲突。
- 反序列化:主进程通过
q.get()从管道读取字节流,并通过pickle.loads()还原为内存对象。
2. 代码示例:通过 Queue 收集计算结果并正确 join()
import multiprocessing
import os

def calculate_square(num, queue):
    """计算平方并通过 Queue 回传给主进程"""
    result = num * num
    print(f"[PID {os.getpid()}] 计算完成: {num}^2 = {result}")
    queue.put(result)  # 序列化压入队列

if __name__ == "__main__":
    nums = [10, 20, 30, 40]
    result_queue = multiprocessing.Queue()
    processes = []

    for n in nums:
        p = multiprocessing.Process(target=calculate_square, args=(n, result_queue))
        processes.append(p)
        p.start()

    # 【重要原则】先从 Queue 中消费数据
    collected_results = []
    for _ in range(len(nums)):
        val = result_queue.get()  # 从队列中读取并反序列化
        collected_results.append(val)

    # 消费完毕后,再等待子进程回收结束
    for p in processes:
        p.join()

print(f"主进程汇总计算结果: {collected_results}")p.join(),就会出现死锁:子进程因为管道被填满而卡在 put() 无法退出;主进程因为 join() 一直等待子进程退出而无法执行 get()。两者互相等待,程序将永久挂起。因此,必须先读取队列数据,待所有写入内容被消化后,再执行 join()。
四、全面对比与技术选型决策
为了在实际工程开发中准确选型,下表从多个核心维度总结了仅用 join() 与结合使用 Queue 的技术差异:
| 比较维度 | 仅用 join() 同步 | 使用 Queue 传值(配合 join) |
|---|---|---|
| 核心功能 | 进程生命周期等待、同步时序、回收 exitcode | 跨进程安全传递业务数据与执行结果 |
| 数据传递能力 | 无(仅能获知子进程已退出) | 有(支持绝大多数可 Pickle 序列化的 Python 对象) |
| 底层通信机制 | 操作系统内核系统调用(waitpid/WaitForSingleObject) | OS Pipe 管道 + 互斥锁 + 序列化后台线程 |
| 性能开销 | 几乎为零,仅为内核事件等待 | 存在 Pickle 序列化、反序列化及内核态复制开销 |
| 典型风险 | 可能漏调导致僵尸进程(Zombie) | 缓冲区满时若先 join 会发生永久死锁;对象不可 Pickle 会报错 |
| 适用场景 | 任务结果直接写入文件/数据库、批量独立操作 | 生产者-消费者流水线、需要主进程合并多子进程计算指标 |
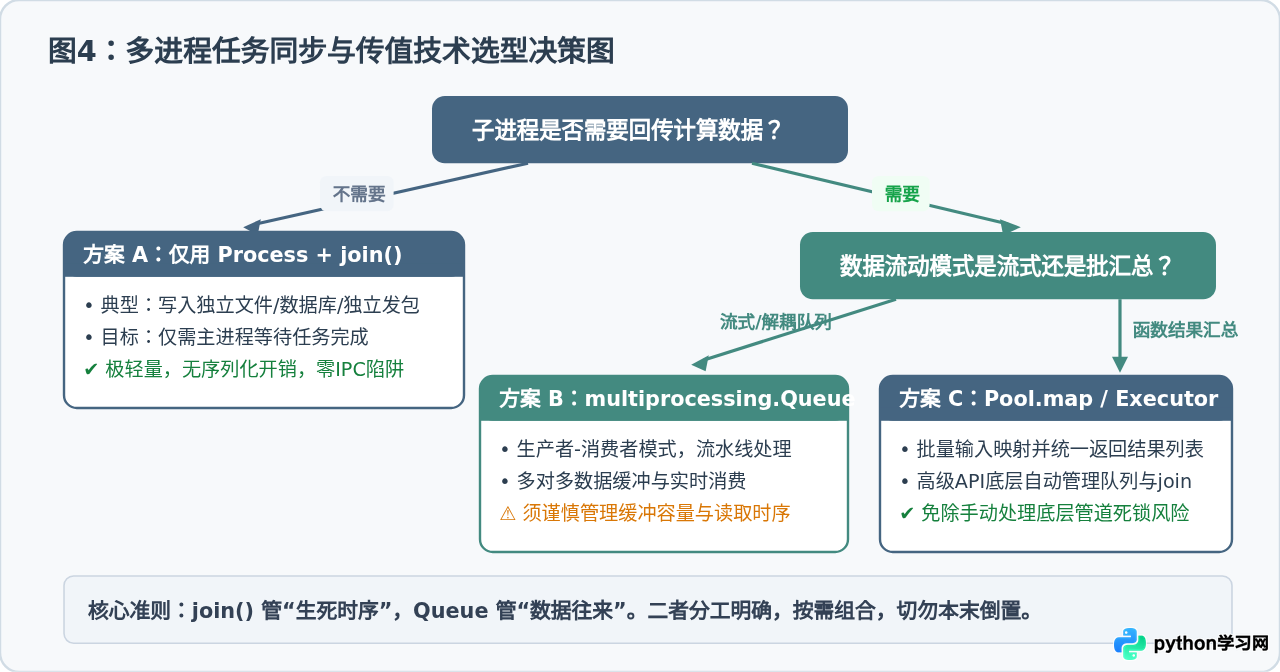
五、工程实践建议
- 明确界限:当子进程运算产物不需要聚合至主进程时,坚决仅使用 join(),避免无谓的 IPC 管道搭建与序列化性能损耗。
- 善用高层封装:如果任务本质是“批量输入映射计算得到批量输出结果”,优先采用
concurrent.futures.ProcessPoolExecutor或multiprocessing.Pool.map。这些高层封装底层自动处理了队列与进程等待逻辑,能从根源上避开死锁。 - 严格遵守消费顺序:在手动使用
multiprocessing.Process和Queue时,始终遵循“先读空队列、再调用join()”的编写纪律。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















