


Python __init__方法详解:类的初始化与属性赋值
深入详解 Python 类中的 __init__ 初始化方法,全面解析其触发机制、self 关键字含义、实例属性与类属性的赋值区别、默认参数与可变参数设计、super() 继承调用链以及高频避坑要点。
在 Python 面向对象编程中,__init__ 是最核心也最频繁使用的内置特殊方法。它的本质任务是当对象实例在内存中被创建后,立即负责为该实例配置初始状态并绑定属性。本文将围绕 __init__ 的触发时机、self 参数的核心意义、实例属性与类属性的赋值隔离、参数传递策略、继承场景下的父类初始化以及典型易错陷阱,系统讲解这一基础而关键的机制。
一、__init__ 的核心概念与基本语法
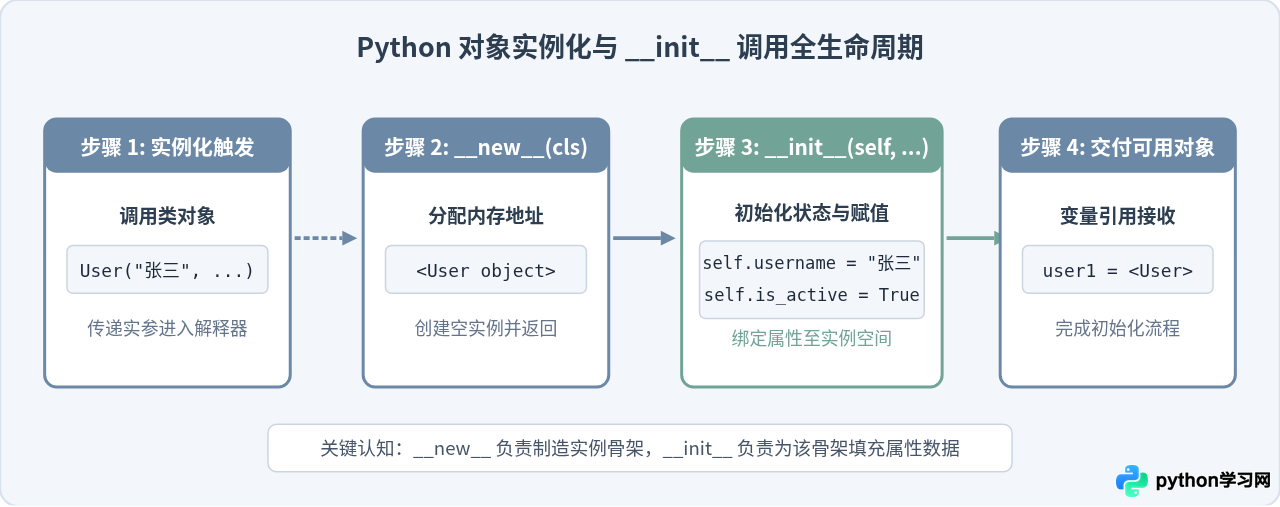
当通过类名后加圆括号(如 User("Alice"))创建实例时,Python 内部会自动调用 __init__ 方法。很多初学者常将其误称为“构造函数”,但准确地说,Python 真正的对象构造分配是由 __new__ 完成的,而 __init__ 负责后续的“初始化配置”。
class User:
    def __init__(self, username, email):
        # self 指向刚被创建的具体对象实例
        self.username = username
        self.email = email
        self.is_active = True  # 设置默认固定属性

# 实例化对象
user1 = User("张三", "zhangsan@example.com")
print(user1.username)   # 输出:张三
print(user1.is_active)  # 输出:True
在这个定义中,方法第一个参数必须是 self,它在调用时由 Python 解释器自动传入,指向当前正在被初始化的那一个具体实例。后续的 username 与 email 则是实例化时传入的业务参数,通过 self.属性名 = 参数值 完成属性绑定。
二、属性赋值机制:实例属性与类属性的隔离
在 Python 中,每个对象都有自己的专属命名空间,底层通过字典 __dict__ 维护。理解属性赋值的关键在于区分实例属性与类属性:
- 实例属性(Instance Attribute):在
__init__内使用self.attr = value绑定的属性,属于各个实例独享,互不干扰。 - 类属性(Class Attribute):直接写在类体内部、方法外部的属性,属于该类本身,所有由该类派生的实例共享同一个类属性。
class Device:
    platform = "IoT-Hub"  # 类属性:所有设备共享

    def __init__(self, device_id, ip_address):
        self.device_id = device_id      # 实例属性:每个设备独有
        self.ip_address = ip_address    # 实例属性:每个设备独有

dev1 = Device("DEV-001", "192.168.1.10")
dev2 = Device("DEV-002", "192.168.1.11")

print(dev1.__dict__)
# 输出示例:{'device_id': 'DEV-001', 'ip_address': '192.168.1.10'}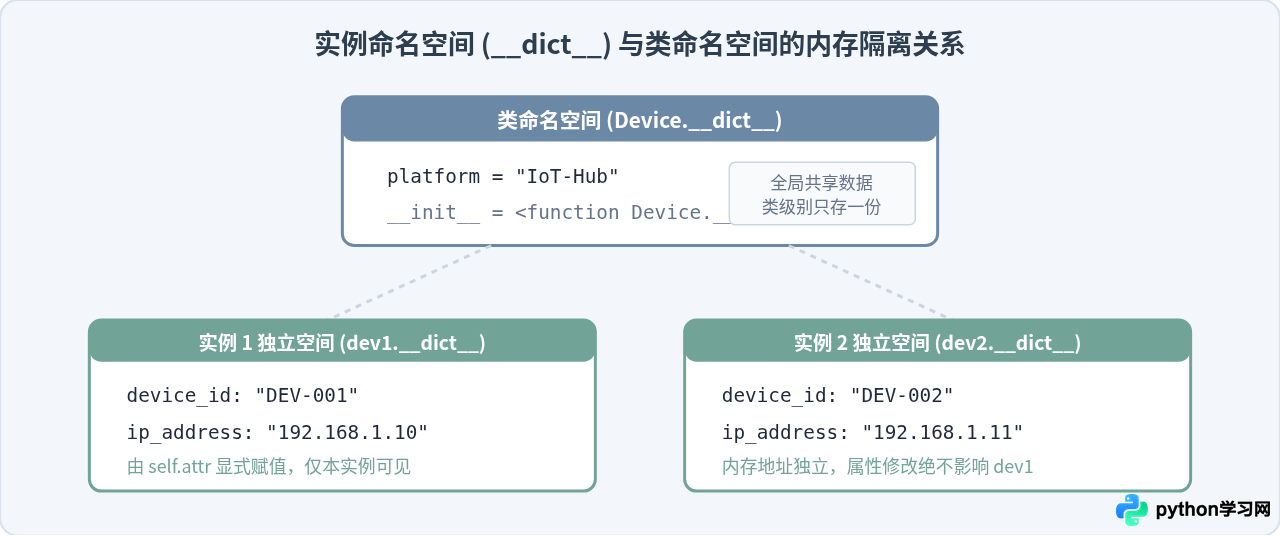
三、参数设计与初始化灵活性
__init__ 支持 Python 函数所有的参数传递语法,包括位置参数、默认参数、关键字参数以及可变参数 *args 与 **kwargs。
1. 默认参数的使用
为属性设置合理默认值能够大幅提升类的易用性,使得调用方仅在有特殊需求时才传入指定值:
class DatabaseConnector:
    def __init__(self, host, port=3306, timeout=10):
        self.host = host
        self.port = port
        self.timeout = timeout

# 仅传必选参数
db_default = DatabaseConnector("10.0.0.1")
# 覆盖默认参数
db_custom = DatabaseConnector("10.0.0.2", port=3307, timeout=30)
2. 使用 **kwargs 应对动态配置
当对象包含大量可选配置,或作为通用底层基类时,可以利用 **kwargs 灵活捕获额外参数:
class RequestClient:
    def __init__(self, base_url, **kwargs):
        self.base_url = base_url
        self.headers = kwargs.get("headers", {})
        self.retry_count = kwargs.get("retry_count", 3)
        self.extra_options = kwargs
四、继承场景与 super().__init__() 调用链
面向对象的核心特征之一是继承。当子类重写了 __init__ 方法时,子类的初始化逻辑会完全覆盖父类的 __init__。若不显式调用父类初始化,父类中定义的属性将不会被绑定到子类实例中,进而引发 AttributeError。
在 Python 中,标准做法是使用 super().__init__(...) 显式调用父级初始化方法:
class Person:
    def __init__(self, name, age):
        self.name = name
        self.age = age

class Developer(Person):
    def __init__(self, name, age, primary_language):
        # 1. 委托父类初始化通用属性
        super().__init__(name, age)
        # 2. 初始化子类特有的专有属性
        self.primary_language = primary_language

dev = Developer("李四", 28, "Python")
print(dev.name)              # 继承自父类属性:李四
print(dev.primary_language)  # 子类独有属性:Python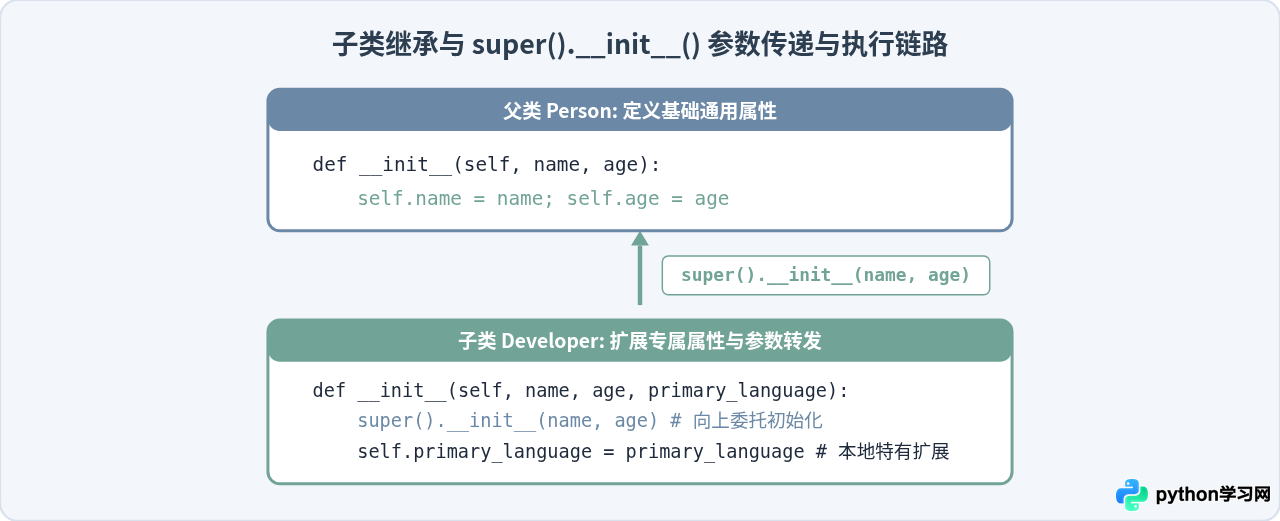
五、四大高频避坑指南
在实际编码中,围绕 __init__ 有几个极易产生隐蔽 Bug 的陷阱,需要特别留意:
1. 陷阱一:在 __init__ 中返回具体值
__init__ 方法必须隐式或显式返回 None。如果尝试返回除 None 之外的任何对象(如字符串、数字或字典),Python 解释器会直接抛出 TypeError: __init__() should return None。
2. 陷阱二:使用可变对象作为默认参数
如果在 __init__ 参数定义中直接指定 skills=[] 或 config={},该空列表/字典是在模块加载时创建的单一对象,所有未传该参数的实例都会共享同一个列表!
# 错误写法:所有实例共享同一个 items 列表
class CartBad:
    def __init__(self, items=[]):
        self.items = items

# 正确标准写法:使用 None 作为占位哨兵
class CartGood:
    def __init__(self, items=None):
        if items is None:
            self.items = []
        else:
            self.items = items
3. 陷阱三:漏写 self 导致参数错位
方法定义必须将 self 作为第一个形参。如果定义为 def __init__(name, age):,在实例化 Person("Alice", 20) 时,Python 自动传入的实例对象会占据第一个形参 name,导致参数个数匹配错误或赋值混乱。
4. 陷阱四:手动调用 __init__ 代替实例化
不要通过 obj.__init__(...) 来创建对象。__init__ 仅用于更新或重置已有实例的状态;生成新实例应始终通过调用类本身 obj = ClassName(...)。
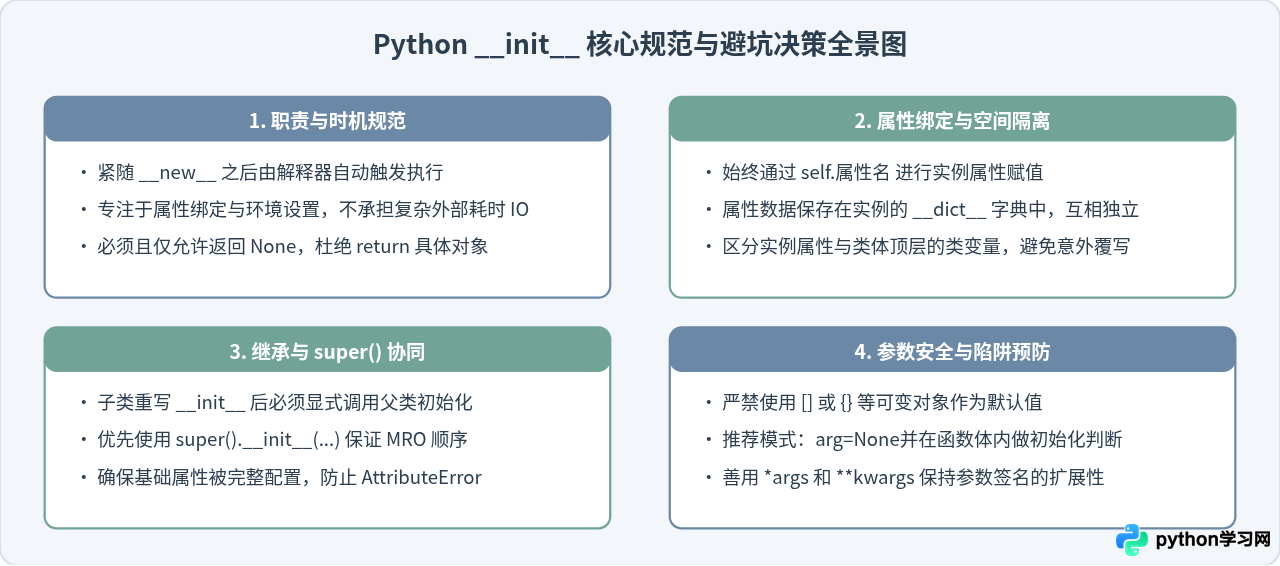
六、核心要点总结与对照
| 对比维度 | __init__ 方法 | __new__ 方法 |
|---|---|---|
| 核心职责 | 初始化已创建的实例状态与属性 | 从系统内存中构造并分配对象空间 |
| 第一个参数 | self(指向刚创建的实例对象) |
cls(指向当前被调用的类本身) |
| 返回值要求 | 必须为 None |
必须返回创建的对象实例 |
| 常用使用场景 | 99% 的面向对象业务初始化、属性赋值 | 单例模式、元编程、不可变类型(tuple/str)定制 |
总结而言,__init__ 是 Python 赋予类实例个性和初始数据的核心入口。掌握其运行生命周期、明确 self 的绑定意义、妥善处理父类 super() 调用并规避可变默认值陷阱,是编写规范、健壮的 Python 面向对象代码的坚实基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















