


Python可变与不可变数据类型有什么区别?
深入解析Python中可变类型与不可变数据类型的本质区别,结合内存地址原理、验证方法、常见陷阱与内联图解,帮助开发者彻底掌握两者在编程中的行为差异与最佳实践。
在 Python 中,可变数据类型与不可变数据类型的核心区别在于:对象一旦在内存中分配,其内部存储的值是否可以直接被修改。不可变对象在创建后内部内容固定不变,任何试图改变它的操作都会生成一个全新的对象并分配新内存地址;可变对象则允许在保持自身内存地址不变的前提下,就地增删改其内部元素。理解这一区别是掌握 Python 变量引用机制、避免隐式传参修改以及规避默认参数陷阱的关键。
一、内存模型与变量引用的本质
许多初学者容易把变量误解为“装数据的盒子”,认为修改变量就是往盒子里装新东西。但在 Python 的底层设计中,所有数据都是“对象”,变量并不是实体容器,而是一个贴在对象上的“标签”或“指针引用”。
当我们执行赋值语句 a = 100 时,Python 解释器首先在内存堆中构建一个整型对象 100,随后将变量名 a 绑定到该对象的内存地址上。使用内置函数 id() 可以获取对象在内存中的唯一标识号(在 CPython 实现中即为对象的内存地址)。
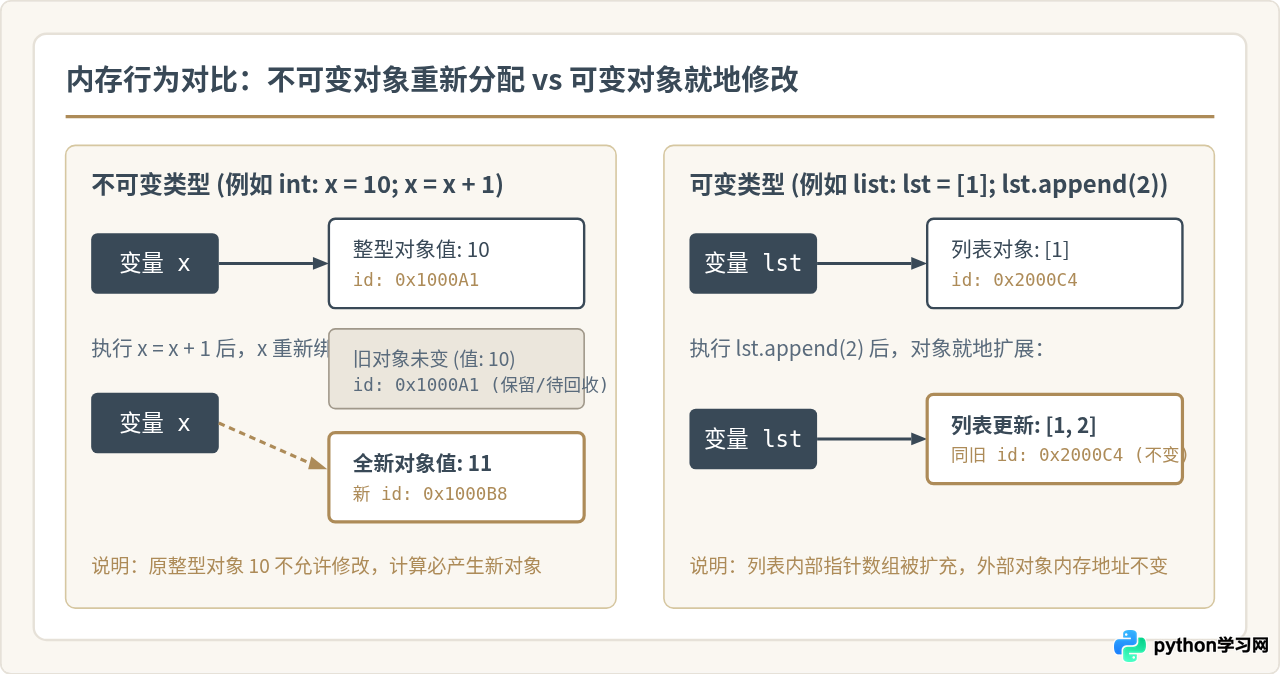
从底层存储来看,不可变对象的值与元信息是一体打包存储的。当进行加减运算、字符串拼接或截取时,Python 并不能擦除原内存数据并就地写入新值,只能开辟新空间存放新对象,再令原变量指向新空间。相反,可变对象(如列表)维护了一个指向元素指针的可扩容动态数组,修改或追加元素只是改动内部指针数组,列表外壳本身的内存地址保持恒定。
二、常见数据类型归类与验证方法
在日常开发中,我们可以按照对象的行为特征清晰划分两大家族:
- 不可变数据类型(Immutable):数值类(
int,float,complex,bool)、字符串(str)、元组(tuple)、冻结集合(frozenset)、字节序列(bytes)。 - 可变数据类型(Mutable):列表(
list)、字典(dict)、集合(set)、字节数组(bytearray)以及绝大多数自定义类实例。
验证可变性的步骤与代码示例
要确定一个对象在某种操作下是“就地改变”还是“生成新对象”,可以通过 id() 函数在操作前后进行比对。以下是具体推导步骤:
# 1. 验证不可变类型 str
text = "hello"
old_id = id(text)
text += " world"
new_id = id(text)
print(f"字符串修改前 id: {old_id}, 修改后 id: {new_id}, 是否相同: {old_id == new_id}")
# 输出:是否相同: False(已创建新字符串对象)

# 2. 验证可变类型 list
nums = [1, 2, 3]
old_id = id(nums)
nums.append(4)
new_id = id(nums)
print(f"列表修改前 id: {old_id}, 修改后 id: {new_id}, 是否相同: {old_id == new_id}")
# 输出:是否相同: True(同一个列表对象就地增加元素)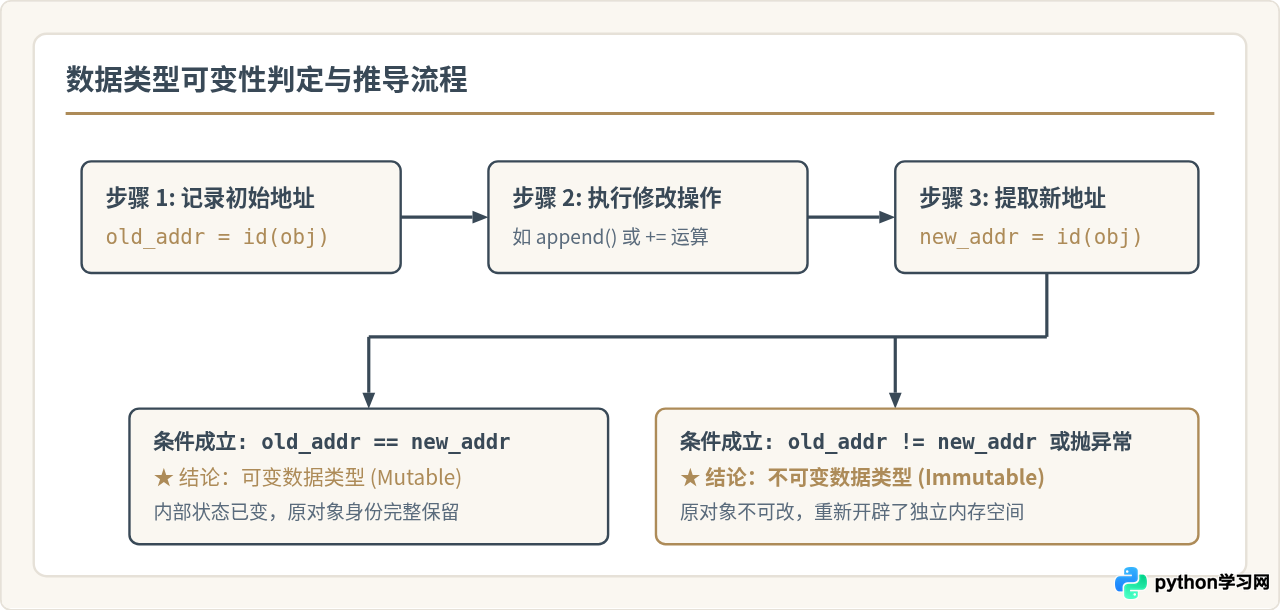
三、核心差异带来的四个高频陷阱
可变与不可变特性的差异并不仅仅停留在理论层面,它深刻影响着参数传递、对象拷贝、哈希索引以及容器嵌套的运行行为。以下是开发中最常见且极易引发隐蔽 Bug 的四个关键场景。
1. 函数默认参数使用可变对象的“状态残留”
这是 Python 最经典的陷阱之一。在 Python 中,函数的 def 语句在模块加载时被执行,此时默认参数的对象就已经在内存中被创建,且只会被创建一次。如果在默认参数中直接使用 [] 或 {},所有省略该参数的函数调用都将共享这同一个对象实例。
# 错误示例:默认参数共享可变对象
def add_user(name, user_list=[]):
    user_list.append(name)
    return user_list

print(add_user("Alice"))  # 输出: ['Alice']
print(add_user("Bob"))    # 预期输出: ['Bob'],实际输出: ['Alice', 'Bob']!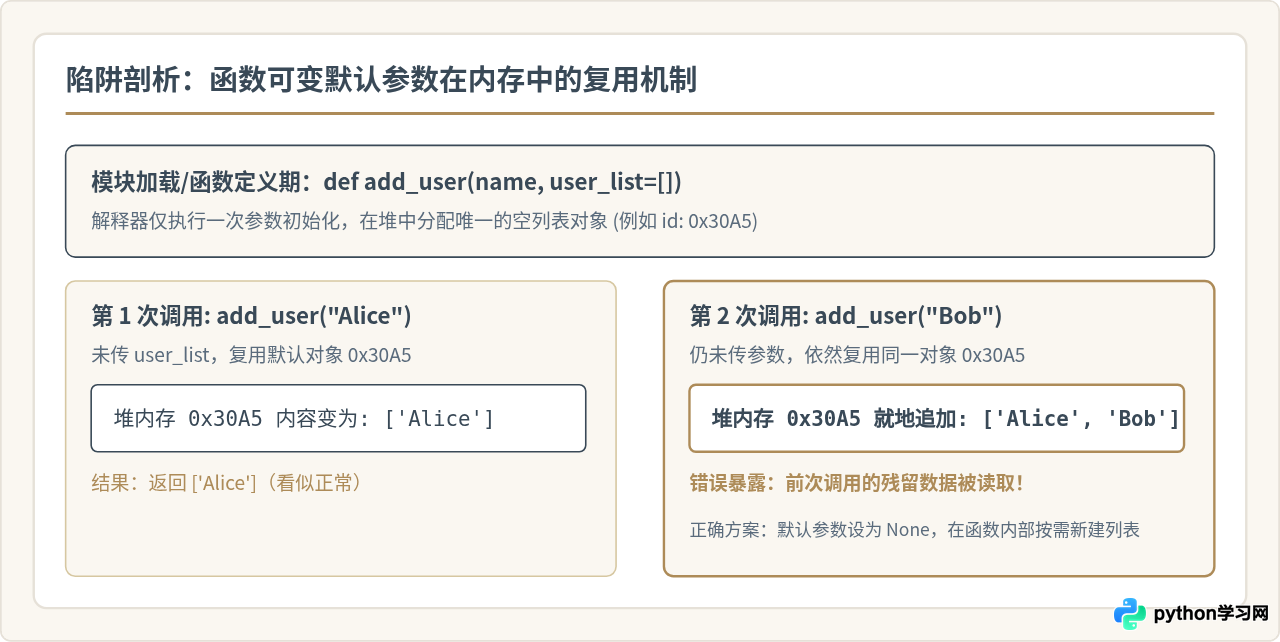
None 作为占位符,并在函数体内动态判断初始化:
def add_user(name, user_list=None):
    if user_list is None:
        user_list = []  # 每次调用独立在栈帧中构建新列表
    user_list.append(name)
    return user_list
2. 元组的“不可变”仅约束外层引用序列
许多人认为元组是不可变的,因此其所有子元素也绝对不能改变。这种理解并不全面。元组的不可变性,本质上只保证它自身包含的元素引用地址不可替换,但并不限制这些引用所指向的底层对象自身是否可以被就地修改。
# 元组包含可变对象 list
data = (10, [1, 2], "abc")

# 试图直接替换元素引用会触发 TypeError
try:
    data[0] = 20
except TypeError as err:
    print(f"不可直接修改元组元素: {err}")

# 但修改列表中指向的具体内容完全合法:
data[1].append(99)
print(data) # 输出: (10, [1, 2, 99], 'abc')在上述代码中,data[1] 所记录的内存指针没有任何变化,依然指向原来的列表,但列表本身是可变对象,其内部元素发生扩展。因此,包含可变对象的元组并不能保证深层状态恒定。
3. 字典键(Key)与集合(Set)元素的哈希约束
Python 中的字典(dict)和集合(set)底层均依赖哈希表实现,具备 $O(1)$ 的快速查找效率。哈希表正常工作的前提是:存入的数据对象的哈希值(hash())必须在其整个生命周期中保持恒定不变。
- 不可变类型可哈希(Hashable):如
int,str,tuple(其内部元素也全为不可变类型),它们实现了__hash__()并在对象生命期内保持一致,因此可作为字典的键或集合的元素。 - 可变类型不可哈希(Unhashable):如
list,dict,set,其内容随时可能修改,若作为键存入哈希表,一旦内容更改哈希槽将发生错位,导致无法再次定位该数据。Python 明确禁止将可变对象作为键或集合元素,强行使用会抛出TypeError: unhashable type: 'list'。
4. 传参引发的外部副作用与深浅拷贝
Python 函数参数传递采用的是“对象的引用传递”(Pass by Assignment)。当把一个可变对象传递给函数时,形参与实参指向的是堆内存中的同一个对象;如果函数内部调用了 append(), pop() 等就地修改方法,外部实参所看到的数据会被直接改变。
若需要隔离这种副作用,必须进行拷贝:
- 浅拷贝(
copy.copy()或list.copy()):创建一个新对象,但只复制一层引用;如果容器内嵌套有下一层可变对象,内层对象依然共享。 - 深拷贝(
copy.deepcopy()):递归复制容器内部的所有层级对象,无论多深的可变嵌套都会完全独立。
四、关键特性对比与工程选型建议
在实际工程架构与业务开发中,选择可变类型还是不可变类型,不仅关乎语法正确性,更直接决定了系统的安全性、内存开销与运行性能。
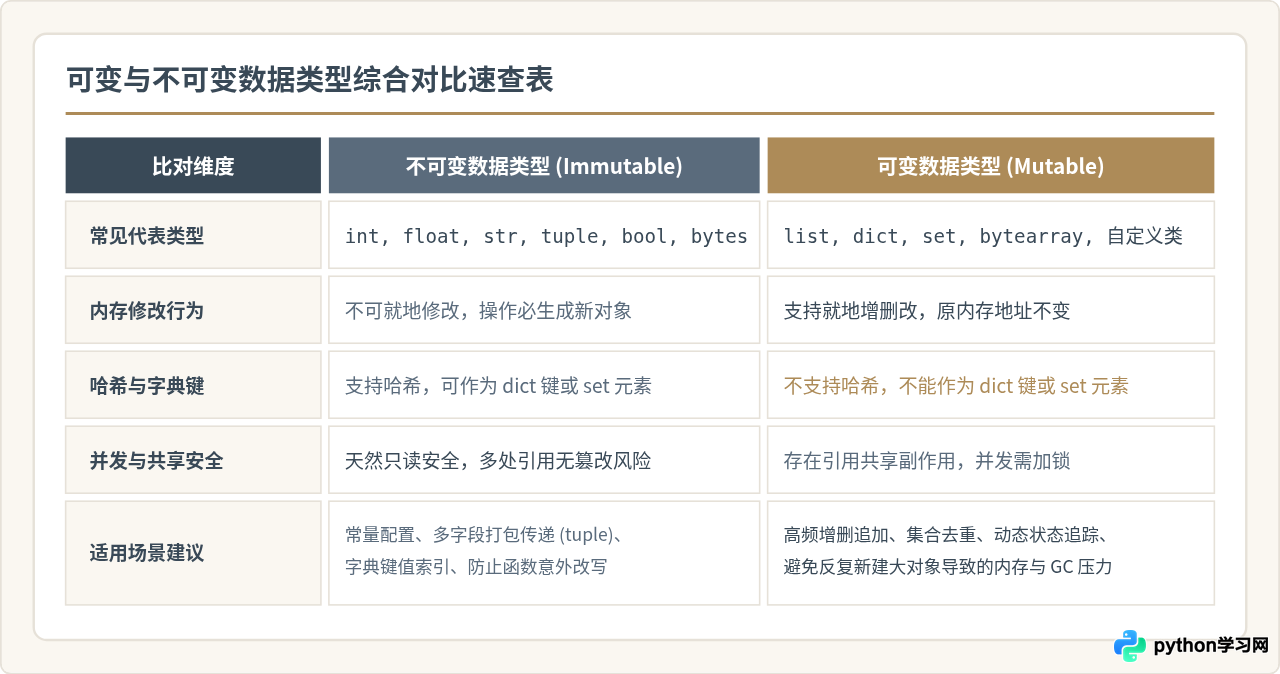
开发选型法则总结
- 优先选择不可变类型保证安全:当需要对外提供只读数据接口、定义固定维度的记录集、或者作为配置参数传递时,优先使用
tuple替代list。这不仅能从语法层面杜绝下游代码意外修改,而且元组在 CPython 内部具备轻量级内存分配优化,占用更少的内存。 - 动态集合与批量操作使用可变类型提升性能:如果在循环中需要频繁追加或修改数据,必须使用
list.append()或字典就地操作。切忌在循环体中对不可变类型(如字符串str += ...)进行大量拼接,因为这会导致频繁分配新内存与数据拷贝,引发二次方级的时间复杂度消耗;此时应改用列表收集后调用"".join(list)。 - 防御性编程与深层拷贝:当模块对外暴露内部可变状态(如对象的内部属性列表)时,应返回其副本(如
self._items.copy()),防止外部调用者无意间就地修改类内部的核心数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















