


Python双下划线函数(魔术方法)是什么?核心机制解析
深入解析Python双下划线函数(魔术方法/特殊方法)的本质、运行机制与协议设计,详解解释器类级查找原理、常用协议实现与工程避坑指南。
__init__、__str__、__len__)被称为特殊方法(Special Methods),在社区中常被称为双下方法(Dunder Methods)或魔术方法(Magic Methods)。它们是 Python 解释器实现语言级协议与数据模型(Data Model)的核心桥梁。本文将直接解析其本质定义、底层类级查找机制、高频协议分类,以及在实际工程开发中必须遵循的设计规范与避坑原则。
一、双下划线函数的本质:数据模型与语言协议的枢纽
初学者常常在定义类时第一次接触到 __init__,并将其单纯理解为“构造函数”。实际上,以双下划线命名是 Python 解释器保留的内部命名空间约定。Python 官方文档中将其正式命名为特殊方法(Special Methods)。
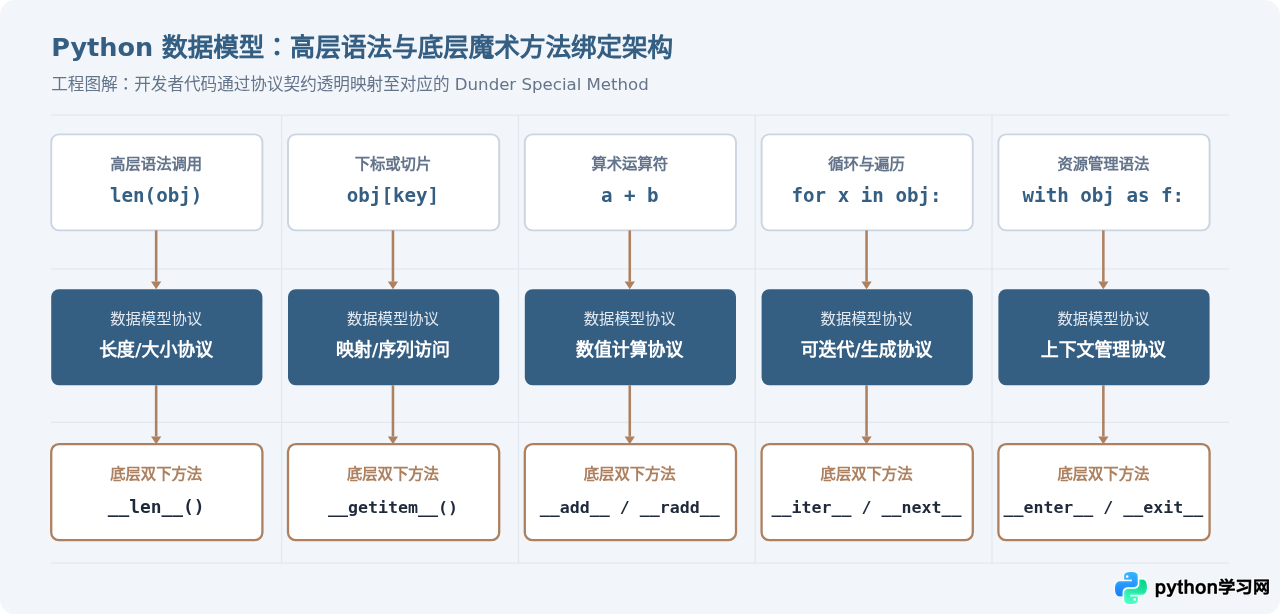
之所以称其为“魔术方法”,是因为开发者通常不会直接通过代码显示调用 obj.__len__() 或 a.__add__(b),而是在使用 Python 常见的高级语法或内置函数(如 len(obj)、a + b、for item in obj、with ctx:)时,由解释器在底层自动派发并调用对应的双下划线方法。
这一机制构成了 Python 的协议机制(Protocols)。Python 并不依赖静态类型接口来规定类的行为,而是采用鸭子类型(Duck Typing):只要你的类实现了 __len__ 和 __getitem__,解释器就视该对象为一个序列,即可享受切片、索引和遍历等全部特性。
二、核心机制解析:解释器如何查找与调用魔术方法
许多开发者认为调用 len(x) 等价于调用 x.__len__()。这种理解在表层功能上大致成立,但掩盖了 Python 最核心的运行机制:类级查找(Class-level Lookup)与类型插槽(Type Slots)优化。
1. 为什么跳过实例属性字典?(类级查找机制)
对于常规方法或属性,Python 会先检查实例的 __dict__,若不存在再沿 MRO(方法解析顺序)在类及基类中查找。但对于特殊方法,解释器会完全绕过实例的属性字典,直接在对象的所属类及其类型对象上查找。
我们通过一段简单的代码来验证这一核心机制:
class Demo:
    pass

# 实例化对象
obj = Demo()

# 尝试在实例级别动态绑定魔术方法
obj.__len__ = lambda: 42

try:
    print(len(obj))
except TypeError as err:
    print(f"实例绑定失败: {err}")
    # 输出示例: 实例绑定失败: object of type 'Demo' has no len()

# 只有在类级别定义或绑定,内置函数与语法才能生效
Demo.__len__ = lambda self: 42
print(f"类绑定成功: {len(obj)}")
# 输出示例: 类绑定成功: 42
Python 做出这一设计的核心原因有两个:
- 执行性能:CPython 在 C 语言层为内置类型定义了结构体(如
PyTypeObject),里面包含了一系列函数指针插槽(Slots,例如用于序列长度的tp_as_sequence->sq_length)。当执行内置函数时,解释器直接读取 C 结构体插槽,无需经过 Python 层面耗时的哈希字典查找。 - 一致性与元类正确性:如果特殊方法可以在实例字典中被覆盖,那么对类对象自身(类也是
type的实例)调用len(Cls)时,究竟该调用Cls类的方法还是元类type的方法就会产生歧义。因此,统一在type(obj)上解析是维系整个类型系统一致性的根基。
2. 运算符派发与反射协商机制
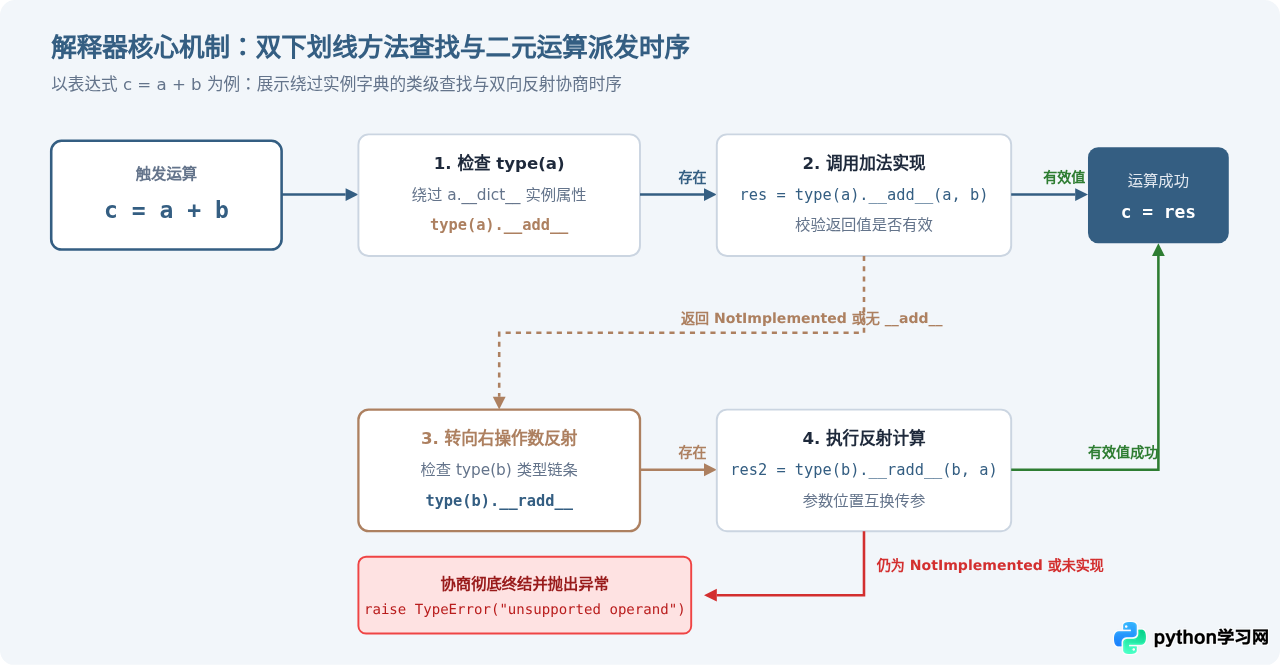
以最常见的二元运算 c = a + b 为例,Python 内部并不会只简单检查 a.__add__,而是包含完整的左右协商与反射降级机制:
- 解释器首先在
type(a)上查找__add__。若存在,执行type(a).__add__(a, b)。 - 如果该方法返回单例值
NotImplemented(或者type(a)没有定义__add__),解释器并不会立即报错,而是转向右操作数。 - 解释器在
type(b)上查找反射方法__radd__。若存在,执行type(b).__radd__(b, a)。 - 若右侧方法同样返回
NotImplemented或未定义,最终才抛出TypeError: unsupported operand type(s) for +。
三、高频魔术方法体系与协议分类解析
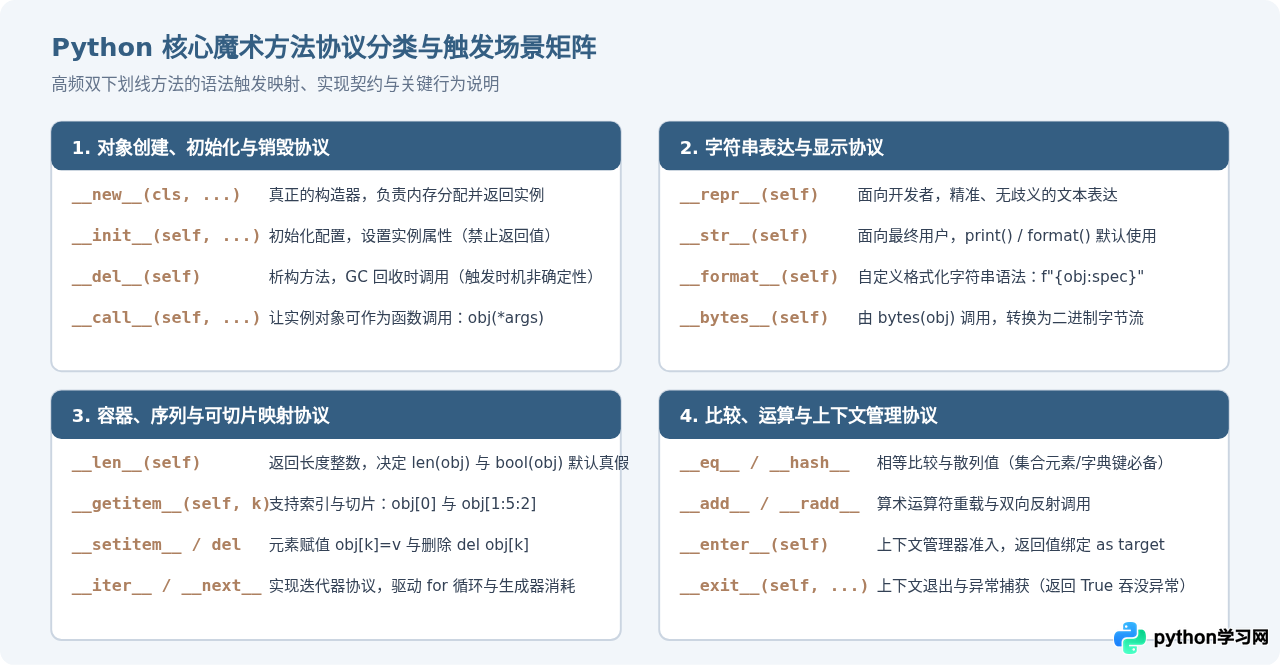
Python 内置了近百个特殊方法,涵盖了对象的全生命周期及全部语法交互。按职责可以将最常用的方法划分为以下四大核心协议族:
1. 对象构建与生命周期协议:`__new__` 与 `__init__`
在实例化对象时,Python 会先调用类方法 __new__(cls, *args, **kwargs),它的职责是创建并返回一个新的对象实例。只有当 __new__ 返回当前类的一个实例时,解释器才会接着调用 __init__(self, *args, **kwargs) 来进行属性配置。
通常情况下不需要重写 __new__,但在以下两个场景中 __new__ 不可替代:
- 继承不可变类型:如继承
tuple、str、float等,实例创建后无法在__init__中修改其值,必须在__new__阶段将初始值传递给底层分配。 - 设计模式实现:例如单例模式(Singleton)或对象池模式。
class PositiveNumber(float):
    """继承不可变 float 类型,强制将输入限制为正数"""
    def __new__(cls, value):
        val = super().__new__(cls, abs(value))
        return val

num = PositiveNumber(-18.5)
print(num)  # 输出示例: 18.5
2. 对象的调试与展示协议:`__repr__` 与 `__str__`
这是最容易混淆的一对特殊方法。理解它们的核心在于服务受众:
__repr__是面向开发者的。它的目标是提供准确、无歧义的描述,通常应当满足eval(repr(obj)) == obj的理想状态,或清晰展示类的关键属性值。__str__是面向终端用户的。它的目标是易读、友好,在print(obj)或str(obj)时被自动触发。
核心回退规则:当一个类没有实现 __str__ 时,Python 会自动回退调用 __repr__;但反之则不会。因此,在编写自定义类时,应始终优先实现 __repr__。
class Point2D:
    def __init__(self, x, y):
        self.x = x
        self.y = y

    def __repr__(self):
        # 提供可重现对象的精准字符串
        return f"Point2D(x={self.x}, y={self.y})"

    def __str__(self):
        # 友好的用户可读输出
        return f"({self.x}, {self.y})"

p = Point2D(3, 4)
print(str(p))   # 输出示例: (3, 4)
print(repr(p))  # 输出示例: Point2D(x=3, y=4)
3. 序列与集合协议:仅需两个方法实现完整序列特性
Python 优雅的鸭子类型协议最直观的体现是在容器设计上。只需在类中实现 __len__ 和 __getitem__,该类便立刻获得了下标访问、切片操作、甚至 for 循环和 in 成员判断:
class CardDeck:
    ranks = [str(n) for n in range(2, 11)] + list('JQKA')
    suits = ['黑桃', '红心', '梅花', '方块']

    def __init__(self):
        self._cards = [f"{s}{r}" for s in self.suits for r in self.ranks]

    def __len__(self):
        return len(self._cards)

    def __getitem__(self, position):
        return self._cards[position]

deck = CardDeck()
print(f"牌副总张数: {len(deck)}")       # 输出示例: 牌副总张数: 52
print(f"前三张牌: {deck[:3]}")          # 输出示例: 前三张牌: ['黑桃2', '黑桃3', '黑桃4']
print(f"方块A在牌堆中: {'方块A' in deck}") # 输出示例: 方块A在牌堆中: True
注意,我们并未编写 __iter__ 或 __contains__,但 Python 解释器在没有找到它们时,会自动回退尝试使用 __getitem__ 从索引 0 开始逐个遍历,以此完成迭代与成员检查。
四、工程实践中的关键注意事项与避坑指南
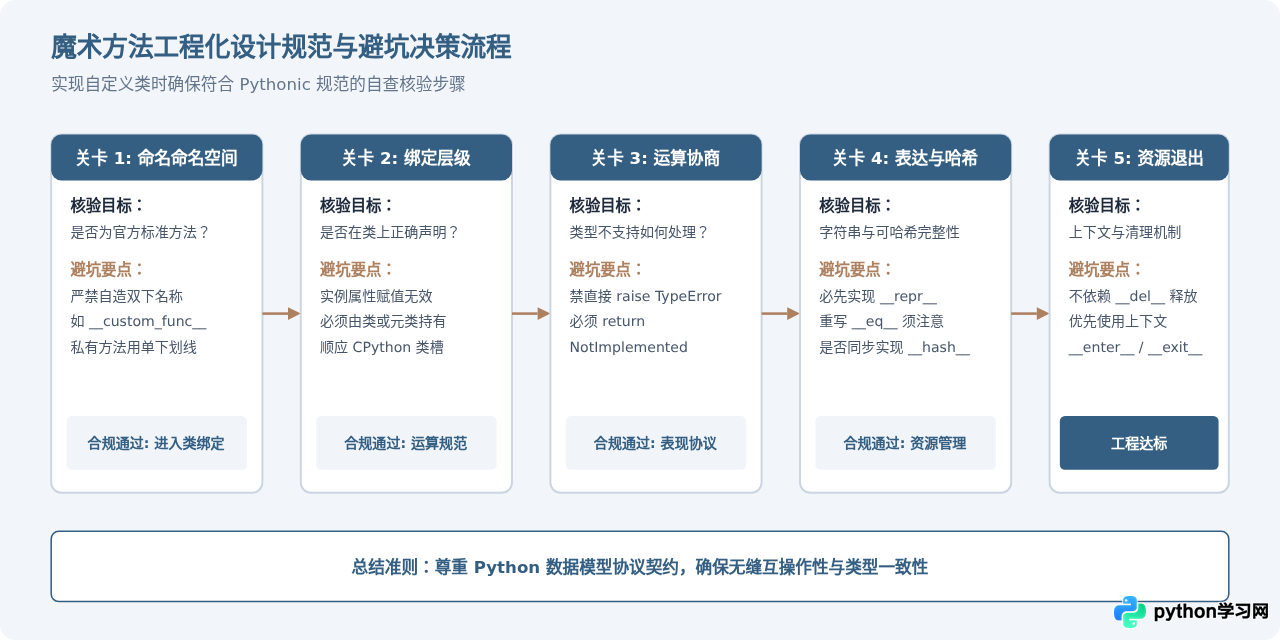
魔术方法赋予了 Python 强大的表达力,但在实际工程代码中,不当使用容易引入隐蔽的 Bug。以下是必须牢记的四条工程原则:
1. 绝不发明私有的双下划线方法
Python 官方明确保留所有以双下划线开头和结尾的命名空间。如果开发者在自己的业务类中定义诸如 __parse_data__ 或 __calculate__,极有可能在未来 Python 版本引入同名新特殊方法时发生非预期的行为冲突或静默覆写。私有方法请始终使用单下划线前缀(如 _parse_data)。
2. 运算符重载必须返回 `NotImplemented` 而非抛出 `TypeError`
当编写自定义的 __add__、__eq__ 等运算时,若发现传入的另一侧操作数不是支持的类型,切勿直接 raise TypeError。
return NotImplemented。核心原因:直接抛出异常会彻底打断解释器的协商流程,导致右侧对象的
__radd__ 永远没有机会执行;而返回 NotImplemented 则会优雅地通知解释器转去尝试其他操作数的反射实现。
3. 重写 `__eq__` 时必须注意 `__hash__` 的联动置空
在 Python 中,如果一个类重写了 __eq__ 却未显式声明 __hash__,Python 会自动将该类的 __hash__ = None。这意味着该类的实例将变为不可哈希(unhashable),无法存入 set 集合,也无法作为 dict 的键。若需要对象可哈希,必须确保相等的对象产生相同的哈希值,并同步实现 __hash__。
五、核心结论与回顾
Python 双下划线函数(魔术方法)并不是什么黑魔法,而是 Python 运行时所遵循的一整套严谨的数据模型契约。
- 概念本质:它们是为实现语言级功能(内置函数、运算符、语法结构)而预留的钩子接口。
- 查找机制:解释器为了性能与元类一致性,执行类级查找,直接通过 C 类型插槽派发,跳过实例字典。
- 协作原则:通过实现特定的协议组合(如序列协议、可调用协议、上下文协议),能够让自定义对象自然地融入 Python 原生生态中,编写出地道且健壮的 Pythonic 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















