


Python主要用来做什么:Web开发、数据分析与自动化应用场景解析
全面解析Python的核心应用场景:Web后端服务开发、数据分析与科学计算、办公与运维自动化。结合主流工具链选型、可运行代码示例、架构流程图与能力边界,帮助读者精准掌握Python的实际落地价值。
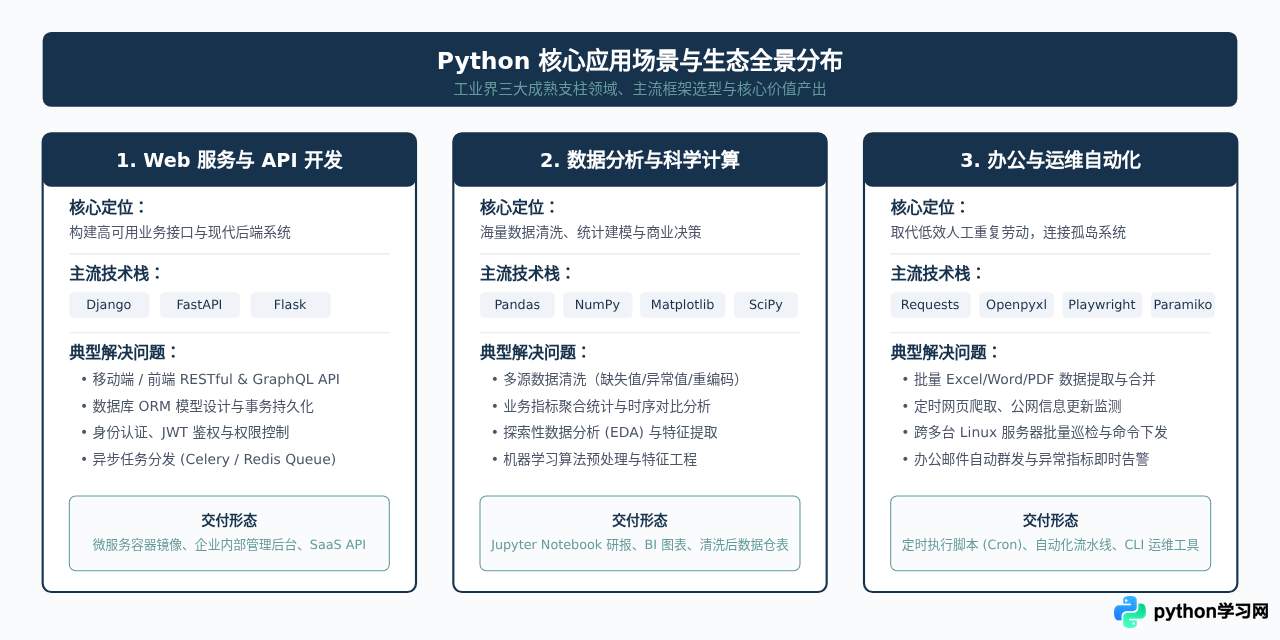
Python 是一门通用型高级编程语言。在工程实际中,它并没有均匀分散在所有软件开发领域,而是高度集中于三个核心场景:Web 后端与 API 服务开发、数据分析与科学计算、以及办公与系统运维自动化。本文将针对这三大支柱领域,系统拆解它们的核心解决问题、主流工具链选型、基础执行流程与代码示例,并明确指出 Python 的能力边界,帮助你在技术选型或技能学习中做出明确判断。
一、Web 开发场景:构建稳定高效的后端服务与接口
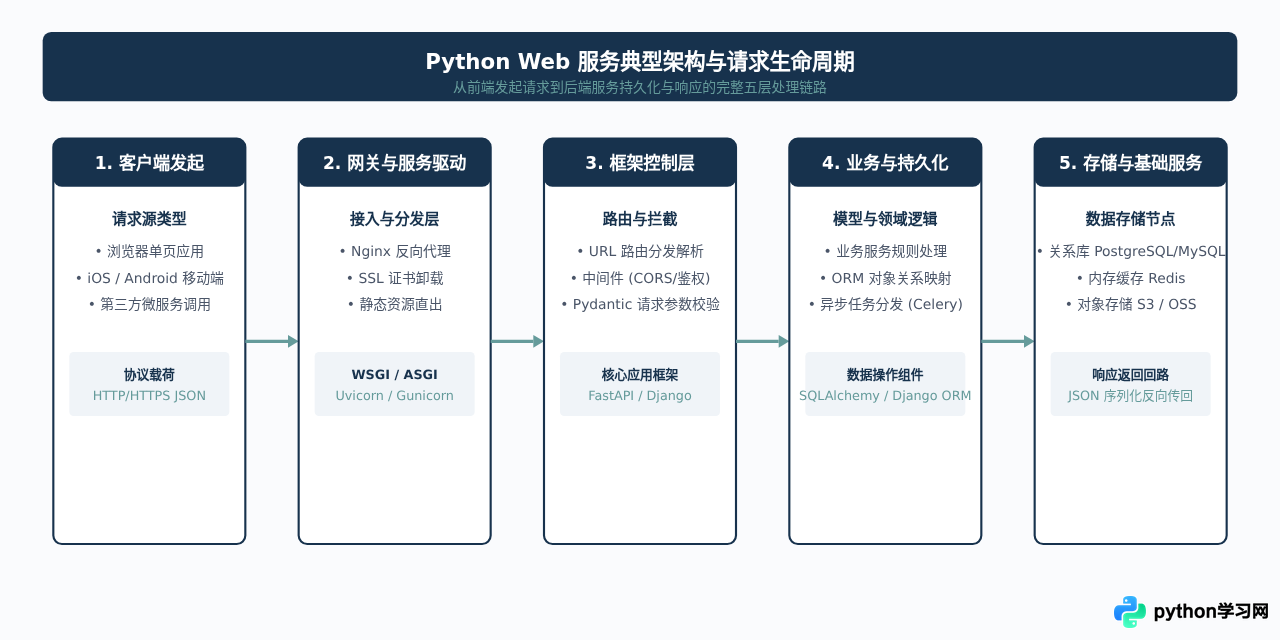
在 Web 开发领域,Python 主要承担后端服务(Server-side)的职责。它不直接负责移动端原生界面或前端浏览器的像素渲染,而是负责处理业务逻辑、数据库持久化、对外暴露 RESTful/GraphQL API、以及执行授权鉴权。Python 在该场景的最大优势在于极高的开发交付效率和极其成熟的第三方库支持。
1.1 主流框架选型与适用场景
在面对具体的 Web 任务时,开发者通常在以下三个主流框架中进行选择:
- FastAPI:现代高性能异步 API 框架。基于标准 Python 3.8+ 类型注解,底层由 Starlette 与 Pydantic 驱动。极其适合构建微服务架构、前后端分离的纯数据接口、以及 AI/机器学习模型的推理服务接口。
- Django:具备“开箱即用(Batteries-Included)”理念的全功能框架。自带成熟的 ORM、管理员后台(Admin)、用户认证系统、会话管理和 CSRF 防护,适合快速构建业务复杂度高、需要完备权限系统的企业级系统。
- Flask:轻量级微框架。只提供核心路由和请求响应机制,其余组件(如数据库、表单验证)均由开发者自由插拔,适合小型项目原型、工具类服务或轻量网关。
1.2 实战示例:使用 FastAPI 构建结构化服务接口
下面是一个标准的 FastAPI 服务接口代码。它展示了如何通过类型约束(Type Hinting)与 Pydantic 模型,快速完成参数检验、业务处理与自动生成 OpenAPI 文档:
# 运行环境需要安装: pip install fastapi uvicorn pydantic
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional
from datetime import datetime

app = FastAPI(title="用户任务管理系统", version="1.0.0")

# 1. 定义数据输入契约模型
class TaskCreateRequest(BaseModel):
    title: str = Field(..., min_length=2, max_length=100, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级1至5")
    assigned_to: Optional[str] = Field(default=None, description="指派人邮箱")

# 2. 模拟数据库持久化集合
mock_database = []

# 3. 编写业务接口
@app.post("/api/v1/tasks", status_code=status.HTTP_201_CREATED)
async def create_new_task(payload: TaskCreateRequest):
    # 重复性业务检查
    for existing in mock_database:
        if existing["title"] == payload.title:
            raise HTTPException(
                status_code=status.HTTP_400_BAD_REQUEST,
                detail=f"任务 '{payload.title}' 已存在,请勿重复创建"
            )

    record = {
        "id": len(mock_database) + 1,
        "title": payload.title,
        "priority": payload.priority,
        "assigned_to": payload.assigned_to,
        "created_at": datetime.utcnow().isoformat()
    }
    mock_database.append(record)
    return {"success": True, "data": record}

# 启动命令示例: uvicorn main:app --host 127.0.0.1 --port 8000 --reload
开发注意事项:
Python 由于存在全局解释器锁(GIL),对于高并发的 I/O 密集型接口(如频繁读写数据库或第三方网络调用),务必使用 async/await 异步编程范式;若涉及极消耗 CPU 的计算密集型操作(如图像实时转码、深度特征提取),应当将其解耦为后台队列任务(如 Celery),避免阻塞 Web 主线程。
二、数据分析与科学计算场景:从数据孤岛到决策洞察
数据分析是 Python 最具统治力的应用场景之一。在金融风控、电商运营、生物医药、市场研究以及机器学习前置特征工程中,Python 凭借其庞大且高度优化的 C 底层封装库,成为了数据科学领域的“事实标准”。
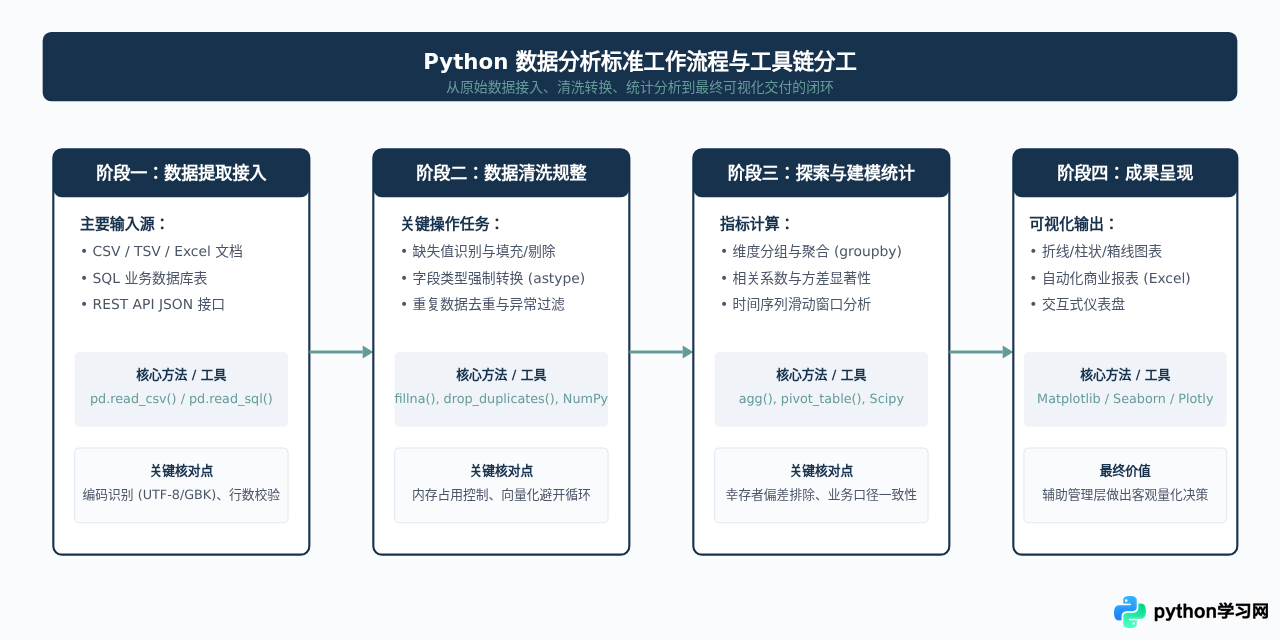
在这个场景中,Python 解决的核心任务可以拆解为四步:从各种渠道提取原始数据、清洗并结构化数据、执行分组统计与计算、输出图表或业务洞察报告。
2.1 实战示例:销售流水数据聚合与指标计算
以下示例使用 pandas 演示最典型的数据清洗与分组聚合计算。代码展示了如何处理缺失金额、提取时间维度,并按部门汇总核心业绩指标:
# 运行环境需要安装: pip install pandas numpy
import pandas as pd
import numpy as np

# 1. 模拟业务原始流水数据(含脏数据)
raw_records = {
    "order_id": ["ORD-101", "ORD-102", "ORD-103", "ORD-104", "ORD-105", "ORD-106"],
    "department": ["华东区", "华北区", "华东区", "华南区", "华北区", "华东区"],
    "sales_amount": [12500.0, np.nan, 8400.0, 21000.0, 15300.0, 9200.0],
    "client_type": ["企业", "个人", "企业", "企业", "个人", "企业"],
    "order_date": ["2026-01-10", "2026-01-11", "2026-01-12", "2026-01-12", "2026-01-14", "2026-01-15"]
}

df = pd.DataFrame(raw_records)

# 2. 数据清洗:填充缺失金额并转换时间格式
median_val = df["sales_amount"].median()
df["sales_amount"] = df["sales_amount"].fillna(median_val)
df["order_date"] = pd.to_datetime(df["order_date"])

# 3. 业务聚合:按部门统计订单量、总成交额及企业客户订单占比
summary = df.groupby("department").agg(
    total_orders=("order_id", "count"),
    total_revenue=("sales_amount", "sum"),
    average_order_value=("sales_amount", "mean"),
    enterprise_clients=("client_type", lambda s: (s == "企业").sum())
).reset_index()

# 4. 衍生指标计算:企业客户占比
summary["enterprise_ratio"] = (summary["enterprise_clients"] / summary["total_orders"]).round(2)

print("--- 部门销售指标汇总表 ---")
print(summary.to_string(index=False))

"""
示例输出结果:
department  total_orders  total_revenue  average_order_value  enterprise_clients  enterprise_ratio
      华东区             3        30100.0         10033.333333                   3              1.00
      华北区             2        26150.0         13075.000000                   0              0.00
      华南区             1        21000.0         21000.000000                   1              1.00
"""
避坑指南:
在 Pandas 中处理海量数据时,尽量避免使用 for index, row in df.iterrows() 遍历行。Python 的原生循环开销极大,应始终优先使用 Pandas 和 NumPy 内置的向量化计算(Vectorized Operations)或 apply,两者的执行速度差异通常在几十倍到上百倍。
三、自动化应用场景:批量办公、系统运维与爬虫任务
如果说 Web 开发和数据分析需要相对成体系的软件工程设计,那么自动化脚本则是体现 Python“即写即用”特点最立竿见影的领域。Python 拥有丰富的内置标准库(如 os, sys, shutil, subprocess)以及成熟的生态扩展,使其成为跨系统、跨软件调度与数据自动搬运的“胶水语言”。
3.1 常见的自动化落地分类
- 办公文档自动化(Office RPA):使用
openpyxl、python-docx或pypdf自动批量处理 Excel 报表合并、自动根据模板生成合同或请款单,彻底告别人工机械复制粘贴。 - 网络数据采集与爬虫:使用
requests+BeautifulSoup4抓取静态网页公开信息;或使用Playwright/Selenium控制真实无头浏览器,处理需要 JavaScript 动态渲染、模拟滑块验证与自动化测试的场景。 - 系统运维与环境监控:编写定期脚本巡检服务器磁盘空间、内存水位、网络连通性;使用
paramiko通过 SSH 协议批量向几十台服务器下发部署脚本或配置命令。
3.2 实战示例:多 Excel 报表自动合并与汇总导出
在实际办公场景中,往往需要汇总来自不同部门的独立 Excel 文件。以下脚本展示了如何使用标准库 pathlib 搭配 pandas 实现指定目录下多份销售报表的自动发现、校验与合并归档:
# 运行环境需要安装: pip install pandas openpyxl
from pathlib import Path
import pandas as pd

def batch_consolidate_reports(source_folder: str, output_file: str):
    folder_path = Path(source_folder)
    # 检索所有以 'sales_' 开头的 xlsx 文件
    excel_files = list(folder_path.glob("sales_*.xlsx"))

    if not excel_files:
        print(f"提示: 在目录 {source_folder} 下未找到匹配的 Excel 报表。")
        return

    consolidated_records = []

    for file_path in excel_files:
        try:
            # 读取单个报表
            temp_df = pd.read_excel(file_path)
            # 记录来源文件标识
            temp_df["source_branch"] = file_path.stem.replace("sales_", "")
            consolidated_records.append(temp_df)
            print(f"成功合并文件: {file_path.name} (行数: {len(temp_df)})")
        except Exception as err:
            print(f"读取文件 {file_path.name} 失败,跳过该文件。错误原因: {err}")

    if consolidated_records:
        final_df = pd.concat(consolidated_records, ignore_index=True)
        # 将结果输出到目标归档报表中
        final_df.to_excel(output_file, index=False, engine="openpyxl")
        print(f"--- 全部报表合并完成!累计整合 {len(final_df)} 条记录,已保存至: {output_file} ---")

# 调用示例 (在实际运行前确保对应目录及文件存在)
# batch_consolidate_reports("./branch_reports", "./consolidated_2026_q1.xlsx")
四、边界与局限:Python 不适合用来做什么?
客观理解一门编程语言,不仅要看它擅长什么,更要清楚它的局限性与不适用场景。盲目将 Python 用于不恰当的技术体系,通常会导致严重的性能瓶颈或维护困难:
| 应用领域 | Python 表现与主要痛点 | 工业界更推荐的替代语言 |
|---|---|---|
| 移动端原生 App 开发 | 虽然有 Kivy 等实验性框架,但在 iOS/Android 上打包体积庞大、控件缺乏原生触感、无法有效调用底层硬件 API。 | Swift (iOS), Kotlin (Android), Flutter / React Native (跨端) |
| 高性能游戏引擎与底层渲染 | 实时渲染与物理引擎对内存布局、低延迟 GC 及硬件并发要求极高,解释型语言的指令损耗无法接受。 | C++, C#, Rust |
| 超低延迟高频交易系统 | Python 解释器与动态类型推导带来不可控的微秒级抖动,垃圾回收机制(GC)无法保证毫秒以下硬实时要求。 | C++, Rust |
| 纯浏览器端用户界面 | 浏览器原生仅支持运行 JavaScript 和 WebAssembly,虽然有 PyScript 等尝试,但加载体积巨大、初始化启动缓慢。 | JavaScript, TypeScript |
五、选型与决策总结
综合以上分析,Python 在工程实践中的定位可以清晰归纳为:以极高的开发迭代效率换取合理的运行损耗。它最适合在业务逻辑频繁变动、开发交付周期紧张、或者需要深度利用科学计算与数据生态的场景下发挥威力。
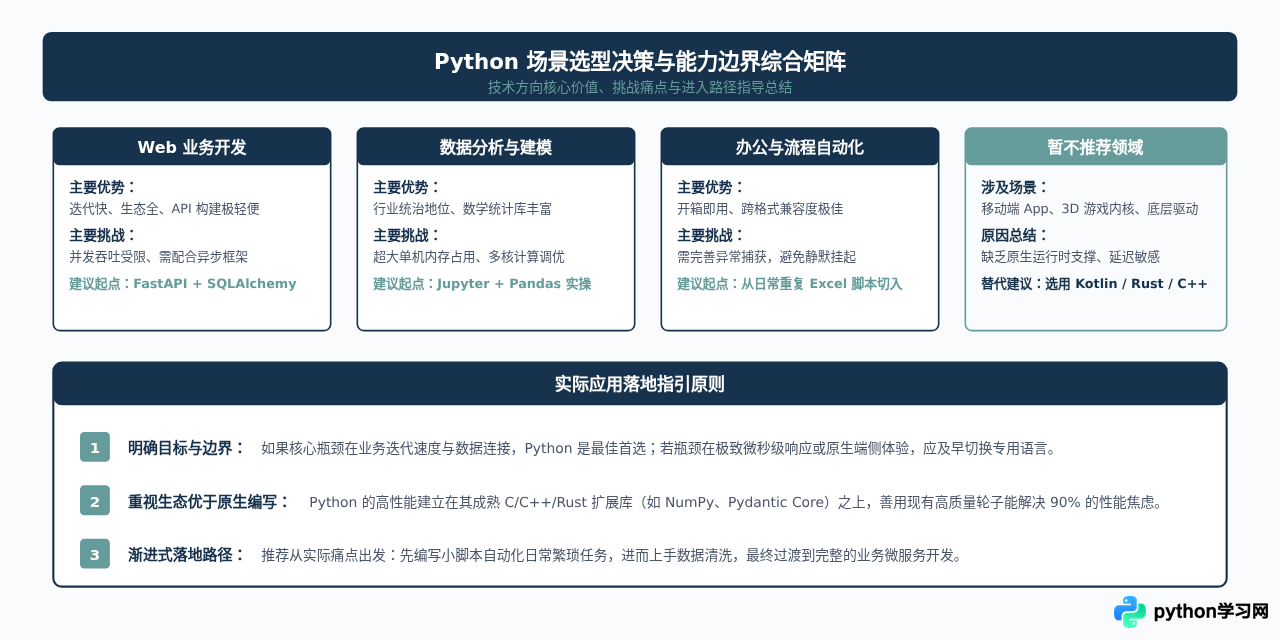
通过理清 Python 的三大核心支柱场景(Web 开发、数据分析、任务自动化)及其对应的成熟工具链,你可以根据当前的实际业务需求进行精准选型,以最低的试错成本完成项目开发与技术落地。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















