


Python异步爬虫实战:怎么用aiohttp提升抓取效率
深入讲解如何使用Python的asyncio与aiohttp构建高并发异步爬虫,详细剖析ClientSession连接池复用、Semaphore并发限流、超时控制与生产级代码实现,切实提升网络爬取效率。
在单机环境下爬取成百上千个网络页面时,基于 requests 的传统同步爬虫会把绝大部分时间耗费在等待远程服务器的 I/O 响应上。解决这一吞吐瓶颈的核心路径,是借助 Python 官方的 asyncio 事件循环与异步 HTTP 库 aiohttp,实现“请求发出即挂起、响应返回即唤醒”的非阻塞并发。然而,真正的效率提升并非盲目派发数万个未控速的协程,而在于正确管理长连接生命周期、精准实施并发信号量约束,以及做好超时防护与异常重试。本文将围绕这些关键机制展开详细实战讲解。
一、为什么同步爬虫慢:阻塞 I/O 与异步并发机制对比
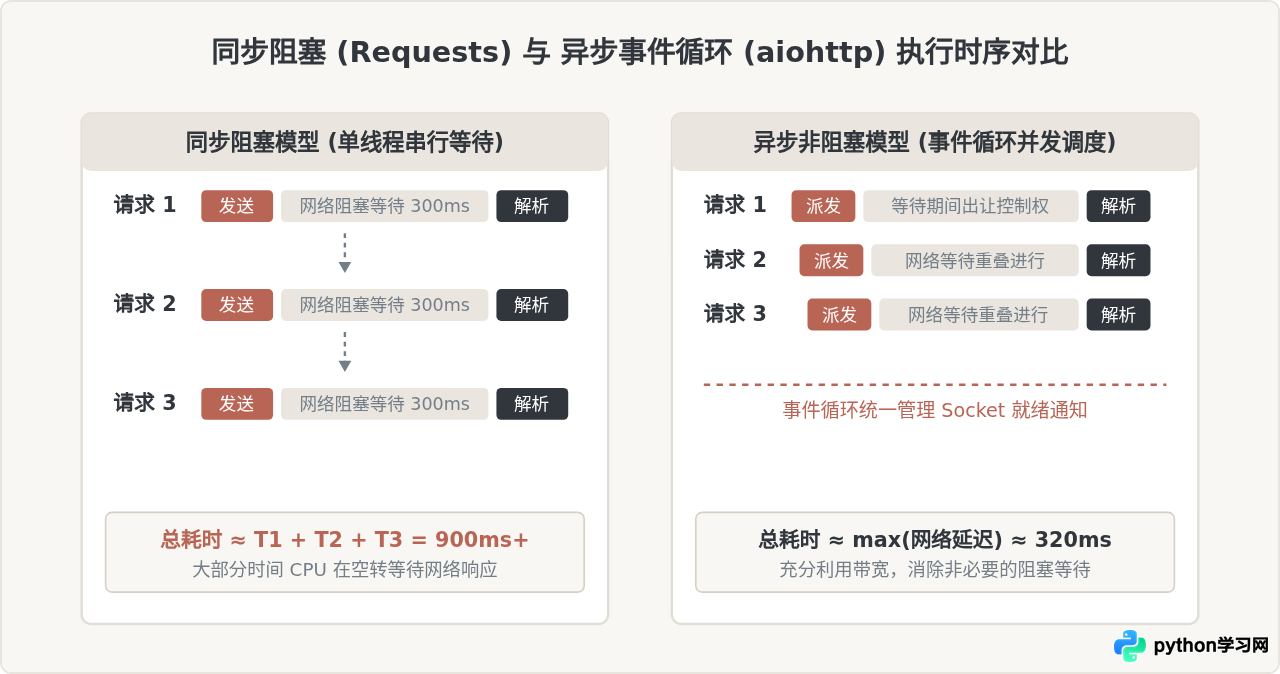
网络爬虫是典型的 I/O 密集型应用。在使用同步网络库时,程序的执行流是严格串行的:发起 HTTP 请求后,线程必须阻塞在 Socket 读写上,等待远程服务器完成 DNS 查询、建立 TCP 连接、处理后端业务并传输数据包。在这段往往长达数百毫秒的网络延迟期间,本地 CPU 处于空转状态。如果需要抓取 1000 个页面,单线程同步耗时就是 1000 次网络请求时长的简单累加。
aiohttp 配合 asyncio 则完全改变了这种等待模式。它在单线程内运行一个事件循环(Event Loop)。当某个协程(Coroutine)发出网络请求遇到 await 挂起点时,控制权会立即交还给事件循环,事件循环随即调度下一个准备就绪的任务发起新请求。底层的操作系统多路复用机制(如 Linux 上的 epoll 或 macOS 上的 kqueue)负责监听所有 Socket 的读写状态。一旦有响应数据到达,对应的协程被重新唤醒并继续解析数据。这样,成百上千个请求的网络等待时间在时间轴上高度重叠,单机抓取吞吐量因此成倍增加。
二、aiohttp 基础与核心组件:正确使用 ClientSession
在编写异步爬虫代码前,必须明确 aiohttp 运行的核心基石——ClientSession。初学者常犯的一个严重错误是像调用 requests.get 一样,在每个抓取函数内部临时创建一个 session,并在抓取完成后销毁。这种做法不仅抹平了异步的性能优势,还会迅速耗尽本地端口并导致系统报 OSError: Too many open files。
ClientSession 本质上是一个内置连接池的高级连接管理器。它的核心职责包括:
- 连接池复用(Keep-Alive):跨请求复用底层已建立的 TCP 连接,省去每次握手协商与 TLS 证书验证的大量时间与计算开销。
- Cookie 与状态维护:集中管理 Cookie Jar,便于在多步爬取或模拟登录流程中共享会话状态。
- 并发调度载体:统一承载连接上限与超时配置,协调派发到同一或不同域名的 HTTP 请求。
因此,在编写异步爬虫时,整个程序的生命周期中通常只需维护一个全局的 ClientSession 实例,通过参数注入或上下文管理器传递给所有爬取任务。
下面是一个标准的单次请求异步上下文演示:
import asyncio
import aiohttp

async def fetch_page(url: str):
    # 使用上下文管理器保证会话与连接的正确释放
    async with aiohttp.ClientSession() as session:
        async with session.get(url) as response:
            print(f"状态码: {response.status}")
            # 必须用 await 获取响应体文本
            html = await response.text(encoding="utf-8")
            return html

if __name__ == "__main__":
asyncio.run(fetch_page("https://httpbin.org/get"))注意:获取响应内容(如 response.text() 或 response.read())必须加上 await 关键字,因为从底层套接字缓冲区读取数据本身是一个异步网络 I/O 操作。
三、构建异步抓取工作流:从单个任务到批量并发
从单个请求过渡到成千上万个 URL 的批量抓取,需要建立清晰的任务调度流。一个健壮的 aiohttp 异步爬虫工作流通常由五个标准阶段组成:目标队列准备、连接会话初始化、协程包装与保护、批量并发汇聚、以及最终的结果汇总与资源释放。
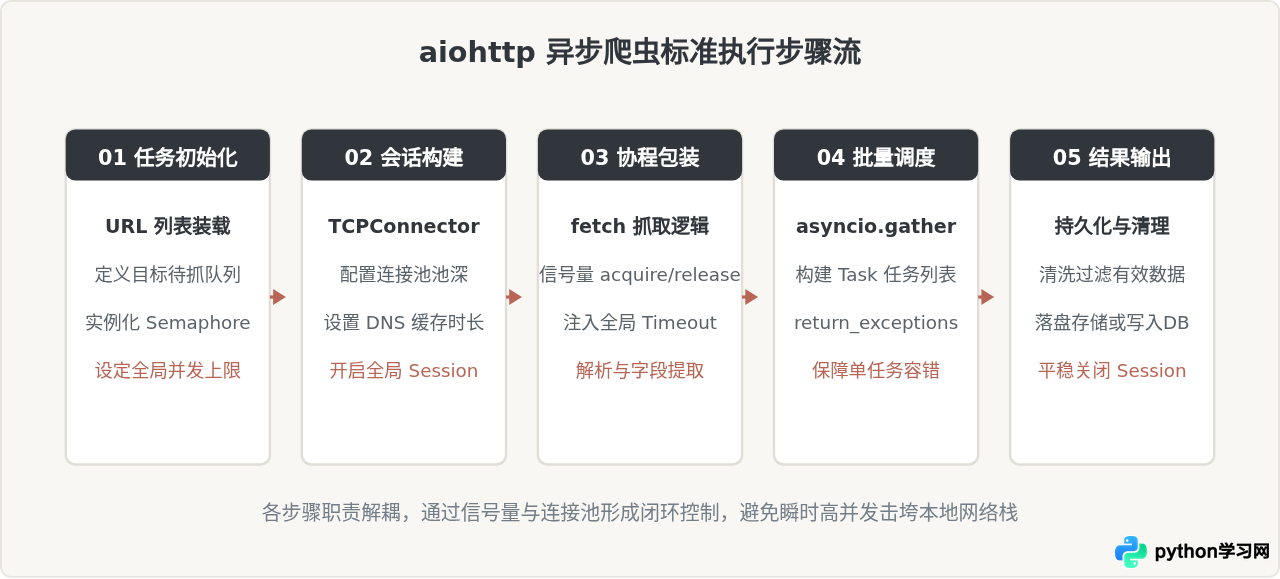
在实现任务汇聚时,最常用的调度函数是 asyncio.gather(*tasks, return_exceptions=True)。这里必须特别强调参数 return_exceptions=True 的重要性:默认情况下,如果任意一个协程抛出未捕获的异常(例如某 URL 触发超时或 404 错误),gather 会立即中断并向上抛出异常,导致其它正在进行的抓取任务无法正常收集结果。开启该参数后,异常对象会被当作普通返回值放入结果列表中,便于在遍历结果时统一做过滤与失败重试。
四、避免崩溃的关键:并发控制、超时与连接池调优
在编写异步爬虫时,吞吐量并不是越大越好。许多开发者在刚接触 aiohttp 时,直接对 10,000 个 URL 同时 asyncio.gather。这种未加节制的“真并发”会导致三个灾难性后果:
- 操作系统资源耗尽:瞬间开启上万个 Socket 会迅速超出操作系统默认的单个进程文件描述符限制(通常为 1024 或 4096),引发
Too many open files。 - DNS 解析雪崩:瞬时并发的大量域名解析请求会直接压垮本地或局域网的 DNS 服务器,产生大量的
ClientConnectorCertificateError或ServerDisconnectedError。 - 触发反爬封禁:目标站点在短时间内接收到来自同一 IP 的超高频并发请求,会立即返回 HTTP 429(Too Many Requests)或直接将 IP 拉入黑名单。
为了在效率与稳定性之间找到平衡点,必须依靠 asyncio.Semaphore 与 TCPConnector 构建分层控制体系。
1. 使用 Semaphore 限制瞬时并发
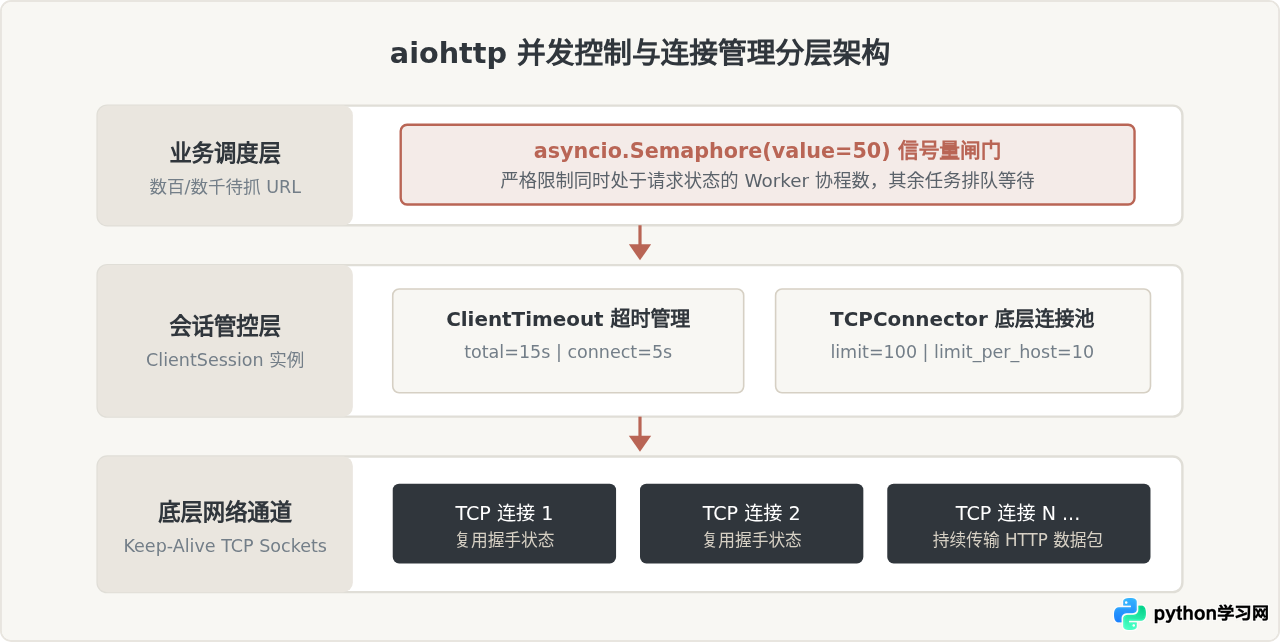
asyncio.Semaphore 维护了一个内部计数器。每次调用 async with semaphore: 会尝试消耗一个配额;当配额耗尽时,后续协程会自动挂起排队,直到有其它协程执行完毕释放配额。这样无论有多少个待抓取 URL,真正处于并发网络传输状态的任务数量始终被锁定在安全阈值之内(常规抓取推荐设置为 30 到 100 之间)。
2. 精准配置 ClientTimeout
在异步爬虫中,如果一个连接因为远程服务器卡顿或中间链路丢包而无限期悬挂,对应的协程就会一直占用信号量配额与连接池资源,最终导致爬虫“假死”。必须显式配置 aiohttp.ClientTimeout:
total:整个请求(从发起建立连接到完整读取所有响应体)的总超时时间。sock_connect:TCP 套接字建立连接的超时上限。sock_read:连续两次套接字读取之间的最大空闲时间。
3. 调优 TCPConnector 参数
通过传入自定义的 TCPConnector,可以对底层网络特性进行调优:
limit=100:全局最大并发连接数池深。limit_per_host=10:限制针对同一域名的并发连接数,防止单点冲击触发目标站防刷策略。ttl_dns_cache=300:启用 DNS 缓存 300 秒,避免成千上万个请求反复查询域名解析。
五、完整实战代码:高吞吐生产级异步爬虫实现
结合上述设计原则,下面给出一份结构完整、具备信号量限速、全局连接复用、超时防护与错误捕获的生产级异步爬虫脚本。代码中以抓取结构化 JSON 示例数据为例,前后的变量、参数与调用关系严格对应。
import asyncio
import logging
from typing import List, Dict, Any, Optional
import aiohttp

# 基础日志配置
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("AsyncSpider")

async def fetch_url(
    session: aiohttp.ClientSession,
    url: str,
    semaphore: asyncio.Semaphore,
    max_retries: int = 2
) -> Optional[Dict[str, Any]]:
    """在信号量保护下发起异步抓取,包含重试机制"""
    async with semaphore:
        for attempt in range(1, max_retries + 1):
            try:
                # 针对单次请求设定独立的快速读取超时
                async with session.get(url) as response:
                    if response.status == 200:
                        data = await response.json(content_type=None)
                        logger.info(f"抓取成功: {url}")
                        return {"url": url, "status": response.status, "data": data}
                    elif response.status == 429:
                        # 触发流控时主动退避
                        logger.warning(f"触发 429 流控,等待 2 秒: {url}")
                        await asyncio.sleep(2)
                    else:
                        logger.warning(f"状态码异常 [{response.status}]: {url}")
            except (aiohttp.ClientError, asyncio.TimeoutError) as err:
                logger.error(f"第 {attempt} 次请求失败: {url},原因: {err}")
                if attempt < max_retries:
                    await asyncio.sleep(0.5 * attempt)
            except Exception as e:
                logger.critical(f"未知异常: {url},原因: {e}")
                break
        return None

async def main_crawler(urls: List[str], max_concurrency: int = 20) -> List[Dict[str, Any]]:
    """主调度函数:构建连接池与任务并发派发"""
    # 1. 设定信号量限制
    semaphore = asyncio.Semaphore(max_concurrency)

    # 2. 调优底层连接器:开启 DNS 缓存与连接上限
    connector = aiohttp.TCPConnector(
        limit=100,               # 全局连接池大小
        limit_per_host=10,       # 单域名连接池深度
        ttl_dns_cache=300,       # DNS 缓存保留 5 分钟
        enable_cleanup_closed=True
    )

    # 3. 设定会话全局超时
    timeout = aiohttp.ClientTimeout(total=15, sock_connect=5, sock_read=8)

    # 4. 共享单一全局 ClientSession
    async with aiohttp.ClientSession(
        connector=connector,
        timeout=timeout,
        headers={"User-Agent": "Mozilla/5.0 (compatible; AsyncSpider/1.0)"}
    ) as session:
        # 创建待执行任务列表
        tasks = [fetch_url(session, url, semaphore) for url in urls]

        # 批量派发并拦截单任务异常
        results = await asyncio.gather(*tasks, return_exceptions=True)

    # 过滤掉抓取失败或抛出异常的结果
    valid_results = [r for r in results if isinstance(r, dict)]
    logger.info(f"抓取完成!总任务数: {len(urls)}, 成功获取: {len(valid_results)}")
    return valid_results

if __name__ == "__main__":
    # 构造示例待抓取 URL 队列 (使用公共测试 API)
    target_urls = [
        f"https://jsonplaceholder.typicode.com/posts/{i}"
        for i in range(1, 41)
    ]

    # 运行事件循环
    crawl_data = asyncio.run(main_crawler(target_urls, max_concurrency=10))
示例执行输出(示例日志)
2026-10-16 01:28:10 [INFO] 抓取成功: https://jsonplaceholder.typicode.com/posts/1
2026-10-16 01:28:10 [INFO] 抓取成功: https://jsonplaceholder.typicode.com/posts/3
2026-10-16 01:28:10 [INFO] 抓取成功: https://jsonplaceholder.typicode.com/posts/2
...
2026-10-16 01:28:11 [INFO] 抓取成功: https://jsonplaceholder.typicode.com/posts/40
2026-10-16 01:28:11 [INFO] 抓取完成!总任务数: 40, 成功获取: 40
六、总结与排坑指南
要让 aiohttp 真正发挥出高吞吐优势,必须在代码编写和运行维护中严格遵守几项基本原则:
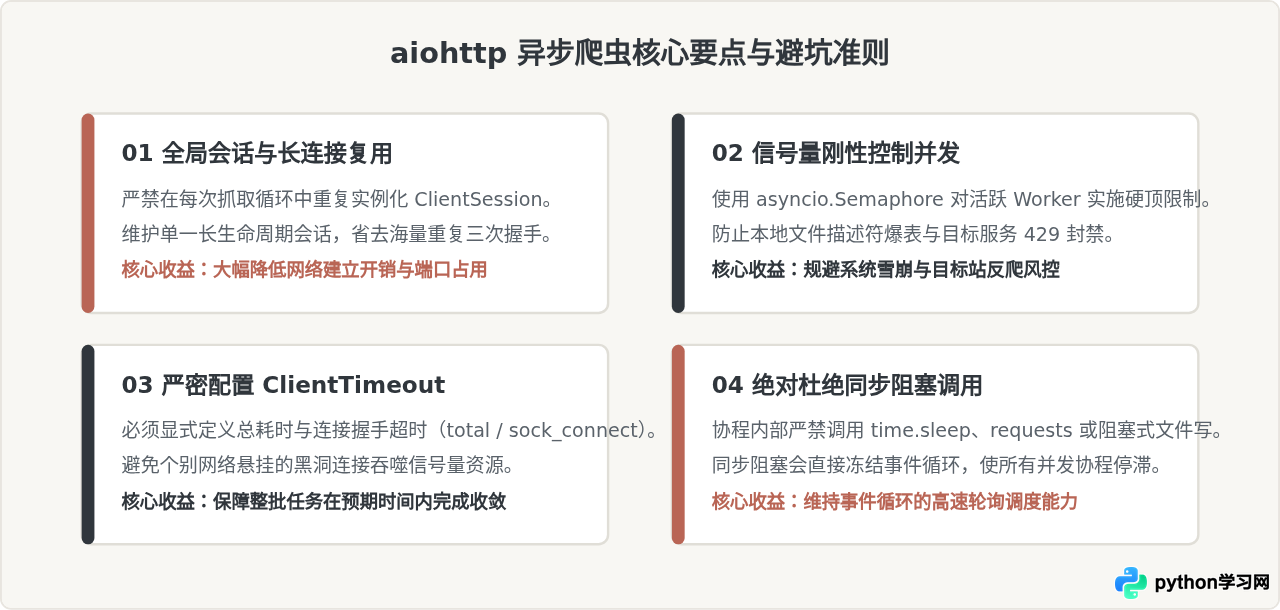
常见踩坑清单
| 问题现象 | 根因剖析 | 解决与规避方案 |
|---|---|---|
OSError: [Errno 24] Too many open files |
未限制并发量,或在循环中反复新建未关闭的 ClientSession,导致系统文件句柄耗尽。 | 全局共享单例 ClientSession,并配合 asyncio.Semaphore 设定合理并发阈值。 |
| 爬虫运行缓慢,速度与 requests 无异 | 在协程函数中混用了 time.sleep() 或同步阻塞库,导致事件循环被整体冻结。 |
全面替换为 await asyncio.sleep(),CPU 密集型或重计算解析交由 ProcessPoolExecutor。 |
| 程序挂起假死,长时间不退出 | 未设置超时参数,某些请求进入无限挂起状态;或者使用 gather 时未妥善处理未完成任务。 |
显式传入 ClientTimeout,并在程序退出时确保调用 await session.close()。 |
大量请求报 Unclosed client session 警告 |
程序异常退出时未显式关闭 session,或未采用 async with 上下文管理器。 |
始终使用 async with aiohttp.ClientSession(),或在 finally 块中执行关闭。 |
综上所述,利用 aiohttp 提升爬虫抓取效率的核心并非单纯追求瞬时并发数字,而是建立在连接池复用、信号量约束与精细超时控制之上的确定性调度。通过这一套体系,不仅能将 I/O 等待耗时压缩到极致,还能确保爬虫长期稳定、受控地运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















