


Python切片索引越界为什么不报错
深入解析Python中单索引越界抛出IndexError而切片越界却安全返回空列表或截断列表的深层原因、底层CPython边界裁剪算法与设计哲学。
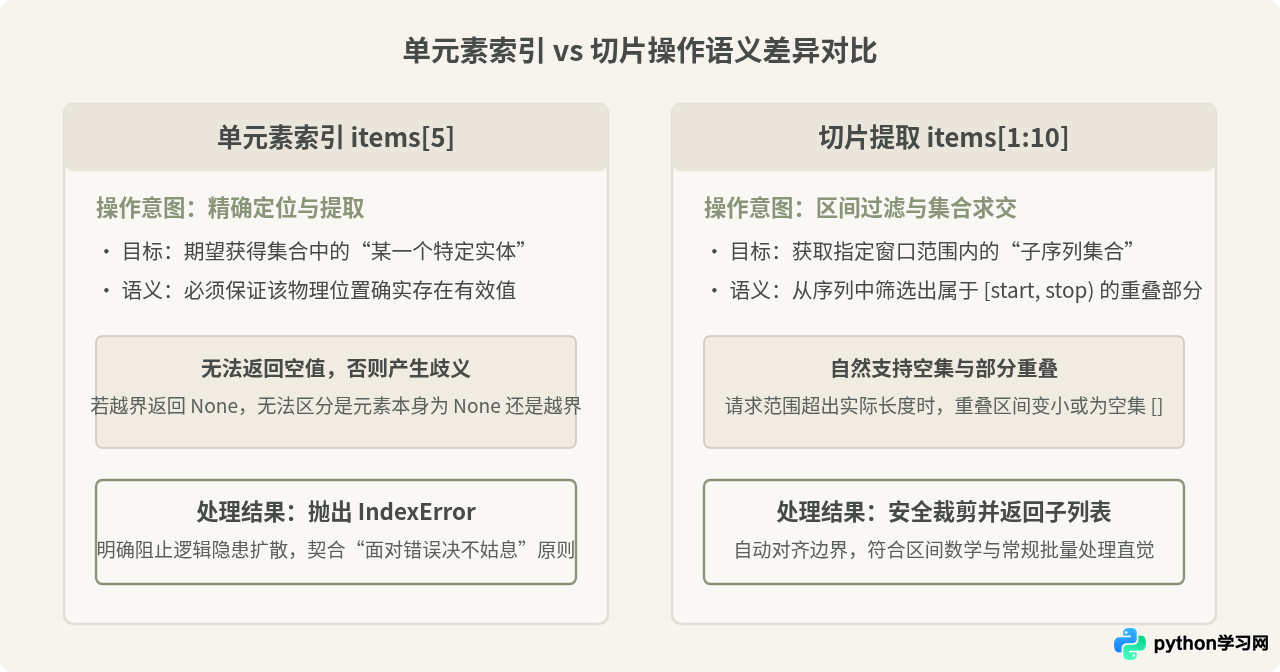
在 Python 编程中,很多开发者都经历过这样的对比:当我们尝试用下标访问一个不存在的列表元素(如 lst[10])时,解释器会立即抛出 IndexError: list index out of range;然而,如果我们对同一个列表执行远超长度范围的切片(如 lst[5:100] 或 lst[50:100]),程序不仅不会报错,反而会安静地返回剩余有效元素甚至空列表。这种截然不同的行为并不是 Python 解释器的疏忽,而是由“精确定位单元素”与“区间截取子序列”两种完全不同的语义设计和底层边界裁剪算法决定的。
一、现象对比:单索引报错与切片容错
为了直观观察两者的行为差异,我们可以先运行一段简单的示例代码。在一个仅包含 3 个元素的列表中分别执行下标访问和切片操作:
# 示例代码:单索引访问与切片操作对比
items = ['apple', 'banana', 'orange']
print("列表长度:", len(items))

# 1. 单元素下标越界访问
try:
    val = items[5]
except IndexError as e:
    print("items[5] 报错信息:", e)

# 2. 切片越界访问
slice_res1 = items[1:10]
slice_res2 = items[10:20]

print("items[1:10] 结果:", slice_res1)
print("items[10:20] 结果:", slice_res2)
运行上述代码后,终端得到的示例输出如下:
# 示例输出
列表长度: 3
items[5] 报错信息: list index out of range
items[1:10] 结果: ['banana', 'orange']
items[10:20] 结果: []
从输出中可以看出,当下标超出 0 <= index < len(items) 的合法范围时,单索引立即阻断并抛出异常;而切片 items[1:10] 自动截取至列表末尾,切片 items[10:20] 则返回了一个空的列表对象,程序全程平稳运行。
二、深层设计哲学:为什么切片不应该报错
要理解切片容错机制,必须从语言设计的核心思想——“集合与区间”的数学概念谈起。
1. 集合求交集不会产生“未定义行为”
在数学概念中,区间切片本质上是计算“请求区间”与“容器实际有效区间”的交集。假设一个列表的有效索引区间是 [0, 3):
- 当请求区间为
[1, 10)时,其与[0, 3)的交集是[1, 3),对应列表后两个元素; - 当请求区间为
[5, 10)时,其与[0, 3)完全没有重叠,交集为空集[]。
在集合论中,求两个集合的交集得到空集是非常正常的数学结果,绝不是程序异常。如果每次求交集为空就抛出错误,反而违背了集合操作的基本公理。
2. 避免冗余且容易出错的防御性代码
在日常文本处理、分页查询和窗口截取场景中,字符串或列表的长度往往是动态的。假设我们要截取一个字符串前 10 个字符作为摘要:
- 如果切片越界会报错,开发者每次截取都必须写成
s[:min(len(s), 10)]; - 而在 Python 现有的切片设计下,直接书写
s[:10]即可,既精炼又杜绝了边界计算失误。
三、底层实现:CPython 如何裁剪越界索引
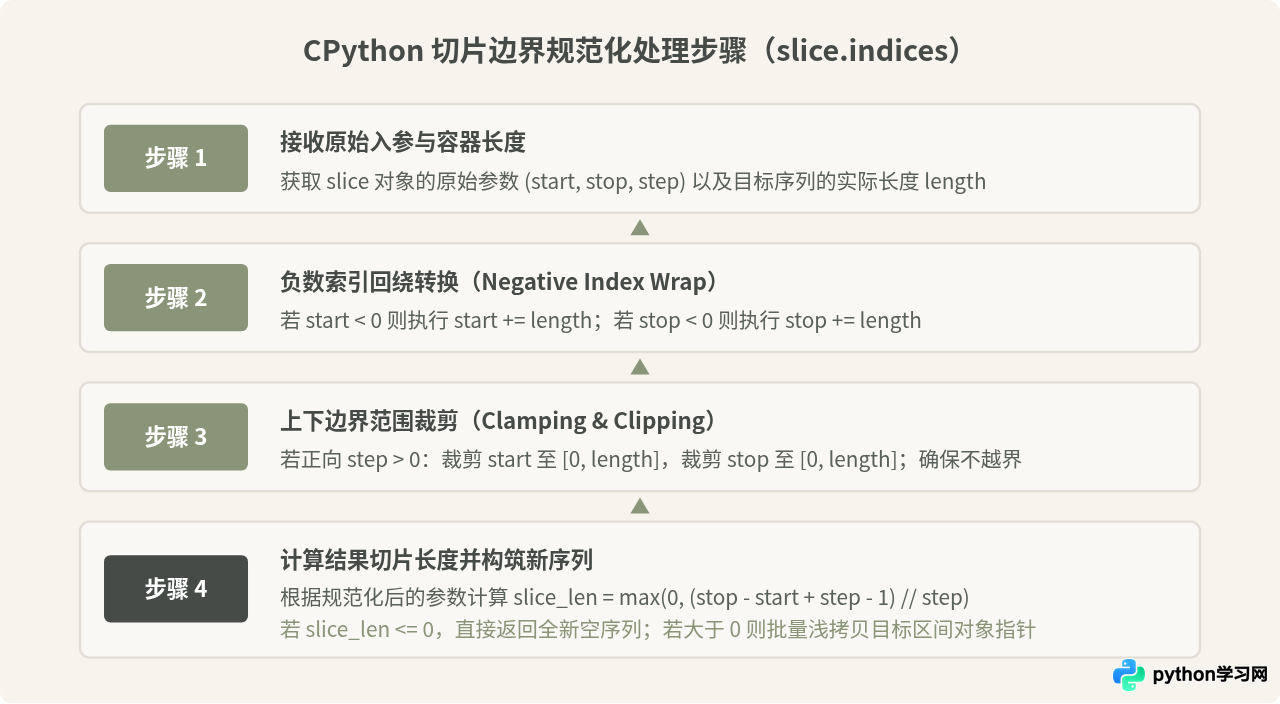
在 CPython 解释器源码中,切片不是粗暴地直接遍历下标,而是通过标准的边界规范化函数进行参数裁剪。在 Python 中,内置的 slice 类提供了一个名为 indices() 的方法,它直接反映了 C 语言底层 PySlice_GetIndicesEx() 函数的内部逻辑。
# 演示 Python 内部对切片参数的自动规范化与裁剪计算
s = slice(2, 50, 1)
length = 5

# indices(length) 接收容器长度,返回安全合法的 (start, stop, step)
safe_start, safe_stop, safe_step = s.indices(length)
print(f"原始切片: [2:50:1],容器长度: {length}")
print(f"规范化后安全索引范围: start={safe_start}, stop={safe_stop}, step={safe_step}")
运行结果显示:
# 示例输出
原始切片: [2:50:1],容器长度: 5
规范化后安全索引范围: start=2, stop=5, step=1
原本超出容器长度的 stop=50 被自动裁剪(Clamp)为 stop=5,完全消除了底层内存越界访问的可能。
四、切片坐标系模型:间隔槽位与区间投影
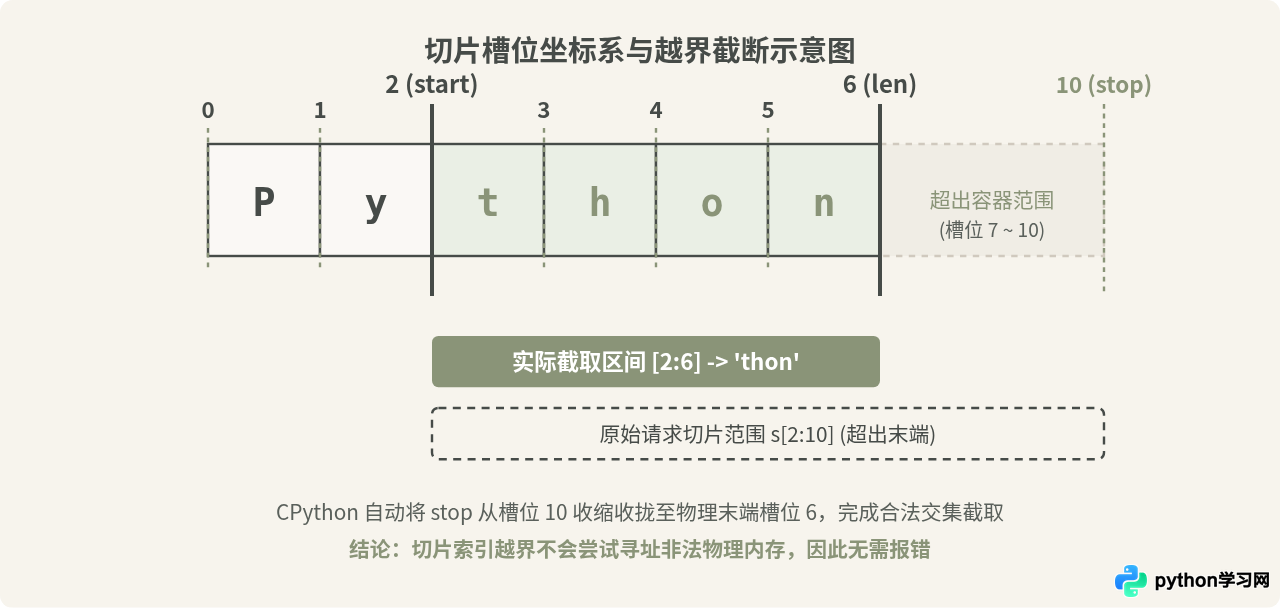
在学习 Python 时,官方教程常推荐一种有助于理解切片的视角:切片索引并不指向具体元素本身,而是指向元素之间的“缝隙”或“槽位”。
例如,对于长度为 6 的字符串 "Python",有效槽位编号为 0, 1, 2, 3, 4, 5, 6。第 0 号槽位位于首字符之前,第 6 号槽位紧随末字符之后。当指定切片 [2:10] 时,起始位置对齐在槽位 2(字符 't' 之前),终止位置被裁剪收敛于末端槽位 6(字符 'n' 之后),因此截取出的内容完整覆盖 't', 'h', 'o', 'n'。
五、切片越界常见陷阱与注意事项
虽然切片索引越界不报错为日常开发带来了极大便利,但在特定场景下,若对这一特性的预期不充分,容易引入隐蔽的代码逻辑缺陷。
1. 误用切片替代单索引导致逻辑断层
有时开发者为了“防止程序抛出 IndexError”,习惯用 lst[i:i+1] 替代 lst[i]:
- 当下标
i处于合法范围时,lst[i:i+1]返回单元素列表[x]; - 一旦
i发生越界,它静默返回空列表[]。
这种做法虽然避免了崩溃,但如果后续代码直接假设该列表中有元素(例如调用 lst[i:i+1][0]),错误只是被延后抛出;如果后续直接忽略空列表,可能会掩盖业务上真正的数据缺失问题。明确需要单个元素时,应显式检查长度或使用异常捕获。
2. 切片赋值越界时的“静默追加”行为
切片不仅用于读取,还可用于赋值。如果对超出范围的切片进行赋值,Python 不会报错,而是直接将新内容追加在列表末尾:
# 切片赋值越界示例
nums = [1, 2, 3]

# 给远超长度的切片位置赋值
nums[100:105] = [99, 100]

print("切片赋值后列表:", nums)
输出结果为:
# 示例输出
切片赋值后列表: [1, 2, 3, 99, 100]
原本期望替换索引 100 的位置,结果由于被裁剪至末尾 [3:3],等同于执行了列表尾部拼接。在编写更新逻辑时必须留意这一细节。
六、总结与开发实践指引
Python 中切片索引越界不报错的本质可以归纳为两点:语义上切片是区间集合求交,允许空子集;实现上 CPython 通过内置算法将边界安全裁剪至合法范围,杜绝了非法内存访问。
| 操作类型 | 典型代码 | 越界时的表现 | 推荐使用场景 |
|---|---|---|---|
| 单元素下标 | lst[i] |
立即抛出 IndexError |
精确定位确定的业务数据;必须确保该位置元素存在 |
| 区间切片 | lst[start:stop] |
自动截断裁剪,安全返回有效子列表或 [] |
截取前 N 项、分页、滑动窗口、后缀匹配等范围操作 |
| 安全下标模式 | lst[i] if i < len(lst) else default |
返回业务默认值,不报错 | 需要单个元素但数据可能不完整时的安全降级 |
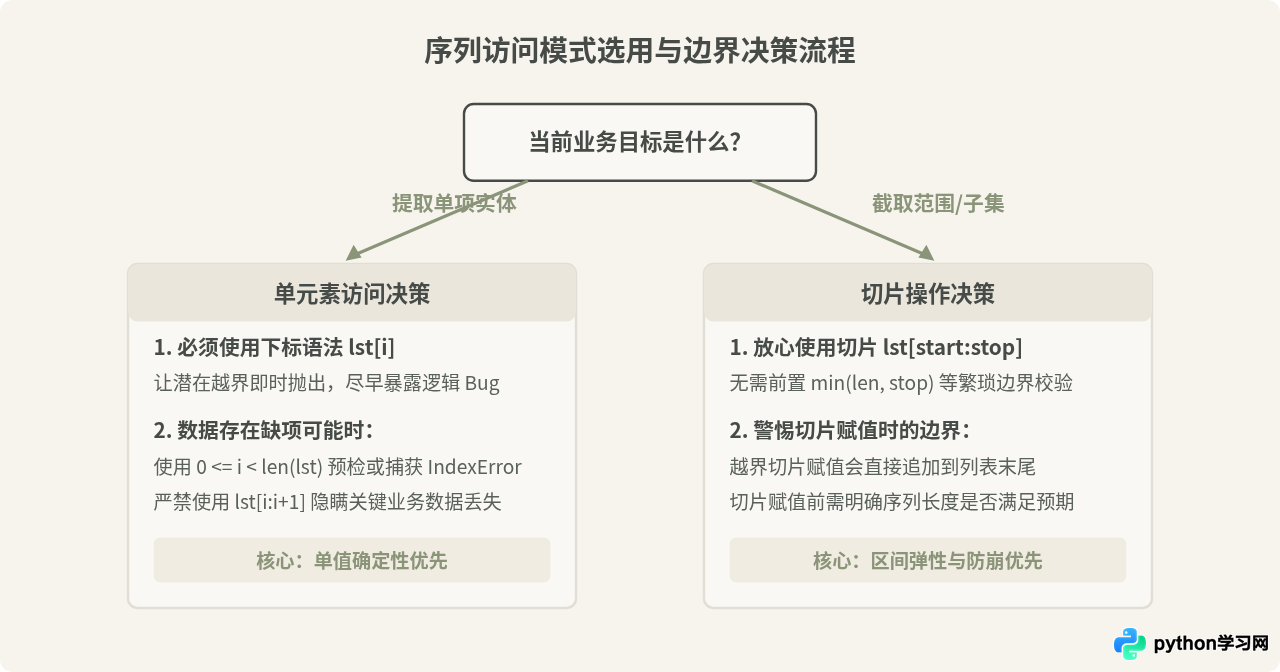
总结:Python 在设计上始终坚持“显式优于隐式,面对错误决不姑息”。单索引越界如果不报错,就会导致程序在产生逻辑错误后继续带着脏状态运行;而切片从数学定义上就是区间求交,交集为空本身就是完全合法且严谨的运算结果。理解这一设计初衷,能帮助我们在编写 Python 代码时更加自然、准确地选择合适的数据访问范式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















