


Python批量插入数据到MySQL的性能优化方法
深入解析Python批量向MySQL插入大量数据时的性能瓶颈与优化方案,涵盖单条多值改写、显式事务分批控制、LOAD DATA INFILE原生导入及MySQL引擎参数调优。
在数据处理、日志汇聚与业务离线同步等场景中,Python经常需要向MySQL写入成千上万乃至数百万行数据。如果按照初学阶段直观的“单循环多次INSERT”方式写入,耗时常常从几秒急剧膨胀至几十分钟甚至数小时。优化批量插入的关键,并不是盲目更换底层驱动,而是消除客户端与数据库之间的多余网络往返开销、大幅降低InnoDB存储引擎的事务刷盘频次,以及选用更贴近底层存储的高效载入路径。
一、为什么单条循环插入会极度缓慢
许多开发者在遇到批量写入需求时,习惯写出如下的循环结构:
# 性能低下的典型范例:单条循环提交
for item in data_list:
    cursor.execute("INSERT INTO users (name, age) VALUES (%s, %s)", (item['name'], item['age']))
    conn.commit()  # 每次插入都触发事务提交与磁盘刷盘
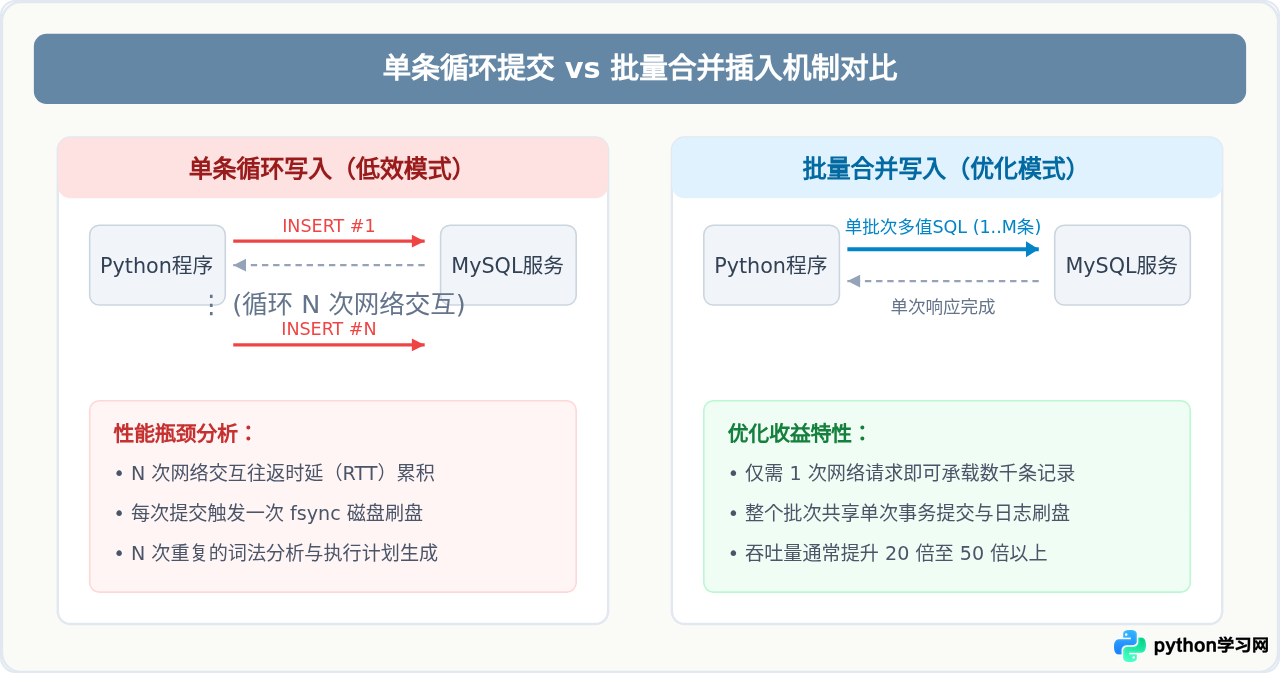
这种写法存在三个致命的性能瓶颈:
- 网络往返时延(RTT)累积:如果插入10,000条记录,客户端与MySQL服务端就要经历10,000次TCP请求与响应往返。即便在内网低时延环境下(假设单次RTT为0.5毫秒),仅网络通信耗时就超过5秒。
- 事务与Redo Log刷盘开销:在默认的
autocommit=True或每次显式commit()模式下,InnoDB存储引擎每写入一条数据都需要将重做日志(Redo Log)强制刷新至磁盘(fsync),机械硬盘或普通云盘根本无法支撑每秒数万次的物理IOPS。 - SQL解析与优化器开销:MySQL服务端需要重复对10,000次SQL文本进行词法分析、语法树构建与权限检验。
二、方法一:使用多值单条SQL与executemany优化
优化批量插入的第一步,是将多个独立的INSERT INTO tbl VALUES (...)合并为单条多值语法:INSERT INTO tbl VALUES (...), (...), (...)。
1. PyMySQL / mysqlclient 中的 executemany 实现
Python中最常用的库是PyMySQL或mysqlclient。在这些库中,游标对象(Cursor)提供了executemany()方法。但需要注意其底层实现差异:
- PyMySQL的executemany():内部会主动将多组参数拼接转换为单条包含多个
VALUES (...), (...)的复合SQL,再通过单个包发送给MySQL执行。 - mysql-connector-python:默认情况下并不自动合并SQL,必须显式在连接参数中设置
rewriteBatchedStatements=True,否则其内部依然是一行一行顺序发送。
import pymysql

# 准备 10,000 条测试元组数据
data = [
    (f"user_{i}", 20 + (i % 30), f"user_{i}@example.com")
    for i in range(10000)
]

conn = pymysql.connect(
    host='127.0.0.1',
    user='root',
    password='password',
    database='test_db',
    charset='utf8mb4',
    autocommit=False  # 务必关闭自动提交
)

try:
    with conn.cursor() as cursor:
        sql = "INSERT INTO users (username, age, email) VALUES (%s, %s, %s)"
        # 批量执行参数化合并
        cursor.executemany(sql, data)
    # 单次显式提交
    conn.commit()
except Exception as e:
    conn.rollback()
    raise e
finally:
conn.close()注意:虽然executemany()能极大提升速度,但如果一次性传入几十万行数据,组装后的SQL字符串体积可能超出MySQL服务端的max_allowed_packet限制,甚至导致Python进程内存暴涨。因此,实际工程中必须结合“分批切块(Chunking)”策略。
三、方法二:显式事务控制与分批切块(Chunking)
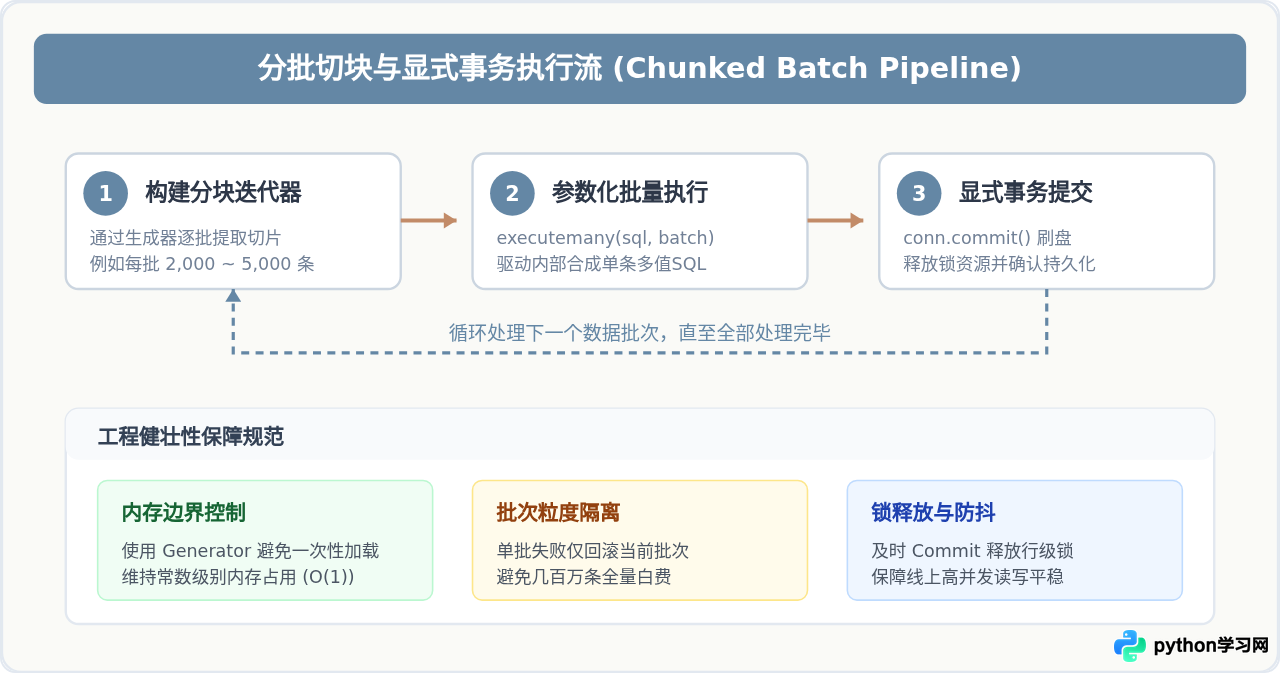
批量插入不是“批次越大越好”。过大的批次会导致以下问题:
- 长事务持有大量行级锁,导致其他业务查询或更新发生锁等待或死锁。
- 如果某一单条记录出现唯一键冲突,整个超大事务回滚代价极高。
- 客户端与MySQL服务端因数据包过大导致内存剧增。
推荐的做法是:采用固定大小的分块迭代器,将大规模数据划分为每批2,000至5,000条记录,每处理完一个批次显式提交一次事务。
2. 生产级分批插入代码实现
def chunk_generator(iterable, batch_size=3000):
    """内存友好的通用数据切块生成器"""
    batch = []
    for item in iterable:
        batch.append(item)
        if len(batch) >= batch_size:
            yield batch
            batch = []
    if batch:
        yield batch

def bulk_insert_chunked(conn, raw_data_iter, batch_size=3000):
    sql = "INSERT INTO users (username, age, email) VALUES (%s, %s, %s)"
    total_inserted = 0

    with conn.cursor() as cursor:
        for batch in chunk_generator(raw_data_iter, batch_size):
            try:
                cursor.executemany(sql, batch)
                conn.commit()  # 每批处理完提交一次事务
                total_inserted += len(batch)
            except Exception as err:
                conn.rollback()  # 出错仅回滚当前失败批次
                print(f"批次写入失败,已回滚: {err}")
                raise err

    return total_inserted
四、方法三:极速之道——LOAD DATA LOCAL INFILE
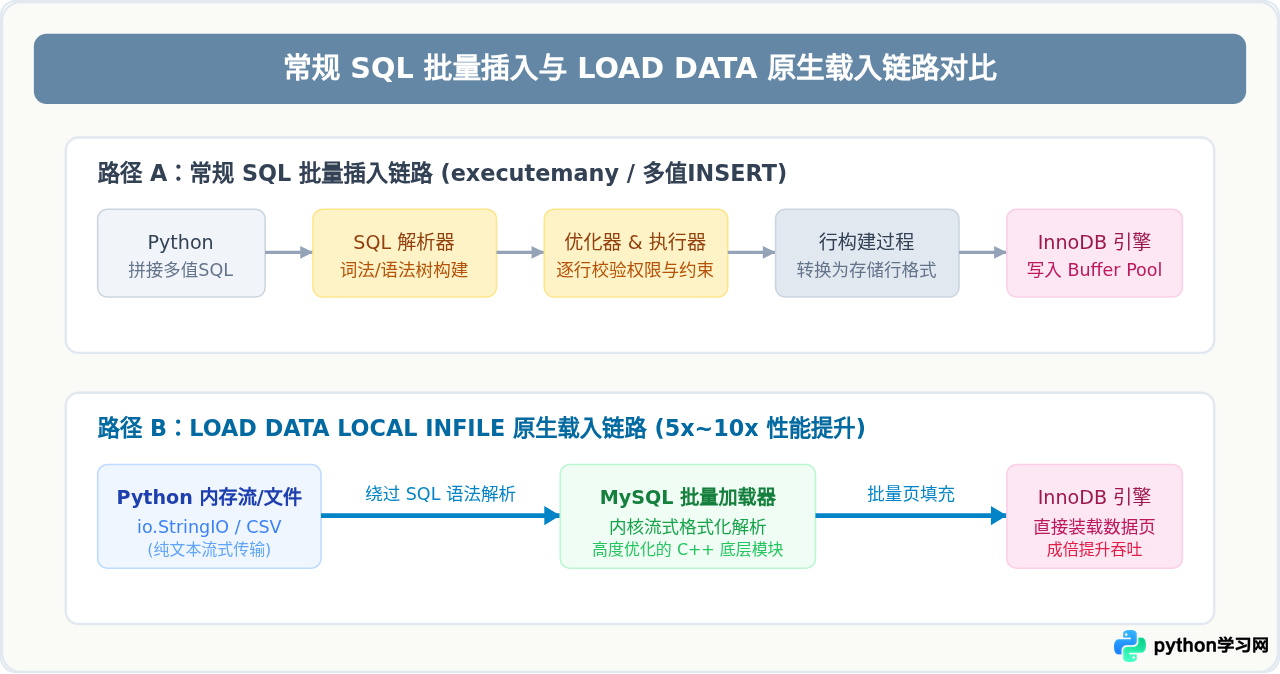
当插入数据量从几万行上升到几百万、甚至几千万行时,即使多值INSERT每批3,000条,执行时间依然受限于SQL解析器与通信协议封包。此时最快的方案是使用MySQL原生的批量加载机制:LOAD DATA LOCAL INFILE。
该机制绕过了常规的SQL词法解析与优化环节,由MySQL引擎直接解析结构化文本(如CSV或TSV格式)并直接映射写入数据页,写入性能通常比executemany还要快5至10倍。
1. 前提环境配置
由于LOAD DATA LOCAL涉及从客户端上传本地文件,出于安全防范,MySQL默认可能未开启本地导入功能:
- MySQL服务端配置:在
my.cnf中确保[mysqld]区域包含local_infile=1。 - Python客户端连接配置:在连接选项中指定
local_infile=True。
2. 结合内存流(StringIO)无需写磁盘文件的Python实现
很多时候数据是在Python内存中动态生成的,如果先落盘写成CSV再加载,会多出一次无谓的磁盘IO。我们可以使用标准库io.StringIO在内存中格式化成TSV格式,直接加载:
import io
import pymysql

# 开启 local_infile 支持
conn = pymysql.connect(
    host='127.0.0.1',
    user='root',
    password='password',
    database='test_db',
    charset='utf8mb4',
    local_infile=True,
    autocommit=False
)

# 模拟 100,000 条内存记录
raw_records = [
    (f"batch_user_{i}", 18 + (i % 50), f"buser_{i}@example.com")
    for i in range(100000)
]

# 在内存中构建制表符分隔(TSV)流
buffer = io.StringIO()
for row in raw_records:
    # 格式化每行以制表符分隔,换行结尾
    buffer.write(f"{row[0]}\t{row[1]}\t{row[2]}\n")

buffer.seek(0)  # 指针复位到开头

try:
    with conn.cursor() as cursor:
        # 使用 StringIO 作为虚拟文件源
        load_sql = """
        LOAD DATA LOCAL INFILE 'virtual_stream.tsv'
        INTO TABLE users
        FIELDS TERMINATED BY '\t'
        LINES TERMINATED BY '\n'
        (username, age, email);
        """
        # PyMySQL 允许将 cursor.connection 的 _client 作为参数或借助内置支持
        # 部分驱动直接支持传递 stream:
        cursor.execute(load_sql)
    conn.commit()
    print("10万条数据写入完成")
except Exception as e:
    conn.rollback()
    raise e
finally:
    buffer.close()
    conn.close()
五、方法四:MySQL服务端参数协同调优
客户端的优化必须有服务端的合理配置相配合,否则硬件性能仍然无法充分发挥。针对大批量插入场景,重点调节以下核心参数:
| 参数名称 | 默认值 / 建议调整值 | 作用机理与优化收益 |
|---|---|---|
innodb_flush_log_at_trx_commit |
默认 1临时调整为 2 或 0 |
为1时每次commit都必须将Redo Log刷盘(fsync)。临时设为2时仅写入OS缓存,每秒集中刷盘一次,可极大消除I/O等待,导入结束后再改回1以确保数据安全。 |
max_allowed_packet |
默认 16M 或 64M建议调整为 128M ~ 256M |
决定单条SQL数据包的最大体积。调大该参数可允许更长、批次更大的多值INSERT SQL传输,避免Packet Too Large错误。 |
innodb_buffer_pool_size |
默认 128M建议调整为物理内存的 60%~75% |
InnoDB数据页与索引缓存池。增大Buffer Pool可确保新插入的B+树叶子节点在内存中合并,大幅减少直接磁盘写入。 |
bulk_insert_buffer_size |
默认 8M可适当增大至 32M ~ 64M |
针对批量插入特定优化树状缓存,加快对二级索引的处理速度。 |
六、批量插入方案选型总结与决策指南
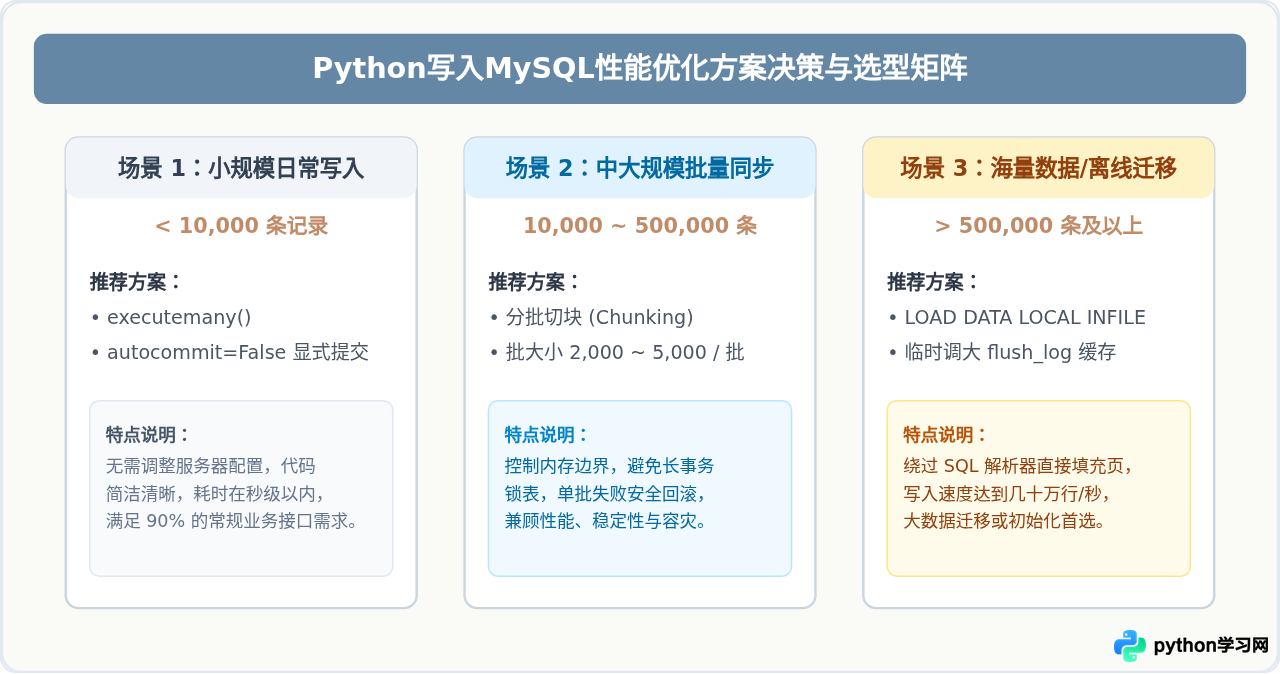
面对不同的业务体量和架构场景,开发者应当遵循梯度递进的优化策略,而不是一律盲目追求最复杂的方案:
七、常见注意事项与避坑指南
- 主键与索引维护开销:如果目标表含有多个二级索引或联合索引,每次批量插入都会触发B+树分裂与重平衡。在全量数据初始化迁移场景下,可先删除二级索引,待全部数据加载完毕后再重新建立索引。
- 主从复制延迟:过大的单次事务(如一次写入50万行)在主库提交后,主从同步会传输巨大的Binlog事件,导致从库重放时发生长时间复制延迟,甚至阻塞从库只读查询。因此生产在线库必须严格限制批大小在数千行以内。
- 唯一键冲突处理:若数据存在重复主键或唯一约束,可使用
INSERT INTO ... ON DUPLICATE KEY UPDATE或INSERT IGNORE,但需注意这两种方式在高并发时对自增主键连续性及锁机制的影响。
通过合理结合“单条多值语句改写”、“生成器分块事务控制”以及“原生LOAD DATA通道”,开发者可以彻底解决Python写入MySQL的性能难题,使海量数据的高效入库变得从容稳定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















