


洛谷Python题目按字典序输出:sorted()配合items()的实现方法
针对洛谷等算法评测平台中常见的按字典序输出需求,详细解析Python中使用sorted()配合dict.items()的实现原理、代码范式、复合多级排序技巧以及常见易错陷阱。
在洛谷等在线算法评测(Online Judge)平台中使用 Python 解题时,字符统计、词频汇总、选手成绩排名等题目通常包含一条硬性格式要求:“输出结果须按字典序排列”。在 Python 中,字典本身并不提供内建的自动按键排序属性,直接遍历输出极易导致判题系统判定为答案错误(Wrong Answer)。解决该问题的最直接且标准的做法,是使用内置函数 sorted() 配合字典的键值对视图 items(),将无序的字典转化为按键排序的元组列表后再行输出。
核心解决路径:利用 d.items() 提取形如 (key, value) 的二元组集合,通过 sorted(d.items(), key=lambda x: x[0])(或直接简写为 sorted(d.items()))对元组首项按字典序排序,随后在循环中解构输出。时间复杂度为稳定高效的 O(N log N)。
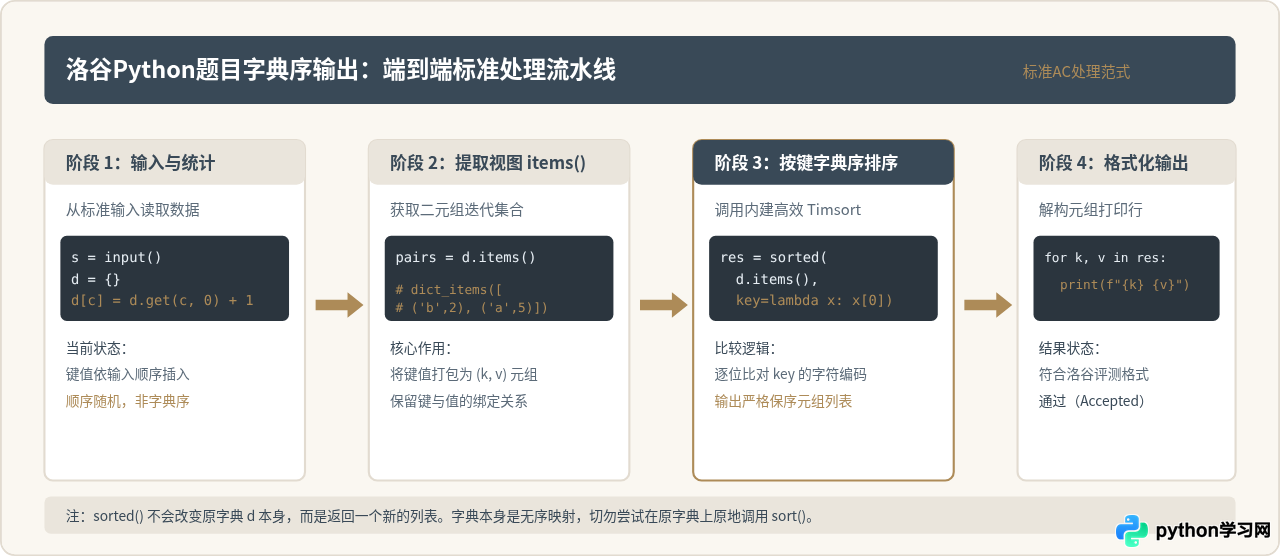
一、问题根源与处理流水线
虽然自 Python 3.7 开始,标准字典类型保证维护元素的插入顺序,但在算法题中,输入数据的到来顺序往往是随机或无序的。例如在一段字符串中统计每个字符的出现频次时,字典中键的顺序完全取决于字符首次出现的时机,并不等同于题目要求的“字母升序(字典序)”。
因此,完整的解题流水线需要经历四个清晰的阶段:首先通过循环或标准库收集数据构建基础字典;其次调用 items() 方法获取可迭代的元组视图;接着使用 sorted() 函数生成排序后的列表;最后通过遍历完成符合洛谷评测机要求的格式化输出。
二、sorted() 配合 items() 的工作机制
很多初学者会疑惑:为什么必须是 sorted(d.items()),而不是 sorted(d)?
在 Python 中,如果直接调用 sorted(d),Python 默认只对字典的键(keys)进行迭代,最终得到的只是一个单纯由键组成的列表,原字典中的对应数值(如频次、分数)全部丢失。若后续再通过 d[k] 逐一查表取值,不仅多出一次哈希查找开销,代码也相对冗长。
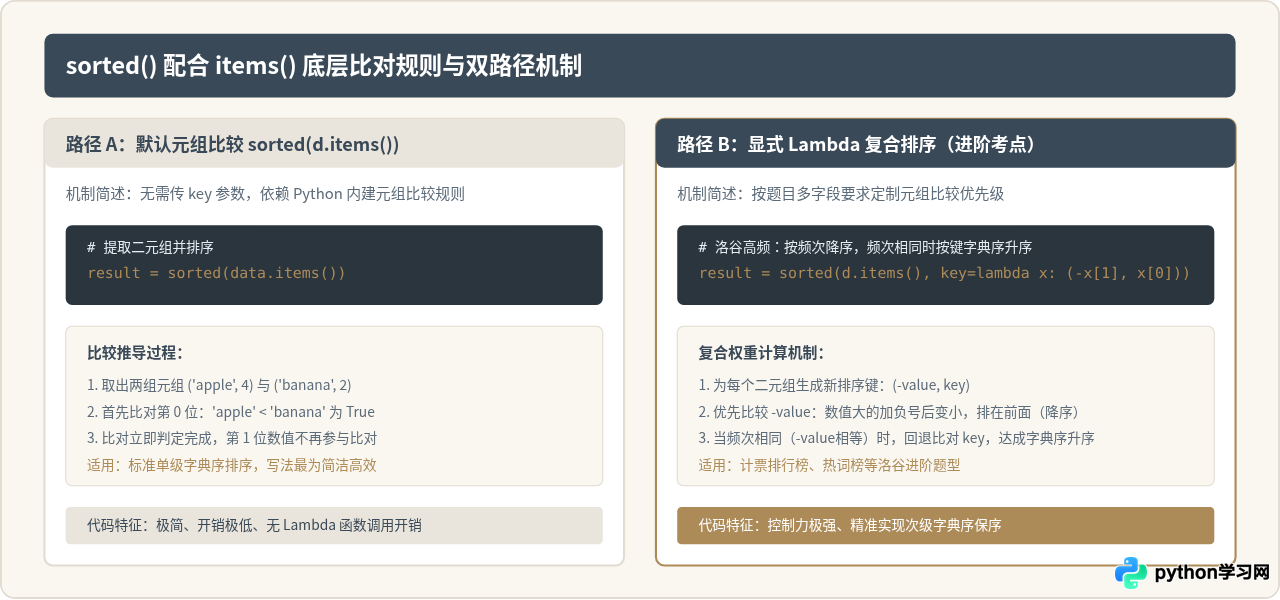
而 d.items() 会返回 dict_items 视图对象,迭代产出形如 (key, value) 的元组。Python 内部对元组的比对有一套严谨的层次规则:
- 默认元组比对机制:当直接对元组列表执行
sorted()时,比较器会首先对比元组的第 0 个元素(即key)。只要键能够区分出大小,即刻决定排序顺序;只有当键完全相同时,才会去比较第 1 个元素(即value)。由于字典中的键本身具有唯一性,第 0 个元素绝无重复可能,因此sorted(d.items())的实际比对行为就等价于纯粹按键进行字典序升序排序。 - 自定义 Key 投影规则:通过传递
key=lambda x: x[0],可以显式指明只提取元组的第 0 项进行比对。这种写法语义更加明确,能够彻底避免在极端场景下因次级元素类型不可比而引发报错。
三、洛谷典型题目的实战实现
场景 1:基础字符/词频字典序输出
题目原型:输入一串由小写英文字母组成的字符串,统计每个字母出现的次数,并按照字母字典序从小到大输出,格式为每个字符及对应频次占一行,中间以空格分隔。
完整 AC 示例代码:
import sys

def solve():
    # 针对洛谷读取可能包含空格或换行的字符串
    raw_input = sys.stdin.read().split()
    if not raw_input:
        return
    text = "".join(raw_input)

    # 构建计数字典
    count_dict = {}
    for char in text:
        count_dict[char] = count_dict.get(char, 0) + 1

    # 核心步骤:通过 sorted() + items() 提取并按键排序
    sorted_pairs = sorted(count_dict.items(), key=lambda x: x[0])

    # 格式化输出
    for char, freq in sorted_pairs:
        print(f"{char} {freq}")

if __name__ == '__main__':
    solve()
代码拆解要点:
count_dict.get(char, 0) + 1避免了先写if char in count_dict的冗余判断,书写简洁。sorted_pairs得到的是一个列表,列表内部每个元素均为(char, freq)二元组。- 解构赋值
for char, freq in sorted_pairs:直接提取键与值,免去了item[0]、item[1]带来的魔法下标。
场景 2:复合排序(频次降序,同频按字典序升序)
题目原型:输入若干学生姓名和投票数,要求按照得票数从多到少排序;若票数相同,则按照学生姓名在英文词典中的先后次序(字典序升序)输出。
完整 AC 示例代码:
import sys

def solve_ranking():
    lines = sys.stdin.read().splitlines()
    if not lines:
        return

    votes = {}
    for line in lines:
        parts = line.strip().split()
        if len(parts) >= 2:
            name, score = parts[0], int(parts[1])
            votes[name] = votes.get(name, 0) + score

    # 核心复合排序技巧:
    # 第一关键字为票数降序(通过 -x[1] 实现取反)
    # 第二关键字为姓名升序(通过 x[0] 实现标准字典序)
    ranked_list = sorted(votes.items(), key=lambda x: (-x[1], x[0]))

    for name, score in ranked_list:
        print(f"{name} {score}")

if __name__ == '__main__':
    solve_ranking()
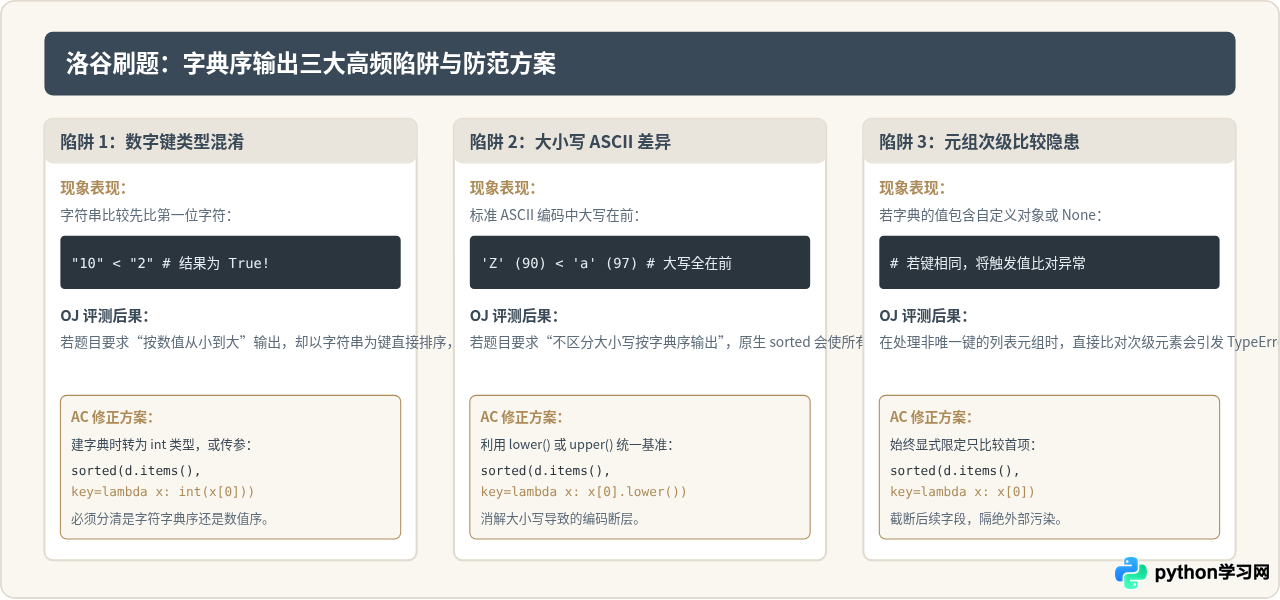
四、洛谷刷题中的三大典型避坑点
在算法评测环境中,单纯记住语法往往不够,洛谷特殊的测试点设计经常包含各类边界陷阱。以下是使用 sorted() 处理字典序时最易踩中的三大陷阱:
五、算法竞赛中的 I/O 与执行效率优化
在洛谷的部分高分题目(如海量数据字符串统计)中,Python 的执行耗时相对敏感。如果测试点数据量达到 10^5 或 10^6 级别,单纯依赖默认的 input() 和逐行 print() 很容易触发 Time Limit Exceeded (TLE)。针对字典序输出场景,建议掌握以下两项性能优化:
1. 快速读取与统计
使用 sys.stdin.read().split() 一次性将全部输入载入内存,比频繁调用 input() 快 5 到 10 倍。此外,结合标准库 collections.Counter 可以用 C 语言底层极速完成频次统计:
from collections import Counter
import sys

# 一次性读入全量字符
data = sys.stdin.read().split()
counter = Counter(data)

# 直接排序输出
res = sorted(counter.items(), key=lambda x: x[0])
2. 批量格式化输出
不要在 for 循环中频繁调用 print()。每次 print() 都会触发标准输出缓冲区的刷新(I/O 系统调用)。最优做法是构造好字符串列表后,使用 sys.stdout.write('\n'.join(...)) 单次倾倒输出:
import sys

# 构造输出缓冲
output_lines = [f"{k} {v}" for k, v in res]
sys.stdout.write("\n".join(output_lines) + "\n")
六、全景速查与解题总结卡片
掌握 sorted() 配合 items() 是打通 Python 基础题库与数据统计类题目的关键环节。为了方便记忆与临场复习,下表归纳了不同业务需求下的核心代码模版:
| 排序需求 | 核心代码写法 | 适用洛谷典型题型 |
|---|---|---|
| 按键字典序升序(标准) | sorted(d.items(), key=lambda x: x[0]) |
字符频次统计、电话簿字典序输出 |
| 按键字典序降序 | sorted(d.items(), key=lambda x: x[0], reverse=True) |
倒序检索、逆序词表 |
| 忽略大小写按键字典序 | sorted(d.items(), key=lambda x: x[0].lower()) |
英文文章不区分大小写词频表 |
| 按值降序,值相同按键字典序升序 | sorted(d.items(), key=lambda x: (-x[1], x[0])) |
得票选举榜、最高分选手排行榜 |
| 数字字符串按真实大小排序 | sorted(d.items(), key=lambda x: int(x[0])) |
编号统计、学号计数题 |
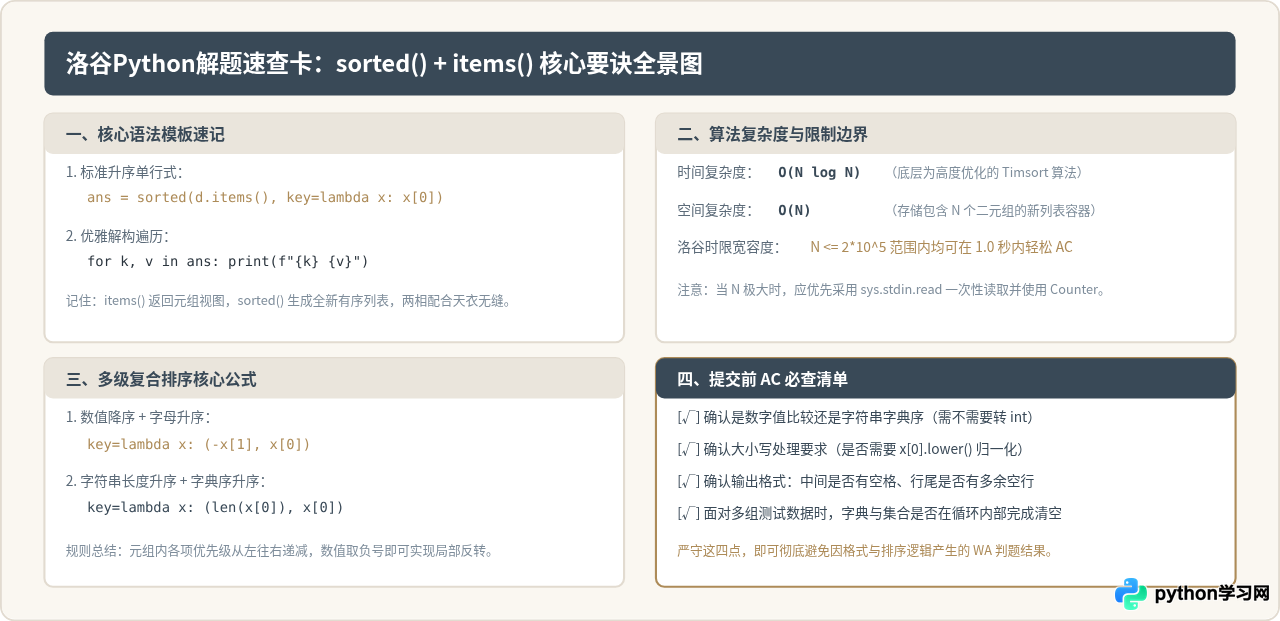
综上所述,在面对洛谷各类统计题目的字典序输出要求时,牢记 sorted(d.items(), key=lambda x: x[0]) 的解构范式,配合对测试点数据类型的敏锐识别(区分数值序与字符序),便能以最优雅、规范的 Python 语法稳稳拿下 Accepted。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















