


Python读取CSV文件中文乱码怎么解决?
针对Python读取CSV文件时常见的中文乱码与UnicodeDecodeError报错,详细解析乱码成因,并提供内置csv模块与pandas库的正确编码配置、自动识别与修复方案。
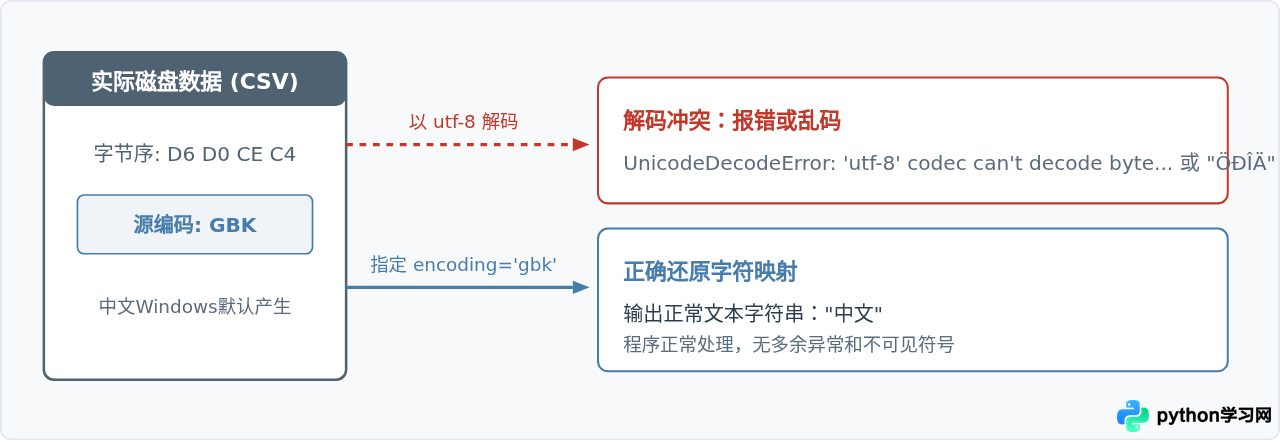
在Python中读取CSV文件遇到中文乱码或UnicodeDecodeError,核心原因只有一个:代码在读取文件时指定的字符编码,与该文件在硬盘中实际保存的编码格式不一致。解决这个问题的核心路径,是查明源文件的真实编码格式,并在open()函数或pandas.read_csv()方法中显式传入对应的encoding参数;针对Excel生成的特殊UTF-8文件,则使用utf-8-sig清除BOM标头。
中文乱码产生的底层机制
计算机存储文本文件时,本质上是将字符转换为特定规则的二进制字节(编码),读取时再按照规则转回字符(解码)。CSV作为无格式的纯文本表格,本身并不携带全局标准的元数据来声明自己的编码类型。
在中文操作系统下,常见冲突主要来自三种场景:一是Windows环境下Excel导出的CSV默认采用系统代码页(通常是GBK或GB18030),而Python 3在多数现代开发环境中默认使用utf-8解码,遇到超出UTF-8编码规则的双字节中文字符时就会报错中断;二是带签名保存的UTF-8文件在开头多出3个不可见字节(BOM),导致首列列名读取多出\ufeff字符;三是代码中缺失明确编码,在不同操作系统迁移时行为不一致。
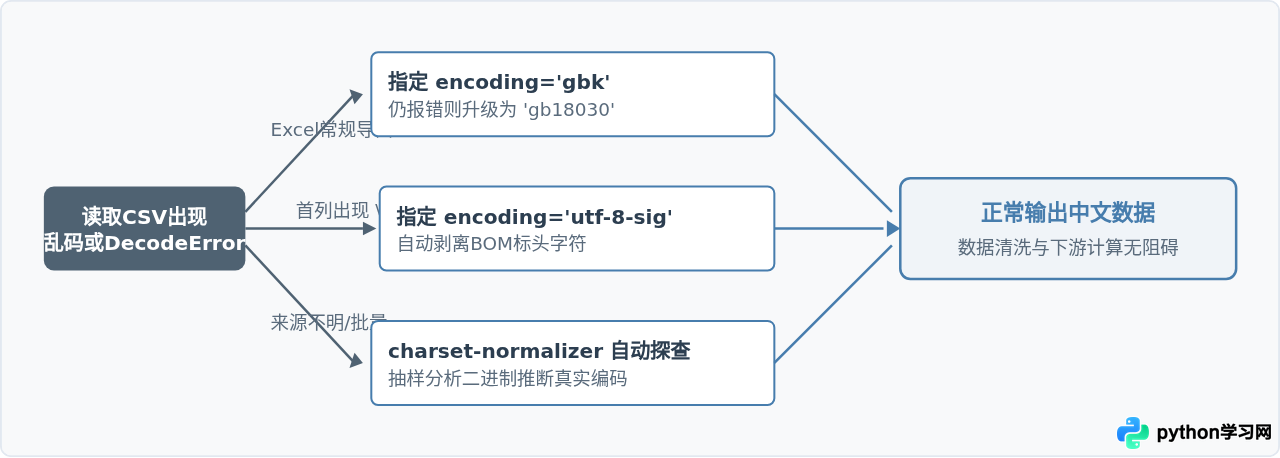
四步排查与解决流程
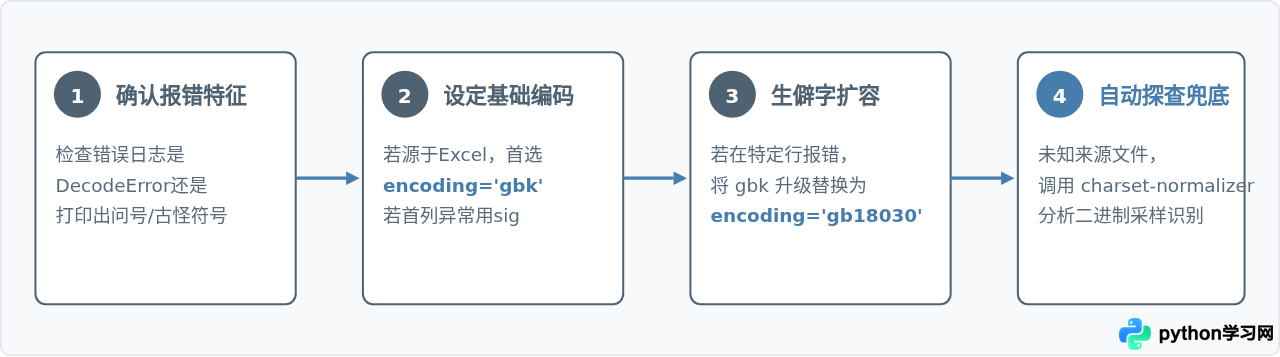
遇到报错时无需盲目尝试各种编码字符串。按照自底向上的顺序,先做基础排查,再根据来源做针对性配置,可以覆盖绝大多数读取场景。
标准库与Pandas代码实现
1. 使用Python内置csv模块
内置open()函数如果不显式指定编码,会根据不同平台采用locale.getpreferredencoding(False)。跨环境运行时,必须强制声明encoding参数。
import csv

file_path = "sales_data.csv"

# 推荐写法:明确指定 encoding='gbk' 或 'utf-8',同时 newline='' 防止换行符被二次转义
try:
    with open(file_path, mode="r", encoding="gbk", newline="") as f:
        reader = csv.reader(f)
        for row in reader:
            print(row)
except UnicodeDecodeError:
    # 若 gbk 报解码错误,尝试更完整的国标汉字库 gb18030
    with open(file_path, mode="r", encoding="gb18030", newline="") as f:
        reader = csv.reader(f)
        for row in reader:
            print(row)
2. 使用Pandas读取
pandas.read_csv()同样支持encoding参数。如果读取Excel导出的UTF-8文件,建议使用utf-8-sig,它会自动剥离文件开头的UTF-8签名,避免第一列列名出现类似['\ufeff姓名', '年龄']的情况。
import pandas as pd

file_path = "user_info.csv"

# 方案 A:针对常规 Windows Excel 导出的 CSV 文件
df = pd.read_csv(file_path, encoding="gbk")

# 方案 B:针对带 BOM 的 UTF-8 文件(可消除列名 \ufeff 前缀)
df_utf8 = pd.read_csv(file_path, encoding="utf-8-sig")

# 验证读取结果
print("列名列表:", df.columns.tolist())
print(df.head(3))
代码执行后的正常示例输出:
列名列表: ['用户ID', '姓名', '城市']
   用户ID  姓名  城市
0  1001  张伟  北京
1  1002  王芳  上海
2  1003  李强  广州
未知文件编码的自动识别
如果手头有大量来源不一的外部CSV文件,逐个尝试编码并不现实。可以使用Python标准生态中的charset-normalizer(或chardet)在读取前对文件开头的二进制字节进行采样检测。
from charset_normalizer import from_path
import pandas as pd

file_path = "external_unknown.csv"

# 自动推断文件编码
results = from_path(file_path)
best_match = results.best()

if best_match:
    detected_encoding = best_match.encoding
    print(f"检测到文件真实编码为: {detected_encoding}")

    # 将检测结果传给 pandas 读取
    df = pd.read_csv(file_path, encoding=detected_encoding)
    print(df.head(2))
else:
    print("无法明确推断编码,尝试使用 gb18030 兜底读取")
    df = pd.read_csv(file_path, encoding="gb18030")
常见中文编码对照与容错机制
处理中文数据时,常见的三种中文编码具有层级包含关系。了解它们的容量差异,有助于在报错时准确升级参数,而不是盲目猜测。
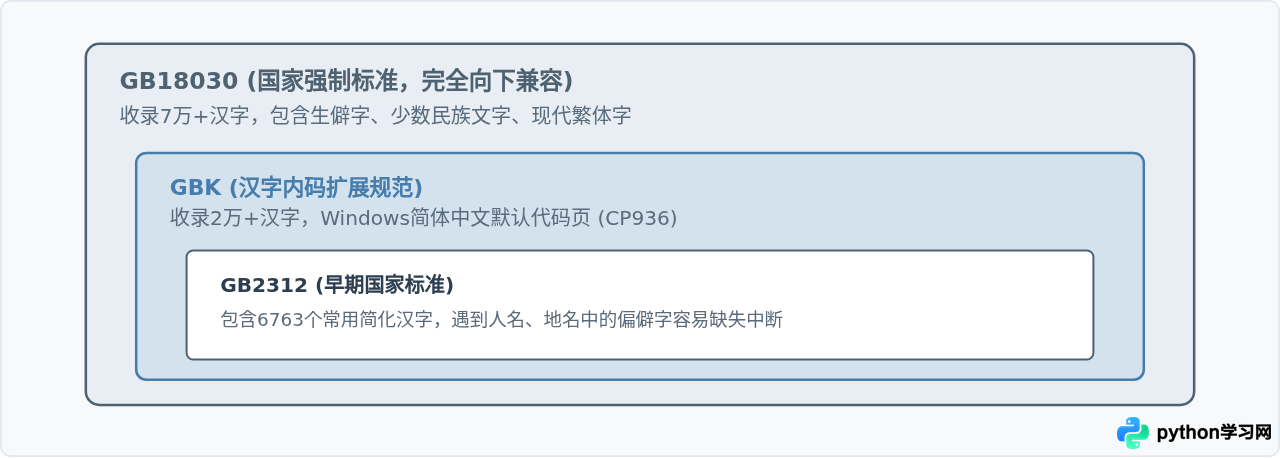
当一个CSV文件包含了大部分常见字,但偶然出现特殊生僻字(例如人名“燚”、地名或特殊标点)时,使用encoding='gbk'会在读取到具体生僻字的那一行突发UnicodeDecodeError。此时直接将参数换成encoding='gb18030'即可完整读取。
如果遇到极少数混杂了损坏字节的历史数据,且业务场景允许丢弃个别不可解析字符以保全整个流程,可以在open()中设置errors='ignore'或errors='replace'进行容错保护:
# 容错处理:忽略无法解析的字节,避免程序崩溃中断
with open("corrupted_data.csv", mode="r", encoding="gb18030", errors="ignore") as f:
    reader = csv.reader(f)
    for row in reader:
        # 处理正常解析出来的数据
pass注意:errors='ignore'会直接丢弃解析失败的字节,导致字符丢失;仅建议在排查脏数据时作为临时过渡方案,正式数据清洗应优先保证源编码配置正确。
排错决策总结
在日常开发与数据处理中,可参考以下决策路径快速定位与消除乱码:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















