


Python数据分析新手避坑:为什么数据清洗比建模更值得先学

针对Python数据分析新手,详细解析为什么数据清洗比算法建模更值得优先掌握。包含真实业务场景对照、完整Pandas代码实操、四步清洗工作流及技能学习路径。
初学 Python 数据分析时,很多人容易直奔机器学习算法或高阶统计模型,以为几行 model.fit() 就能输出商业洞察。实际上,决定分析结果可信度与工程落地成败的瓶颈通常在数据清洗环节。本文将通过真实的业务场景对比、可复现的 Pandas 代码实操以及四个标准清洗步骤,清晰拆解为什么新手应当先扎实学好数据清洗。
一、核心认知:脏数据如何让高精模型彻底失真
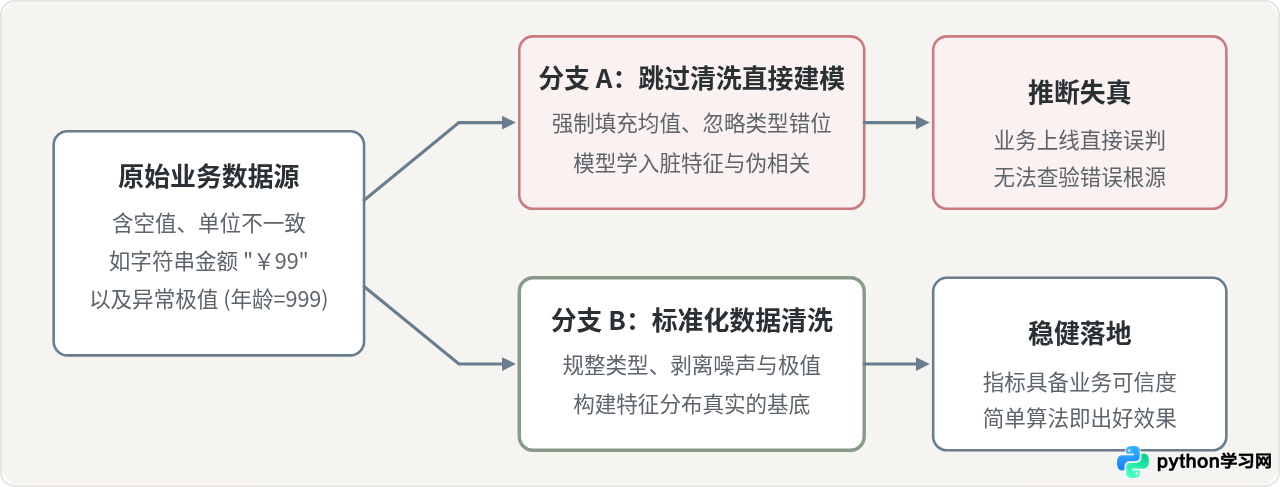
机器学习和统计学模型本质上是数学映射。模型自身缺乏对真实物理世界逻辑的常识判断,只会严格根据输入数据的统计特征推导参数。行业中常说的“垃圾进,垃圾出(Garbage In, Garbage Out)”正是对这一现象的精炼总结。
为了理解两者的因果机制,我们可以看下面的因果链条:未经治理的原始数据会通过隐蔽的异常值、格式偏差或缺失逻辑,直接污染模型的目标函数,导致训练出的模型在纸面指标上表现优异,但在实际推断中全盘崩溃。
二、场景对照:两套处理策略带来的实际差异
为了具体展现处理质量的影响,我们可以设定一个一致的业务测试条件:分析某零售平台的“用户平均消费水平”与“高客单人群留存率”。数据集包含 10,000 条消费明细,其中包含格式混杂的金额、偶发的负数(退款未打标)以及极端离群值。
| 考察维度 | 做法一:先学算法,速成建模 | 做法二:先学清洗,把控质量 |
|---|---|---|
| 数据准备阶段 | 遇到类型报错直接 errors='coerce' 转为 NaN,再用整列均值粗暴填充缺失值。 |
先做类型转换与正则提炼,区分真实零值、退单和系统缺失,按业务归类处理。 |
| 对异常值的反应 | 直接将包含测试账号(如单笔刷单 99 万元)的数据喂给回归模型或神经网络。 | 使用箱线图或 IQR(四分位距)识别极端离群点,排查原因后建立过滤规则。 |
| 最终分析结论 | 平均消费金额被虚高拉升 400%,高客单留存模型在验证集上泛化能力崩塌。 | 消费数据准确呈现右偏长尾分布,留存分析结论能够直接用于制定营销预算。 |
| 后续排错成本 | 误以为算法参数未调优,花费数天调整超参数,无法定位根本原因。 | 数据链条每步可追溯,若指标有异动,10 分钟内即可核查定位到源头字段。 |
这种差异之所以至关重要,是因为工业界很少存在 Kaggle 比赛中那样整洁标准、只需 X_train, y_train 切分的数据表。如果对输入数据的几何分布、离散程度与业务约束毫无把握,越复杂的模型反而越容易固化数据中的噪音。
三、代码对比:脏数据击穿建模流程的典型例子
我们在 Python 3.10 环境下使用 Pandas 构造一段包含典型问题的数据,观察两种处理路线在执行过程中的具体表现。
1. 模拟业务脏数据
import pandas as pd
import numpy as np

# 模拟电商客户行为样本
raw_data = {
    'user_id': [1001, 1002, 1003, 1004, 1005],
    'age': [24, np.nan, 29, 999, 31],                     # 存在缺失与业务不可能的异常值 999
    'order_amount': ['¥128.5', '¥89.0', '未知', '¥320.0', '¥-15.0'], # 货币符号、文本干扰及异常负数
    'signup_date': ['2026-01-10', '2026/02/15', '2026.03.01', '2026-03-05', '2026-03-12'] # 日期格式混杂
}
df = pd.DataFrame(raw_data)
print(df.dtypes)age float64
order_amount object
signup_date object
dtype: object
2. 错误做法:直接调用数值分析与拟合
初学者如果试图直接计算 order_amount 的均值或者放入回归模型中,程序会直接抛出类型错误异常:
# 尝试直接聚合求均值
try:
    mean_val = df['order_amount'].mean()
except TypeError as err:
print(f"执行中断:{err}")3. 正确做法:执行严谨的数据清洗流程
面对这一列数据,我们需要按顺序完成字符清洗、缺失标记、异常过滤和类型收敛:
clean_df = df.copy()

# 步骤 1:清洗金额字段,剥离特殊符号并安全转化为浮点数
clean_df['order_amount'] = (
    clean_df['order_amount']
    .astype(str)
    .str.replace('¥', '', regex=False)
)
# 将无法转化的文本转换为 NaN,再转化为标准数值型
clean_df['order_amount'] = pd.to_numeric(clean_df['order_amount'], errors='coerce')

# 步骤 2:校验业务逻辑,排除负向退款单与异常高龄记录
clean_df = clean_df[
    (clean_df['order_amount'] > 0) &
    ((clean_df['age'] > 0) & (clean_df['age'] < 120) | clean_df['age'].isna())
]

# 步骤 3:统一定义时间格式,便于后续时序特征构造
clean_df['signup_date'] = pd.to_datetime(
    clean_df['signup_date'].astype(str).str.replace(r'[./]', '-', regex=True)
)

print(clean_df)0 1001 24.0 128.5 2026-01-10
1 1002 NaN 89.0 2026-02-15
3 1004 NaN 320.0 2026-03-05
四、实操指引:数据清洗的四步闭环操作
掌握数据清洗不需要一开始就背诵所有 Pandas API,建立规范的排查闭环能够解决日常工作中 80% 以上的数据质量问题。标准的清洗流水线包含结构探测、格式统一、缺失与异常治理、一致性检验四个明确阶段。
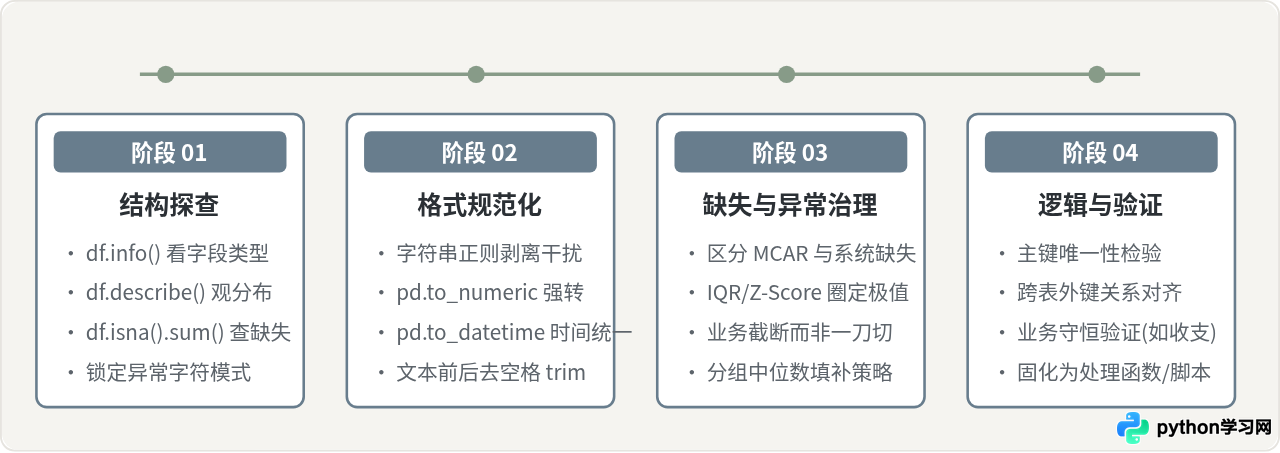
在实际操作中,新手最常犯的错误是在没有调用 df.info() 的情况下直接上手写处理代码。先通过探查明确每一列的存储类型和真实含义,再写转换逻辑,可以节省大量调试时间。
五、时间分配与技能迁移:为什么清洗是长效投资
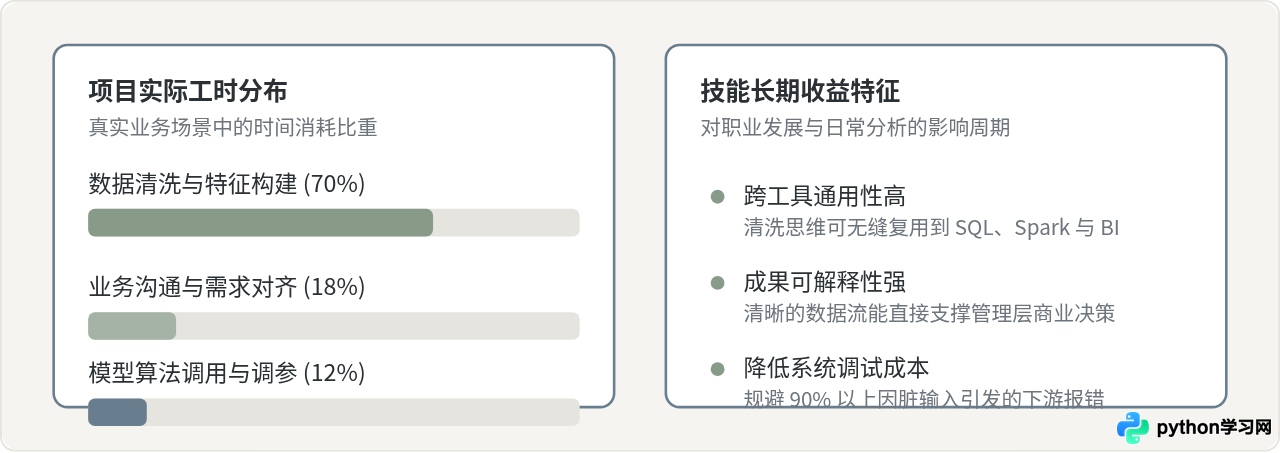
在实际工作中,算法框架的封装度已经非常高。无论是 Scikit-Learn、XGBoost 还是 LightGBM,调用算法本身的语法通常不超过十行代码。与之相对的是,不同业务在不同发展阶段所采集的数据格式千差万别,数据清洗需要根据行业特性具体分析。
清洗数据不仅是在“修补错误”,更是深度理解业务上下文的过程。例如,当你去追查为什么某个月份的客单价突然变成负数时,你才会真正了解到平台存在“退换货跨月冲账”的财务规则。如果跳过清洗直接建模,这些隐藏的业务特性不仅无法体现在特征中,反而会被误当作离群点剔除。
六、给新手的推荐学习路径
为了避免在琐碎的语法和复杂的数学推导中迷失方向,建议新手按照以下四个阶段循序渐进地构建知识体系。
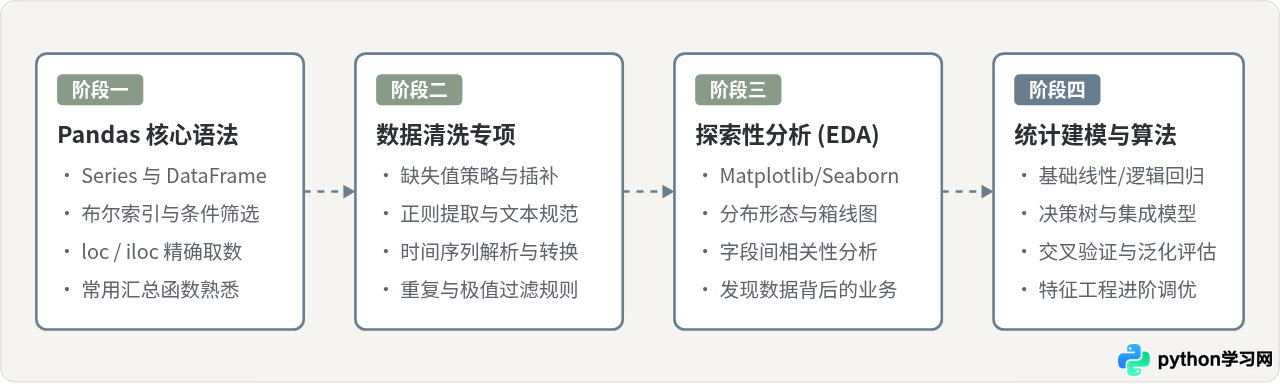
学习技术的关键是尊重分析流程中的客观规律。当你可以熟练地使用 Pandas 将一张凌乱、包含各种异常和格式冲突的原始业务表格,清晰规范地转化为结构工整的数据集时,再引入任何建模工具,输出的结果才会具备实打实的参考价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















