


Python子类继承时怎么用super()调用父类构造函数
详解在Python面向对象编程中,子类继承时如何使用super()正确调用父类__init__构造函数,包含单继承与多继承传参、执行顺序、原理及常见避坑要点。
在 Python 中,子类一旦重写了 __init__ 构造函数,父类的初始化逻辑默认不会自动运行。若要复用父类的属性赋值和状态准备逻辑,标准且稳妥的方法是在子类的 __init__ 内使用 super().__init__(参数) 进行委托调用。本文将直接拆解单继承与多继承场景下的标准调用语法、参数传递规则、执行时机以及避免踩坑的实用细节。
一、单继承基础:为什么以及如何调用 super()
面向对象继承的核心价值之一在于复用逻辑。当子类继承父类并定义了自己的 __init__ 方法时,就发生了方法覆盖(Override)。此时,如果不在子类方法中主动触发父类的构造流程,父类所负责的实例属性初始化就会被完全跳过,导致调用相关属性时抛出 AttributeError。
在 Python 3 中,调用父类构造函数的标准规范语法非常简洁,只需写成 super().__init__(...)。
class Person:
    def __init__(self, name, age):
        self.name = name
        self.age = age

class Student(Person):
    def __init__(self, name, age, student_id):
        # 1. 委托父类初始化公共属性
        super().__init__(name, age)
        # 2. 初始化子类特有属性
        self.student_id = student_id

# 验证实例化过程
s = Student("李雷", 16, "S202401")
print(f"姓名: {s.name}, 年龄: {s.age}, 学号: {s.student_id}")
# 输出结果:
# 姓名: 李雷, 年龄: 16, 学号: S202401
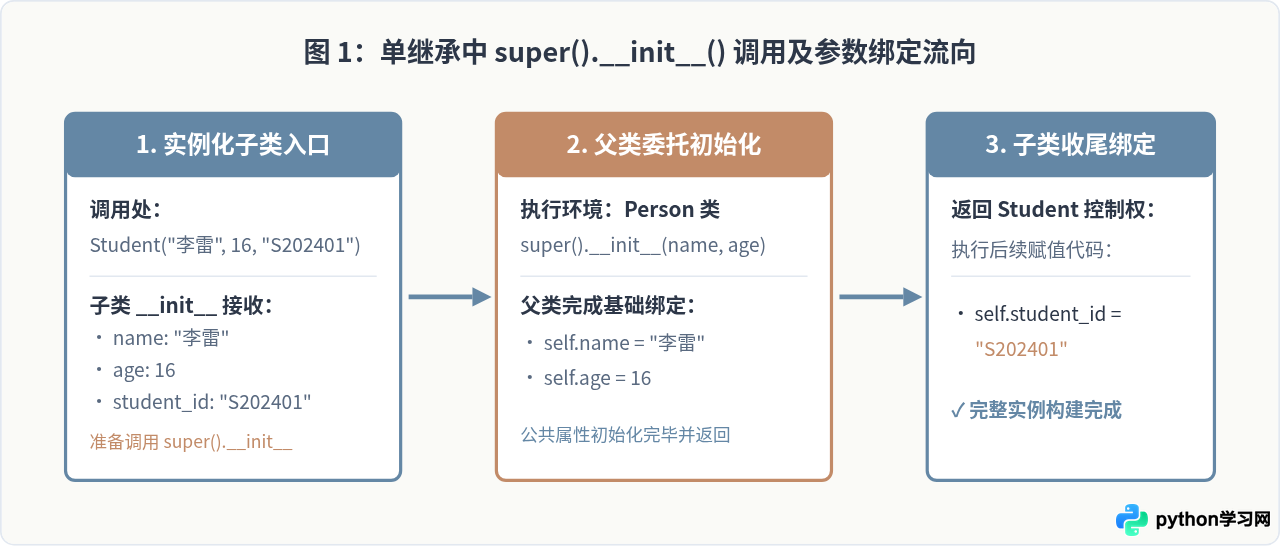
在上述代码中,Student 接收三个参数,其中 name 和 age 是父类 Person 初始化的基础数据。通过 super().__init__(name, age),子类无需再重复编写 self.name = name 这类代码,保证了初始化逻辑的单一事实来源。
二、编写子类构造函数的 4 个规范步骤
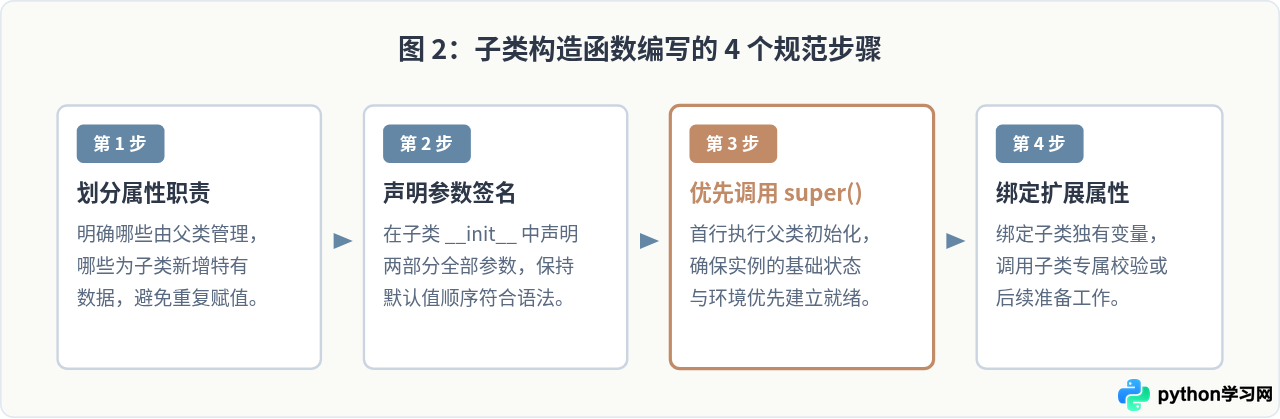
为了保证代码的健壮性与可读性,编写包含继承关系的构造函数时,建议遵循标准化的 4 步流程:
1. 参数灵活转发:使用 **kwargs 增强拓展性
当父类的初始化参数较多,或者父类未来可能会增删参数时,可以使用关键字不定长参数 **kwargs 降低子类与父类之间的耦合度:
class DatabaseConnector:
    def __init__(self, host="localhost", port=3306, timeout=10):
        self.host = host
        self.port = port
        self.timeout = timeout

class LoggingDatabaseConnector(DatabaseConnector):
    def __init__(self, log_level="INFO", **kwargs):
        # 将与父类相关的连接参数通过 kwargs 批量透传
        super().__init__(**kwargs)
        # 子类只处理自身特有的日志等级
        self.log_level = log_level

# 实例化示例
db = LoggingDatabaseConnector(host="192.168.1.100", port=5432, log_level="DEBUG")
print(f"Host: {db.host}, Port: {db.port}, LogLevel: {db.log_level}")
# 输出:Host: 192.168.1.100, Port: 5432, LogLevel: DEBUG
三、核心机制:super() 与 MRO 方法解析顺序
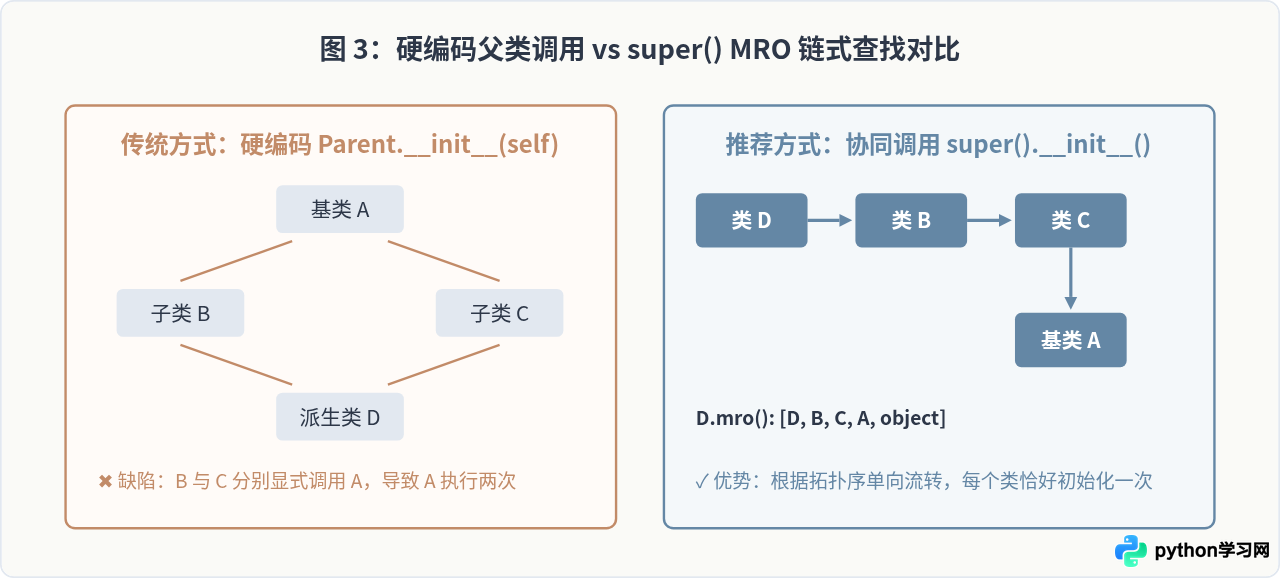
很多开发者容易把 super() 简单理解为“直接指向父类”,但这种理解在多继承(Multiple Inheritance)场景下是不准确的。在 Python 内部,super() 返回的是一个代理对象,它根据当前对象所属类的 MRO(Method Resolution Order,方法解析顺序) 列表,线性查找到当前类的“下一个兄弟类或基类”。
这也是为什么在处理菱形继承(Diamond Inheritance)时,必须使用 super() 而不能用硬编码类名 Parent.__init__(self) 的核心原因。
下面是一个典型的菱形多继承代码验证:
class A:
    def __init__(self):
        print("初始化 A")

class B(A):
    def __init__(self):
        super().__init__()
        print("初始化 B")

class C(A):
    def __init__(self):
        super().__init__()
        print("初始化 C")

class D(B, C):
    def __init__(self):
        super().__init__()
        print("初始化 D")

d = D()
# 运行输出:
# 初始化 A
# 初始化 C
# 初始化 B
# 初始化 D
可以看到,尽管 B 和 C 均继承自 A,但整个链条中 A 只被初始化了一次。B 中的 super().__init__() 调用的并不是 A,而是按照 D.mro() 的顺序调用了 C,实现了协同多继承。
四、常见错误与避坑指南
在实际使用 super().__init__() 时,容易因为习惯残留或概念模糊出现以下几个典型错误:
1. 错误地在 super().__init__() 中传递 self
TypeError: __init__() takes 2 positional arguments but 3 were given
在旧式代码直接调用类名(如 Person.__init__(self, name))时,需要显式传递实例 self。但 super() 返回的代理对象已经隐式绑定了当前实例,因此绝对不能再向 super().__init__() 传入 self。
# 错误示例:
super().__init__(self, name, age)  # TypeError! 多传了一个 self

# 正确示例:
super().__init__(name, age)        # 正确,Python 会自动绑定 self
2. Python 2 与 Python 3 的写法混淆
在 Python 2 中,super 必须显式传入类名和实例,即 super(Student, self).__init__(name, age)。在 Python 3 中,编译器在编译方法时会自动注入隐藏的 __class__ 闭包变量,因此直接使用无参的 super().__init__(...) 即可。保留 Python 2 风格并不报错,但繁琐且在类重命名时容易引发错误。
3. super() 的调用顺序问题
通常情况下,应该把 super().__init__(...) 放在子类构造函数的第一行。因为子类的很多特有逻辑可能依赖父类已经建立的基础属性或连接。只有在极特殊的“需要在父类初始化前预先设置某些参数或拦截环境变量”的场景下,才考虑将 super() 后置。
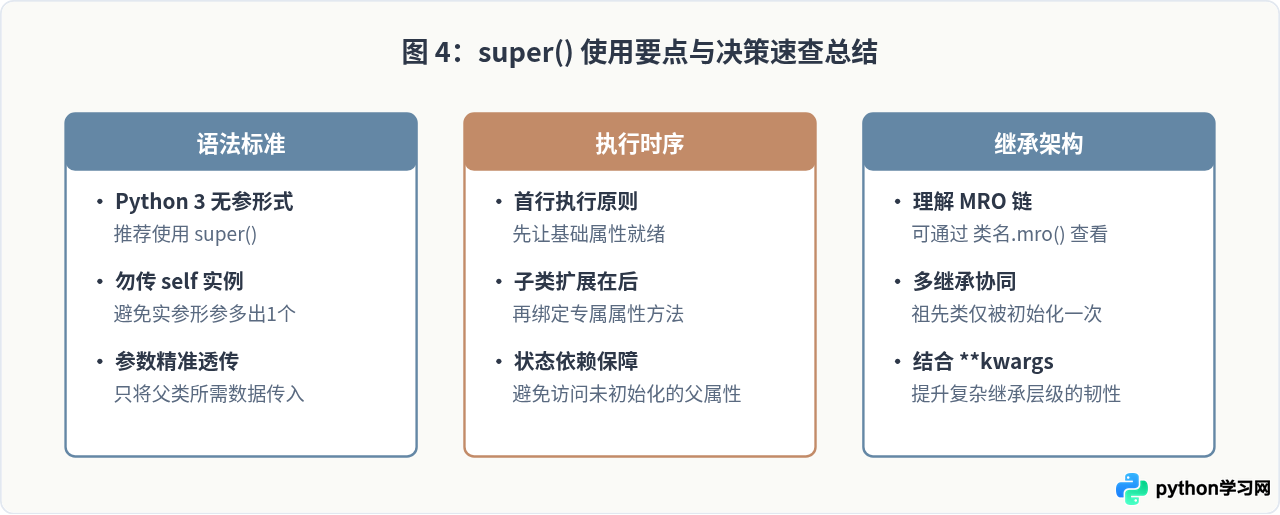
五、核心规则速查与总结
下表概括了在 Python 中调用父类构造函数的关键规则:
| 场景 / 维度 | 推荐做法 | 常见反模式 |
|---|---|---|
| 单继承语法 | super().__init__(参数) |
Parent.__init__(self, 参数) 或传入 self |
| 调用时机 | 优先放在子类 __init__ 首行 |
子类属性全部处理完甚至使用父类属性后再调用 |
| 参数转发 | 明确关键参数,扩展项可用 **kwargs |
硬编码遗漏父类必需参数,导致 TypeError |
| 多继承协同 | 链条中所有类统一使用 super() |
混用 Parent.__init__(self) 导致祖先类被多次执行 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















