


为什么科学计算首选NumPy数组而不是Python列表?
深入对比NumPy数组与Python列表在底层架构与运行效率上的差异,全面解析连续内存、SIMD向量化加速、动态开销消除与科学计算技术选型依据。
ndarray是几乎所有数值计算库的核心基石。科学计算之所以首选NumPy数组而非Python原生列表,根本原因在于连续紧凑的内存存储、纯C原生类型避免对象开销、硬件级SIMD向量化执行以及高效的广播机制。相比之下,Python列表是存放任意对象指针的离散数组,在大规模数值运算中存在严重的内存膨胀、缓存命中率低和解释器动态解包延迟。
一、底层存储差异:连续物理内存对比离散指针数组
数据在物理内存中的存放形态,从根本上决定了计算吞吐量的上限。Python列表(list)与NumPy数组(ndarray)在设计初衷上的分野,导致了截然不同的内存拓扑结构。
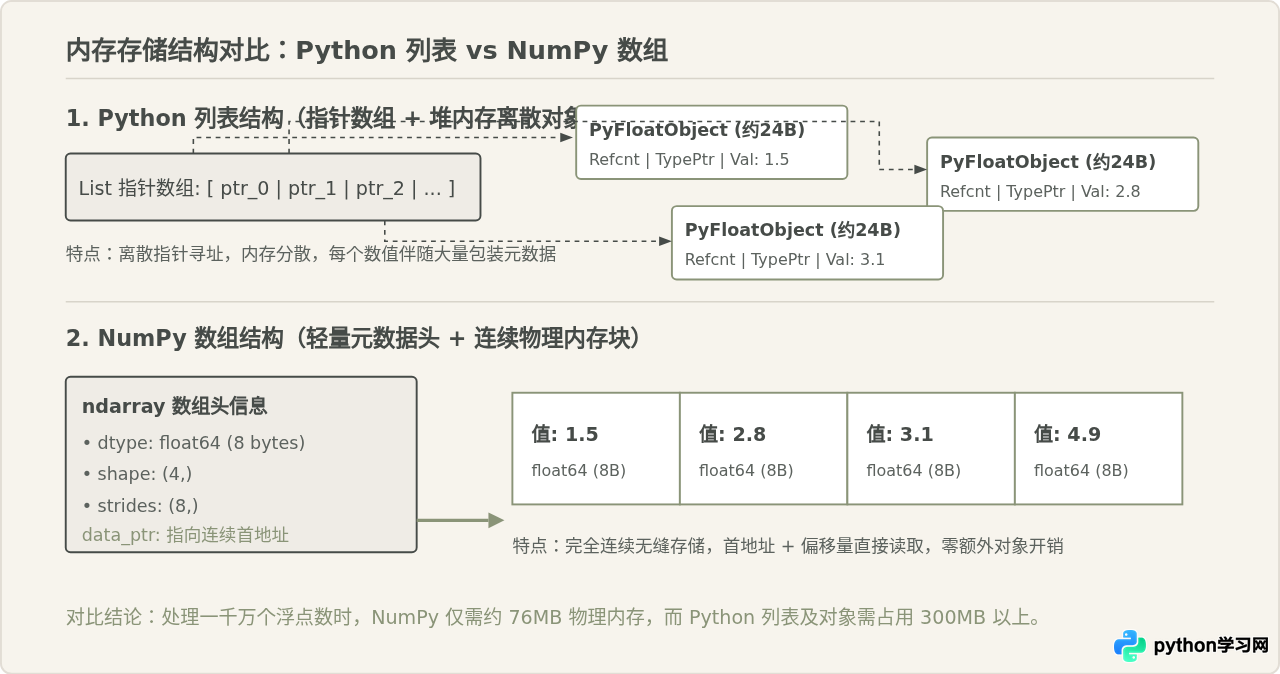
Python列表被设计为一个高度通用的异构容器。为了支持在同一个列表中同时容纳整数、字符串乃至自定义对象,Python列表实际存储的是一个连续的指针数组,每个指针指向堆内存中独立分配的PyObject。以标准的64位浮点数为例,在原生Python中,一个浮点数并非单纯的8字节数据,而是一个包含对象引用计数(8字节)、类型指针(8字节)以及实际浮点数值(8字节)的完整对象,至少占用24至32字节。更关键的是,这些具体的数值对象被分散分配在堆的不同区域,在内存地址上往往不连续。
与此相对,NumPy数组要求元素类型同质(Homogeneous)。这种约束换取了极致的紧凑性:NumPy数组在内存中分配一块完全连续的缓冲区,每个float64元素精确占用8字节,没有额外的对象头信息。数组对象本身只包含一个轻量级的描述头(包含维度shape、数据步长strides、数据类型dtype及指向数据缓冲区的指针)。
二、执行效率差异:解释器循环与硬件向量化
当执行简单的数组求和或元素级乘法时,两者在CPU层面的运行轨迹存在本质差异。
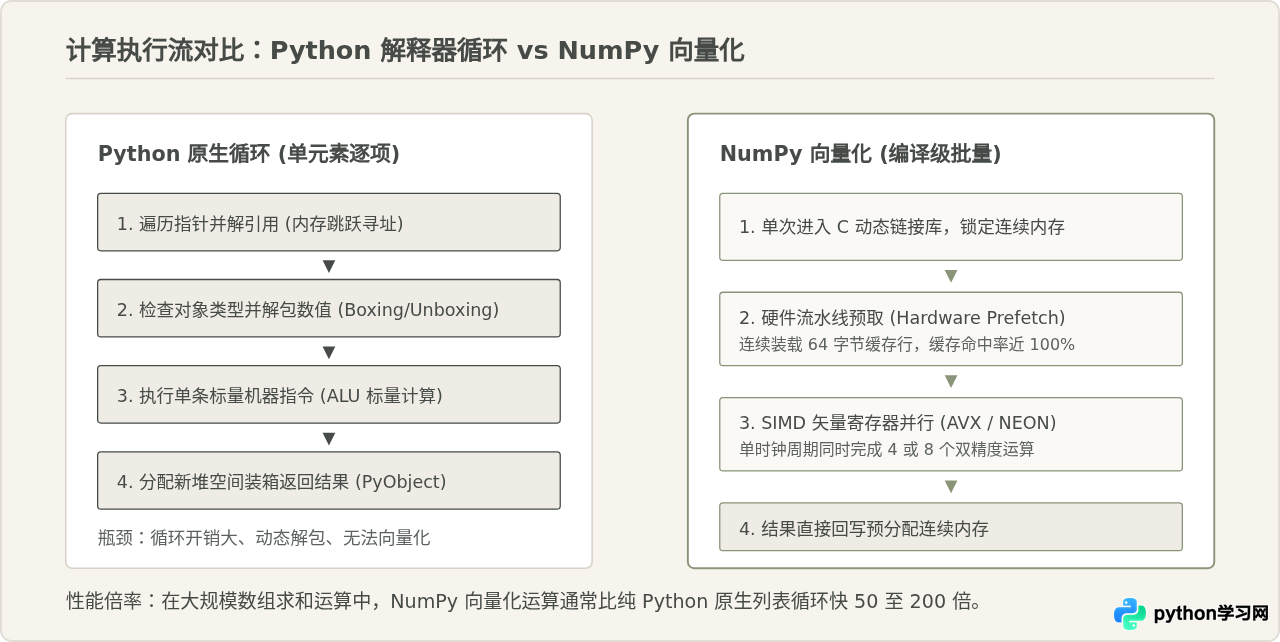
在Python列表中遍历并相加元素,例如使用for x in my_list: total += x,解释器在每一步迭代中都需要经历以下流程:
- 通过指针索引获取下一个
PyObject的内存地址; - 检查该对象的
ob_type类型指针,确认其是否支持__add__操作(动态分发); - 从包装结构体中解包(Unboxing)提取原生机器数值;
- 调用C底层加法函数;
- 将相加得到的新机器数值重新装箱(Boxing)为全新的
PyFloatObject或PyLongObject对象。
这一过程伴随大量的条件跳转、函数调用开销与临时对象的频繁创建与回收。由于数据在内存中散落分布,CPU的数据预取器(Hardware Prefetcher)无法预测下一步的内存位置,导致L1/L2数据缓存命中率极低,CPU频繁陷入等待内存就绪的停顿状态(Cache Miss Stall)。
NumPy的向量化运算(Vectorization)则完全绕过了Python解释器。当调用a + b时,控制权直接移交给底层的预编译C代码。因为已知数组内全部为同一种数据类型(如float64)且内存地址严格连续:
- 零运行时类型检查:仅在启动时检查一次类型签名,循环体内无需任何类型判定。
- 极佳的局部性(Locality):连续内存使得CPU可以在一次缓存行(Cache Line,通常为64字节)填充中抓取连续8个双精度浮点数,缓存命中率接近100%。
- 硬件级SIMD并行:现代编译优化的C循环可以直接映射到CPU的SIMD指令集(如AVX-2、AVX-512或ARM NEON),单个时钟周期内一条指令同时对4个或8个浮点数执行运算。
这种说法看似合理,但并不准确。用C语言编写只是NumPy高效的实现手段,而非根本瓶颈所在。如果我们在C代码中遍历并操作Python原生列表,依然必须顺着指针寻址、读取PyObject结构体并提取数值,此时依然会遭遇严重的缓存未命中(Cache Miss)与指针解引用开销。真正的速度源泉是同质连续的内存拓扑,它让底层编译器的循环展开、SIMD指令并行与CPU硬件预取发挥出极限性能。
三、科学计算工作流:从标量循环改造为向量化计算
采用NumPy进行科学计算,不仅是底层性能的提升,更代表了一种将复杂矩阵与向量操作视为整体的编程范式。从传统的Python列表循环转变为NumPy计算,通常包含四个关键步骤:
步骤 1:显式类型化与零复制转换
在创建数组时明确指定数值精度(如float32或float64),避免类型隐式提升带来的额外内存分配:
import numpy as np

# 明确指定 dtype,直接分配单块紧凑内存
raw_data = [1.2, 3.4, 5.6, 7.8]
arr = np.array(raw_data, dtype=np.float64)
步骤 2:形状与步长视图(Strides)重塑
NumPy的维度变换(如reshape、转置T)绝大多数情况下是“零内存复制”的视图操作(View)。它仅仅修改数组元信息头中的shape和strides,而不复制实际的缓冲区数据:
# 将 1 维数组重构为 2x2 矩阵,底层数据内存不变
matrix = arr.reshape((2, 2))
print("步长信息:", matrix.strides)  # 输出示例: 步长信息: (16, 8)
步骤 3:利用广播机制消除显式矩阵扩展
在处理不同维度的运算时,原生列表必须通过多重循环或列表推导式构造复制矩阵。NumPy的广播机制(Broadcasting)允许不同形状的数组直接进行算术运算,其实现原理是将较小维度的步长(Stride)设置为0,从而在物理上不需要复制任何数据:
# 矩阵加上一维偏置向量:偏置行在内存中不进行复制,虚拟广播对齐
bias = np.array([10.0, 20.0])
result = matrix + bias  # 向量化广播加法
步骤 4:批量算子与聚合统计
将逻辑判断与筛选转换为布尔掩码(Boolean Masking),替代传统的if过滤条件,全部下沉到底层C库完成计算:
# 筛选大于 15 的元素并计算均值
mask = result > 15.0
filtered_mean = result[mask].mean()
print("均值输出:", filtered_mean)  # 示例输出: 均值输出: 26.7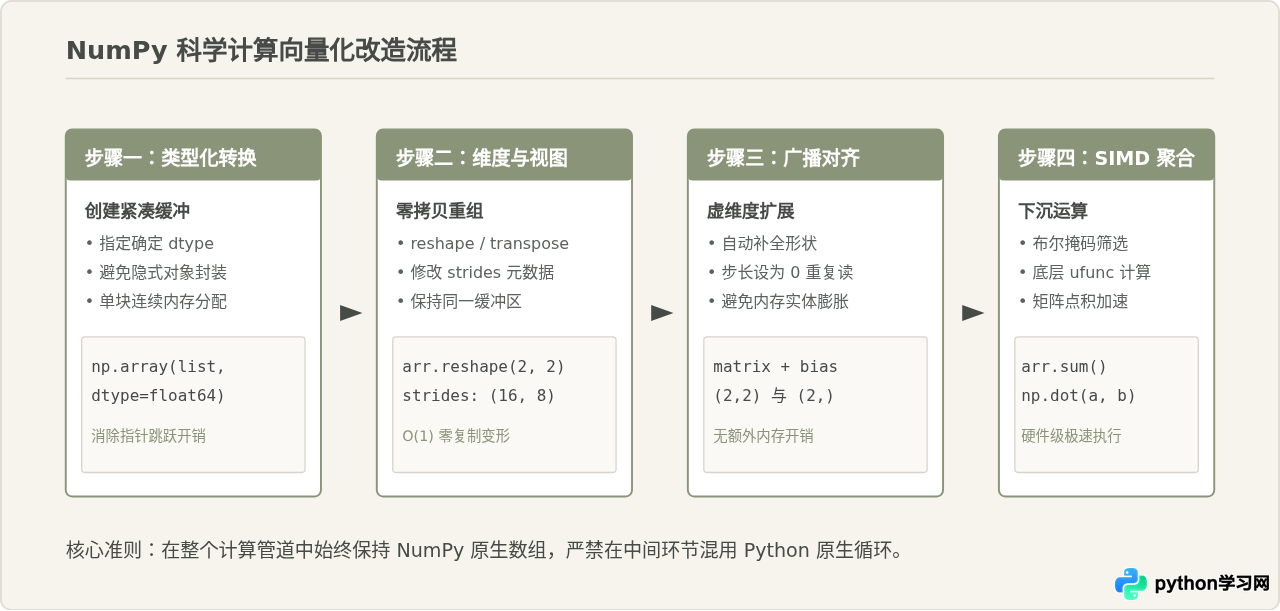
四、适用边界辨析:什么时候仍然应当使用 Python 列表?
尽管NumPy在数值密集计算中具有压倒性优势,但这并不意味着它可以完全替代Python列表。理解两者的设计边界,能够帮助开发者做出合理的架构选型。
1. 动态频繁增删元素
Python列表针对尾部追加(append)和弹出(pop)做了高度优化,采用过量分配策略(Over-allocation),其均摊时间复杂度为常数级 O(1)。
相反,NumPy数组在创建时大小完全固定。若使用np.append(),NumPy必须在底层开辟一块全新的连续内存区域,并将原数组所有数据完整拷贝过去,时间复杂度高达 O(N)。如果在循环中持续向NumPy数组追加元素,程序性能将发生断崖式下跌。
2. 异构容器与复杂对象管理
当数据集合包含不同类型(例如字符串、自定义类实例、字典等),或者需要处理树状、图状非规则结构时,Python列表的异构特性具有天然的便利性。虽然NumPy支持dtype=object,但这会使其退化为“包装了NumPy外壳的指针数组”,失去连续内存和SIMD的一切优势,反而徒增封装成本。
五、选型决策总结
综合内存布局、硬件加速特性与数据流向,下表汇总了Python列表与NumPy数组的核心技术特征差异:
| 对比维度 | Python 原生列表 (list) | NumPy 数组 (ndarray) |
|---|---|---|
| 内存布局 | 连续指针数组,元素指向分散的堆对象 | 绝对连续且同质的纯原生内存块(C/Fortran布局) |
| 内存占用 | 极大(包含对象引用计数、类型头信息,额外3~4倍膨胀) | 极小(按数据类型紧凑排列,float64仅需8字节) |
| 计算机制 | 解释器标量循环,每次迭代伴随动态类型检查与装箱 | 底层C编译库向量化执行,支持硬件级SIMD并行指令 |
| 缓存友好度 | 较差(指针跳转导致高频CPU Cache Miss) | 极佳(数据局部性极强,硬件预取命中率接近100%) |
| 元素类型 | 完全异构,可混存任意Python对象 | 强同质性,要求统一的数值精度与类型定义 |
| 动态伸缩性 | 优异(尾部追加/弹出均摊复杂度为 O(1)) | 较差(尺寸固定,动态增删需重新分配并全量拷贝) |
| 生态集成 | Python通用基础架构容器 | SciPy、Pandas、PyTorch、TensorFlow的核心交互基石 |
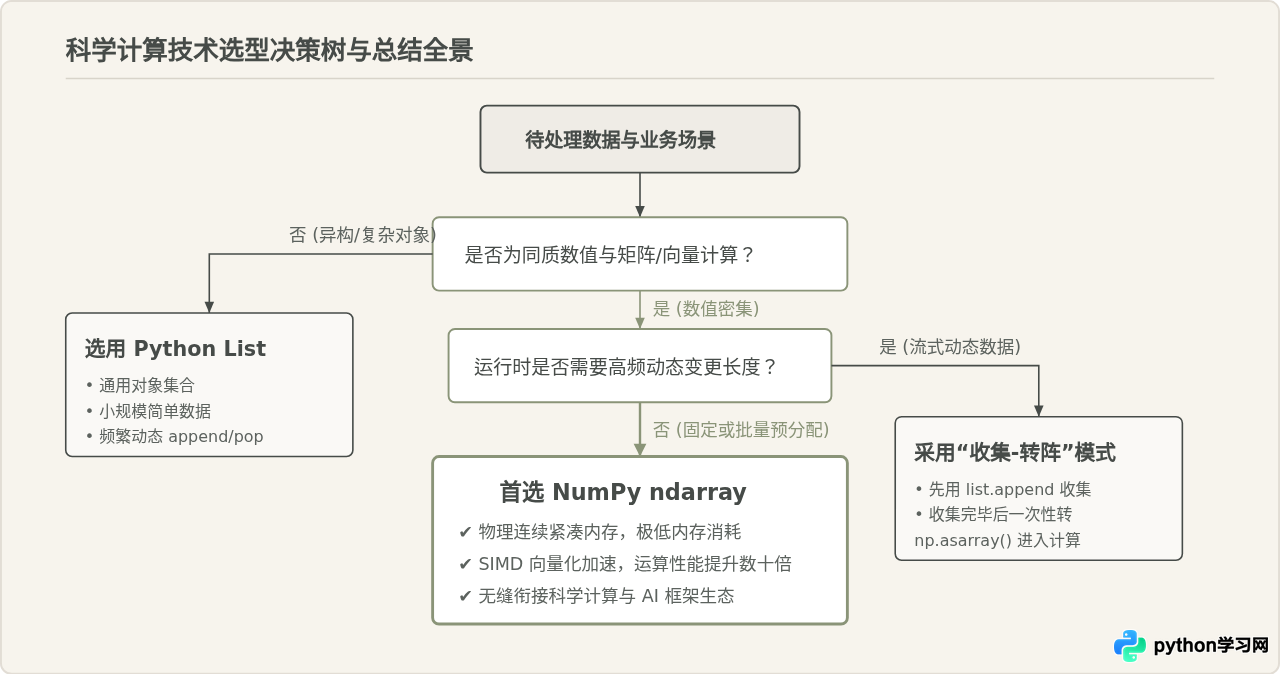
综上所述,科学计算首选NumPy数组,是现代硬件架构(CPU缓存机制、SIMD向量指令)与数据拓扑特性(连续物理内存、同质数据消除动态解包)相互契合的必然结果。掌握两者的本质差异,能让我们在面对海量数据与密集计算任务时,做出更坚实、更高效的工程决策。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















