


Python异步编程主要用在哪里:IO密集型场景解析
深入解析Python异步编程(asyncio)的核心应用场景,详细剖析IO密集型任务中事件循环的运作机制、网络抓取、API聚合、长连接服务等实战案例及避坑指南。
Python的异步编程模型并不是为了提升数字计算速度而设计的,它的核心价值在于解决IO等待期间的CPU资源闲置问题。当程序需要等待远程服务器响应、数据库读取记录、外部文件传输或建立网络长连接时,异步机制能够让单个CPU线程在“等待的间隙”转去处理其他任务,从而在有限的系统资源下支撑起数千甚至上万的高并发请求。
一、理解边界:什么是IO密集型任务
在探讨异步应用之前,必须先厘清现代程序中两类截然不同的性能瓶颈:计算密集型(CPU-bound)与IO密集型(I/O-bound)。
- 计算密集型:程序耗时主要集中在处理器的运算单元上,例如复杂的数学矩阵运算、音视频重编码、大模型推理或密码哈希破解。这类场景下CPU始终处于100%全负荷运算状态,单纯使用单线程的异步编程不仅无法提速,反倒会因事件循环调度带来额外微小的开销。
- IO密集型:程序的大部分时间都在“等待数据就绪”,例如发起HTTP请求等待对端服务返回JSON、向PostgreSQL发送复杂SQL等待磁盘检索并返回游标、或者监听WebSocket客户端的实时消息。在等待的99%时间里,本地CPU核心其实处于空闲挂起状态。
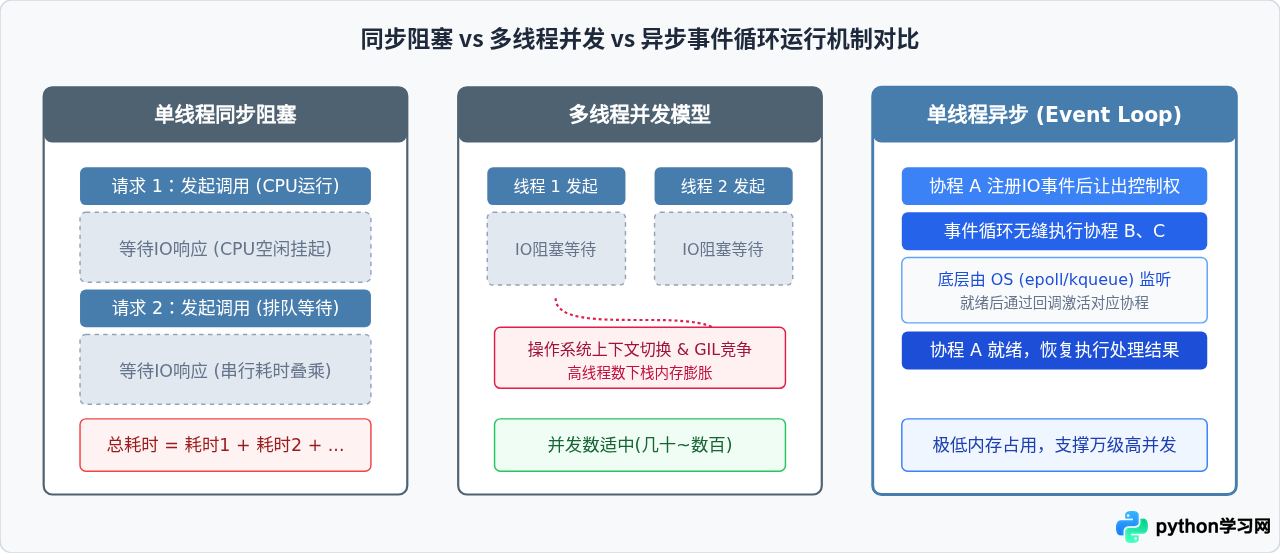
传统的同步代码在遇到IO调用时会发生线程阻塞,当前线程只能原地等待网络数据包返回后才继续执行下一行代码。若想同时发起1000个网络请求,同步模型往往需要创建1000个操作系统线程。然而,操作系统线程开销昂贵,每个线程默认占用数MB独立栈内存,频繁的线程上下文切换也会给内核调度器带来沉重负担。
二、底层工作机理:事件循环与协程协作
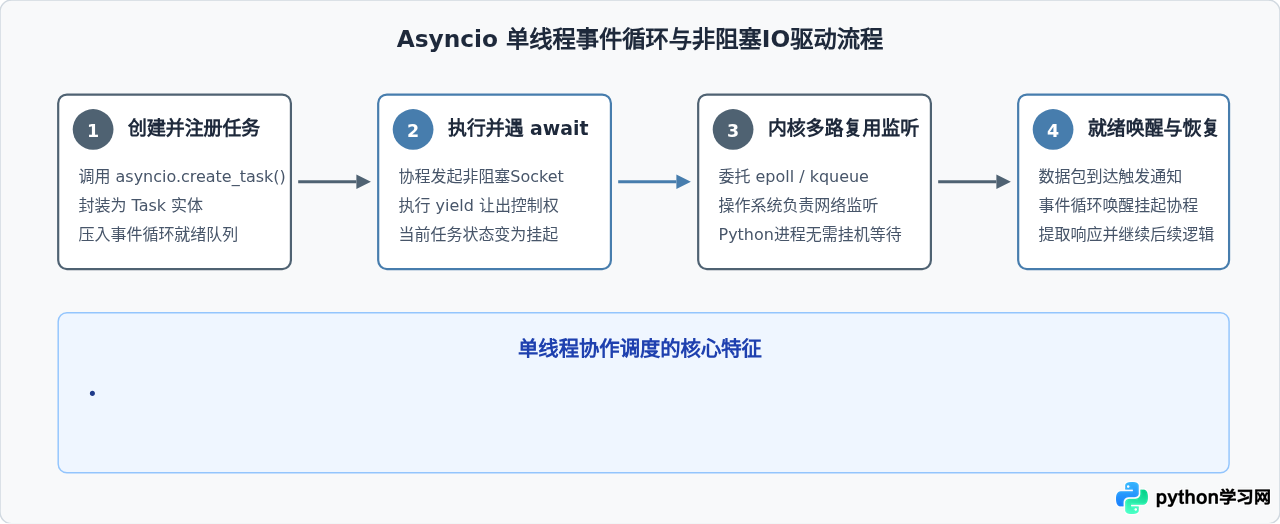
Python的 asyncio 模块本质上是在用户空间实现的一套协作式调度器。它的两个基石概念是事件循环(Event Loop)和协程对象(Coroutine):
- 事件循环:如同一个永不停歇的轮询调度员。它维护一个可执行任务清单,并借助操作系统内核的多路复用机制(Linux下的
epoll、macOS下的kqueue、Windows下的IOCP)监听所有待处理套接字(Socket)的文件描述符。 - 协程让出机制(await):当一个协程运行到
await non_blocking_io()时,它主动将CPU执行权归还给事件循环,并告诉循环:“当这个网络连接的数据包到达时再唤醒我”。在数据到达前的空档期,事件循环立即转去驱动其他就绪的协程。
三、四大典型落地场景深度剖析
Python异步编程在实际工程实践中最主要落地在以下四个方向:
1. 高并发网络数据采集与多源API聚合
对于电商价格比对、资讯爬虫或聚合API网关,程序通常需要向数十个甚至上千个远程第三方端点请求数据。如果使用同步的 requests 库,抓取1000个网页、每个平均耗时0.5秒,串行总计需要500秒;若利用异步HTTP库(如 httpx 或 aiohttp),配合 asyncio.gather,1000个请求可以在几秒钟内全部完成。
2. 高吞吐微服务网关与Web API框架
现代Python Web框架(如 FastAPI、Sanic、BlackSheep)均原生基于ASGI(Asynchronous Server Gateway Interface)标准构建。在微服务架构中,一个对外的查询接口往往需要先向用户中心验签、再向订单服务查明细、最后向库存服务查状态。通过异步并发调用下游微服务,接口响应时间将直接由“三次请求耗时之和”缩减为“下游最慢服务的耗时”。
3. 实时长连接与WebSocket通讯系统
在线客服系统、多人协同文档、实时股票行情看板等场景需要客户端与服务端维持持久连接(Persistent Connection)。这些连接在99%的时间内没有即时消息传递,但连接不能断开。如果每个连接占用一个操作系统线程,服务器在几千个连接时内存就会枯竭;而基于异步事件循环,一台单核服务器就能轻松挂载数万个空闲WebSocket长连接。
4. 异步数据库批量检索与分布式缓存读写
在密集数据库查询场景下,传统的同步数据库驱动会在SQL语句发送后阻断线程。借助异步驱动(如针对PostgreSQL的 asyncpg、针对MongoDB的 motor、针对Redis的 redis.asyncio),应用可以在数据库磁盘寻道和网络传输期间继续处理其他业务计算,显著提高吞吐量。
四、从同步到异步的实战代码与改造路线
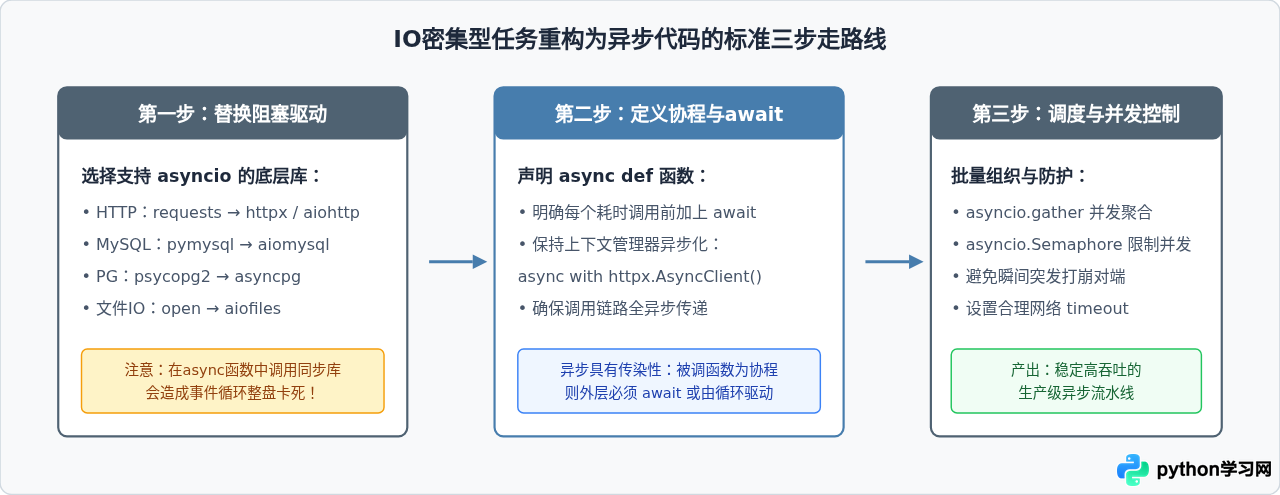
为了让读者直观掌握异步编程在IO密集场景下的用法,我们以“批量抓取外部接口”为例展示标准改造步骤:
代码范例:带信号量限制的异步HTTP批量请求
执行以下代码需要安装现代异步HTTP库:pip install httpx。
import asyncio
import httpx
import time

# 目标测试URL集合(示例)
URLS = [
    f"https://httpbin.org/delay/1" for _ in range(20)
]

# 利用信号量控制并发数,避免瞬间耗尽连接池或触发对方防火墙
SEMAPHORE = asyncio.Semaphore(5)

async def fetch_url(client: httpx.AsyncClient, url: str, index: int) -> dict:
    """单个请求协程:受信号量保护,避免无限制并发"""
    async with SEMAPHORE:
        start_time = time.monotonic()
        try:
            response = await client.get(url, timeout=10.0)
            elapsed = time.monotonic() - start_time
            return {"index": index, "status": response.status_code, "elapsed": round(elapsed, 2)}
        except Exception as exc:
            return {"index": index, "error": str(exc)}

async def main():
    start_total = time.monotonic()

    # 共享同一个 AsyncClient 连接池,复用底层TCP长连接
    async with httpx.AsyncClient() as client:
        # 创建20个并发任务
        tasks = [fetch_url(client, url, i) for i, url in enumerate(URLS)]

        # 并发收集所有任务结果
        results = await asyncio.gather(*tasks)

    total_time = time.monotonic() - start_total
    print(f"完成 {len(results)} 个请求,总计耗时: {total_time:.2f} 秒")
    # 如果是同步阻塞调用,20个耗时1秒的请求需要20秒以上;
    # 采用5个并发信号量后,总耗时仅需约4秒出头即可完成。

if __name__ == "__main__":
    asyncio.run(main())
在上述代码中,async with httpx.AsyncClient() 确保了TCP连接池的复用;asyncio.Semaphore(5) 控制了同一时刻最多只有5个HTTP请求正在飞向网络。在等待服务器返回的1秒内,事件循环自动协调各任务推进,最大化节约了等待耗时。
五、生产环境三大约束与排错注意事项
尽管异步编程在IO密集场景下表现卓越,但若违反其设计契约,反而会导致更严重的性能衰退或隐蔽死锁:
事件循环始终运行在单个操作系统线程中。如果你在协程内部调用了同步的 time.sleep(5)、同步的 requests.get() 或耗时数秒的本地磁盘大文件加密,整个事件循环将被彻底“冻结”。在此期间,其他所有已经就绪的几千个网络连接无法被响应,客户端将遭遇大面积超时。如果必须执行遗留的同步阻塞代码,必须使用 asyncio.to_thread(sync_func) 将其投递到后台独立线程池中执行。
- 未加限制的瞬时并发造成连接拒绝:不要直接对10000个URL执行
asyncio.gather(*tasks)而不加控制。瞬间建立过量套接字会导致本地操作系统报错Too many open files(超过文件描述符ulimit限制),或者直接被对端服务器当作DDoS攻击予以封禁。务必使用asyncio.Semaphore设置合理上限。 - 异常处理与任务泄漏:
asyncio.gather默认遇到一个异常就会中断或需配置return_exceptions=True。如果后台创建了未被引用的create_task,若发生未捕获异常,任务可能会静默失败而不输出堆栈日志。建议在生产中使用结构化并发或显式添加任务异常回调。
六、总结:Python并发技术选型全景矩阵
为了帮助开发者在面对实际需求时快速决策,下面总结了Python不同并发手段的适用分水岭:
| 方案 | 适用典型场景 | CPU利用特点 | 内存开销 | 编程心智负担 |
|---|---|---|---|---|
| 单线程异步 (asyncio) | 高并发网络爬虫、API网关、WebSocket长连接、微服务转发 | 单核事件循环,非阻塞等待,不突破GIL | 极低(协程数千个仅几十MB) | 中高(需区分async/await,禁止同步阻塞) |
| 多线程 (threading) | 中低并发的本地磁盘IO、遗留同步库调用、图形界面后台工作 | 受GIL限制,仅在阻塞C调用/系统IO时释放GIL | 较高(每个线程1MB~8MB栈空间) | 中(需处理线程同步锁与死锁) |
| 多进程 (multiprocessing) | 科学计算、数据预处理、机器学习特征工程、图像处理 | 独享CPU多核心,完全绕过GIL | 高(子进程复制内存空间,IPC通信开销) | 中(需要序列化数据与进程间通信) |
概括而言,当系统瓶颈是“网络等待”且并发量达到数百上千时,Python异步编程是最理想的技术选型;只要保证不引入同步阻塞调用,并合理配置信号量限流,异步编程就能以极低的系统开销换取卓越的吞吐表现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















