


Python生成指定范围内不重复的随机数
详细讲解在Python中生成指定数值范围内互不重复随机数的实用方法,涵盖random.sample、全量洗牌、集合查重及加密安全场景的适用条件与边界处理。
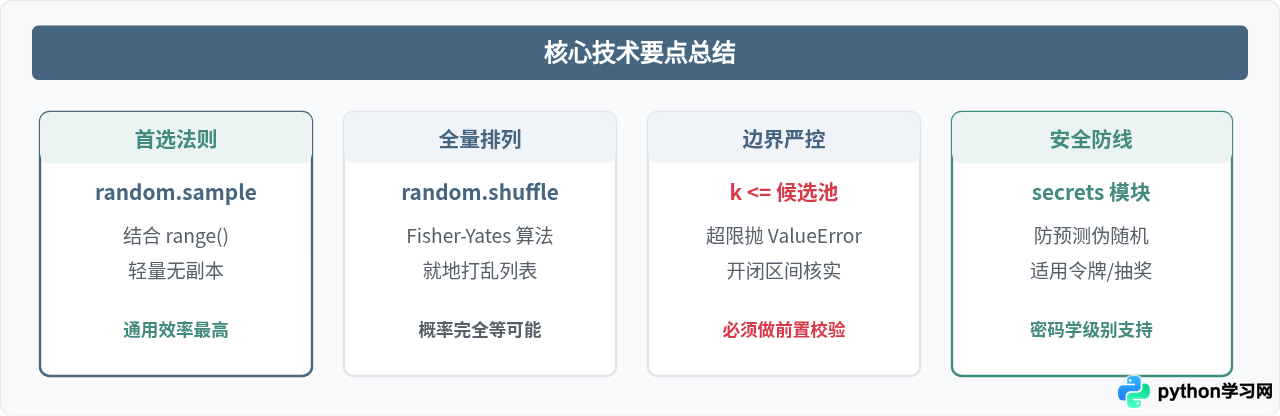
在 Python 中生成指定整数范围内互不重复的随机数,最直接、标准且高效的解法是使用标准库内置的 random.sample(range(start, stop), k)。该方法底层实现了无放回抽样,能够在不产生多余列表副本的前提下,精确抽取指定数量且各不相同的整数。
一、核心解决方案:使用 random.sample()
日常开发中最普遍的需求是在区间 [start, stop - 1] 内挑选 k 个各不相同的随机整数。标准库模块 random 提供了 sample() 函数,配合 Python 3 的惰性求值对象 range(),可以做到开箱即用且性能优异。
import random

# 目标:在 1 到 100 之间(含 1 和 100)随机抽取 8 个互不重复的整数
start = 1
end = 100
count = 8

# 注意:range 的右边界是开区间,因此取值上限需为 end + 1
unique_numbers = random.sample(range(start, end + 1), count)

print("生成的不重复随机数列表:", unique_numbers)
# 示例输出:[42, 17, 88, 3, 95, 61, 29, 74]在这段代码中,range(1, 101) 构成候选数字池。Python 3 中的 range 并不会立即在内存中创建容纳 100 个数字的完整列表,而是一个轻量级的可迭代序列对象。random.sample() 能直接对其建立索引抽样,因此即便是范围很大的数值区间,内存开销也十分受控。
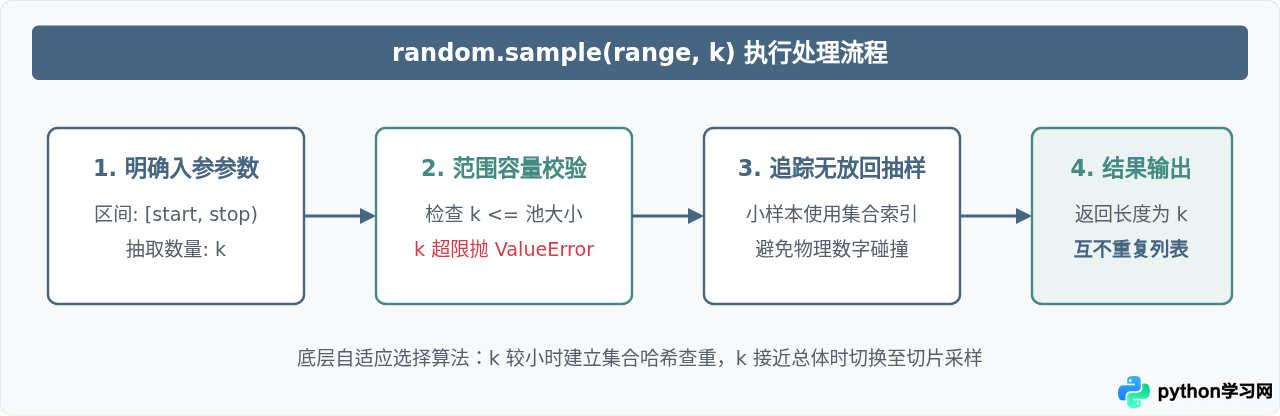
k 绝不能超出候选区间所包含的整数总数。例如 range(1, 10) 中只有 9 个整数,若传入 k=10,Python 将直接抛出 ValueError: Sample larger than population or negative。在封装通用函数时,必须对 k 进行前置判断。
二、机制对比:有放回抽样 vs 无放回抽样
初学者容易尝试在 while 循环中调用 random.randint() 并配合 set 进行去重,或者误用 random.choices()。理解“有放回”与“无放回”的区别,是选用正确方法的关键。
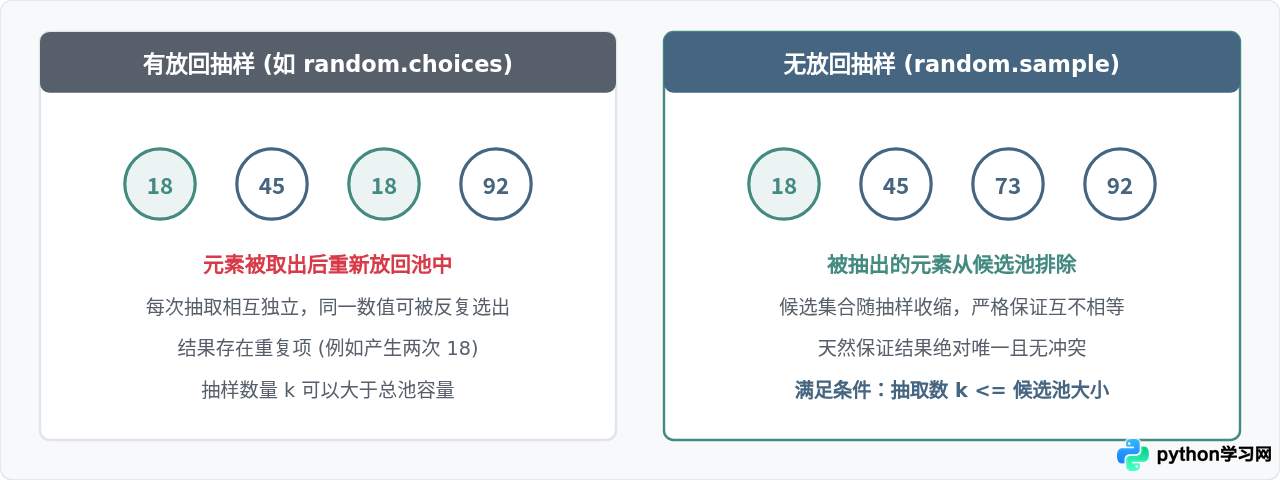
如果使用 random.randint() 在循环中抽样并向集合 set 添加元素,当抽取数量接近范围上限时,冲突概率会急剧增加,导致循环次数呈几何级数上升(即经典的生日悖论与球箱模型冲突)。因此,无放回抽样应当始终作为第一选择。
三、场景扩展与变体实现
1. 全量打乱顺序:random.shuffle()
当需要把指定范围内的所有数字全部打乱并按随机顺序输出(例如扑克牌洗牌、全量学员抽签出场顺序)时,抽取数量 k 等于总体容量。此时直接使用 random.shuffle() 就地洗牌最为高效直观。
import random

# 创建包含 1 到 10 的列表
numbers = list(range(1, 11))

# 就地打乱列表顺序(修改原列表,不返回新对象)
random.shuffle(numbers)

print("打乱后的完整数字列表:", numbers)
# 示例输出:[7, 2, 10, 4, 1, 9, 3, 5, 8, 6]
random.shuffle() 采用的是经典的 Fisher-Yates 洗牌算法,时间复杂度严格为 O(N),保证每一个排列的出现概率完全均等。
2. 超大稀疏范围与动态排重
在某些特定场景下,数字取值区间极为庞大(如 1 到 10^12),但只需极少量的几个随机数(例如 3 个全局防碰撞测试 ID)。虽然 Python 3 的 range 本身不占内存,但在非常巨大的范围上,也可以使用显式集合进行轻量抽取:
import random

def generate_sparse_unique_randoms(low, high, k):
    """
    适用于大范围、少量抽取的稀疏排重场景
    """
    if k > (high - low + 1):
        raise ValueError("抽取数量不能大于范围容量")

    selected = set()
    while len(selected) < k:
        num = random.randint(low, high)
        selected.add(num)

    return list(selected)

# 从千亿级范围中获取 4 个不重复的随机数
print(generate_sparse_unique_randoms(1, 100_000_000_000, 4))
# 示例输出:[19482710384, 84729104812, 5109283719, 93847291024]
3. 安全敏感场景:secrets 模块
random 模块使用的是 Mersenne Twister(梅森旋转算法),它属于伪随机数生成器(PRNG),其内部状态在观察到一定数量的输出后是完全可预测的。如果生成的随机数用于一次性密码验证码、安全令牌、抽奖防作弊或秘钥派生,必须改用标准库中的 secrets 模块。
import secrets

# 使用操作系统底层安全随机源 (如 /dev/urandom 或 CryptGenRandom)
secure_rng = secrets.SystemRandom()

# 在 100000 到 999999 之间抽取 5 个不重复的验证码候选
secure_codes = secure_rng.sample(range(100000, 1000000), 5)

print("密码学安全的随机数序列:", secure_codes)
# 示例输出:[829104, 301948, 672109, 458120, 194823]
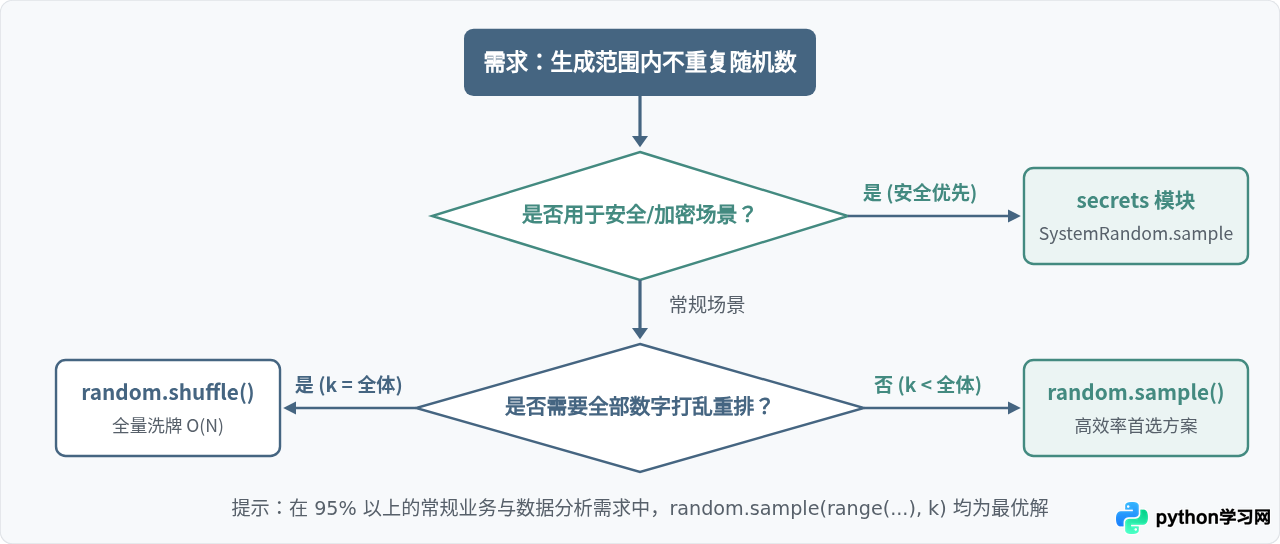
四、方案选型决策路径
针对不同的业务场景、抽取规模以及安全性要求,可以通过如下决策路径挑选出最贴合需求的方法:
五、综合总结与技术选型对照
为了便于在工程实践中快速查阅与选型,下表将本文讨论的核心方法从适用场景、底层复杂度及常见错误点进行横向对照:
| 实现方法 | 适用场景 | 时间复杂度 | 内存消耗 | 核心优势与避坑点 |
|---|---|---|---|---|
random.sample(range, k) |
通用场景,部分无放回抽取 | O(k) | O(k) | 首选方案;注意 k 严禁超过范围总容量。 |
random.shuffle(list) |
需要全量元素随机打乱次序 | O(N) | O(N) | 直接修改原列表;必须先把 range 展开为列表。 |
set + random.randint |
极大稀疏范围中的极小量抽取 | 接近 O(k) | O(k) | 仅在范围远大于抽取数时可用;若抽取比例高易陷入自旋。 |
secrets.SystemRandom |
验证码、密码生成、抽奖防作弊 | O(k) | O(k) | 密码学安全,无法通过历史序列逆向预测,系统调用开销稍高。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















