


转行自学Python怎么学?高效学习方法与时间管理技巧
针对零基础及在职转行人群的实用Python学习指南,系统讲解基础语法压缩、项目驱动实战、在职时间切片管理与求职作品集构建策略,避开低效自学陷阱。
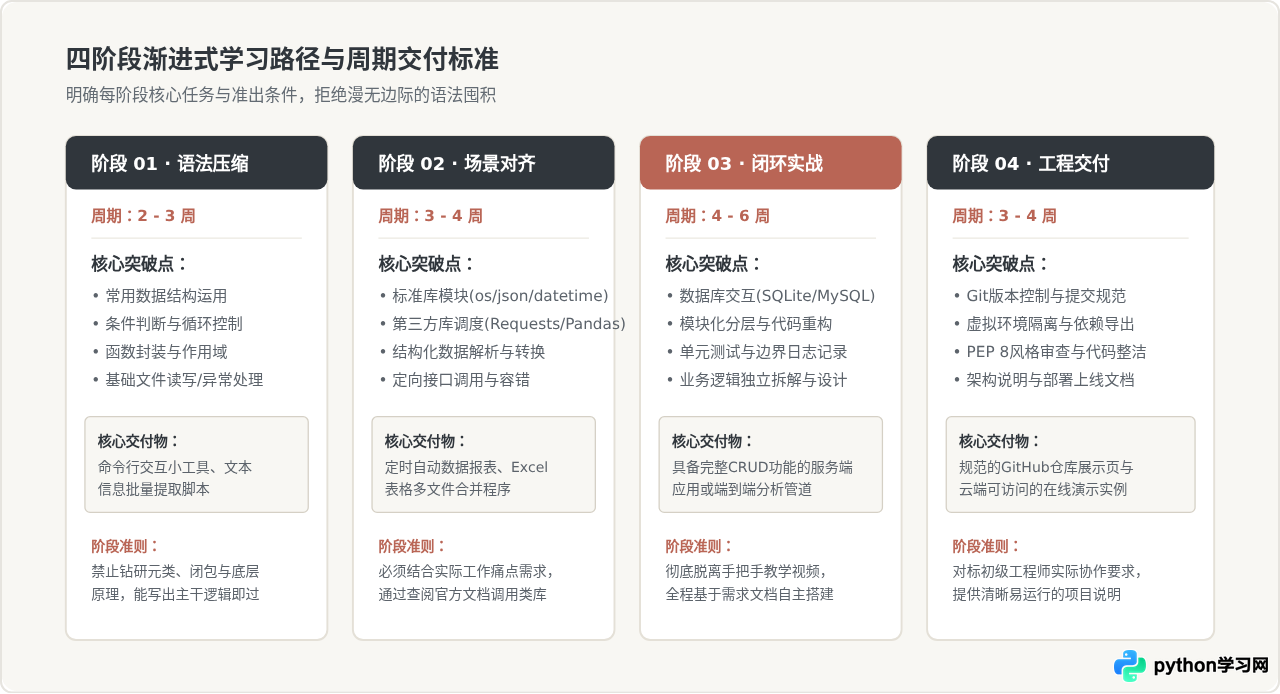
一、明确转行目标与基础语法的高效压缩
自学转行最常见的失误,是一上来就购买几百集的视频教程或翻阅上千页的语法大部头。试图把 Python 的每一个内置函数和边角特性掌握后再做项目,往往会在漫长的被动输入中耗尽初始热情。
Python 作为通用编程语言,其应用分支极其广泛:自动化运维、数据分析与挖掘、Web 后端开发、自动化测试等。不同岗位对技术栈的需求截然不同。数据分析侧重 Pandas、SQL 与统计可视化;Web 开发则需要打牢网络协议、ORM、数据库以及 Django 或 FastAPI 框架基础。在启动学习的第一天,就应选定具体的技术出口,根据目标倒推所需能力,删除无关知识点。
对于基础语法,应推行“压缩法则”:将语法学习时间严格控制在 2 至 3 周以内。这一阶段只聚焦核心四要素:变量与常用数据结构(列表、字典、元组、集合)、基础控制流程(if 条件分支与 for/while 循环)、函数的定义与传参返回值,以及基础的文件读写与异常捕获。面向对象的高级特性(如多重继承、元类、装饰器底层原理)不必在此刻死磕,留待后续真实业务场景中逐步理解。
二、打破“教程依赖”的项目闭环实战法
许多转行者在观看讲师编码时感觉“全懂了”,但打开空白的编辑器却连第一行代码都写不出。这种心理学上的“被动认知错觉”,是因为大脑在跟随线性叙事时并未真正建立解决问题的索引网络。
摆脱教程依赖的关键在于实施“三步跃迁机制”:
- 仿写改造:在学习某个实例时,坚决不逐字盲目复制。完成示例后,主动改变原始约束。例如教程读取的是 CSV 文件,尝试改用 JSON 或 SQLite;教程处理单页抓取,尝试改造成具备异常重试机制的多页采集。
- 逆向复刻:掩盖讲师的实现代码,仅根据最终的功能说明、入参要求和预期输出,自己在本地空白文件中设计结构并编码。遇到障碍时,优先查阅语言官方文档或报错堆栈,而非回看视频。
- 原创闭环:挑选一个与自身当前工作或生活相关的真实小问题(例如:整理桌面杂乱文件、自动核对两张格式不一的对账表、抓取指定技术博客的更新),不依赖任何预设教程,独立从零搭建。
下面是一个典型的自动化数据处理示例,展示了初学者如何用规范的函数组织、异常防御和日志输出来替代零散的面条式代码:
import os
import csv
import logging
from typing import List, Dict

# 配置基础日志记录格式,避免简单滥用 print
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)

def extract_valid_records(file_path: str, threshold: float) -> List[Dict[str, float]]:
    """
    安全读取CSV文件并过滤达标记录
    """
    if not os.path.exists(file_path):
        logging.error("目标文件不存在: %s", file_path)
        raise FileNotFoundError(f"未找到数据文件: {file_path}")

    valid_records = []
    with open(file_path, mode="r", encoding="utf-8") as f:
        reader = csv.DictReader(f)
        for row_index, row in enumerate(reader, start=1):
            try:
                name = row["item_name"].strip()
                score = float(row["score"])
                if score >= threshold:
                    valid_records.append({"item_name": name, "score": score})
            except (KeyError, ValueError) as err:
                logging.warning("第 %d 行数据格式解析失败,已跳过: %s", row_index, err)
                continue

    logging.info("读取完毕,共筛选出 %d 条有效数据", len(valid_records))
    return valid_records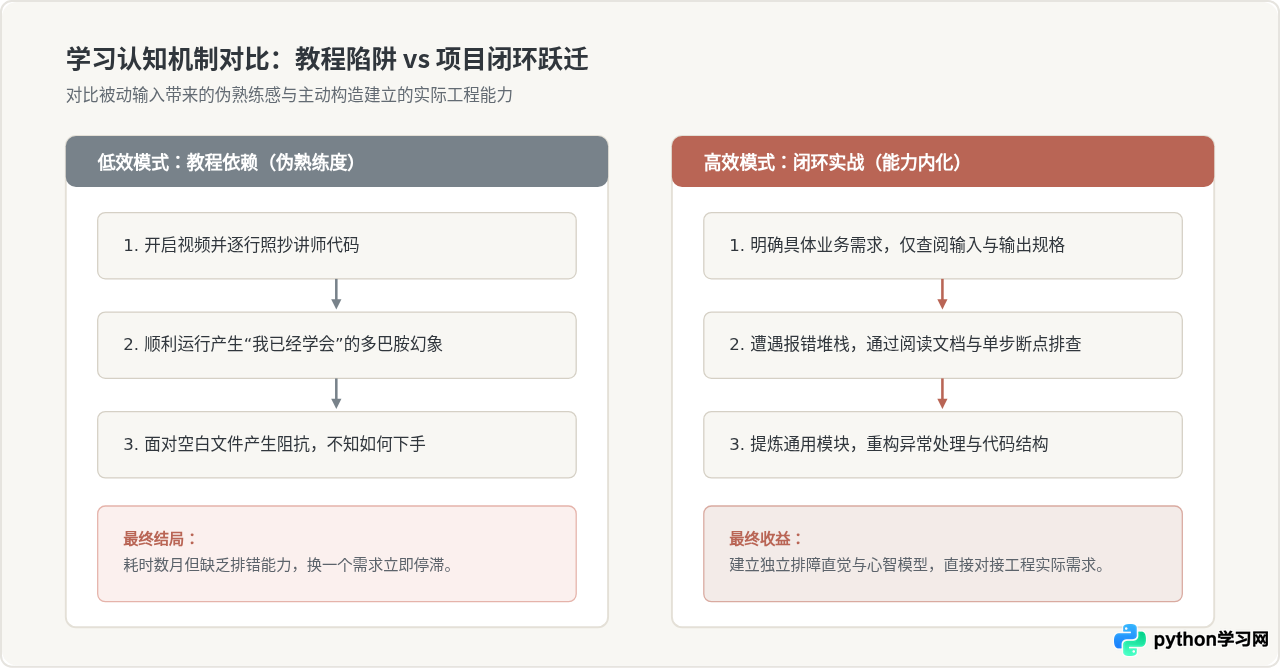
三、在职转行的时间切片与精力管理模型
自学转行者的失败,极少是因为智商不足,大部分是因为在漫长的碎片化消耗中被现实生活击垮。下班后身心俱疲的状态下,强行要求自己坐在电脑前推导两个小时复杂算法,既违背生理规律,也极易引发挫败感与逃避心理。
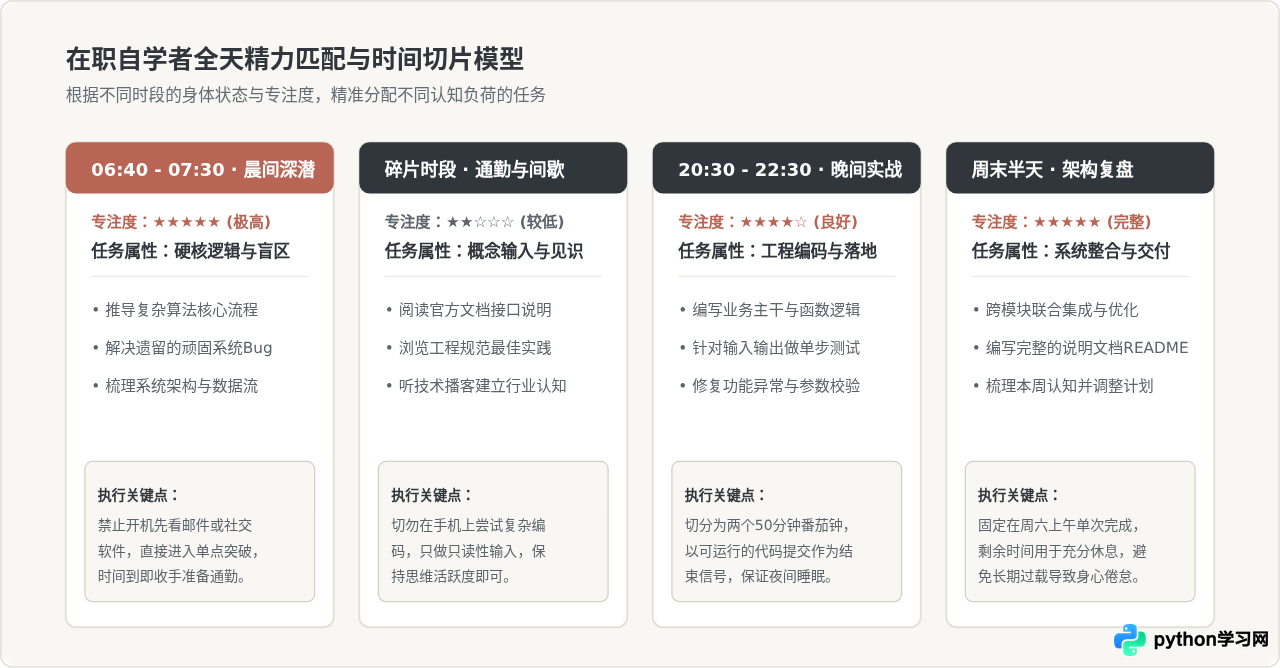
解决这一困境的核心,是实现任务类型与精力周期的严格对齐。将全天时间拆分为互不干扰的特定切片,执行不同的认知负荷任务:
- 晨间高能块(40 - 50 分钟):早起后的黄金期大脑未经杂务干扰,意志力最充沛。适合用来攻坚前一晚卡壳的疑难 Bug、理解核心数据结构原理或推演业务架构。在此切片内杜绝查阅社交平台与打卡杂务。
- 碎片通勤块(20 - 30 分钟):在公共交通或就餐间隙,不适宜编写代码。应专注于只读性内容:浏览 Python 官方 PEP 提案、阅读所用开源库的最新 Release Note、在手机端回顾前一日保存的代码片段或技术概念。
- 晚间深度编码块(90 - 120 分钟):晚餐后留出整块不受打扰的“编码专区”。采用番茄工作法(如 50 分钟专注 + 10 分钟拉伸),目标非常明确:只做项目实现与调试。关掉即时通讯工具,进入心流状态。
- 周末全流程攻坚块(3 - 4 小时):用于串联零碎成果。完成从功能编写、单元测试、Git 提交到环境打包上线的完整闭环交付,并对本周进度进行复盘与调优。
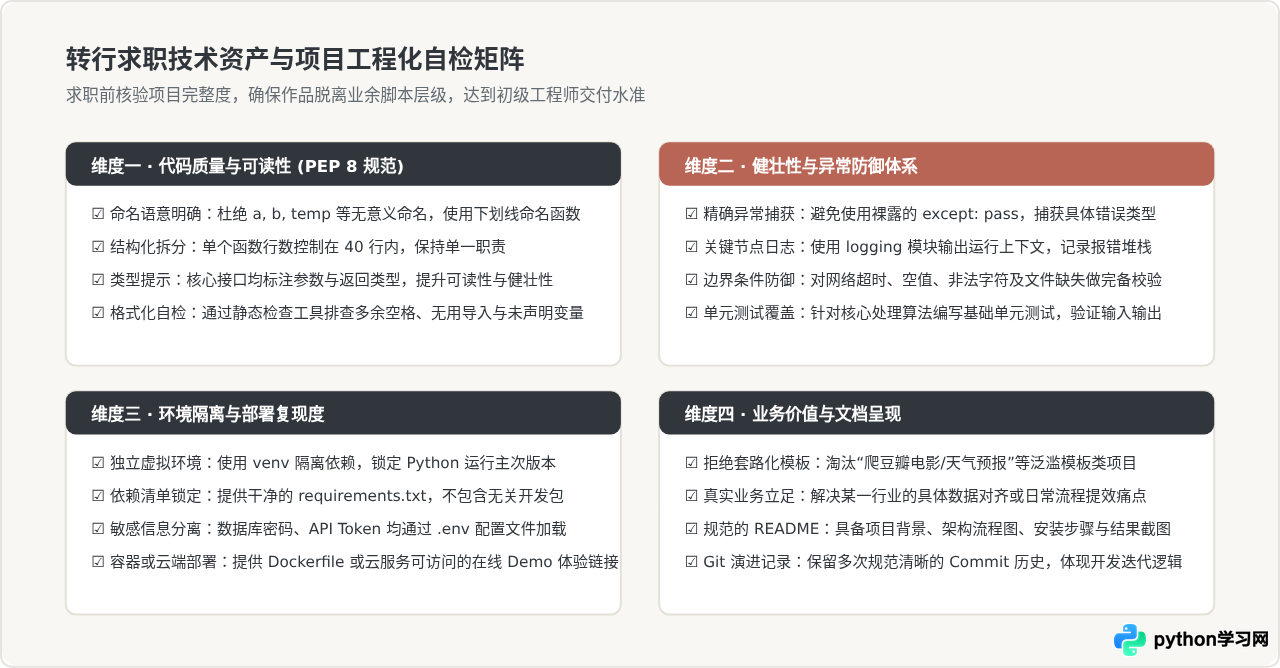
四、工程化意识与自检清单:从脚本进阶至求职作品集
招聘方在评估转行自学者时,最担忧的不是“是否有计算机学位”,而是“是否只会写散乱的初级脚本,缺乏真实工程协作能力”。一个合格的自学交付物,必须具备工程化规范。
想要使自己的作品集在招聘市场中脱颖而出,必须在自学中同步建立以下四项工程化习惯:
- 环境隔离与依赖管理:杜绝在全局 Python 环境下安装所有库。每个独立项目必须使用
venv创建专属虚拟环境,并通过pip freeze > requirements.txt准确记录依赖版本,确保任何人在克隆项目后均能一键还原运行。 - 版本控制与清晰的 Git 提交树:放弃把最终打包文件压缩为“v1.0-final.zip”的做法。通过 Git 进行版本演进,每一次提交都包含简明而符合规范的 Commit Message(如
feat: add user login validator、fix: resolve null pointer in parser),真实呈现代码的重构与思考过程。 - 代码规范与风格审查:严格遵循 PEP 8 编码规范,变量使用下划线命名法,常量全大写,类名大驼峰;为复杂函数补充 Type Hints(类型提示)及 Docstring 注释;通过 Flake8 或 Black 保持全项目排版整洁一致。
- 防御性编程与完善的 README:包含必要的配置项分离(使用环境变量而非硬编码密码与密钥)、异常边界兜底与结构化日志输出。每个项目都应附带专业规范的 README 文档,清晰说明背景、架构设计、启动依赖步骤及演示效果截图。
五、常见误区与应对策略
自学过程中难免会遇到瓶颈,提前识别以下典型误区能够大幅减少沉没成本:
- 误区一:盲目死磕深层算法,忽视工程集成能力。初级转行岗位的核心考核点是能否快速承接业务需求、熟练调用第三方库、看懂团队代码并产出符合规范的功能模块。在基础未牢前,不要把几个月时间全花在 LeetCode 动态规划题库上,先打牢应用工程能力,再根据求职目标定向练习常见高频数据结构。
- 误区二:频繁更换教程与开发工具。今天看某老师的视频觉得不错,明天看到新的“最新指南”又从第一章重新开始。这种行为本质是用低成本的从头开始逃避高难度的项目攻坚。认准一套逻辑清晰的主干教材即可,其余资源仅作为特定知识点的参考手册。
- 误区三:遭遇报错便彻底删库重来。报错信息是编程语言给开发者最精确的导航。面对红色报错堆栈,先看最后一行指出的异常类型(如
IndexError、KeyError、TypeError),再根据文件行号回溯上下文,养成使用断点单步调试和日志排查的习惯。正是解决这些具体报错的过程,在真正塑造你作为开发者的核心排障直觉。
转行自学 Python 并不是比拼谁看的视频时长更久,而是看谁能更早把代码当成解决现实问题的通用工具。以业务目标为导向裁剪语法、以闭环项目为抓手内化技能、以能量周期为依据管理时间,扎实打磨出两到三个具备工程规范的代表作品,便是跨越转行鸿沟最稳健的路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















