


Python3下载App报错ConnectionError怎么解决
针对Python3使用requests或urllib下载App安装包时频繁遭遇ConnectionError的问题,系统梳理代理配置、请求头封禁、大文件连接中断等常见成因,并提供流式下载、自动重试与断点续传的完整解决方案。
requests.exceptions.ConnectionError 通常并非 Python 解释器本身的语法缺陷,而是由于底层 TCP 连接中断、本地代理环境变量干扰、目标服务器防爬限流主动重置连接,或是因为未启用分块流式传输导致传输大文件超时。本文将从错误定位、原因排查到工业级下载脚本的实现,提供一套清晰完整的修复步骤。
一、认识 ConnectionError 的具体表现与报错层级
在 Python 中,网络库 requests 是对 urllib3 的高层封装。当发起下载请求抛出 ConnectionError 时,终端输出的通常是一长串嵌套的回溯信息(Traceback)。仔细观察回溯的最末几行,可以快速锁定故障发生的具体阶段:
- NewConnectionError / NameResolutionError:无法解析域名或无法建立初次 TCP 握手,通常指向 DNS 故障或网络不通。
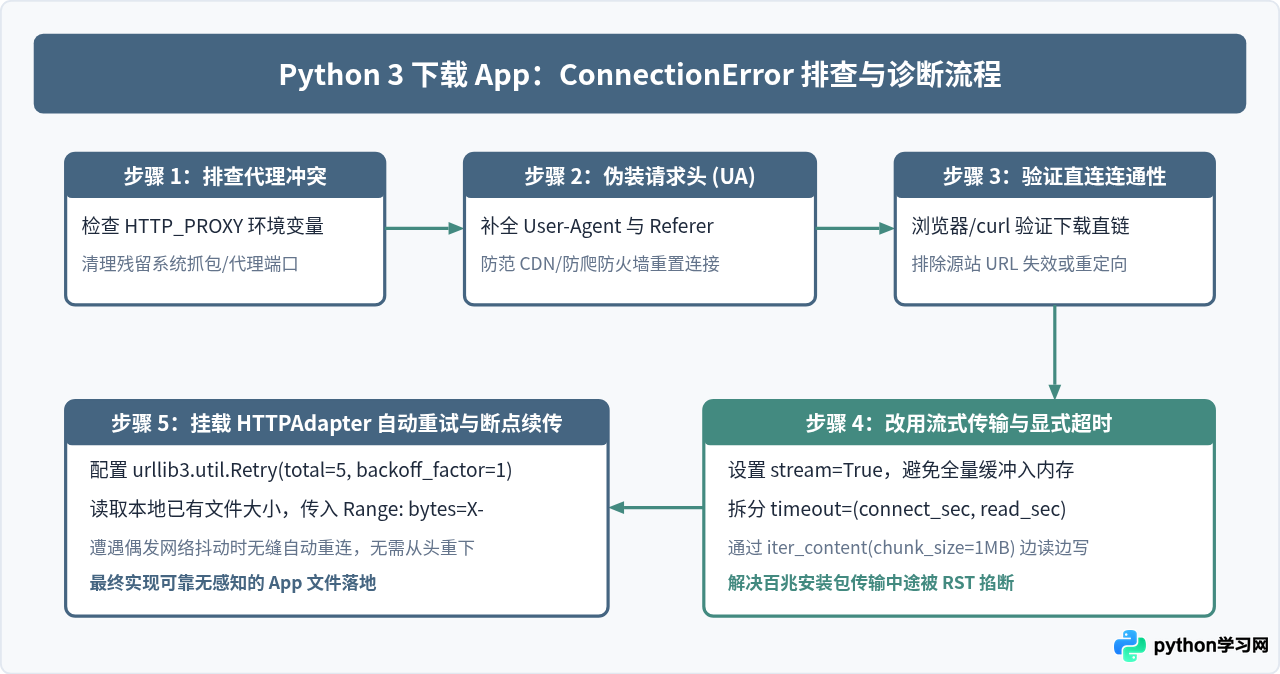
- ProxyError:Python 自动读取了操作系统的代理变量(如 127.0.0.1:7890),但代理软件未启动或拒绝连接。
- RemoteDisconnected / ConnectionResetError:连接在传输过程中被远端服务器或中间防火墙强行掐断(Connection reset by peer)。
- MaxRetryError:重试达到上限,常见于目标服务器检测到非浏览器行为后直接拒绝连接。
二、高频诱因一:系统代理环境变量与抓包工具冲突
这是本地开发机上最常见的故障原因。许多开发者在电脑上开启了代理工具(如科学上网工具、Fiddler、Charles 等),这些软件会在系统环境中写入 http_proxy、https_proxy 或在系统网络设置中配置了 127.0.0.1:7890 这类端口。
Python 官方的 urllib 和第三方库 requests 在初始化时,会默认通过 urllib.request.getproxies() 自动读取操作系统的代理配置。一旦代理软件中途关闭,或者目标 App 下载服务器拒绝代理握手,Python 就会尝试连接已关闭的本地代理端口,直接抛出 requests.exceptions.ProxyError: Cannot connect to proxy. 或 ConnectionRefusedError。
排查与解决方法
可以在代码中显式隔离系统环境变量,或者通过 Session 对象的 trust_env=False 忽略系统代理:
import os
import requests

# 方法 1:临时在代码中清除代理环境变量(仅对当前进程生效)
os.environ.pop("HTTP_PROXY", None)
os.environ.pop("HTTPS_PROXY", None)
os.environ.pop("http_proxy", None)
os.environ.pop("https_proxy", None)

# 方法 2:使用 Session 并禁用系统环境变量信任(推荐)
session = requests.Session()
session.trust_env = False  # 强制不读取系统代理,直接直连源站

# 如果确定需要走特定代理,应显式传入有效参数:
# proxies = {
#     "http": "http://127.0.0.1:7890",
#     "https": "http://127.0.0.1:7890"
# }
# response = session.get(download_url, proxies=proxies, stream=True)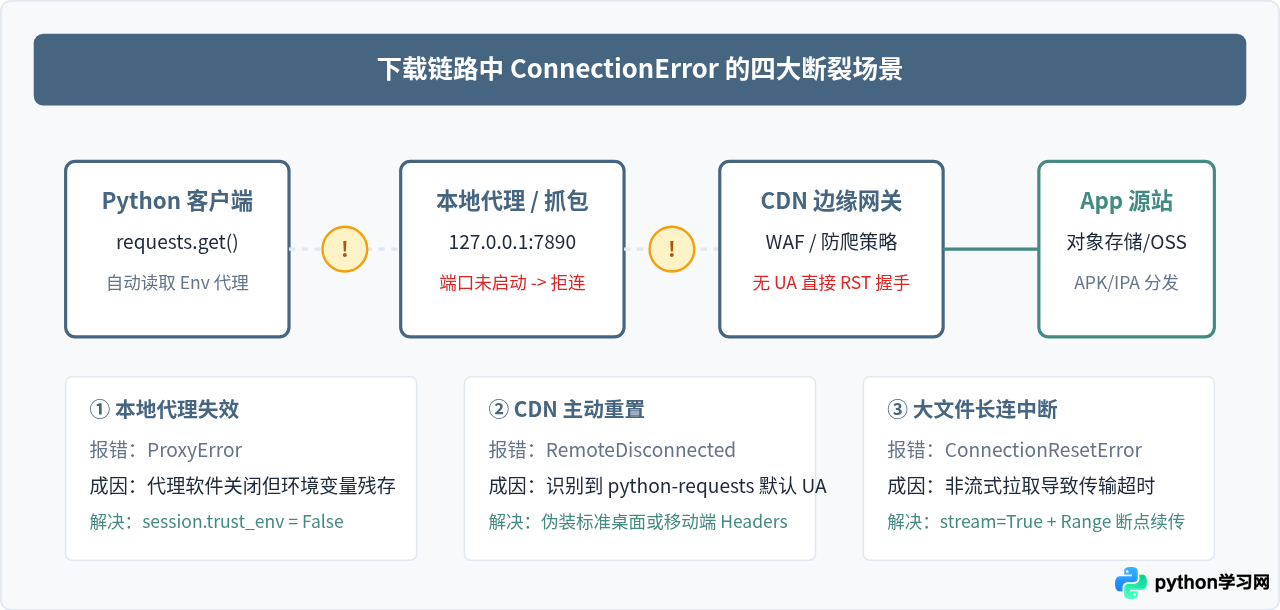
三、高频诱因二:目标源站反爬与缺失 User-Agent 阻断
requests 在发起请求时,如果不显式指定,其默认的 User-Agent 为形如 python-requests/2.31.0。
各大应用商店(如华为应用市场、小米应用商店、Google Play、酷安等)或提供 App 安装包下载的 CDN 边缘节点,通常挂载了防刷防护策略。当检测到非标准浏览器的客户端发来下载大文件的请求时,服务器端不会返回友好的 403 Forbidden,而是直接在 TCP 层面发送 RST 数据包重置连接,或者在握手完成后立刻断开。在 Python 端表现即为突发的 ConnectionError: ('Connection aborted.', RemoteDisconnected('Remote end closed connection without response'))。
User-Agent、Accept 以及合法的 Referer:
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "Connection": "keep-alive"
}
四、关键机制:必须启用流式传输(stream=True)
普通抓取网页文本时,使用 r = requests.get(url) 会在接收完服务器响应的全部字节后才返回响应对象。然而 App 安装包体积往往在几十 MB 到数 GB 不等。
如果直接调用不带 stream=True 的普通请求:
- Python 进程会尝试将上百兆的二进制流全部装入内存缓冲区;
- 下载期间操作系统套接字没有周期性的读取操作,极易触发服务端的空闲读写超时(Read Timeout);
- 一旦中间发生瞬间网络抖动,整个传输立刻崩溃,抛出
ConnectionError,且先前下载的数据无法保留。
正确规范:设置 stream=True,配合 iter_content(chunk_size=1024*1024) 分块边读边写入磁盘,既能维持极低的内存占用,又能保证 TCP 通道持续处于活动状态。
五、健壮工程方案:HTTPAdapter 自动重试与断点续传
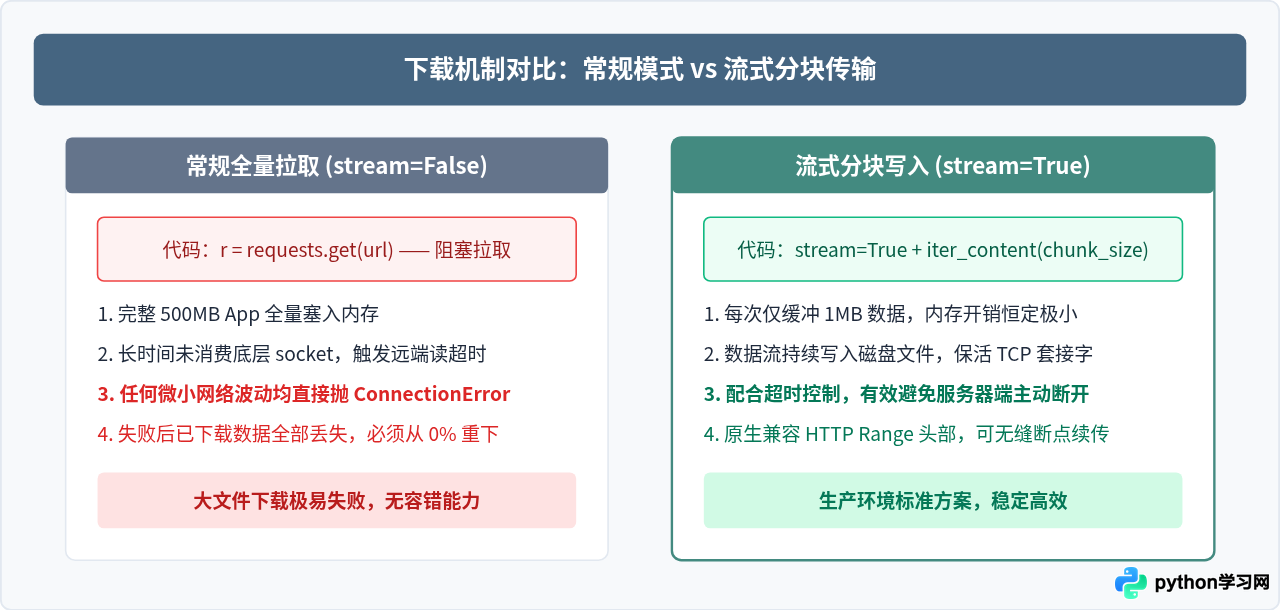
仅靠单次请求无法彻底抵御公网偶发的抖动。若要彻底根治下载 App 过程中的 ConnectionError,应在底层网络会话中加载带指数退避算法的重试适配器,并加入基于本地文件大小的 HTTP Range 断点续传机制。
1. 配置 Retry 适配器
通过 urllib3.util.retry.Retry,可以在底层套接字发生连接丢失或特定 HTTP 状态码(如 502、503、504)时,自动休眠并重试,对业务层完全透明:
from urllib3.util.retry import Retry
from requests.adapters import HTTPAdapter

retries = Retry(
    total=5,                        # 总重试次数
    backoff_factor=1,               # 指数退避间隔:1s, 2s, 4s, 8s...
    status_forcelist=[500, 502, 503, 504],
    raise_on_status=False
)
adapter = HTTPAdapter(max_retries=retries)
session = requests.Session()
session.mount("http://", adapter)
session.mount("https://", adapter)
2. 完整且可直接使用的下载实现
下面是一个工业级强度的 Python 3 App 下载函数,涵盖了请求头伪装、代理环境隔离、显式连接与读取超时控制、流式分块落盘,以及连接断开后的自动断点续传:
import os
import requests
from urllib3.util.retry import Retry
from requests.adapters import HTTPAdapter

def download_app(url: str, output_path: str, max_retries: int = 5):
    """
    具备抗 ConnectionError 能力的可靠 App 安装包下载函数
    """
    # 1. 初始化 Session 并规避环境变量中的废弃系统代理
    session = requests.Session()
    session.trust_env = False

    # 2. 挂载自动重试适配器
    retry_strategy = Retry(
        total=max_retries,
        backoff_factor=1.5,
        status_forcelist=[429, 500, 502, 503, 504],
        raise_on_status=False
    )
    adapter = HTTPAdapter(max_retries=retry_strategy)
    session.mount("http://", adapter)
    session.mount("https://", adapter)

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
        "Accept": "*/*"
    }

    # 3. 检查本地临时文件,计算已下载字节数(支持断点续传)
    downloaded_bytes = 0
    temp_path = output_path + ".downloading"
    if os.path.exists(temp_path):
        downloaded_bytes = os.path.getsize(temp_path)
        if downloaded_bytes > 0:
            headers["Range"] = f"bytes={downloaded_bytes}-"
            print(f"检测到未完成下载,尝试从 {downloaded_bytes} 字节处断点续传...")

    # 4. 设置分立超时时间:连接超时 10 秒,读取超时 60 秒
    timeouts = (10.0, 60.0)

    try:
        with session.get(url, headers=headers, stream=True, timeout=timeouts) as resp:
            # 处理 HTTP 416(Requested Range Not Satisfiable)通常说明文件已下完
            if resp.status_code == 416:
                if os.path.exists(temp_path):
                    os.replace(temp_path, output_path)
                    print("文件此前已完整下载。")
                    return True

            resp.raise_for_status()

            # 判断服务端是否支持断点续传(206 Partial Content 表示支持)
            file_mode = "ab" if resp.status_code == 206 else "wb"
            if file_mode == "wb":
                downloaded_bytes = 0  # 若服务器不支持 Range,则从头写入

            total_length = resp.headers.get("content-length")
            total_size = int(total_length) + downloaded_bytes if total_length else None

            # 5. 1MB 分块流式落盘
            chunk_size = 1024 * 1024
            with open(temp_path, file_mode) as f:
                for chunk in resp.iter_content(chunk_size=chunk_size):
                    if chunk:
                        f.write(chunk)
                        downloaded_bytes += len(chunk)

        # 6. 下载完整后原子重命名为目标文件名
        os.replace(temp_path, output_path)
        print(f"App 安装包下载完成: {output_path}")
        return True

    except requests.exceptions.ConnectionError as ce:
        print(f"发生连接中断: {ce}。已保存进度: {downloaded_bytes} 字节,可再次运行本函数继续下载。")
        return False
    except requests.exceptions.Timeout as te:
        print(f"传输超时: {te},网络拥堵或源站无响应。")
        return False
    finally:
        session.close()

if __name__ == "__main__":
    # 示例用法
    app_url = "https://example.com/packages/release.apk"
    target_file = "my_app.apk"
    download_app(app_url, target_file)
六、排查解决全景决策与常见疑问
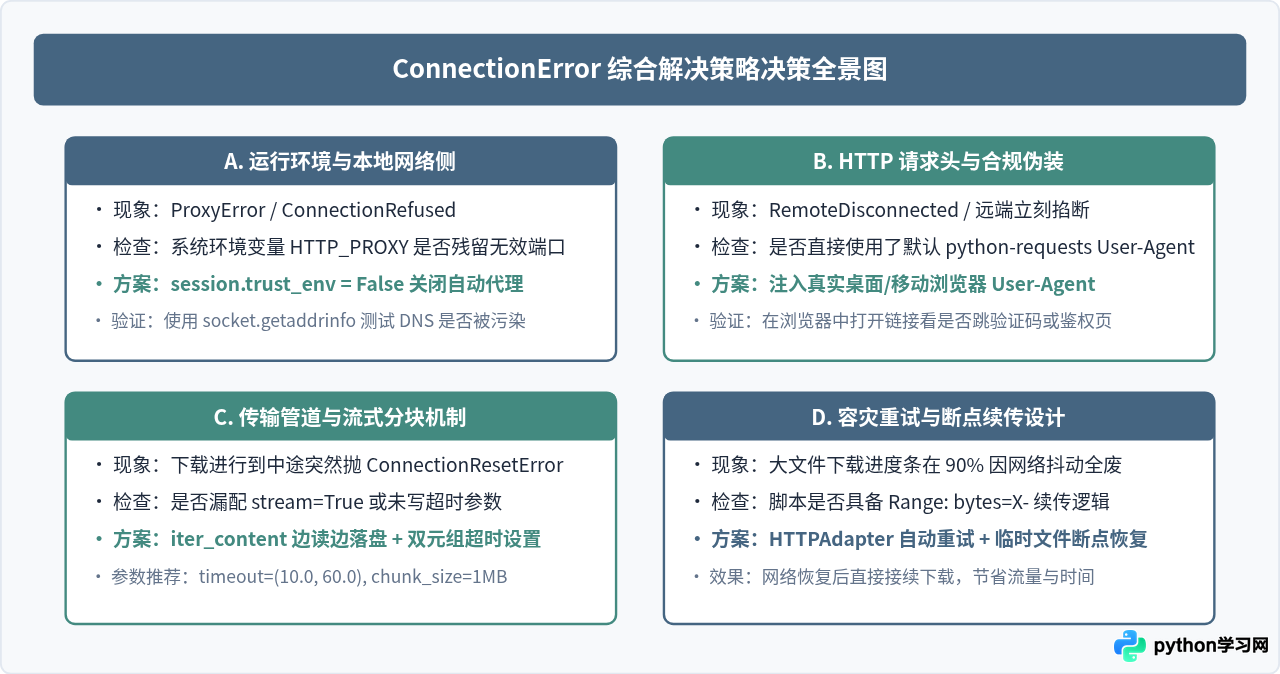
排查对照表
| 异常细分类别 | 典型错误特征 | 排查重点 | 对应解决手段 |
|---|---|---|---|
ProxyError |
Cannot connect to proxy | 本地抓包/VPN 软件残留的环境变量 | 设置 session.trust_env = False |
ConnectionRefusedError |
111 Connection refused | 目标主机端口未开放或路由不可达 | 校验下载链接真实性,测试端口连通性 |
RemoteDisconnected |
Remote end closed connection | 源站防爬策略封禁了默认 UA | 补充真实浏览器的 User-Agent 标头 |
ReadTimeout / RST |
Connection reset by peer | 大文件全量缓冲导致套接字超时 | 开启 stream=True 并配置 Range 续传 |
常见注意事项
- 不要使用
verify=False盲目忽略 SSL 证书:如果遇到证书校验报错,应先通过pip install --upgrade certifi更新本地根证书库,盲目关闭证书验证不仅存在安全隐患,还可能被目标 CDN 识别为不安全流量而进一步重置。 - 下载完成校验:对于 APK 或可执行安装包,下载完成后推荐配合
hashlib.md5或hashlib.sha256核对文件哈希,避免在弱网环境下写入了不完整文件。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















