


Python元组的创建、索引与切片操作指南
本指南系统讲解Python元组的创建方式、单元素元组陷阱、正向与反向索引规则、切片语法参数及边界控制,辅以工程规范与内存图示,助您掌握元组的核心操作。
一、元组的创建方式与语法特性
在 Python 中,元组是由逗号分隔的一组有序对象。许多初学者误以为圆括号是定义元组的决定性要素,但实际上,英文逗号才是构成元组语法的核心标志。
1. 字面量创建与单元素陷阱
创建多元组时,圆括号通常起到语法分组的作用。然而在定义仅含一个元素的元组时,如果遗漏尾部逗号,Python 解释器会将其视作普通的算术运算括号表达式,而非元组对象。
# 1. 多个元素的常规元组
server_info = ("192.168.1.100", 8080, "active")
print(type(server_info))

# 2. 单元素元组的正确与错误写法
not_a_tuple = (42)       # 仅为带括号的整数 int
real_tuple = (42,)       # 带有尾部逗号,判定为 tuple
print(type(not_a_tuple))
print(type(real_tuple))

# 3. 省略圆括号的元组打包(Tuple Packing)
coordinates = 10, 20
print(type(coordinates))empty_tup = () 创建。但只要元素数量为 1,就必须显式添加逗号 (element,),这是编写单元素参数传递与 SQL 占位符绑定时的高频易错点。
2. tuple() 工厂函数转换
当数据来源于其他可迭代对象(如列表、字符串、字典键或生成器)时,可以使用内置的 tuple() 构造函数进行强制转换。转换过程会固定当前元素序列,生成全新的不可变元组。
# 从列表转换
user_list = ["admin", "root", "guest"]
user_tuple = tuple(user_list)

# 从字符串转换(拆分为单字符序列)
char_tuple = tuple("DATA")

# 从字典转换(默认获取键集合)
status_map = {"code": 200, "status": "OK"}
key_tuple = tuple(status_map)

print("用户元组:", user_tuple)
print("字符元组:", char_tuple)
print("字典键元组:", key_tuple)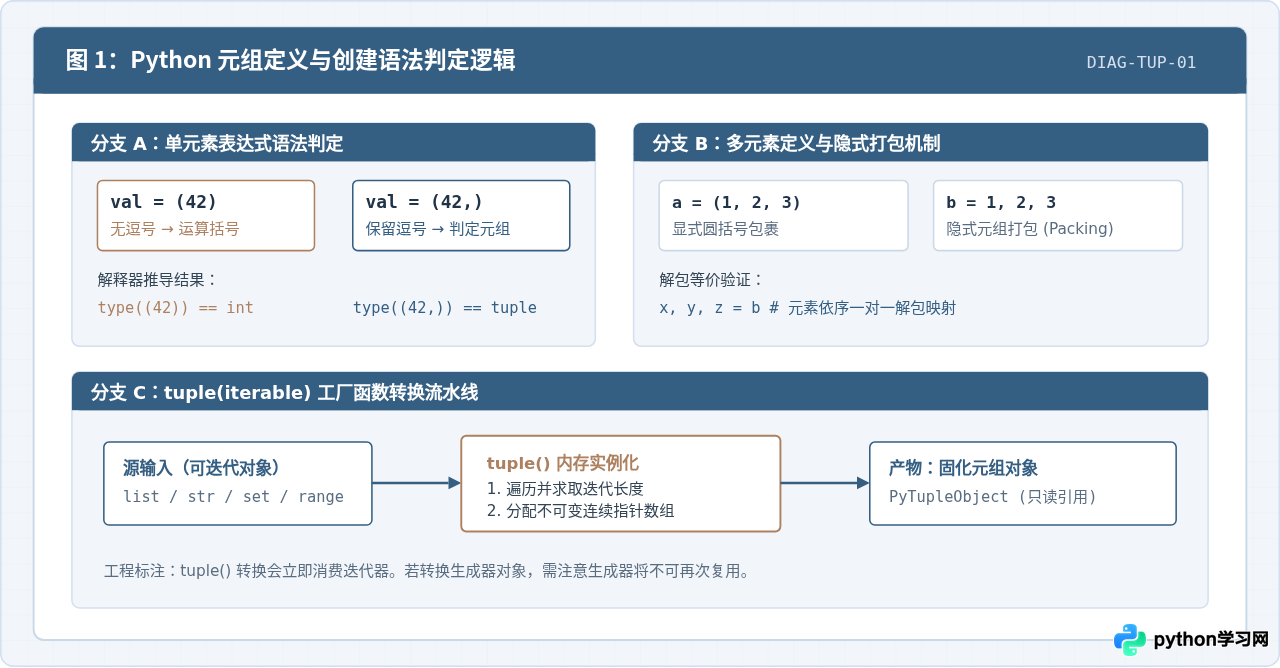
二、元素索引机制与底层内存引用
元组属于有序序列,其内部元素保持严格的物理相对顺序。Python 为元组提供了统一的双向索引坐标系:支持从左往右的正向索引,以及从右往左的负向索引。
1. 正向与反向索引映射
正向索引从 0 开始递增,最大有效索引为 len(tuple) - 1;反向索引从 -1 开始递减,对应序列的最后一个元素,递减至最左端首元素的 -len(tuple)。
# 定义包含不同类型数据的元组
cluster = ("node-a", "10.0.0.1", 9092, True, "Primary")

# 1. 正向索引访问(从 0 开始)
first_item = cluster[0]       # "node-a"
port = cluster[2]             # 9092

# 2. 负向索引访问(从 -1 开始)
role = cluster[-1]            # "Primary"
ip_addr = cluster[-4]         # "10.0.0.1"

print(f"节点名: {first_item}, 角色: {role}, 端口: {port}")2. 越界异常与不可变性本质
当访问的索引值超出有效坐标区间 [-len, len - 1] 时,Python 解释器会抛出 IndexError 异常。
此外必须明确,元组的不可变性是指“其所包含的引用地址不可变”,而非“引用所指向的对象值不可变”。如果元组内包含列表或字典等可变对象,元组固定的是该对象的内存指针;当该列表内部被修改时,元组自身结构并未破坏,但读取到的值会动态改变。
# 包含可变列表的元组
mixed_tuple = ("Config", [100, 200])

# 尝试直接修改元组的引用槽位 -> 触发 TypeError
try:
    mixed_tuple[0] = "NewConfig"
except TypeError as e:
    print("拦截到修改异常:", e)

# 修改槽位所指向列表内部的元素 -> 允许执行
mixed_tuple[1].append(300)
print("修改后的元组内容:", mixed_tuple)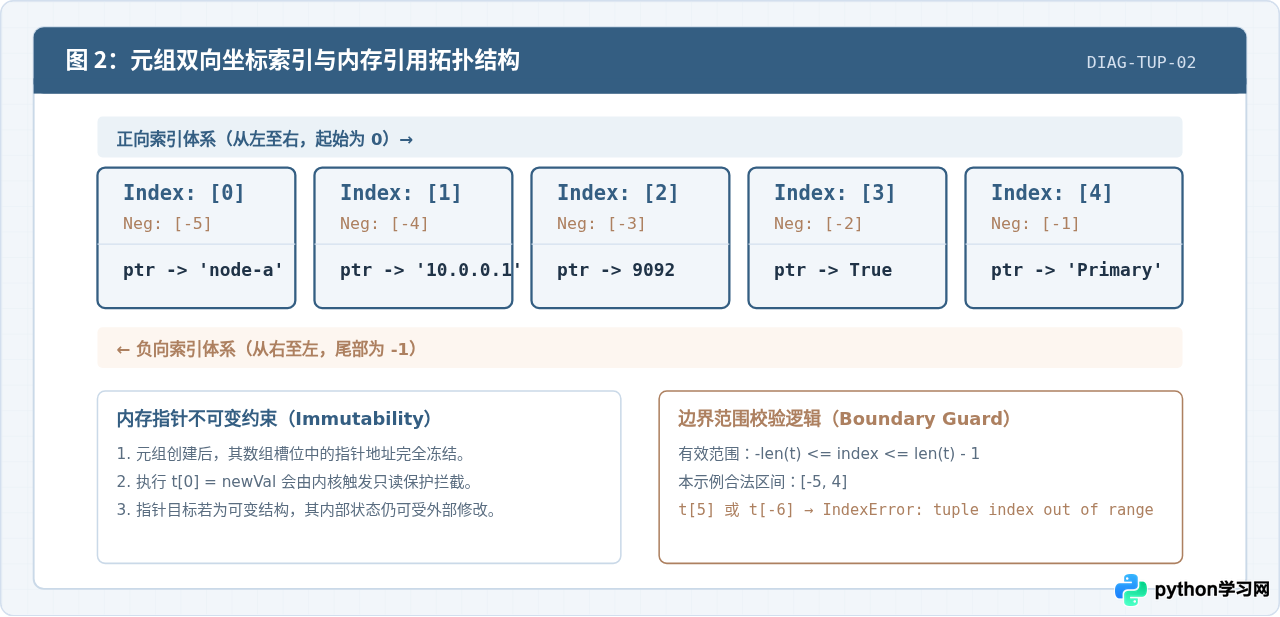
三、切片操作详解:语法规则与边界保护
切片(Slicing)是从元组中提取子序列的高频操作。其完整语法为 tuple[start:stop:step]。切片操作会生成一个全新的元组对象,包含提取到的元素引用,不会对原元组产生任何副作用。
1. 切片三要素与区间规则
- start(起始索引):切片开始的位置,包含该位置的元素。省略时,若 step > 0 则默认为 0;若 step < 0 则默认为 -1。
- stop(终止索引):切片结束的位置,不包含该位置的元素(即左闭右开区间
[start, stop))。省略时,默认延伸至对应方向的边界端点。 - step(步长与方向):每次位移的间隔及搜索方向。为正数时向右行进,为负数时向左行进。省略时默认为 1。
data = (10, 20, 30, 40, 50, 60, 70, 80)

# 1. 基础范围切片:左闭右开 [1:5] -> 索引 1, 2, 3, 4
sub_a = data[1:5]
print("data[1:5]:", sub_a)

# 2. 省略边界:从起点到索引 3、从索引 4 到末尾
sub_start = data[:4]
sub_end = data[4:]
print("前4项:", sub_start)
print("后4项:", sub_end)

# 3. 指定正步长:隔位采样
step_two = data[::2]
print("隔项采样 (step=2):", step_two)

# 4. 负步长与反转:逆序切片
reversed_tup = data[::-1]
print("反转元组 (step=-1):", reversed_tup)

# 5. 负步长指定区间:注意 start 必须在 stop 右侧
sub_rev = data[6:2:-1]  # 提取索引 6, 5, 4, 3
print("区间逆序 data[6:2:-1]:", sub_rev)2. 切片越界的容错机制
与单一索引访问(t[index] 超出范围直接抛出 IndexError)截然不同,Python 切片操作具有自动边界截断机制。无论 start 或 stop 设定的数值多大,Python 均会自动将其裁剪到有效边界内,绝不抛出异常;若区间内不存在任何元素,则安全返回空元组 ()。
numbers = (1, 2, 3)

# 远超边界的切片不会崩溃
print("超出右界切片:", numbers[1:100])
print("无效区间切片:", numbers[5:10])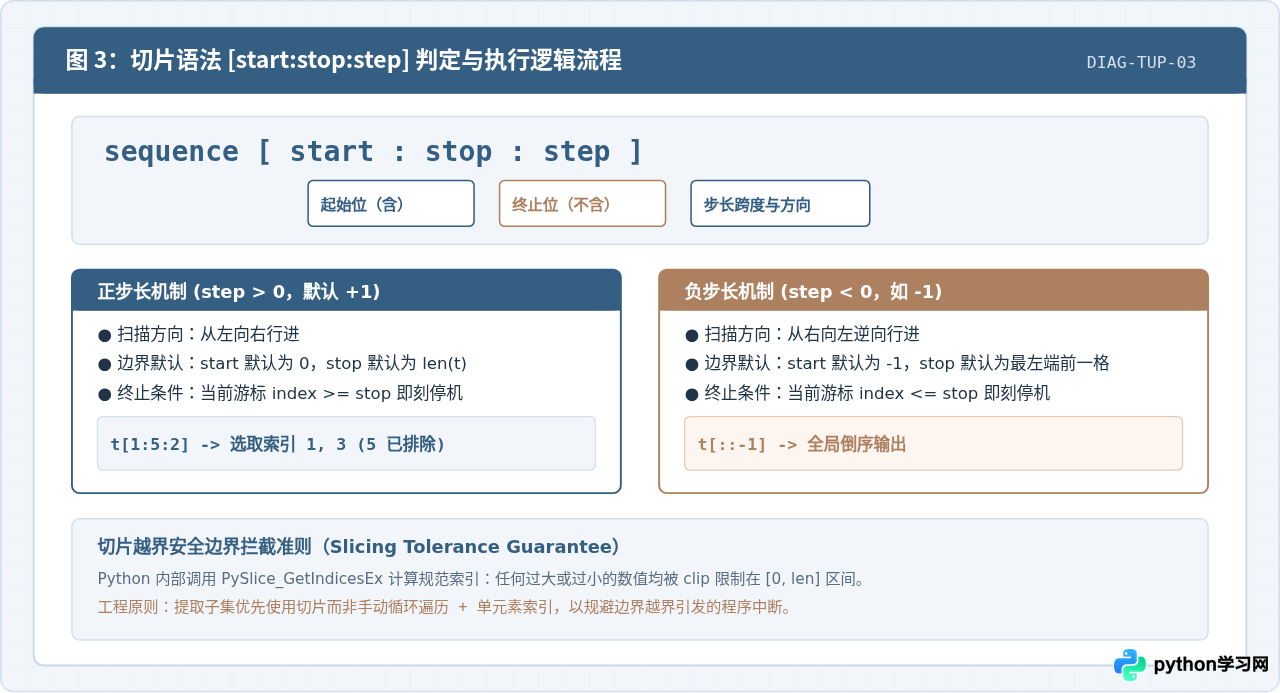
四、元组不可变性与列表选型对比
在实际 Python 开发中,理解何时选用元组、何时选用列表是编写高质量代码的基础。
| 对比维度 | 元组(tuple) | 列表(list) | 工程决策建议 |
|---|---|---|---|
| 可变性 | 不可变(Immutable) | 可变(Mutable) | 固定配置项、函数返回值选用元组;动态收集池选用列表 |
| 内存开销 | 更小(无多余预分配缓冲空间) | 较大(预留过度分配缓冲槽) | 大规模只读数据集选用元组可节约显著内存 |
| 字典键与集合 | 支持(仅当所有子元素均为可哈希对象时) | 不支持(不可哈希,触发 TypeError) | 多维度复合查询键必须采用元组封装 |
| 初始化性能 | 较快(底层常量直接缓存重用) | 略慢(每次动态分配堆内存) | 高频只读常量建议声明为元组 |
五、常见问题排查与工程实践全景总结
1. 常见报错与排查清单
- TypeError: 'tuple' object does not support item assignment:尝试直接通过下标修改元组元素。若确实需要更新,应转为列表修改后再转换回元组,或重新构造新元组。
- IndexError: tuple index out of range:单元素索引超出了合法区间。排查时应先用
len(t)校验长度,或改用切片语法提供安全降级。 - ValueError: too many values to unpack / not enough values to unpack:元组解包时左侧变量数量与右侧元组元素数量不匹配。可采用
first, *middle, last = data的星号解包语法吸收多余项。
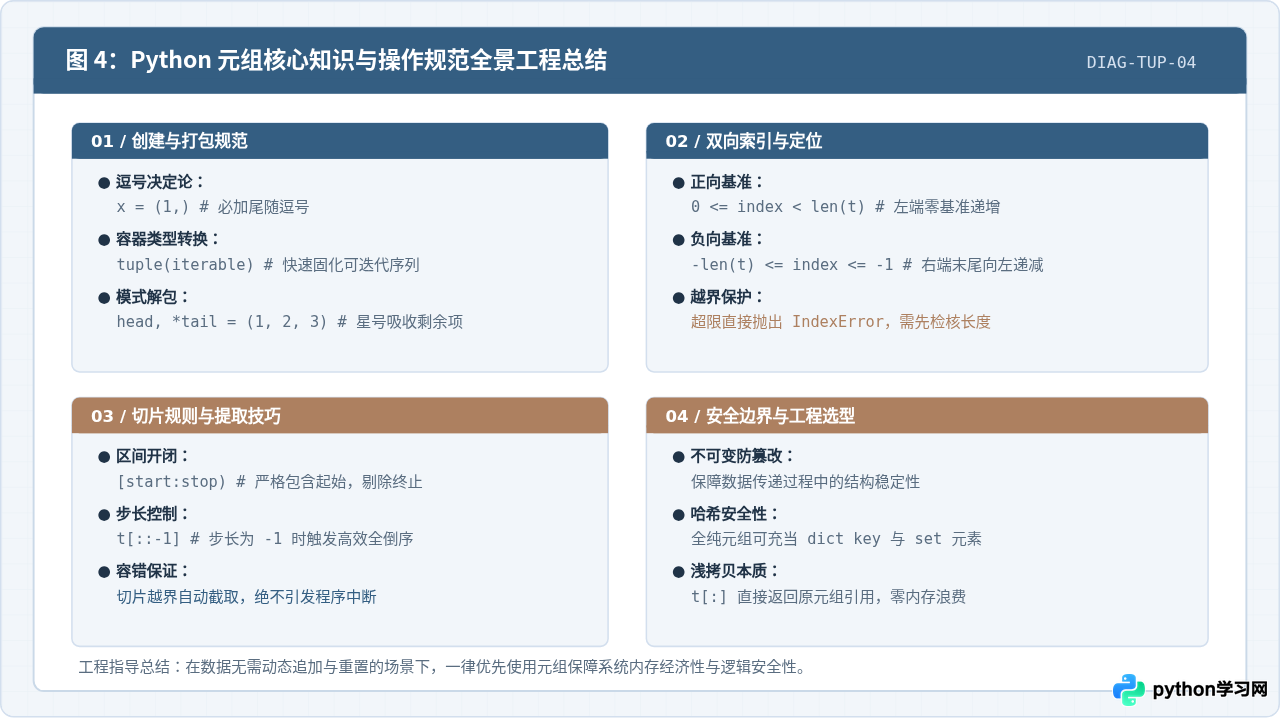
通过遵循本文介绍的单元素逗号定义规范、双向索引映射坐标系以及步长切片边界保护,开发者能够在日常业务逻辑与底层组件开发中更严谨地设计数据管道,避免常见的索引越界与意外篡改隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















