


Python元组怎么创建、索引和切片
深入浅出讲解Python元组的创建方法、正负索引规则与切片截取技巧,结合语法要点、内存结构原理与完整代码示例,助你扎实掌握元组核心操作。
一、认识元组的核心特性
在 Python 中,元组使用逗号或圆括号来组织数据。一旦元组被创建,其内部的元素数量和各位置的引用就不能被修改、添加或删除。这种只读约束带来了三大核心优势:
- 数据安全性:将配置项、函数固定参数或系统只读状态放入元组中,能够有效防止程序在复杂调用链路中被意外篡改。
- 支持哈希(Hashable):纯只读元素构成的元组可以作为字典(dict)的键或集合(set)的成员,而可变的列表则无法实现这一特性。
- 轻量与性能:由于长度与内存布局固定,Python 内部对元组做了更优的内存分配与缓存回收处理,创建与迭代速度通常优于列表。
二、Python 元组的创建方式
创建元组看似只需一对圆括号,但在实际编写时,逗号的存在与否才是决定数据类型的本质标志。我们梳理了以下四种常见的创建方式。
1. 常规圆括号创建
直接在圆括号 () 中放入用逗号隔开的元素,这是最直观且最符合阅读习惯的书写方式:
# 创建包含整数、浮点数、字符串的混合元组
person = ("Alice", 28, "Engineer", 95.5)
print(person)        # 输出: ('Alice', 28, 'Engineer', 95.5)
print(type(person))  # 输出: <class 'tuple'>
2. 单元素元组的“逗号陷阱”
这是初学者最容易踩中的语法坑点。如果在圆括号内只写一个元素而没有末尾逗号,Python 会将其判定为数学运算中的优先级括号,而不是元组构造:
# 错误写法:缺少逗号,类型为 int
not_a_tuple = (42)
print(type(not_a_tuple))  # 输出: <class 'int'>

# 正确写法:在元素后补充逗号
single_tuple = (42,)
print(type(single_tuple)) # 输出: <class 'tuple'>
3. 省略括号的元组打包(Tuple Packing)
在 Python 中,只要有一连串用逗号隔开的值,即便没有任何括号,Python 也会默认将其打包为元组:
# 省略括号的逗号打包
coordinates = 120.15, 30.28
print(coordinates)        # 输出: (120.15, 30.28)
print(type(coordinates))  # 输出: <class 'tuple'>
4. 空元组与工厂函数 tuple()
当需要初始化一个空的不可变容器,或者将现有的列表、字符串、range 等可迭代对象转为元组时,可以使用工厂函数 tuple():
empty_a = ()              # 字面量创建空元组
empty_b = tuple()         # 工厂函数创建空元组

# 将列表转换为元组
num_list = [1, 2, 3, 4]
num_tuple = tuple(num_list)
print(num_tuple)          # 输出: (1, 2, 3, 4)

# 将字符串拆解为字符元组
char_tuple = tuple("Python")
print(char_tuple)         # 输出: ('P', 'y', 't', 'h', 'o', 'n')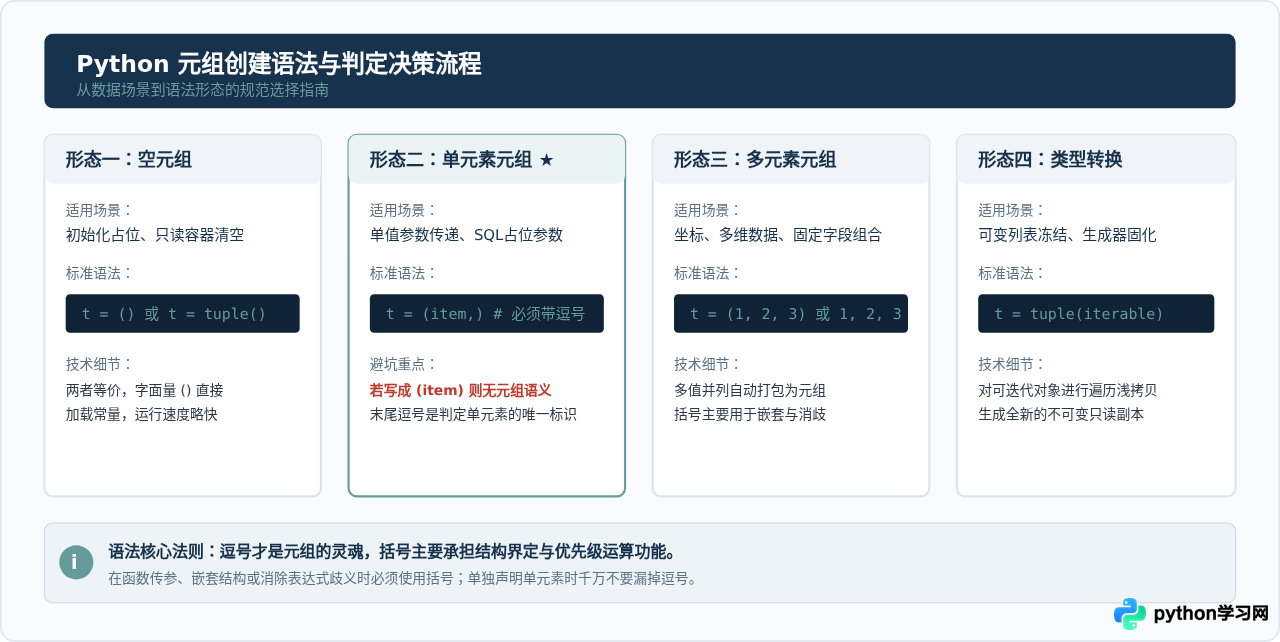
三、元组的索引访问规则
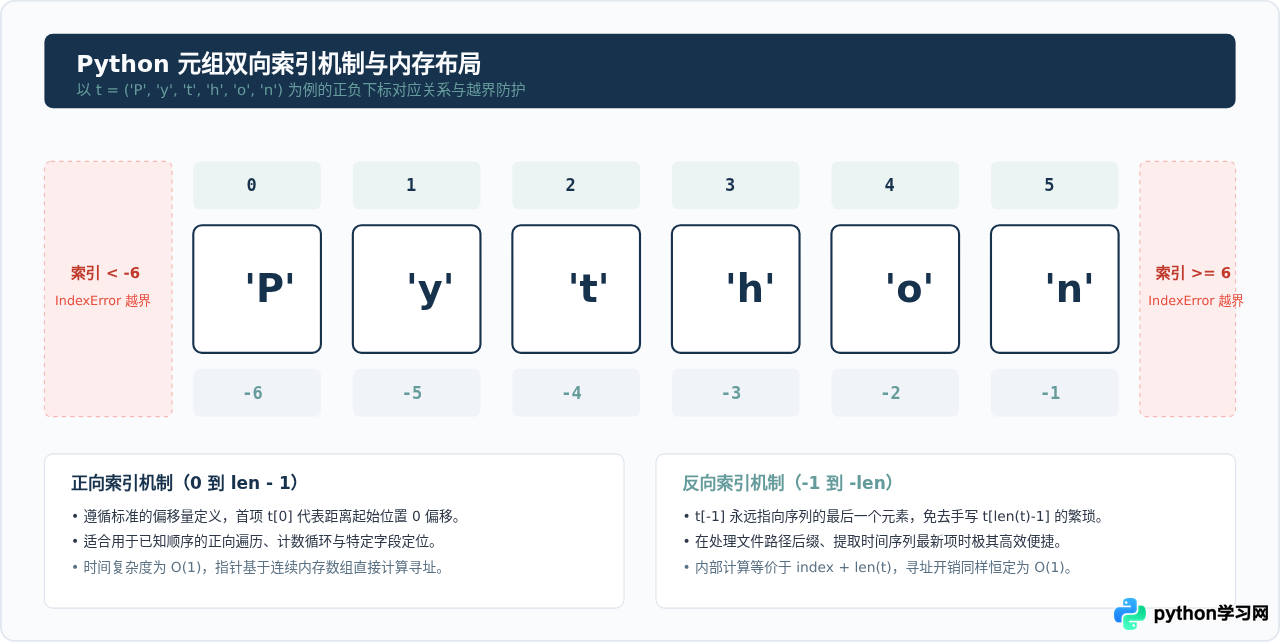
元组属于有序序列,其内部每个元素都拥有固定的位置编号。Python 提供了两套无缝兼容的索引寻址机制:正向索引与反向索引。
1. 正向索引与反向索引
假设我们定义一个元组 t = ('P', 'y', 't', 'h', 'o', 'n'):
- 正向索引(从 0 开始):自左向右从 0 编号递增。首个元素为
t[0](值为'P'),最后一个元素为t[5](值为'n')。 - 反向索引(从 -1 开始):自右向左从 -1 编号递减。末尾元素为
t[-1](值为'n'),首个元素为t[-6](值为'P')。
letters = ('P', 'y', 't', 'h', 'o', 'n')

# 正向索引访问
print(letters[0])   # 输出: P
print(letters[3])   # 输出: h

# 反向索引访问
print(letters[-1])  # 输出: n (倒数第一个)
print(letters[-2])  # 输出: o (倒数第二个)
2. 边界检查与 IndexError 异常
索引访问要求指定的下标必须在元组的合法范围内。如果指定的索引超出界限,Python 会立即抛出 IndexError:
letters = ('P', 'y', 't', 'h', 'o', 'n')
# 元组长度为 6,合法正向索引为 0~5,反向索引为 -6~-1

# 超出范围将报错
print(letters[6])   # 抛出 IndexError: tuple index out of range
print(letters[-7]) # 抛出 IndexError: tuple index out of range在不确定元组长度时,直接访问下标是不安全的。建议在索引前通过 len(t) 进行长度校验,或使用条件表达式:val = t[0] if t else default_val。
四、元组切片语法与截取技巧
如果说索引是为了提取单个元素,那么切片(Slicing)就是为了从元组中批量截取一段子序列。切片不仅语法灵活,而且具有出色的安全性。
1. 切片的核心语法
切片的基本语法结构为:
tuple_name[start:stop:step]这三个参数全部为可选参数,由冒号 : 进行分隔:
start:起始索引(包含该位置,即闭区间)。若省略,正向步长默认从 0 开始。stop:结束索引(不包含该位置,即开区间)。若省略,默认截取到序列末尾。step:步长与提取方向。默认为 1;当为正数时正向步进,当为负数时反向步进。
2. 常见切片模式实战
以元组 numbers = (0, 1, 2, 3, 4, 5, 6, 7, 8, 9) 为例:
numbers = (0, 1, 2, 3, 4, 5, 6, 7, 8, 9)

# 1. 基础区间切片:提取索引 2 到 5(包含 2,不包含 6)
print(numbers[2:6])    # 输出: (2, 3, 4, 5)

# 2. 省略起始位置:从头截取前 4 个元素
print(numbers[:4])     # 输出: (0, 1, 2, 3)

# 3. 省略结束位置:从索引 6 一直截取到末尾
print(numbers[6:])     # 输出: (6, 7, 8, 9)

# 4. 指定步长:每隔一个取一个元素
print(numbers[::2])    # 输出: (0, 2, 4, 6, 8)

# 5. 反向步长:完整逆序反转元组
print(numbers[::-1])   # 输出: (9, 8, 7, 6, 5, 4, 3, 2, 1, 0)

# 6. 全切片复制:创建一份全新的浅拷贝
copy_numbers = numbers[:]
print(copy_numbers)    # 输出: (0, 1, 2, 3, 4, 5, 6, 7, 8, 9)
3. 切片的自动截断机制(永不报错)
与单元素索引越界立即抛出 IndexError 不同,切片操作对越界具有极高的容错性。如果 stop 超过了元组长度,或者 start 超出了有效范围,Python 会自动将其截断到有效边界,而不会抛出异常:
data = (10, 20, 30)

# 切片超出实际长度,自动截断到边界
print(data[1:100])     # 输出: (20, 30)

# 起始位置直接超出范围,返回空元组
print(data[10:20])     # 输出: ()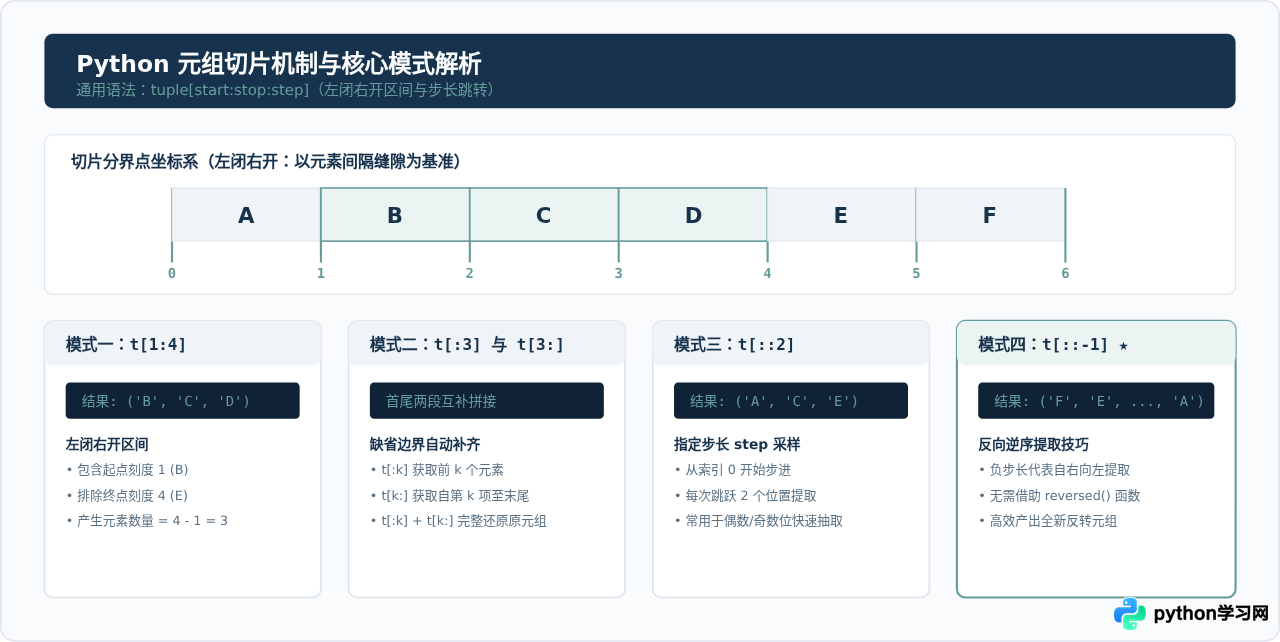
五、进阶特性与高频避坑指南
1. 不可变性的深度理解:包含可变对象的元组
元组的“不可变”指的是其内部各槽位保存的内存引用不可变更。如果元组中某个元素本身是可变容器(例如列表 list),那么该列表内部的内容是可以被增删改查的:
# 包含可变列表的元组
mixed_tuple = ("Python", [10, 20])

# 试图修改元组的引用:报错!
try:
    mixed_tuple[1] = [30, 40]
except TypeError as e:
    print(e)  # 输出: 'tuple' object does not support item assignment

# 修改列表内部元素:完全允许!
mixed_tuple[1].append(30)
print(mixed_tuple) # 输出: ('Python', [10, 20, 30])如果需要构建完全不可变且可安全作为字典键的嵌套数据结构,请确保元组内的所有子元素也均为不可变类型(如纯数字、字符串或其他元组),避免嵌套列表或字典。
2. 元组解包(Tuple Unpacking)与星号表达式
在实际开发中,提取元组数据往往不只依赖单一索引或切片,更常用且优美的方式是解包操作:
point = (100, 200)
x, y = point
print(f"x={x}, y={y}")  # 输出: x=100, y=200

# 配合星号 * 提取头部、中间切片和尾部元素
scores = (98, 85, 92, 78, 90, 88)
highest, *middle, lowest = sorted(scores)
print(highest)  # 输出最高分: 78 (升序排列后首项)
print(middle)   # 中间切片列表: [85, 88, 90, 92]
print(lowest)   # 输出最高分: 98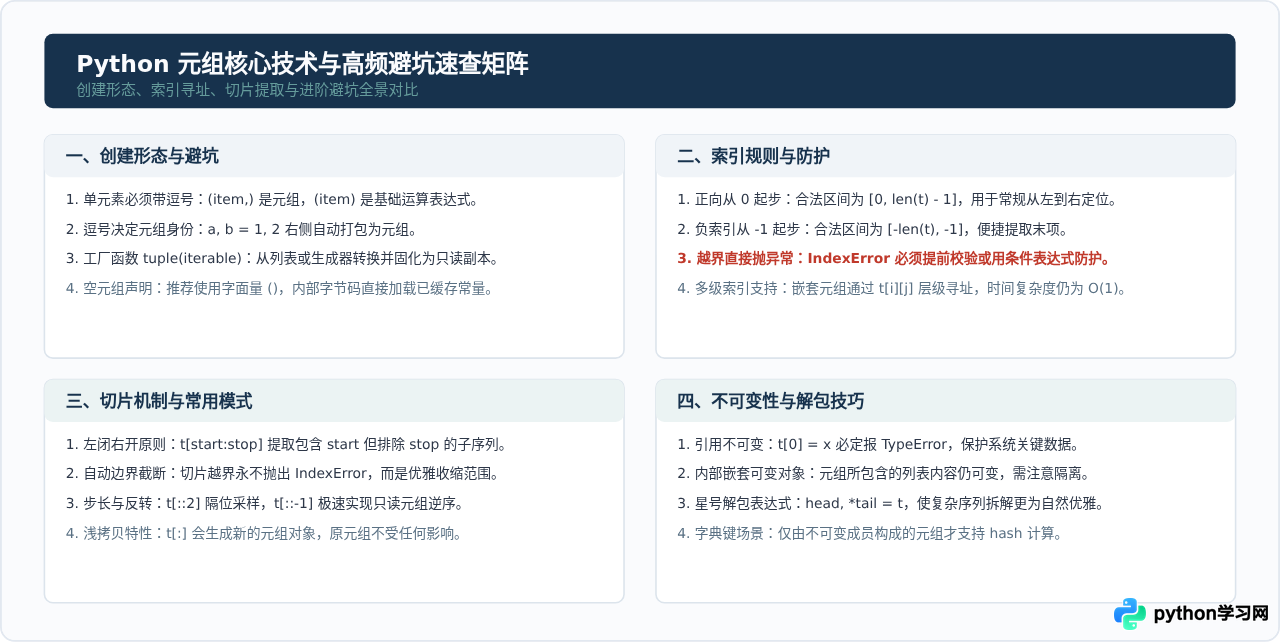
六、总结与核心用法速查表
| 操作分类 | 代码示例 | 输出/效果 | 关键注意点 |
|---|---|---|---|
| 单元素元组创建 | t = ("apple",) |
('apple',) |
末尾逗号必不可少,否则沦为字符串 |
| 类型转换创建 | t = tuple([1, 2, 3]) |
(1, 2, 3) |
生成不可修改的只读新元组 |
| 正向单点索引 | t[0] |
获取第一个元素 | 范围必须满足 0 <= index < len(t) |
| 末位反向索引 | t[-1] |
获取最后一个元素 | 快速读取末尾,避免手写 len(t) - 1 |
| 左闭右开切片 | t[1:3] |
提取索引 1 和 2 的元素 | 不包含右边界 3,产生新元组 |
| 逆序切片 | t[::-1] |
反向完整提取整个元组 | 纯切片反转,执行性能优异 |
| 星号拆分解包 | first, *rest = t |
first 单值,rest 列表 |
优雅替代繁琐的连续切片操作 |
通过合理结合元组的不可变安全机制、快速定位的正负索引以及弹性强大的切片语法,不仅能够让数据传递逻辑更加清晰、防范意外修改,还能显著提高代码的运行稳定性与执行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















