


Python re.match获取groups后怎么手动重组顺序

详细讲解在 Python 中使用 re.match 匹配成功并获取 groups 元组后,如何通过变量解构、索引映射、格式化模板以及命名分组等方式手动重组字段顺序,并深入分析索引偏移与常见避坑要点。
在 Python 正则表达式处理中,使用 re.match() 匹配成功后,调用 match.groups() 会按正则表达式中圆括号的先后顺序返回一个包含所有捕获组的不可变元组(Tuple)。当需要将这些捕获结果按照业务所需的全新次序输出时,直接通过原元组无法就地修改。核心解决方法主要有三类:最直观的变量解构赋值(如 year, month, day = match.groups() 后自由组装)、适合配置化与批量处理的索引映射列表推导(如 [g[i] for i in order]),以及免临时变量的位置占位符格式化(如 "{2}-{0}-{1}".format(*match.groups()))。本文将系统讲解这几种重组方式的具体实现、适用场景与关键避坑要点。
一、理解 match.groups() 的结构与索引规则
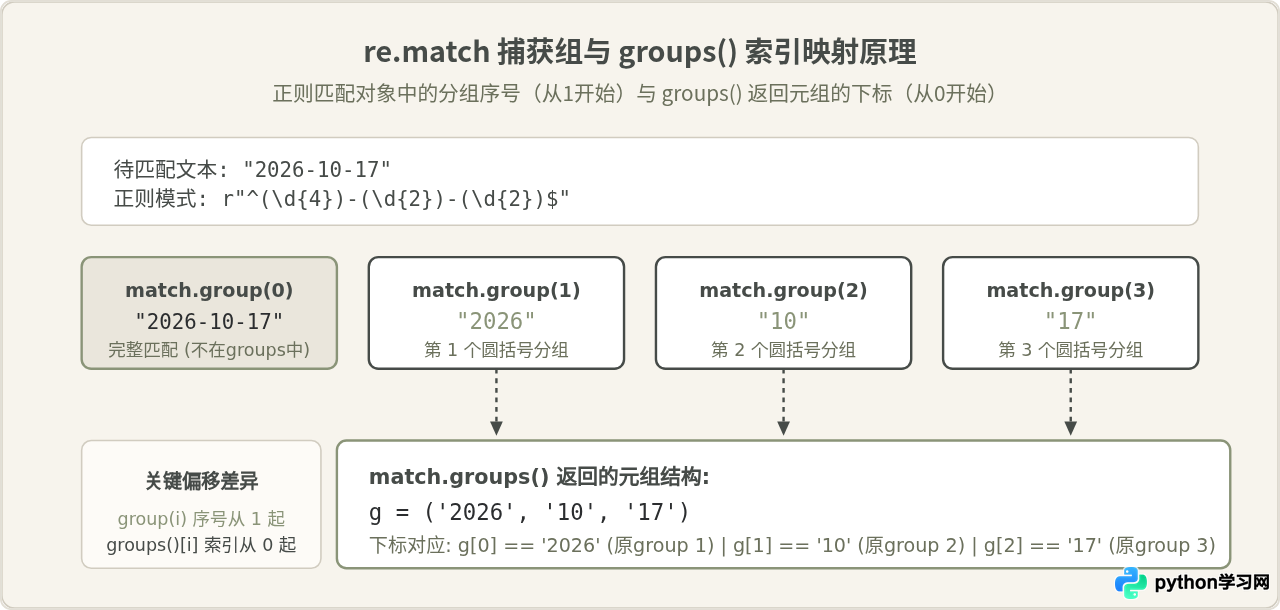
在编写重组逻辑前,必须明确 re.match() 生成的匹配对象与元组下标之间的对应关系。正则表达式内部对捕获组的编号是从 1 开始的,例如 match.group(1) 代表第一个括号捕获的内容,而 match.group(0) 始终代表整个匹配到的完整字符串。
然而,调用 match.groups() 时,返回的是仅包含子捕获组的 Python 标准元组。Python 容器的索引下标严格从 0 开始。因此,正则表达式中的第 1 个捕获组,在 match.groups() 所返回的元组中对应的下标是 0;第 2 个捕获组对应下标 1,以此类推。
二、手动重组的基本操作流程
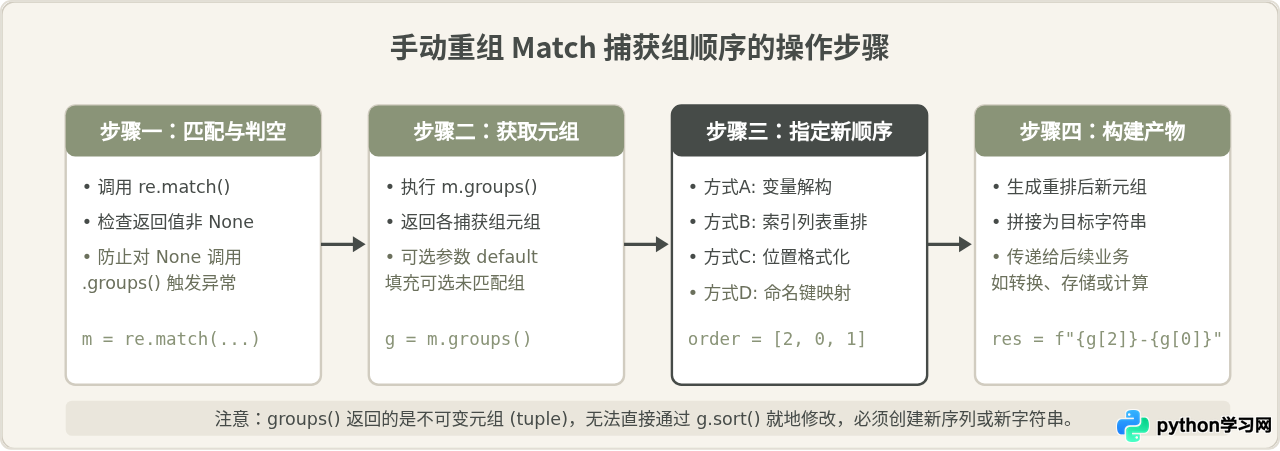
在实际代码中,完成一次安全的分组提取与顺序重组,通常遵循固定的四个操作步骤。严谨的判空与类型处理是防止运行时崩溃的前提。
三、具体重组实现方式与代码示例
假设我们有一串表示日期的输入字符串 "2026-10-17",正则表达式将其依次划分为年、月、日三个捕获组。现在的目标是将顺序调整为 "日/月/年" 即 "17/10/2026"。针对该需求,可以使用以下几种典型方法。
1. 变量解构赋值(推荐用于字段明确场景)
如果捕获组数量固定且语义明确,直接使用元组解构赋值是最清晰、最具可读性的方式:
import re

text = "2026-10-17"
pattern = r"^(\d{4})-(\d{2})-(\d{2})$"
match = re.match(pattern, text)

if match:
    # 按照正则捕获顺序解构到具备明确含义的局部变量
    year, month, day = match.groups()

    # 按照新顺序重新组合
    reordered_str = f"{day}/{month}/{year}"
    reordered_tuple = (day, month, year)

    print("重组字符串示例:", reordered_str)
    print("重组元组示例:", reordered_tuple)
示例输出:
重组字符串示例: 17/10/2026
重组元组示例: ('17', '10', '2026')
这种做法不仅语法简洁,而且在重组前若需要针对特定字段进行数值转换(例如 int(day))或格式校验,处理起来非常自然。
2. 索引列表重排(推荐用于多字段或动态重组)
当正则捕获的组较多,或者重组规则来自外部配置(例如用户自定义的列排序列表)时,手动解构容易书写冗长。此时可以用目标索引列表配合列表推导式:
import re

text = "2026-10-17"
pattern = r"^(\d{4})-(\d{2})-(\d{2})$"
match = re.match(pattern, text)

if match:
    groups = match.groups()  # ('2026', '10', '17')

    # 目标顺序:原下标 2 (日), 原下标 1 (月), 原下标 0 (年)
    target_order = [2, 1, 0]

    # 使用列表推导式提取并重排
    reordered_list = [groups[i] for i in target_order]
    reordered_str = "/".join(reordered_list)

    print("列表推导重组示例:", reordered_str)
示例输出:
列表推导重组示例: 17/10/2026此外,还可以使用 Python 标准库中的 operator.itemgetter,其语法更为紧凑:
from operator import itemgetter

# itemgetter(2, 1, 0) 会直接返回由对应元素构成的元组
reorder = itemgetter(2, 1, 0)
reordered_tuple = reorder(match.groups())
print("itemgetter 重组示例:", reordered_tuple)
3. 位置占位符格式化(适合直接生成字符串)
如果最终目的只是拼接成新的字符串,而不需要在内存中保留重排后的元组或中间变量,可以使用字符串的 format() 方法,并利用 * 参数解包:
import re

text = "2026-10-17"
pattern = r"^(\d{4})-(\d{2})-(\d{2})$"
match = re.match(pattern, text)

if match:
    # {2} 代表第 3 个参数(即日),{1} 为月,{0} 为年
    reordered_str = "{2}/{1}/{0}".format(*match.groups())
    print("format 占位重组示例:", reordered_str)
示例输出:
format 占位重组示例: 17/10/20264. 命名捕获组与字典重组(推荐用于长期维护的复杂正则)
数字索引容易在后续修改正则表达式(例如中间插入新括号)时引起错位。如果在正则中使用 (?P<name>...) 定义命名捕获组,随后调用 match.groupdict(),就可以通过语义键名重新构建输出:
import re

text = "2026-10-17"
pattern = r"^(?P\d{4})-(?P\d{2})-(?P\d{2})$"
match = re.match(pattern, text)

if match:
    data = match.groupdict()
    # 按照语义键重排
    reordered_str = f"{data['day']}/{data['month']}/{data['year']}"
    print("命名分组重组示例:", reordered_str)
四、各重组方案特性与对比
不同的重组方式在代码可读性、执行开销以及对业务变动的抵御能力上存在差异。下面的图示与对比表概括了这三种基础方案的核心特征。
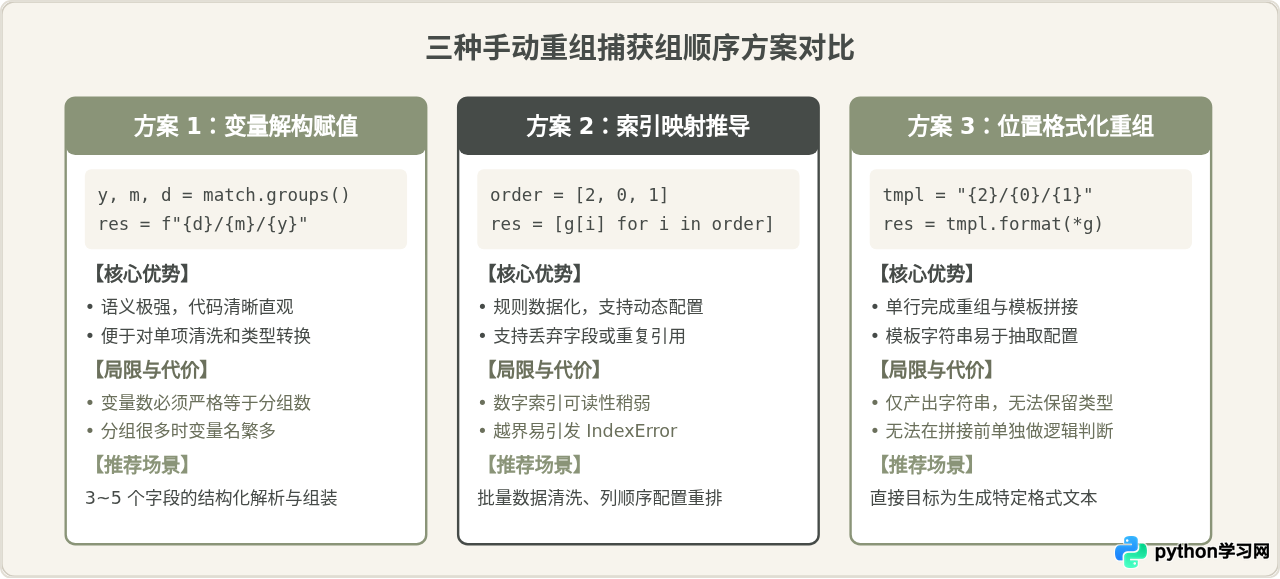
| 重组方案 | 核心代码形式 | 输出产物类型 | 适用场景 |
|---|---|---|---|
| 解构赋值 | y, m, d = match.groups() |
独立变量 / 新元组 / 新文本 | 字段少(2~5个)、语义固定、后续需要清洗或转换数据类型 |
| 索引推导 | [g[i] for i in [2, 0, 1]] |
新列表 (list) 或新元组 (tuple) | 重排规则由外部配置决定、分组较多、需要批量处理表格列 |
| 格式化占位 | "{2}/{0}/{1}".format(*g) |
纯字符串 (str) | 纯文本展示转换,无需对单个字段执行中间运算 |
| 命名组字典 | d = match.groupdict() |
字典键访问 / 结构化对象 | 大型项目、长期维护且正则表达式经常扩展或调整的模块 |
五、常见认知误区与注意事项
在处理 groups() 重组时,有几个容易让人产生混淆或写出隐患代码的细节,需要特别注意:
误区一:混淆 re.sub 与 match.groups() 的适用边界
一种常见的说法是:“既然只是重组文本顺序,直接用 re.sub(r'(\d{4})-(\d{2})-(\d{2})', r'\3/\2/\1', text) 一行搞定,为什么还要手动取 groups()?”
这种说法在其适用的前提下是完全成立的——如果你的唯一需求是直接对全文做正则替换且不需要对子串做任何验证或计算,re.sub 确实更简洁。但当遇到以下情况时,必须使用 re.match().groups() 手动重组:
- 需要转换类型或计算:例如提取出月份后,需要将字符串
"10"转换为整型并判断是否在 1~12 范围内,或者将英文月份转换为数字。 - 下游并非输出字符串:例如需要将重排后的元组直接存入数据库参数列表(如
cursor.execute(sql, reordered_tuple))。 - 复杂的条件分支:例如某个字段值决定了后续采用何种组装规则,这在简单的静态替换模式串中无法直接完成。
误区二:误以为 groups() 允许就地修改或排序
部分初学者会尝试直接调用 groups.sort() 或赋值 groups[0] = ...,这会直接抛出 TypeError: 'tuple' object does not support item assignment。groups() 返回的是不可变元组,所有“重排”操作本质上都是基于原元素创建新容器或新对象,绝非在原元组上做就地变更。
误区三:忽略可选分组返回的 None
如果正则中包含可选分组(例如使用 ?),当该分组未匹配到内容时,match.groups() 对应的位置会填充 None 而不是空字符串:
import re

pattern = r"^(\d{4})(-(\d{2}))?$"
m = re.match(pattern, "2026")

if m:
    print(m.groups())  # 输出: ('2026', None, None)
此时如果直接使用 "".join(...) 或未加判断的字符串格式化,可能会输出 "None" 文本或引发异常。可以通过 match.groups(default="") 指定未匹配分组的默认值:
# 指定未匹配项填充为空字符串 ""
safe_groups = m.groups(default="")
print(safe_groups)  # 输出: ('2026', '', '')
六、选型与决策总结
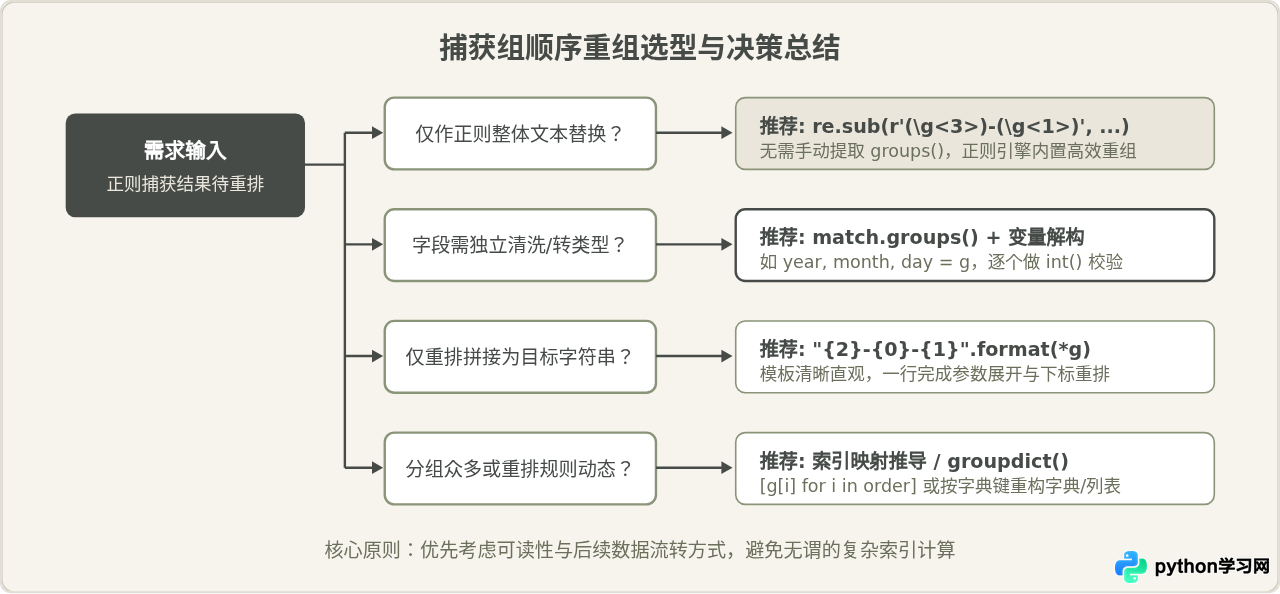
综上所述,Python 中获取 re.match().groups() 后的顺序重组并不存在单一的最佳答案,而是取决于后续数据流向:对于少数固定字段,变量解构赋值是最自然且利于维护的选择;对于纯文本格式的调整,格式化占位符或正则内置的 re.sub 效率更高;而在处理动态规则与数据表列重排时,索引映射推导则具备最高的灵活性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















