


Docker执行python脚本中文乱码Locale问题
深入解析在 Docker 容器中执行 Python 脚本出现中文乱码或 UnicodeEncodeError 的根源,提供从环境变量配置、基础镜像 Locale 生成到代码层规范的完整解决步骤与验证方案。
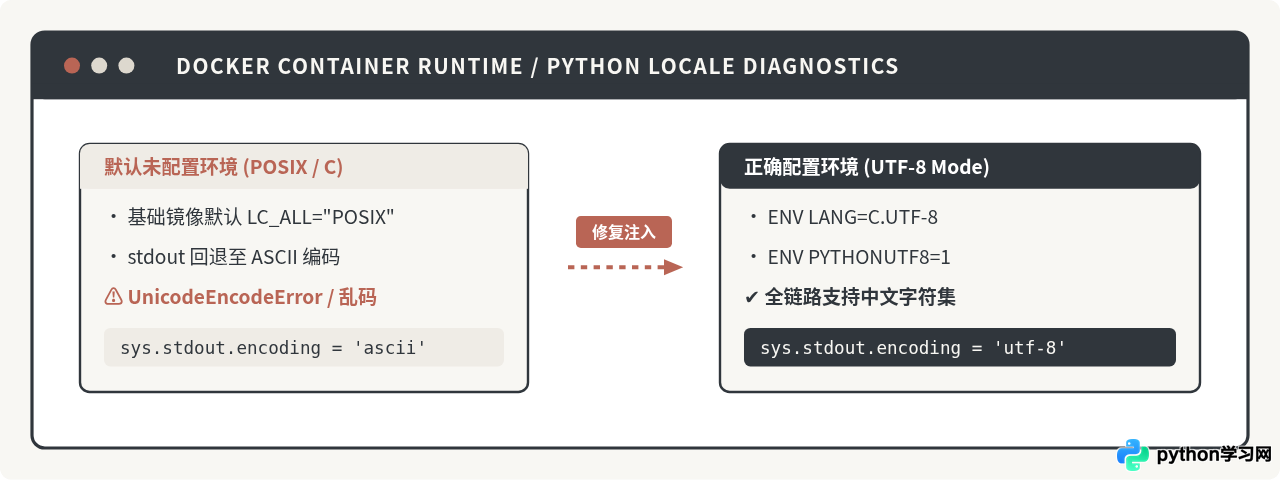
UnicodeEncodeError 错误或产生乱码。解决这一问题的核心路径非常明确:无需繁琐重装系统,只需在容器环境中指定 ENV LANG=C.UTF-8 与 ENV LC_ALL=C.UTF-8,或通过 ENV PYTHONUTF8=1 激活 Python 的原生 UTF-8 模式,即可在系统层与运行时层面彻底解决字符集错位。
一、问题典型表现与错误根源分析
许多开发者在宿主机(如 macOS 或桌面版 Linux)本地调试 Python 脚本时,中文输入与打印均正常,但一旦将程序打包进 Docker 镜像运行,或者通过 docker run 启动容器执行时,涉及中文的内容就会立刻报错或显示为乱码。最典型的报错信息如下:
UnicodeEncodeError: 'ascii' codec can't encode characters in position 0-1: ordinal not in range(128)在另外一些场景下,程序虽然没有抛出崩溃异常,但输出到终端、重定向到日志文件或存储到挂载卷中的中文字符全部变成了 ä¸æ 等十六进制转义形式,或是被直接替换为全角问号 ???。这种现象的产生,根源在于 Linux 容器特殊的运行机制与 Python 的编码推断逻辑之间的相互作用。
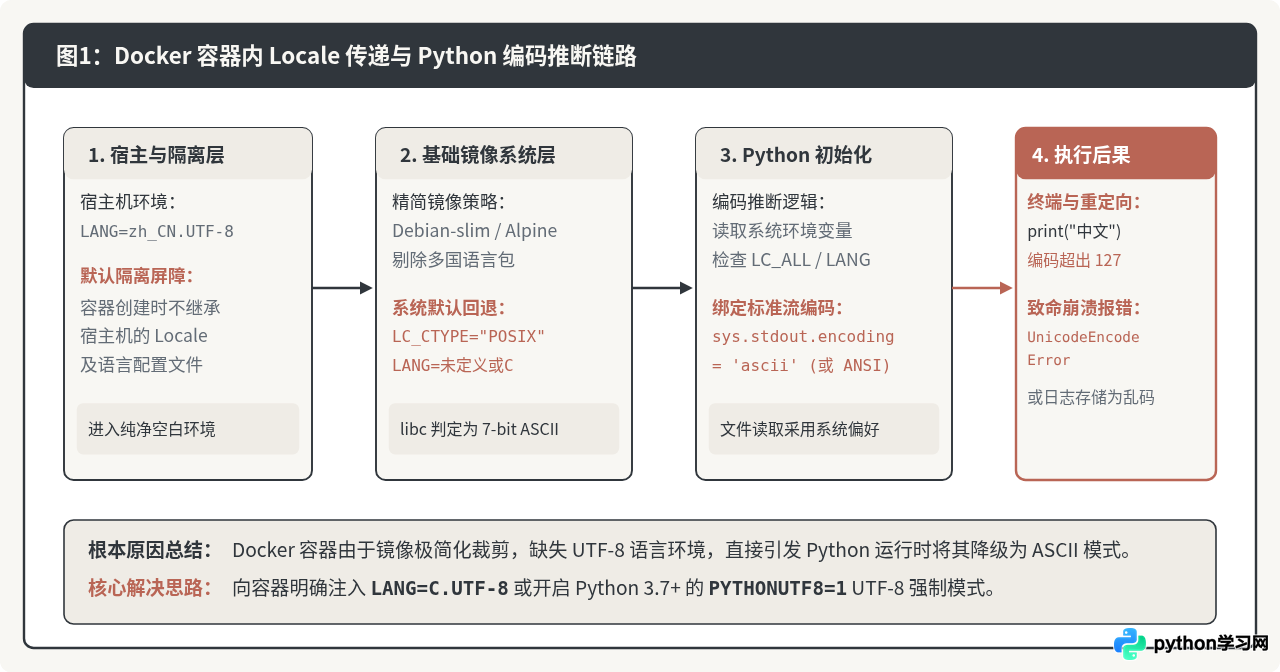
首先,Docker 容器具备独立的文件系统与命名空间,它在启动时不会自动继承宿主机的 LANG、LC_ALL 等本地化环境变量。其次,以 python:3.9-slim、debian:bullseye-slim、ubuntu 以及 alpine 为代表的基础镜像,为了严格控制镜像体积(通常控制在几十兆之内),在制作镜像模板时刻意剥离了多国语言包与 Locale 数据库。这使得容器内部默认回退到最基础的 POSIX 或 C 区域。
在 C Locale 下,底层 C 函数库(glibc 或 musl libc)告知应用程序:当前终端和环境仅支持 128 个常规 7 位 ASCII 字符。当 Python 解释器启动并初始化标准 I/O 流(sys.stdout、sys.stderr、sys.stdin)时,它会向系统询问首选编码。一旦得到 ANSI_X3.4-1968 或 ascii 的答复,Python 就会将标准流严格限制在 ASCII 范围。当脚本尝试用 print() 输出码点大于 127 的中文字符时,ASCII 编码器无法处理,便立即抛出 UnicodeEncodeError。
二、容器内编码状态排查方法
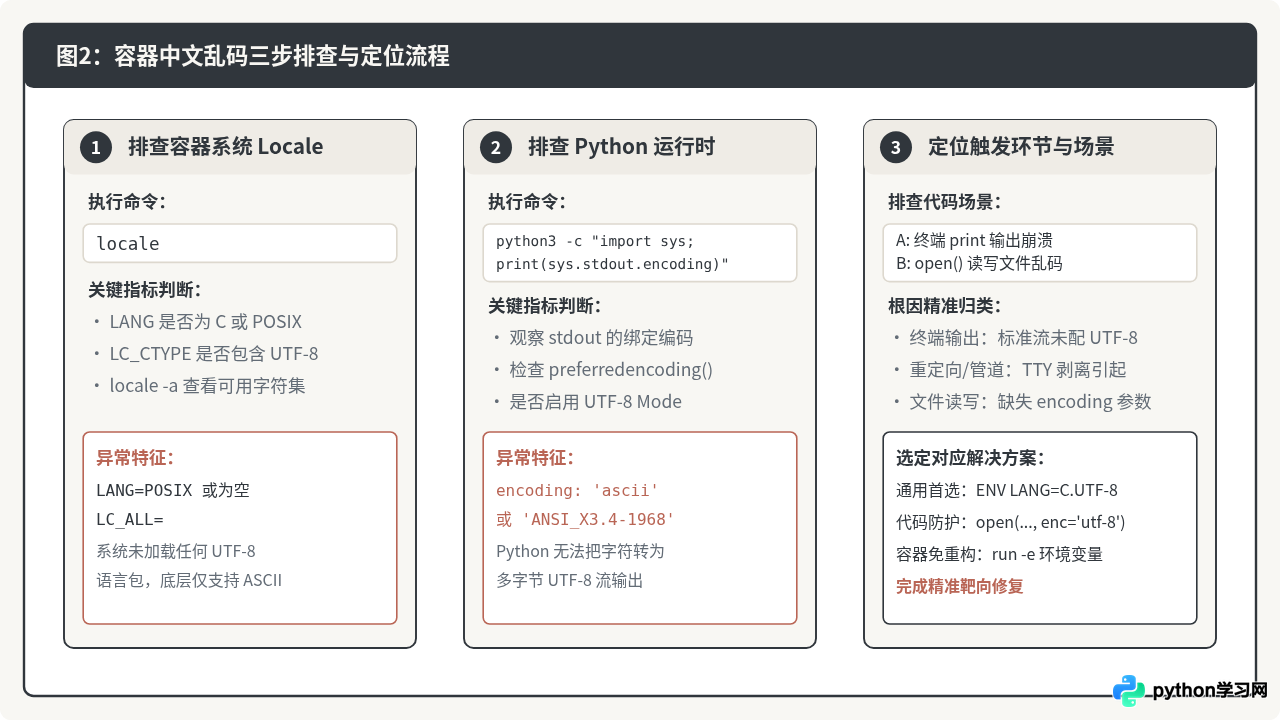
当容器内出现中文乱码时,盲目修改代码往往无法治本。遵循自底向上的顺序,首先确认容器系统级与 Python 运行时两个层面的编码状态,能迅速确认问题所在。
1. 检查容器系统的 Locale 配置
进入正在运行的容器,或通过 docker run 启动交互式终端执行 locale 命令:
# 进入容器检查当前 locale 环境变量
docker exec -it <容器名称或ID> localeLANG=
LANGUAGE=
LC_CTYPE="POSIX"
LC_NUMERIC="POSIX"
LC_TIME="POSIX"
LC_COLLATE="POSIX"
LC_MONETARY="POSIX"
LC_MESSAGES="POSIX"
LC_PAPER="POSIX"
LC_NAME="POSIX"
LC_ADDRESS="POSIX"
LC_TELEPHONE="POSIX"
LC_MEASUREMENT="POSIX"
LC_IDENTIFICATION="POSIX"
LC_ALL=
如果输出中的 LANG 为空,且 LC_CTYPE 显示为 POSIX 或 C,说明系统当前处于纯 ASCII 模式。接着执行 locale -a 查看系统当前编译支持的所有字符集:
docker exec -it <容器名称或ID> locale -aC
C.UTF-8
POSIX
在较新的 Debian 与 Ubuntu 精简镜像中,即便没有安装中文语言包,系统也自带了 C.UTF-8。这为后续零依赖解决问题提供了极佳的前提。
2. 检查 Python 运行时的推断编码
通过执行单行命令,打印 Python 内部标准流与文件系统的实际编码:
docker exec -it <容器名称或ID> python3 -c "import sys, locale; print('stdout:', sys.stdout.encoding); print('fs:', sys.getfilesystemencoding()); print('locale:', locale.getpreferredencoding())"stdout: ANSI_X3.4-1968
fs: ascii
locale: ANSI_X3.4-1968
如果 stdout 对应的编码是 ANSI_X3.4-1968、US-ASCII 或 ascii,那么只要 Python 脚本向终端打印汉字,程序必然中断。只有当 stdout 显示为 utf-8 时,中文才能正常输出。
三、解决方案与 Dockerfile 最佳实践
针对不同的基础镜像与应用场景,我们有四种切实可行的解决手段。在工程实践中,推荐优先选用“方案一”与“方案二”,它们无需安装任何额外系统包,不膨胀镜像体积,且适应大多数现代云原生环境。
方案一:配置 C.UTF-8 环境变量(通用首选)
现代 Linux 发行版(包括 Debian 10+、Ubuntu 18.04+、Alpine Linux 等)均原生内嵌了 C.UTF-8 字符集支持。C.UTF-8 是对传统 C/POSIX 区域的现代扩展:它保持了西文标准的排序与时间规则,同时全面支持 Unicode/UTF-8 字符编码。
在你的 Dockerfile 中直接加入两行环境变量声明:
FROM python:3.10-slim

# 设置容器通用 UTF-8 语言环境
ENV LANG=C.UTF-8     LC_ALL=C.UTF-8

WORKDIR /app
COPY . /app

CMD ["python3", "main.py"]在 Linux Locale 优先级规则中,
LC_ALL 拥有最高覆盖权,而 LANG 作为基准全局默认值。同时声明两者,可以防止某些子进程或第三方 C 扩展库单独读取 LC_ALL 时因变量为空而继续回退到 POSIX。
方案二:激活 Python 3.7+ 的 UTF-8 模式(应用级直达)
如果使用的 Python 版本为 3.7 及以上,可以利用 Python 官方引入的 PEP 540(UTF-8 Mode)。该模式会强行让 Python 忽略操作系统的 Locale 配置,无论底层操作系统处于何种区域,Python 的标准输入输出、文件系统路径解析及默认打开文件均采用 UTF-8 编码。
在 Dockerfile 中通过环境变量开启:
FROM python:3.11-slim

# 开启 Python 原生 UTF-8 Mode 并指定 I/O 编码
ENV PYTHONUTF8=1     PYTHONIOENCODING=utf-8

WORKDIR /app
COPY . /app

CMD ["python3", "main.py"]
这种做法对纯 Python 应用程序非常高效,即便底层容器没有进行任何语言环境改造,Python 代码也能正常处理中文。需要注意:如果容器内同时还运行着其他依赖系统 Locale 的 C 语言工具或 Shell 脚本,该配置仅对 Python 进程生效,无法改变其他进程的 ASCII 行为。
方案三:安装并生成完整 zh_CN.UTF-8 语言包(完整本地化)
如果业务系统不仅需要输出汉字,还需要依赖系统的中文本地化特性(例如使用 Python 的 locale.strxfrm 进行汉字拼音排序、输出“2026年11月19日 星期四”这种中文日期格式、或生成符合中国本地化标准的货币符号),则需要构建真正的中文环境。
在 Debian / Ubuntu 基础镜像中,操作步骤如下:
FROM python:3.10-slim

# 安装 locales 工具,取消注释中文并编译生成语言包
RUN apt-get update && apt-get install -y --no-install-recommends locales     && sed -i -e 's/# zh_CN.UTF-8 UTF-8/zh_CN.UTF-8 UTF-8/' /etc/locale.gen     && locale-gen zh_CN.UTF-8     && apt-get clean     && rm -rf /var/lib/apt/lists/*

# 设置环境变量指向中文语言包
ENV LANG=zh_CN.UTF-8     LC_ALL=zh_CN.UTF-8

WORKDIR /app
COPY . /app

CMD ["python3", "main.py"]
此方案的代价是镜像构建过程中需要通过网络拉取 locales 软件包,最终镜像体积会增大约 15MB~30MB。若非强依赖上述本地化格式,普通中文文本读写与打印建议使用方案一。
方案四:Alpine Linux 特殊处理与运行时参数注入
很多微服务基于 Alpine Linux(例如 python:3.10-alpine)构建。Alpine 采用轻量级的 musl libc,并不包含与 glibc 相同的 locales 机制。在 Alpine 容器中解决中文问题非常简单:
FROM python:3.10-alpine

# Alpine 原生支持 C.UTF-8,直接配置环境变量即可
ENV LANG=C.UTF-8     LC_ALL=C.UTF-8

WORKDIR /app
COPY . /app

CMD ["python3", "main.py"]
如果是已经运行在测试或生产集群中的现成容器镜像,开发者无法立即重新构建 Dockerfile,可以在容器启动命令中动态注入环境变量:
# 通过 CLI 参数动态注入环境变量
docker run -d   -e LANG=C.UTF-8   -e LC_ALL=C.UTF-8   -e PYTHONIOENCODING=utf-8   --name my_app   my-existing-image:latest
如果是使用 docker-compose.yml 编排容器,在服务定义下的 environment 节点添加对应参数:
version: "3.8"
services:
  worker:
    image: my-python-worker:1.0
    environment:
      - LANG=C.UTF-8
      - LC_ALL=C.UTF-8
      - PYTHONUTF8=1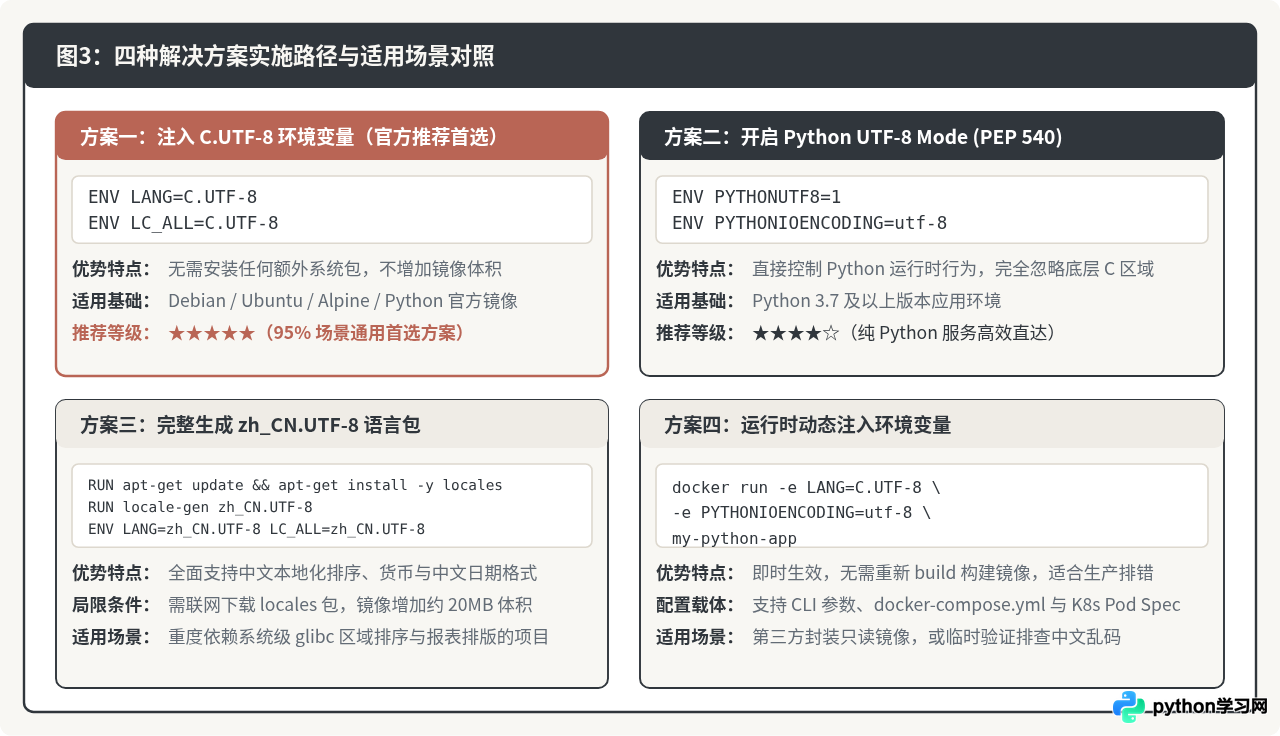
四、Python 代码层面的防护与陷阱
配置容器环境变量解决了控制台输出与标准流的问题,但在实际工程中,仍可能遇到“控制台能打印中文,但读取外部文件依然抛出 UnicodeDecodeError”的现象。这是由于 Python 在不同操作层面的编码绑定机制存在差异。
1. 警惕 open() 函数省略 encoding 参数
在 Python 3 中,调用 open('data.txt', 'r') 打开文件时,如果不显式指定 encoding 参数,Python 会使用 locale.getpreferredencoding(False) 作为默认编码。在未设置 C.UTF-8 或未开启 PYTHONUTF8=1 的容器中,这个值很可能是 ASCII,导致读取包含汉字的文件时崩溃。
代码规范要求:所有涉及文本读写的文件操作,必须显式传入 encoding="utf-8" 参数。
# 错误示例:依赖系统隐式 Locale,容器环境极易崩溃
with open("config.json", "r") as f:
    content = f.read()

# 正确示例:显式指定编码,环境无关,具备最高鲁棒性
with open("config.json", "r", encoding="utf-8") as f:
    content = f.read()
2. 日志模块(Logging)Handler 编码指定
标准库 logging 在向文件写入日志时,其底层 FileHandler 同样默认使用系统的 Locale 偏好编码。若容器环境未完全统一,容易在特定日志归档时出现错误。正确的配置方式如下:
import logging

logger = logging.getLogger("app")
# 显式指定日志文件的编码为 utf-8
file_handler = logging.FileHandler("app.log", encoding="utf-8")
formatter = logging.Formatter("[%(asctime)s] %(levelname)s: %(message)s")
file_handler.setFormatter(formatter)
logger.addHandler(file_handler)

logger.info("中文日志记录测试正常")
3. 子进程调用(Subprocess)的管道编码
使用 subprocess.Popen 或 subprocess.run 调用外部系统命令并捕获其输出时,如果指定了 text=True(或 universal_newlines=True),子进程输出解码同样依赖 Locale。建议显式指定编码参数:
import subprocess

result = subprocess.run(
    ["ls", "-l", "/data"],
    capture_output=True,
    text=True,
    encoding="utf-8"  # 显式指定管道字符集
)
print(result.stdout)
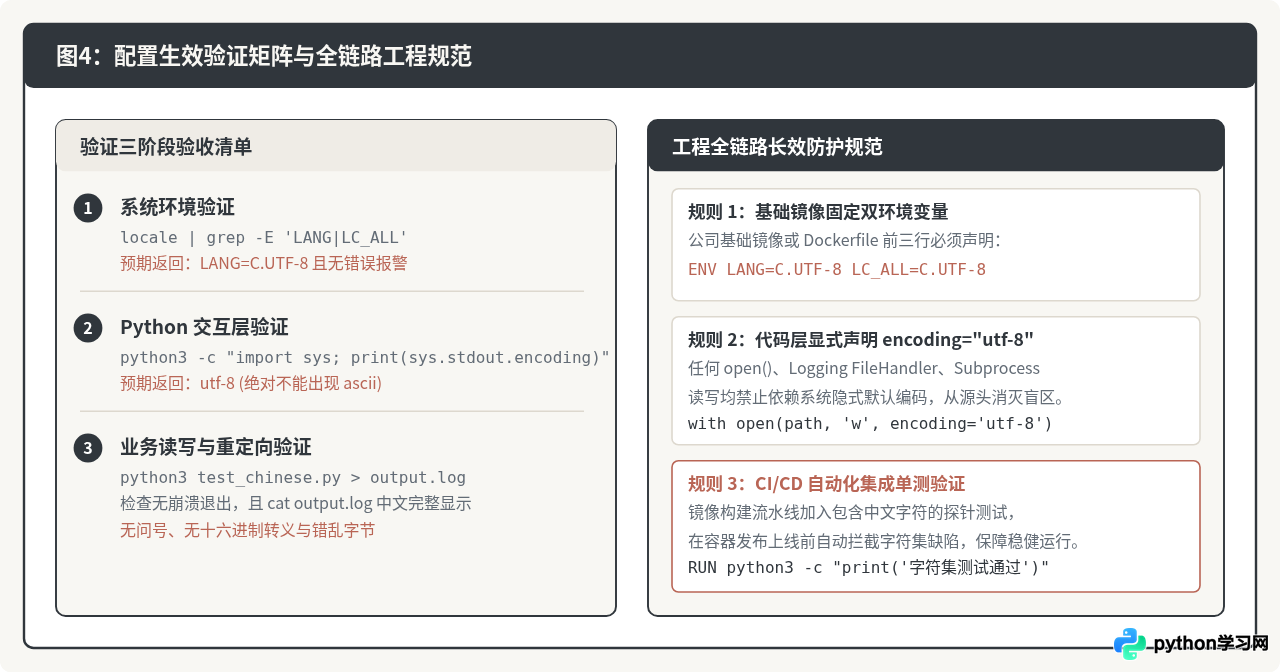
五、端到端测试用例与验证
为了确认容器环境与 Python 运行时已完全具备中文处理能力,我们构建一个涵盖控制台输出、文件写入与读取的端到端测试用例。
1. 编写验证脚本 test_locale.py
import sys
import locale

def test_environment():
    print("=" * 45)
    print("【1】当前运行时字符集检测:")
    print(f"标准输出流编码 (sys.stdout.encoding): {sys.stdout.encoding}")
    print(f"标准错误流编码 (sys.stderr.encoding): {sys.stderr.encoding}")
    print(f"文件系统解析编码 (sys.getfilesystemencoding): {sys.getfilesystemencoding()}")
    print(f"系统首选默认编码 (locale.getpreferredencoding): {locale.getpreferredencoding()}")
    print("=" * 45)

    print("【2】控制台中文输出测试:")
    test_str = "中文测试:容器环境 Python 脚本运行正常!"
    print(test_str)

    print("=" * 45)
    print("【3】文件写入与读取测试:")
    file_path = "output_test.txt"
    with open(file_path, "w", encoding="utf-8") as f:
        f.write("数据持久化测试:你好,Docker 容器!
")

    with open(file_path, "r", encoding="utf-8") as f:
        read_back = f.read().strip()
    print(f"从文件回读内容: {read_back}")
    print("=" * 45)
    print("✔ 所有中文字符集验证项目全部通过!")

if __name__ == "__main__":
    test_environment()
2. 执行测试并核对输出
在正确注入 ENV LANG=C.UTF-8 的镜像中运行该脚本,应得到如下符合预期的完整输出:
【1】当前运行时字符集检测:
标准输出流编码 (sys.stdout.encoding): utf-8
标准错误流编码 (sys.stderr.encoding): utf-8
文件系统解析编码 (sys.getfilesystemencoding): utf-8
系统首选默认编码 (locale.getpreferredencoding): UTF-8
=============================================
【2】控制台中文输出测试:
中文测试:容器环境 Python 脚本运行正常!
=============================================
【3】文件写入与读取测试:
从文件回读内容: 数据持久化测试:你好,Docker 容器!
=============================================
✔ 所有中文字符集验证项目全部通过!
若能在终端无异常打印上述内容,且通过 docker logs <容器名> 查看历史日志时汉字显示清晰完整,则表明该容器已成功免疫中文乱码问题。
六、不同方案的决策参考表
综合考虑镜像体积、维护成本与业务需求,各方案的选型对比如下表所示:
| 解决方案 | 实施方式 | 镜像增量 | 适用范围 | 推荐度 |
|---|---|---|---|---|
| 配置 C.UTF-8 | ENV LANG=C.UTF-8 LC_ALL=C.UTF-8 |
0 MB | Debian / Ubuntu / Alpine / 多数官方镜像 | ★★★★★(默认首选) |
| 开启 UTF-8 Mode | ENV PYTHONUTF8=1 PYTHONIOENCODING=utf-8 |
0 MB | Python 3.7+ 纯应用镜像 | ★★★★☆(推荐) |
| 生成 zh_CN.UTF-8 | apt-get install locales && locale-gen |
~20 MB | 依赖中文拼音排序、货币与日期的重度本地化业务 | ★★★☆☆(按需使用) |
| 动态注入参数 | docker run -e LANG=C.UTF-8 ... |
0 MB | 生产临时调试、无法重构镜像的第三方镜像运行 | ★★★★☆(运维应急) |
总结而言,Docker 容器执行 Python 脚本遇到的中文乱码与 UnicodeEncodeError,本质上是精简镜像移除了多语言配置与 Python 字符流自动推断机制碰撞所致。在工程实践中,将 ENV LANG=C.UTF-8 与 ENV LC_ALL=C.UTF-8 作为 Dockerfile 的通用基础标配,并在 Python 代码中始终坚持显式指定 encoding="utf-8",是从根本上杜绝中文乱码问题的最稳定、最高效路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















