


Python计算分页或时间换算时怎么使用//获取整数结果
详细讲解在Python中使用整除运算符//进行分页总页数计算与时间跨度单位换算的方法,深入解析向下取整原理、偏移进位技巧与取模运算的配合实践。
在日常开发中,计算总页数、定位切片起始下标,或是将累计秒数拆分为“时、分、秒”,都是极其高频的任务。很多开发者习惯使用标准除法 / 计算后再通过浮点取整转换,但这往往会引入浮点数精度截断或额外的边界逻辑。在 Python 中,双斜杠 // 是专门的整除运算符(Floor Division),能够直接返回整数商。掌握它的向下取整规律,并结合数学偏移量与取模运算 %,即可用极简、严谨的代码稳妥解决分页与时间换算问题。
一、整除运算符 // 的底层原理与取整行为
在 Python 3 中,单斜杠 / 始终执行真除法(True Division),即便两数恰好能除尽,返回的结果也是浮点数(Float),例如 6 / 2 得到 3.0。而双斜杠 // 执行的是整除运算,直接求出商的整数部分。
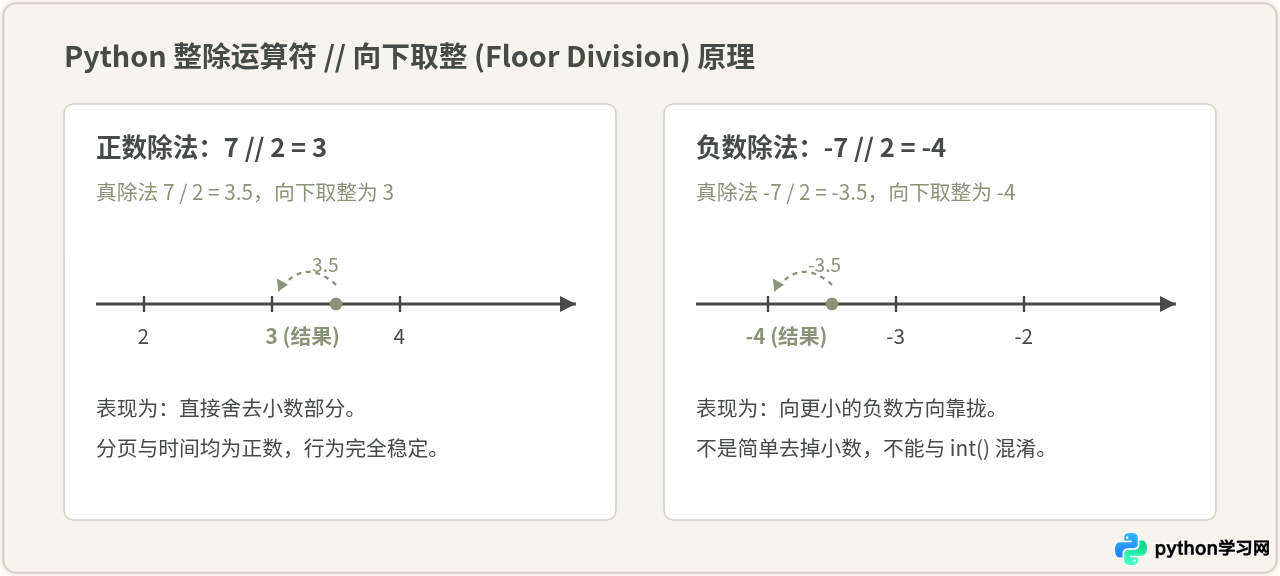
理解 // 的核心在于认识其数学定义:向下取整(Floor),即取不大于实际商的最大整数(朝着数轴负无穷大方向取整)。在被除数与除数均为正数时,它的表现与“直接舍弃小数部分”完全一致;但当出现负数时,其表现与简单的向零截断(如 int() 强转)存在本质区别。
# 正数整除:朝负无穷取整,正数直接去尾
print(14 // 4)    # 结果为 3 (14 / 4 = 3.5,不大于 3.5 的最大整数是 3)
print(14 / 4)     # 结果为 3.5

# 负数整除:依然严格向负无穷取整
print(-14 // 4)   # 结果为 -4 (-14 / 4 = -3.5,不大于 -3.5 的最大整数是 -4)
print(int(-3.5))  # 结果为 -3 (向零截断)
由于分页数据总数与时间换算中的总秒数通常为非负整数,整除 // 能够稳定给出向下对齐的整数值。正是这一数学特性,为后续的分页进位与时间降阶计算提供了确定的理论基础。
二、场景一:分页计算中如何获取整数总页数与位置
在后端接口或前端数据展示中,分页涉及两个基本问题:第一,已知数据总条数 total_count 与每页条数 page_size,求总页数 total_pages;第二,已知当前页码,求切片截取的起点与终点。
1. 为什么不能直接使用 total_count // page_size?
很多初学者会自然写出 total_count // page_size,这会在非整除场景下直接少算一页。例如:
- 当
total_count = 20,page_size = 10时,20 // 10 = 2,刚好 2 页,结果正确; - 当
total_count = 21,page_size = 10时,21 // 10 = 2,由于向下取整,第 21 条记录所在的第 3 页直接被丢失。
分页计算本质上要求的是向上取整(Ceil),即只要有多出来的余数,就必须单独占一页。
2. 经典整数向上取整公式:(total + page_size - 1) // page_size
无需导入 math.ceil,利用 // 配合一个常数偏移量即可完美实现向上取整:
def get_total_pages(total_count: int, page_size: int) -> int:
    if total_count <= 0 or page_size <= 0:
        return 0
    return (total_count + page_size - 1) // page_size
公式原理解析:
- 若能够整除:设
total_count = 20,page_size = 10。分子加上9(即10 - 1)变为29。计算29 // 10依然等于2,刚好不跨越到下一个整数。 - 若存在任意余数:设
total_count = 21,page_size = 10。余数为 1。分子加上 9 变为30。计算30 // 10 = 3,精准完成跨步进位。即便余数只有 1,加上page_size - 1后也能达到下一个整除门槛。 - 空数据表现:当
total_count = 0时,如果不做前置拦截,(0 + 10 - 1) // 10 = 9 // 10 = 0。该公式在输入为 0 时计算结果天然为 0。
技巧补充:利用负数向下取整实现一行流向上取整
由于负数整除是朝负无穷取整,因此负数整除其实等价于正数的向上取整后再取反:
total_pages = -(-total_count // page_size)
例如 -(-21 // 10) = -(-3) = 3。这也是 Python 算法竞赛与紧凑代码中常见的整数向上取整写法。
3. 根据页码与数据索引的反向定位
利用 // 还可以方便地根据全局索引判断数据属于第几页:
# 场景:从 0 开始计数的列表索引,求属于第几页(页码从 1 开始)
item_index = 24       # 第 25 条记录(索引 24)
page_size = 10
belong_page = item_index // page_size + 1   # 24 // 10 + 1 = 3 (第 3 页)

# 场景:根据页码计算切片的起始与结束索引
page = 3
start_idx = (page - 1) * page_size           # (3 - 1) * 10 = 20
end_idx = start_idx + page_size              # 30
# 切片操作为: items[start_idx:end_idx]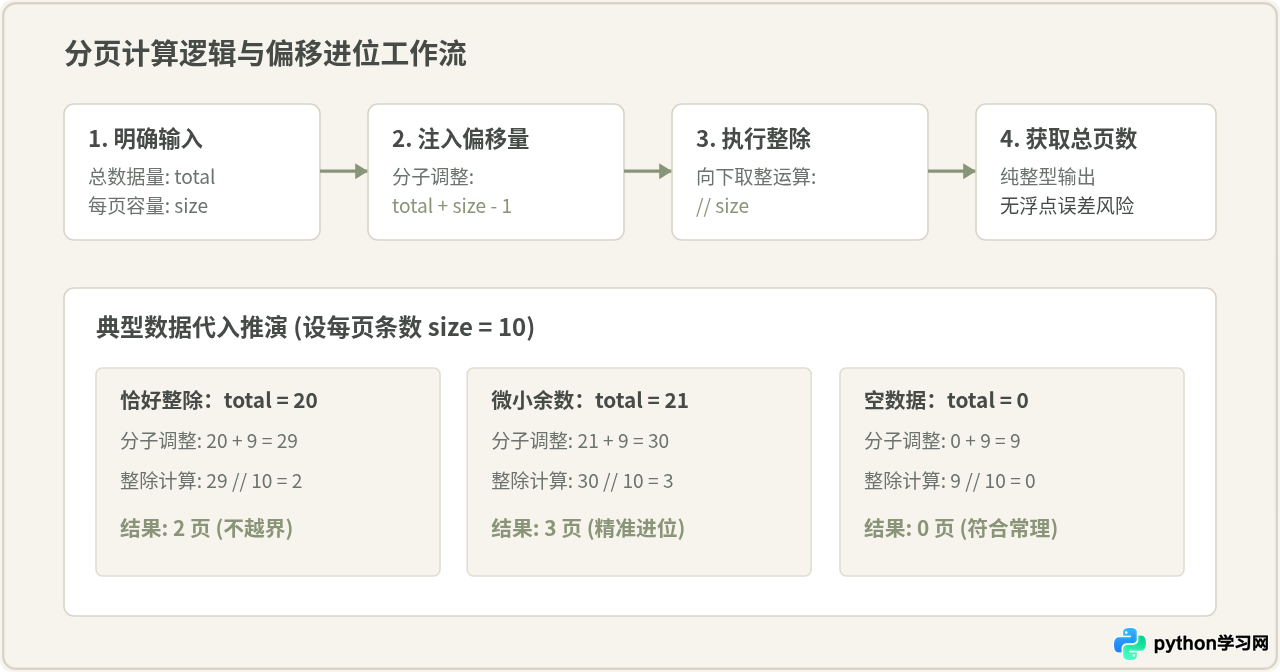
三、场景二:时间跨度换算与级联分解
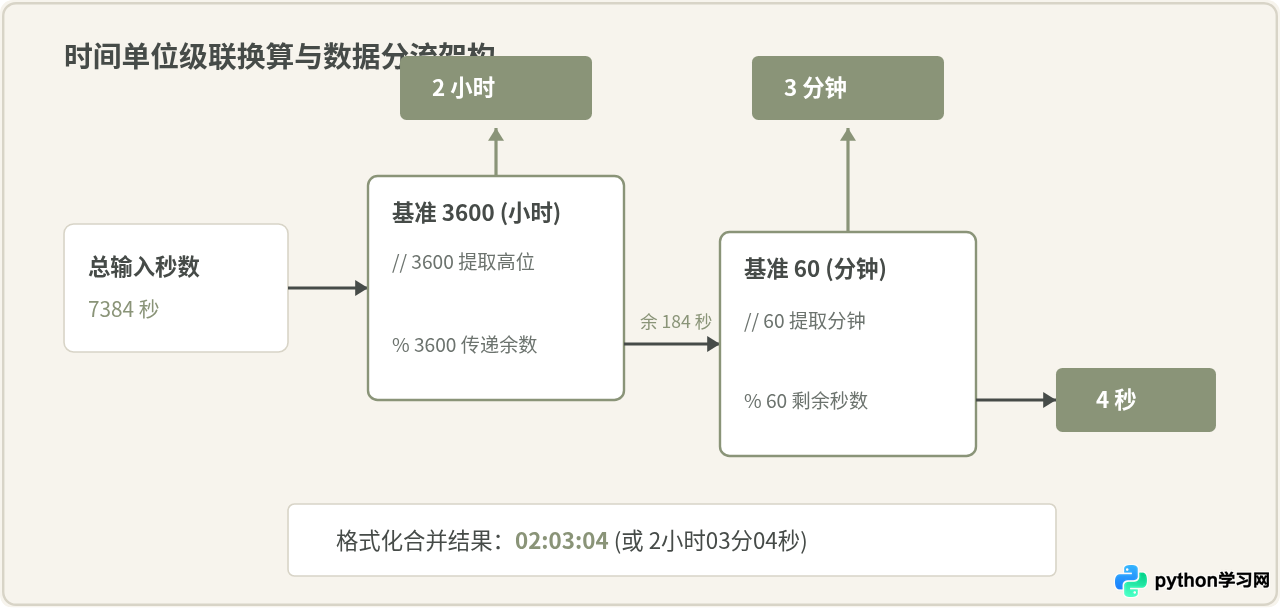
在性能监控、倒计时或时长展示中,系统记录的往往是一个总秒数(如 7384 秒),需要换算成“小时、分钟、秒”的标准格式。在此场景下,整除 // 负责提取高阶单位的整数倍数,取模 % 负责保留未被提取的余数,两者配合完成级联分解。
1. 分步换算的逻辑实现
1 小时等于 3600 秒,1 分钟等于 60 秒。换算逻辑如下:
def format_seconds(total_seconds: int) -> tuple[int, int, int]:
    # 1. 提取小时:求 3600 的整数倍
    hours = total_seconds // 3600
    # 2. 扣除已换算为小时的秒数,保留余数
    rem_seconds = total_seconds % 3600
    # 3. 在剩余秒数中提取分钟:求 60 的整数倍
    minutes = rem_seconds // 60
    # 4. 剩余的即为不足 1 分钟的秒数
    seconds = rem_seconds % 60

    return hours, minutes, seconds

# 测试
h, m, s = format_seconds(7384)
print(f"{h:02d}:{m:02d}:{s:02d}")  # 输出: 02:03:04
2. 使用内置函数 divmod 简化代码
Python 提供了内置函数 divmod(a, b),它在底层由 C 代码同时完成 (a // b, a % b) 两次运算,不仅书写更为优雅,在处理大批量数据换算时效率也更高:
def format_seconds_divmod(total_seconds: int) -> tuple[int, int, int]:
    # 一步获取小时与剩余秒数
    hours, remainder = divmod(total_seconds, 3600)
    # 一步获取分钟与最终秒数
    minutes, seconds = divmod(remainder, 60)
    return hours, minutes, seconds
这种级联分解模式可以任意向上扩展。例如需要进一步提取“天”时,只需先使用 total_seconds // 86400 提取天数,再对 86400 取模后进入后续计算即可。
四、关键细节与避坑指南
在生产环境中运用 // 运算时,还需要注意数据类型转换、浮点精度以及异常防御等细节问题。
1. 警惕浮点数污染:参与运算的操作数类型
在 Python 中,如果 // 运算的任一操作数是浮点数(Float),那么即使结果在数学上是一个整数,其返回值类型也会被隐式提升为 float。例如:
val1 = 10 // 3     # 结果为 int: 3
val2 = 10.0 // 3   # 结果为 float: 3.0
在分页处理中,切片索引 items[start:end] 要求下标必须是标准的 int 类型。如果从前端接收到的每页条数被框架解析成了 float(例如 10.0),整除结果将是 3.0,在传递给切片时会直接引发异常:TypeError: slice indices must be integers or None or have an __index__ method。因此,在计算前应确保操作数均为纯整型,或显式进行 int() 约束。
2. 为什么比 math.ceil(total / page_size) 更可靠?
部分开发者习惯使用 math.ceil(total / page_size)。这种方式看似直观,但在处理大数值或严苛场景时存在隐患:
- 浮点精度损失:Python 的
int支持任意精度大整数,而/会先将数值转化为符合 IEEE 754 标准的 64 位双精度浮点数。一旦数据量达到极大量级(超过 53 位有效二进制数字),浮点数转换将发生精度丢失,从而导致取整结果错误; - 依赖与开销:使用纯整数算术公式
(total + page_size - 1) // page_size完全不需要导入math模块,避免了模块导入与函数调用开销,执行速度更为轻快。
3. 防范除零异常 (ZeroDivisionError)
无论是分页计算中的 page_size 还是时间换算中的进制底数(如 60、3600),若除数为 0,Python 都会抛出 ZeroDivisionError。在对外暴露的函数或服务接口中,必须对除数进行防御性校验:
def safe_paginate(total: int, page_size: int) -> int:
    # 防御非法传参
    if page_size <= 0:
        raise ValueError("每页条数 page_size 必须大于 0")
    if total <= 0:
        return 0
    return (total + page_size - 1) // page_size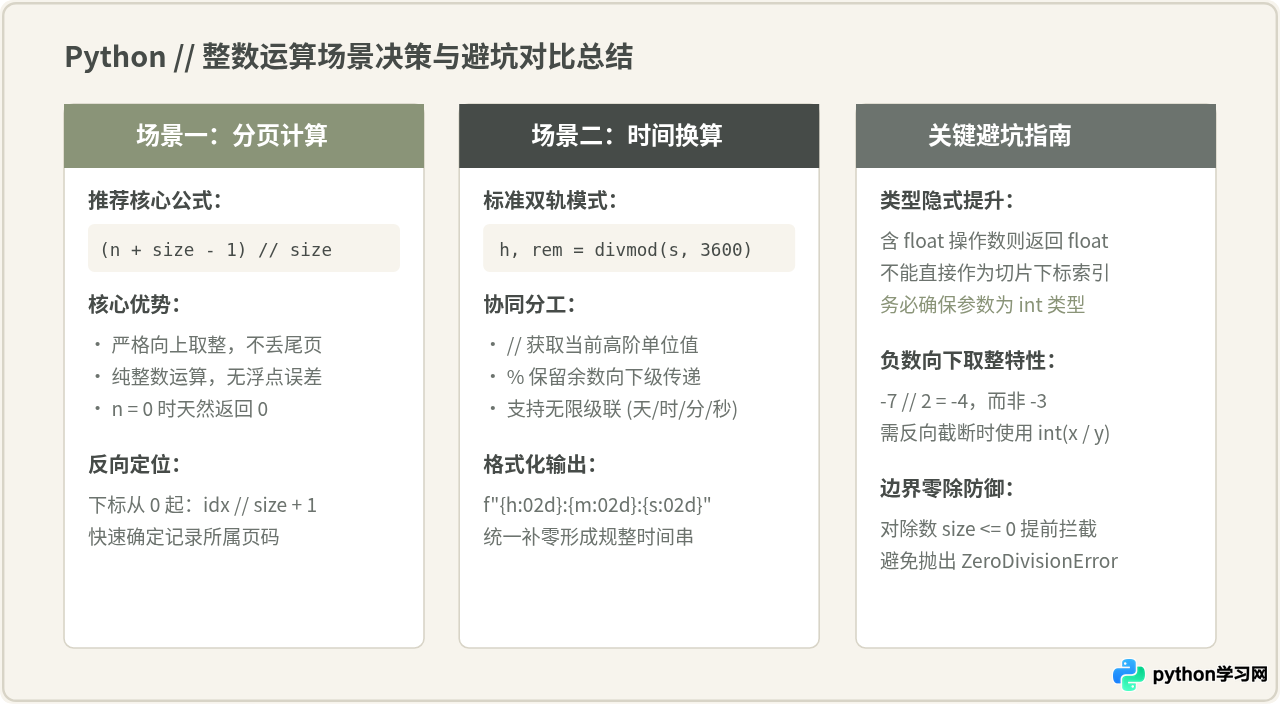
五、总结
掌握 Python 的整除运算符 //,关键在于理解其数学上的向下取整(Floor)本质。在计算分页总页数时,通过 (total + page_size - 1) // page_size 引入常数偏移,可以用纯整数运算优雅完成向上取整;在时间单位换算中,通过 // 提取高阶单位整数与 % 保留传递余数,配合 divmod() 函数即可高效完成级联拆解。在编写工程代码时,保持操作数整型纯度并做好除数大于零的防御校验,就能兼顾算法的简洁性、可读性与执行稳健性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















